构建 AI 智能体的开发者很少亲自训练模型或编写 GPU 内核,但他们在工具、记忆和提示词上做出的每一个决定,都受制于模型内部的运作方式:模型如何选择下一个 token,注意力机制如何让它回看前文,以及这种回看要消耗多少内存。把这些机制当作智能体开发的前提知识而非背景杂谈,能直接换来一组具体的设计规则:根据任务调整采样参数,预期准确率会随上下文变长而下降,保持工具集精简,把新信息追加在提示词末尾,并且绝不让自动化的上下文压缩抹掉安全指令。
智能体开发者在技术栈中的位置
组织大语言模型相关工作的一种方式是三层技术栈。最底层是 LLM 工程:分布式计算、Transformer 架构、定制 GPU 内核、缩放定律、预训练、后训练、强化学习和分词器。中间层是 LLM 适配:监督微调、蒸馏、上下文学习、LoRA(一种通过训练小规模低秩权重更新来低成本微调模型的方法),以及借助 RLHF 或 DPO 进行的偏好对齐。最顶层是 LLM 应用:聊天机器人、检索增强生成和智能体。
智能体开发者位于最顶层。即便如此仍要学习底层的理由很实际:理解键值缓存和注意力变体的开发者,能够提前预判上下文限制和计算开销,而不是等到生产环境中才发现。这个技术栈本身只是一种非正式的框架,并非行业标准。
模型如何选出下一个词
语言模型通过把条件概率相乘来为一个 token(词或子词片段)序列赋予概率:即在给定前文的条件下,每个 token 出现的概率。以句子“The class was about agents .”为例,第一个 token“The”的边际概率为 0.0377,在“The”之后出现“class”的概率为 0.0001,在前两个词之后出现“was”的概率为 0.0344,最后的句号为 0.0252。整句的乘积是 1.2e-17。由于许多小数相乘会导致浮点运算下溢,实践中通常改为对对数概率求和。
这一定义正是语言模型被归为生成式模型而非判别式模型的原因。逻辑回归或 SVM 之类的判别式模型学习的是决策边界,比如把猫的照片和狗的照片区分开。生成式模型学习的则是数据分布本身,因此可以从中采样。选择下一个 token 看起来像是在词表上做分类,这让两者的界线显得模糊,但模型定义的是任意文本序列上的完整联合分布,这才是它能够生成文本的根本。
生成是逐个 token 进行的。给定“The class was about”,模型会把概率分散到整个词表上——现代模型的词表通常约有 128,000 个子词 token:“to”为 0.3171,“as”为 0.0491,“the”为 0.0360,“a”为 0.0330,“two”为 0.0147,“how”为 0.0124,依此类推。采样到“to”之后上下文得到延长,下一个分布中“be”为 0.1501,“begin”为 0.0855,“go”为 0.0627,“start”为 0.0496。
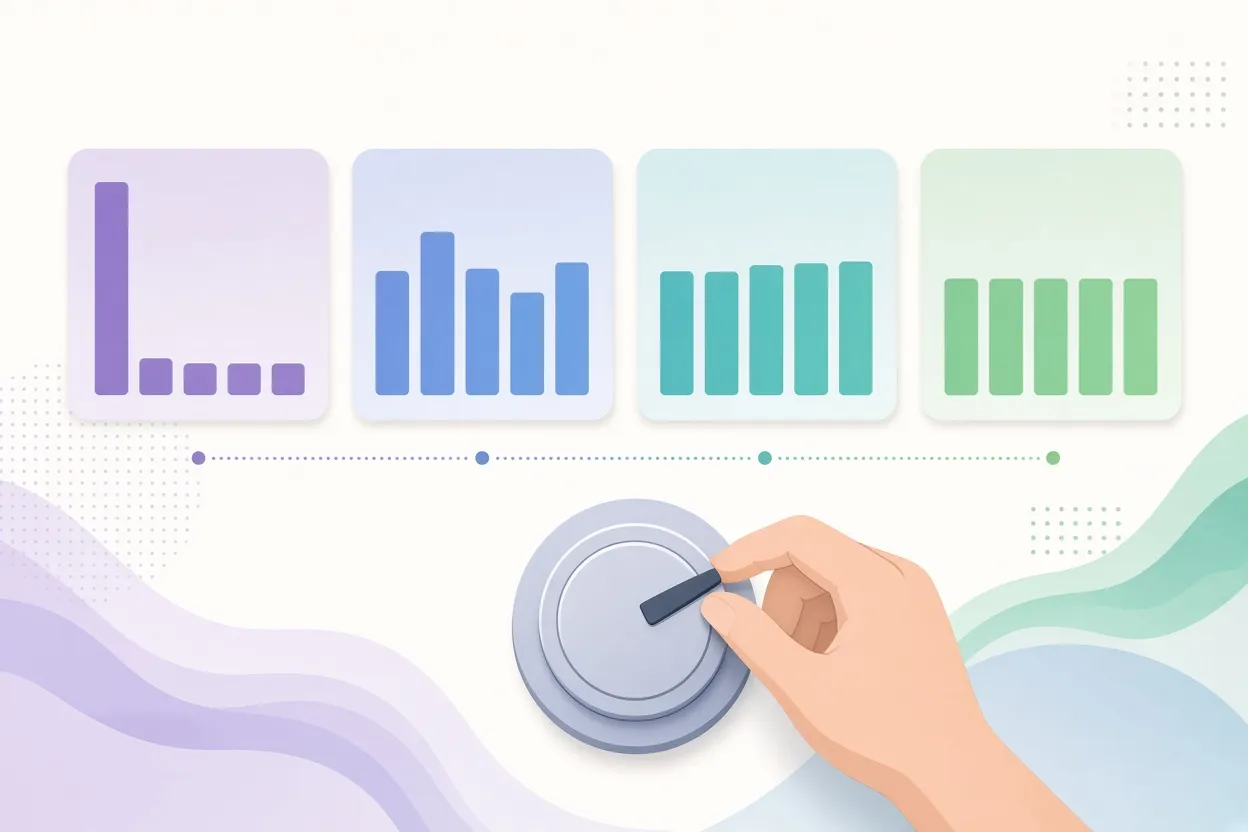
▲ 温度对 token 概率的影响
如何从这个分布中抽取,由开发者决定。温度是在 softmax 将原始 logits 重新归一化为总和为一之前,对其施加的一个除数。它没有天然的上界;温度为 5 不过是一个缩放因子。低温会让峰值更尖锐,使行为趋向贪心解码;高温会拉平分布,抬高低概率 token。对于提示词“I am tired, I will take a ___”,“nap”“break”“rest”“bath”“shower”等候选词在 T=0.1 时呈现为一根占绝对优势的柱子,而在 T=2.0 时几乎变成等高的柱子。
| 策略 | 作用 | 取舍 |
|---|---|---|
| 贪心解码 | 始终选取概率最高的 token | 快速且确定,但可能产生重复或局部贪心的文本 |
| Top-k | 从概率最高的 k 个 token 中采样,例如 k=5 | 候选池大小固定,不随模型置信度变化 |
| Top-p(核采样) | 从累积概率达到 p 的最小集合中采样,例如 30% | 候选池大小随分布自适应 |
| 温度 | 在 softmax 之前将 logits 除以 T | 低 T 追求可预测性,高 T 追求多样性 |
| 束搜索 | 同时跟踪多个候选序列 | 整体序列似然更高,但耗费多得多的时间和内存 |
经验法则由任务决定:数学和代码需要低温度;创意写作需要更高的熵,通常搭配 top-p 或 top-k。束搜索能找到比贪心解码概率更高的序列,但在内存中同时保留多个假设往往使其成本过高,不适合交互式智能体。束搜索中的候选序列可以按累积概率、特定任务的价值函数或外部验证器来排序。
对智能体循环来说有两个细节值得注意。温度是推理阶段的超参数,而不是学习得到的权重,不过强化学习的 rollout 会以固定温度采样。另外,在 token 之间改变温度不会使 KV 缓存失效,所以技术上是可行的,尽管生产系统很少这么做。推理模型增加了多步思考,但温度仍然是影响推理质量的一个实时调优决策。
注意力机制内部:上下文为何有成本
几乎所有现代 LLM 都是仅解码器的 Transformer,源自 2017 年 Vaswani 及其谷歌同事发表的论文《Attention Is All You Need》,该论文提出了一种用于翻译的编码器-解码器设计。现代生成模型去掉了编码器,只保留解码器,而两者共享同一种注意力模块。
以“The”“class”“was”“about”这几个 token 为例走一遍这个模块,就能看出上下文限制的来源:
- 每个 token 在学习得到的嵌入表中查找,得到一个向量。
- 加上位置嵌入,因为注意力本身是置换不变的:没有位置信息,模型无法分辨哪个可见 token 在前。
- 堆叠后的向量经过层归一化。
- 三个学习得到的矩阵 W_Q、W_K 和 W_V 将它们分别投影为查询、键和值,各自带有偏置项。
- Q 乘以 K 的转置,得到一个 n×n 的分数矩阵,n 为序列长度。
- 因果掩码阻止每个 token 关注其后的 token。训练时整个序列是并行处理的,若没有掩码,“The”之后的预测就会泄露来自“class”和“was”的信息。
- 分数除以键维度的平方根,经 softmax 使每行总和为一,再乘以 V。
- 输出投影 W_O 将结果映射回模型维度,残差连接把原始输入加回来以保持梯度流动。
多头注意力并行运行多组 Q、K、V 投影,把输出拼接后再通过一个更宽的 W_O 投影,使模型能够同时关注不同的表示子空间。完整的模块还会加上一个前馈层和另一个残差连接,模块堆叠 N 次,最后由语言建模头接 softmax 产生下一个 token 的分布。权重初始为随机值,所以早期的前向传播只会产生噪声,直到梯度下降完成训练。
原论文中的复杂度表既解释了 Transformer 的成功,也解释了它的上下文问题。自注意力每层的开销为 O(n^2 * d),d 为表示维度,但只需要 O(1) 次顺序操作,因此整个序列可以在 GPU 上并行处理。循环网络的开销为 O(n * d^2),却需要 O(n) 个顺序步骤。并行性让 Transformer 得以在海量语料上训练;平方项则让长上下文变得昂贵。作为参照,原始的“Transformer (big)”模型约有 2 亿参数,训练耗费 2.3 x 10^19 FLOPs,在 2017 年算是庞大,但与今天万亿参数的模型相比微不足道。
线性注意力与混合模型
以 DeltaNet 为代表的线性注意力去掉了查询和键之间的 softmax。一切都是线性的之后,矩阵结合律允许模型先计算 K 的转置乘以 V,得到一个 d×d 的状态矩阵,其大小与序列长度无关。该状态在每一步通过清除无关记忆并加入新的键值外积来更新,因此从 2^9 到 2^16 个 token,运行时间和 GPU 内存都呈线性增长。
代价体现在检索上。在 RULER 基准的“大海捞针”任务中(一个神奇数字被藏在文章文本里,在末尾被提问),Llama-2-7B 在 8k token 内保持高准确率,而 RWKV-v5-7B 和 Mamba-2.8B 在超过 2k 到 4k token 后急剧下降。固定大小的状态必须压缩全部历史,具体的事实因此丢失。
| 属性 | 完整 softmax 注意力 | 线性注意力 |
|---|---|---|
| 计算量与序列长度的关系 | O(n^2) | O(n) |
| 上下文机制 | 每个 token 都能回看之前所有 token | 历史被压缩进固定的 d×d 状态 |
| 推理时的内存 | KV 缓存线性增长,O(n) | 状态大小恒定 |
| 长程检索 | 强 | 弱 |
实践中架构师会把两者混合使用。DeltaNet 将滑动窗口层和线性层交错排列,并周期性地插入全局注意力层;加入全局注意力后,平均检索率从 22.7% 提升到 32.7%,Wikipedia 困惑度从 28.24 改善到 27.51,常识任务得分没有受损。开放的前沿模型 Kimi K3 将多头潜在注意力(Multi-Head Latent Attention)与 KDA 线性层、稳定层归一化和前馈模块结合起来,并用门控在生成过程中控制记忆。
还有一点:两种注意力公式本身都没有在方程中规定最大上下文长度。硬性限制来自学习得到的位置嵌入。模型只能解读训练中见过的位置,所以扩展上下文意味着要调整或插值这些嵌入。
预填充、解码与 KV 缓存
推理分两种状态运行。预填充阶段,所有提示词 token 一次性通过模型,执行算术强度很高的稠密矩阵乘法;按照 Roofline 性能模型,这一阶段受算力限制。解码阶段,模型每步输出一个 token。中间激活被丢弃,但键和值作为 KV 缓存保留下来,并随每个 token 增长。每一步都要为单个 token 的更新重新加载模型权重和缓存,所以解码受内存带宽限制。首 token 延迟(Time to First Token)衡量预填充;每输出 token 时间(Time Per Output Token)衡量解码。
对于需要在工具 schema、环境观测和交互轨迹构成的长上下文上循环的智能体来说,这种划分影响深远。KV 缓存内存应尽早进行性能分析,也值得弄清混合或线性注意力模型是否适合自己的工作负载。推测解码有助于缓解带宽瓶颈:一个小型草稿模型提出若干 token,目标模型在一次并行传递中验证它们,生成从第一个被拒绝的位置继续。代码任务(HumanEval)上的接受率高于摘要任务(XSum),因为代码语法更可预测;而草稿越长,接受率最终会降到足以抵消收益的程度。
推理模型在推理时花费额外 token 来发现自身错误,在 Agent's Last Exam 基准上,GPT-5 Astra 和 Claude Opus 的准确率都随 token 预算上升。努力程度可设为低、中、高或最高;更高的努力程度能提高准确率,但延迟和开销会大幅增加。Kimi K3 用奖励信号训练这种控制能力:答对得 +1,预算内答错得 0,超出预算且答错得 -1,然后把三个领域、三个努力等级下的九个教师模型蒸馏到一个学生模型中。
结构化输出与上下文工程
智能体处于调用 API、数据库和代码解释器的复合系统之中,所以其输出需要严格的契约。约束解码强制生成过程遵循正则表达式或 JSON schema。SGLang 把 schema 编译为有限状态机,在不经过模型前向传播的情况下直接插入引号、花括号等固定语法,只在存在多个合法 token 的转移处才调用模型;在 Llama-7B 上,这带来了相对 vLLM、Guidance 和 LMQL 的显著吞吐量提升。DSPy 的 signature 以声明式代码表达同样的契约,定义 name、email、intent 等带类型的输入输出字段,并将其编译为强制执行 schema 的提示词。对于范围狭窄的决策,在嵌入上接一个小型分类头,或者用对比模型根据状态嵌入为候选动作打分,可以完全避开开放式生成。
▲ 面向智能体的上下文工程实践
早期的实践聚焦于单轮对话的提示词工程。智能体需要的则是上下文工程:把系统提示词、多轮历史、长期记忆、工具输出和附加文件一并加以筛选编排。把一切都塞进窗口会在两方面失败。注意力开销呈平方增长,准确率也会崩塌。在考察跨多文档推理与聚合能力的 OOLONG 基准上,Gemini 2.5 Pro、Claude Sonnet 4 和 GPT-5 等领先模型的得分从 8k token 时接近 90% 跌到 512k token 时的大约 10% 到 40%。这种“上下文腐化”远在宣称的窗口上限之前就已出现。
实用准则可直接由上述机制推出:
- 避免工具泛滥。 在 Terminal-Bench 2 上,一个名为 Pi 的极简框架只有读取、写入、编辑和 bash 四个工具,在各 Claude 模型上的表现与 Codex、Claude Code 等更大的框架持平甚至更优。
- 检索,而不是倾倒。 使用嵌入模型、向量搜索和重排序器,只取回相关的片段。
- 追加在末尾。 在前面插入新信息会改变其后每个 token 的位置,使预先计算的 KV 缓存失效并增加延迟。顺序追加则能保持缓存有效。
- 对格式做基准测试。 Markdown、YAML 还是原始文本对特定模型和任务效果更好,是一个实证问题。
- 保护压缩过程。 上下文填满时,系统会截断或总结历史。Meta 的一位安全与对齐负责人曾报告过这样一起事件:一个智能体在压缩了一个极其庞大的收件箱之后,丢失了“删除邮件前须与用户确认”的指令,把收件箱清空了。安全关键指令需要免受自动化裁剪的影响。
递归语言模型(RLM)提供了另一条路径。提示词作为变量存储在 Python 等执行沙箱中,模型检查切片、应用正则表达式并递归地发起子查询,而不是一次读完全部内容。在一项 263k token 的 OOLONG 任务上,基于 GPT-5-mini 构建的 RLM 得分为 51.1%,而 GPT-5 为 34.2%,普通 GPT-5-mini 为 23.2%;即便不使用子调用,它仍达到了 40.9%。
要点与行动
机制与设计规则是一致的。采样设置决定了智能体是可预测还是偏探索,所以代码和数学任务应设低温度,只在开放式工作中才调高。注意力让长上下文代价高昂,超过某个点后还不可靠,所以应把上下文窗口当作预算而非容器。KV 缓存奖励只追加的上下文,惩罚前置插入。线性注意力和混合注意力以检索精度换取效率,这在为长时间运行的智能体选择基础模型时很重要。如今构建智能体的开发者可以从以下几步入手:审核工具列表,把批量数据放到检索之后,按能让缓存存活的方式排列上下文,并编写一个明确的测试来确认安全指令在压缩后依然存在。


