提升AI智能体(代替人执行任务的软件)表现的途径主要有两条:改变送入模型上下文的内容,或者重新训练模型的权重。本文梳理的研究给出了一条实用的分界线。提示词与上下文优化只需数百次试运行(称为rollout)就能收敛,而且适用于只能通过API调用的闭源模型。权重训练对数据需求量大,但在有数千条样本时能够扩展,还能把某项能力迁移到更小、更便宜的模型上。无论走哪条路,都离不开一套可供优化的评测。
为什么靠猜选不出最佳提示词
来看附加在数学题末尾的三种结尾语,它们在谷歌PaLM 2模型上用GSM8K数学基准做了测试。多数人事先都猜不中哪一句会胜出。
| 提示词后缀 | 准确率 |
|---|---|
| “Let's think step by step.”(让我们一步一步思考。) | 71.8% |
| “Take a deep breath and work on this problem step-by-step.”(深呼吸,一步一步解决这个问题。) | 80.2% |
| “Let's combine our numerical command and clear thinking to quickly and accurately decipher the answer.”(让我们结合对数字的掌握和清晰的思路,快速而准确地解出答案。) | 74.5% |
胜出的那句话并非出自人手。它来自OPRO,这是谷歌DeepMind提出的一种方法,由语言模型充当优化器:读取此前的指令及其得分,再提出一条有望得分更高的新指令。对于这类措辞为何有效,一种解释是:模型写出的提示词比人写的更接近模型在训练中见过的文本。
由此得到的教训是:提示词的好坏因模型而异,而且违背直觉,必须靠实测来判断。
优化所需的三个要素
这里所说的优化,是指通过数据和评测指标来表达意图,再交由算法改进系统。它同时需要三样东西:
- **数据:**训练集、任务尝试记录、示范、人工反馈。
- **系统或模型:**语言模型、多步骤工作流或智能体。
- **评测与指标:**精确匹配、通过率、由模型充当评审,或成本与延迟。
更大的通用模型并不能免去这一需求。它们的训练目标是广泛的能力,而实际应用面临“最后一公里”问题:适配专门的工作流。一个把邮件转成日程条目的日历工具就能说明这种差距。提示词写的是“提取日期和时间”,但真实意图还包括一封邮件里有多个事件、时区格式以及符合ISO标准的输出。评测集比文字指令更能体现这些要求。随着模型进步,手工打磨提示词措辞的重要性可能下降,但定义评测看来会是一项长期的基本功。
当你手里有领域数据和评测套件,而期望的行为又难以用一条静态提示词说清时,就值得着手优化。好处包括可靠性、领域适配、借助小模型降低成本和延迟,以及更轻松的升级:新一代模型推出后,用同一套评测集重新跑一遍优化器即可。
优化上下文
上下文优化让模型权重保持冻结,大致分为两大类。
少样本示例
少样本提示是在任务描述中加入带解答的输入输出示例。2022年的一篇论文表明,模型对这些示例的排列顺序高度敏感,而且无需标注就能找到好的顺序。该方法检查模型在一组无标注探测集上的预测是否保持均衡,而不是全部坍缩到同一个答案,这一度量称为全局熵。与随机排序相比,它有时能把准确率提高8%以上。
当示例缺少逐步推理过程时,可以用自举(bootstrapping)来补足。系统让模型在训练题上运行,保留那些得出正确答案的推理轨迹。STaR用这些轨迹对模型做微调;答错时,它把正确答案作为线索交给模型,让模型反推出通往该答案的推理。DSPy框架则是把这些轨迹放进提示词,并在开发集上搜索最佳组合,在GSM8K上的结果往往超过人工编写的推理示例。
指令与反思
MIPROv2分三步同时优化指令和示例:
- 自举生成示范,只保留成功的运行。
- 依据程序代码及其训练数据的摘要来提出指令。
- 用贝叶斯模型搜索各种组合,该模型在小批量数据上更新信念,并定期做完整评测以排除噪声。
在一项鸢尾花分类任务中,优化器把一条平实的指令换成了一条颇具戏剧性的指令,内容是拯救一个濒临灭绝的稀有物种。这样的包装对如今的模型来说已显过时,但它说明胜出的提示词可以多么违背直觉。需要注意一点:除非指标本身做了检查,否则MIPROv2不会验证推理是否站得住脚,因此可以在指标中加入评审模型,防止靠走捷径刷分。
TextGrad走的是另一条路。由一个模型用自然语言对输出写出批评意见,这些反馈再沿流水线的各个组件反向传递。虽然名字如此,其中并不涉及微积分。在一项推理任务上,准确率从77.8%升至91.9%。
GEPA是Genetic Pareto Prompt Evolution的缩写,它维护一个提示词候选池,并在多项任务上为候选打分。它只保留不被其他任何候选支配的候选(即帕累托前沿):如果一条提示词能解决的任务只是另一条提示词所能解决任务的子集,就会被淘汰。随后它通过两种方式产生新候选:让模型反思失败案例并改写提示词,或者在多步骤流水线中合并不同候选里表现最好的模块。
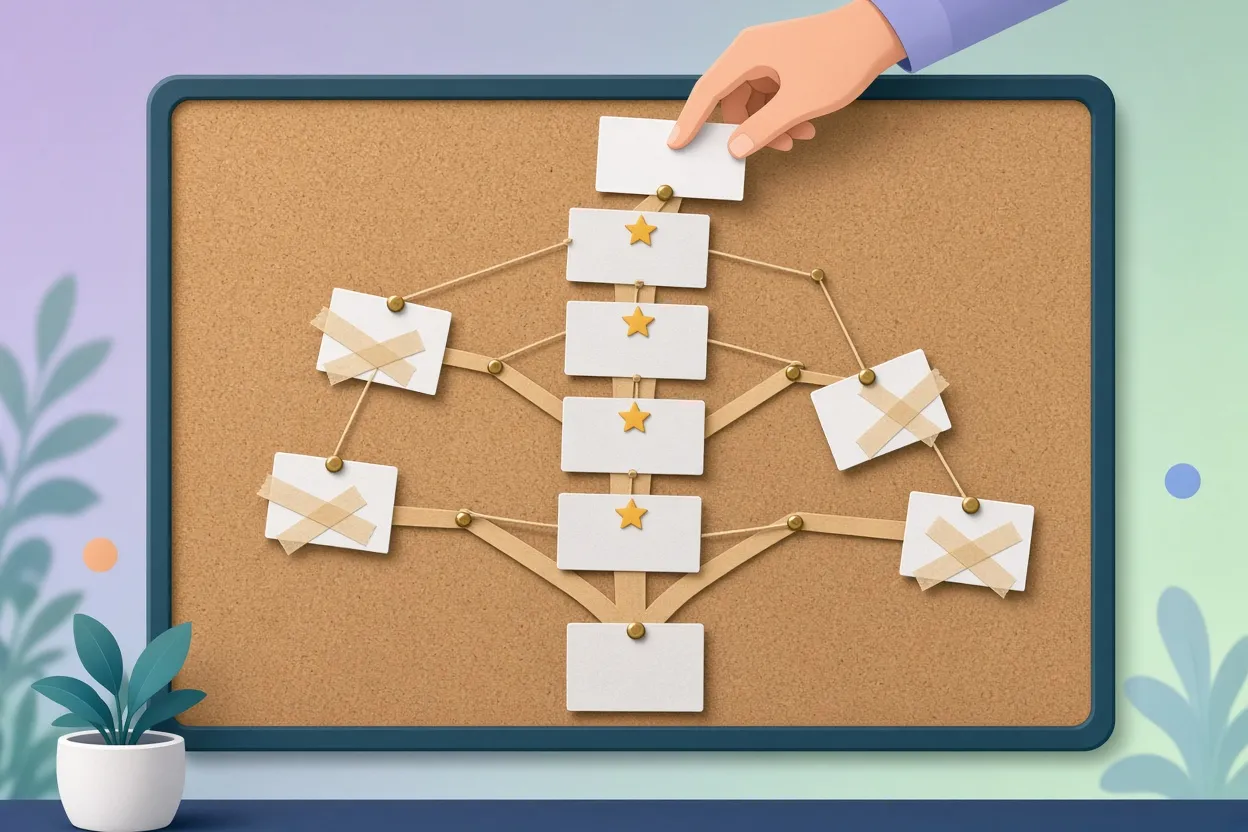
▲ 针对提示词候选的进化搜索
PAPILLON是一条先用本地模型去除查询中的敏感信息、再调用外部模型的流水线。在这条流水线上,GEPA把得分从基线的82.26提升到97.83。提升是分阶段实现的:更全面的隐私策略(87.76)、结构化输出(94.44)、透明的理由说明(94.67),最后是一套详尽的协议。在六项基准上,GEPA相对GPT-4.1 mini基线把综合表现提高了12.19分,加入合并后提高13.33分。
优化权重
监督微调
微调是指针对特定任务对已训练好的模型继续训练。对智能体而言,做法是让能力强的教师模型完成任务,学生模型再在成功的运行记录上训练。这是蒸馏的一种形式,虽然简单,却仍是应用最广的方法之一。
有两项发现值得注意。第一,最强的教师未必最好。学生向能力与自己相近的教师学习,效果往往好于向能力远超自己的模型学习。第二,数据量很重要:随着数据集从316条样本增加到10万条,OpenThoughts-Agent在SWE-bench Verified和Terminal-Bench 2.0上的成绩稳步提升。在FireAct中,一个130亿参数的Llama 2模型用GPT-4的运行记录微调后达到34.4%,高于使用提示词的GPT-3.5的31.4%。
采用GRPO的强化学习
在强化学习(RL)中,模型自己尝试完成任务并获得奖励。奖励需要可验证,最好通过单元测试或沙箱结果来判定,评审模型只作为后备手段。
较早的标准方法近端策略优化(PPO)要在内存中保留四个完整模型,并训练其中两个,包括一个估计每个token贡献的价值模型。组相对策略优化(GRPO)在DeepSeekMath论文中提出,并用于DeepSeek-R1,它去掉了价值模型。它为每条提示词采样一组答案,按每个答案的奖励高于或低于组内平均值多少、再除以组内离散程度来打分。这样内存中只需三个模型,需要训练的只有一个。在MATH基准上经过2,400个训练步后,GRPO达到约55.5%,而PPO各变体为50%至53.5%。
建议的分工是:先做监督微调,建立格式和基本推理能力;等模型越过最低能力门槛后再上RL。当不存在教师时,RL就成为必需,比如前沿模型去攻克尚无人解决的问题。如果RL的效果不如监督微调,就继续用微调。
在策略蒸馏
在策略蒸馏(on-policy distillation)把两种思路结合起来。学生先生成自己的尝试,再由一个权重开放的教师模型为每个token打分。以“5 + (2 * 3) 等于多少?”为例。单纯的微调从不向学生展示如何从自己的错误中恢复。单纯的RL只返回一个零分,不提示这次尝试错在哪里。在策略蒸馏则会标出学生先把5和2相加的那一步。
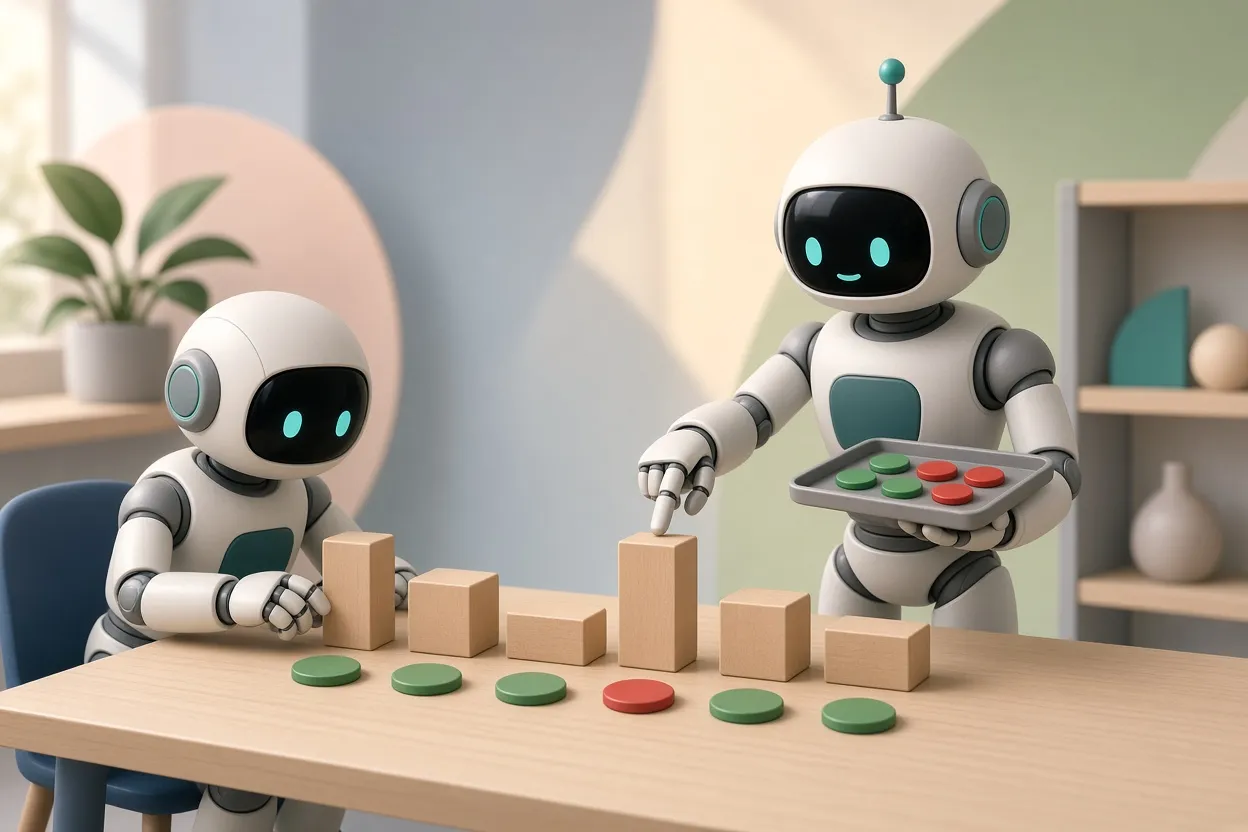
▲ 教师模型的逐步反馈
Qwen3模型系列的数据显示了它的效率:
| 方法 | AIME'24 | GPQA-Diamond | GPU小时 |
|---|---|---|---|
| 离策略蒸馏 | 55.0% | 55.6% | 未说明 |
| 强化学习 | 67.6% | 61.3% | 17,920 |
| 在策略蒸馏 | 74.4% | 63.3% | 1,800 |
优化智能体的智能体
第三条路线是把优化工作交给智能体。Darwin Gödel Machine会改写自身的脚手架,也就是包裹模型并驱动其各步骤运行的外围框架(harness)代码,同时保留一份早期版本的存档供探索。Meta-Harness读取完整的执行日志并写出更好的harness代码,在Terminal-Bench 2.0上达到37.6%的通过率,而Claude Code基线为27.5%。在安德烈·卡帕西(Andrej Karpathy)的autoresearch方法中,智能体修改训练脚本并运行,指标改善就保留改动,否则回滚。一次nanochat运行完成了83项实验,保留了15处改动。
由于智能体会针对被衡量的任何指标去优化,评测的质量和可信度就成了主要瓶颈。
两者如何取舍
| 以下情况选上下文优化 | 以下情况选权重优化 |
|---|---|
| 模型闭源,只能通过API访问 | 较小的模型无法遵循指令 |
| 需要快速、轻量的运行,甚至每天都跑 | 想把能力强的教师蒸馏成更便宜的学生 |
| 与环境的每次交互成本都很高 | 提示词不断累积,造成上下文膨胀 |
| 只有数百次rollout,而非数千次 | 有数千条训练样本 |
两者也可以结合。BetterTogether交替进行提示词优化和微调,并报告称效果好于单独使用任何一种。
接下来该做什么
- 先搭建评测。没有数据、可运行的系统和指标,就没有可优化的对象。
- 不要相信对提示词措辞的直觉。用自己的基准测试各种变体,使用商用API时要多跑几次。
- 如果用的是闭源模型或数据有限,先从GEPA或MIPROv2这类提示词优化器入手。在GEPA报告的结果中,数百次rollout就足以收敛。
- 当你有数千条样本、需要更小的模型,或者提示词已经变得过长时,转向权重训练。从监督微调开始,选一个与学生能力相近的教师,只有在RL胜过微调或没有教师的情况下才加入RL。
- 如果教师的权重是开放的,可以先考虑在策略蒸馏,再考虑纯RL。在Qwen3的案例中,它以大约十分之一的算力取得了更高的分数。
- 保持评测集稳定,这样底层模型一变就能重新运行优化。