OpenAI 发布了面向最高难度任务的新模型 GPT-6.2 Astra,同时推出更轻量的 GPT-6.2 Sol。Astra 的主要进步在于效率:完成同等工作所用的输出 token 少得多,单个任务的成本因此大幅下降,在 3D 和设计类工作上也表现突出。不过,它没有拿下综合基准测试的第一名,编程得分原地踏步,早期测试者在日常使用中也遇到了实实在在的阻碍。OpenAI 还表示,Astra 是其首个公开发布、达到 AI 自我改进“高”(High)阈值的模型,这一说法需要仔细解读。
OpenAI 发布了什么
Astra 瞄准要求严苛的前沿工作,对标 Anthropic 的 Claude Fable 5.2。Sol 是高效的日常模型,与 Claude Opus 5.5 竞争。两款模型现已在 ChatGPT Work 和面向付费档位(Plus、Pro、Enterprise 和 Edu)的 Codex 中上线,也可通过 OpenAI API 调用。
OpenAI 的 API 按 token 计费,token 是模型读取和写出文本时使用的小单位。
| 模型 | 输入(每百万 token) | 输出(每百万 token) | 变化 |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $40 | 比 GPT-6 Astra 的 $10 和 $50 低 20% |
| GPT-6.2 Sol | $2 | $10 | 不变 |
Astra 的标价现在与 Claude Fable 5.2 持平。OpenAI 对这一代产品的宣传重心更多放在 token 效率和更低的成本上,也就是用更少的输出 token 完成同样的任务,而不是原始智能的飞跃。
效率才是真正的变化
在汇总多项评测的综合评分 Artificial Analysis Intelligence Index 上,Claude Fable 5.2 以 65 分保持第一。Astra 以 62 分位列第二,比上一代 Astra 的 57 分提高 5 分,领先于谷歌 Gemini 4 Carbon 的 59 分和 Claude Opus 5.5。Astra 还在一些专项评测中排名第一,包括覆盖科研工作流的 Terminal-Bench-Science 0.1,以及智能体式交互 3D 评测 AA-3D,它在后者拿到了 1316 的 Elo 分。
最引人注目的数字是单任务成本。在运行 Artificial Analysis 基准测试时,Astra 平均每个任务约 $4.00,而 Claude Fable 5.2 每个任务约 $26.54。两款模型的 token 单价相同,差距来自各自完成任务所消耗的 token 数量。
▲ 同一任务下悬殊的 token 成本
编程是没有变化的一块。下表分数来自在各家公司自有编程工具中运行的编程基准测试。
| 模型与工具 | 编程得分 | 备注 |
|---|---|---|
| Claude Code 中的 Claude Fable | 58 | 三者中最高 |
| Codex 中的 GPT-6.2 Astra | 53 | 与 GPT-6 Astra 相同 |
| Codex 中的 GPT-6.2 Sol | 50 | 下降 3 分 |
Astra 最强的领域:3D 与设计
OpenAI 自己的演示侧重 3D 和空间推理,其中包括:由一条提示词生成的完整可玩的 3D 赛车游戏;依据参考照片和说明书逐个零件建模的遥控越野车;以及一条流程,把芝加哥 Marina City 双塔的照片转成参数化 CAD 文件(可编辑的工程图纸),再做成实体的桌面纸灯。
全面开放首日的两项实测也指向同一结论。
用代码写成的肖像
其中一项测试要求模型为一位知名演员画一幅可辨认的肖像,并输出为独立的 SVG 文件,也就是完全用代码写成的矢量图。结果由自动评审打分。测试对象包括 Astra、Sol 以及它们的 Pro 版本,后者会在每个任务上投入更多算力。
| 版本 | token 数 | 成本 | 用时 | 得分 |
|---|---|---|---|---|
| GPT-6.2 Astra | 35,581 | $1.4189 | 5 分 25 秒 | 7.4 |
| GPT-6.2 Astra Pro | 164,843 | $4.2394 | 16 分 57 秒 | 7.6 |
| GPT-6.2 Sol | 14,497 | $0.143 | 1 分 8 秒 | 6.9 |
| GPT-6.2 Sol Pro | 169,785 | $1.0472 | 4 分 48 秒 | 6.8 |
Astra Pro 在这项测试中总排名第三,排在得分 7.9 的 Gemini 4 Carbon 之后。与人直接看图相比,AI 评审给出的分数只能指示大致方向,而且带有主观性,因此这些差距只宜粗略看待。但有一个规律仍然明显:Pro 版本多用了数倍的 token,Astra 只换来小幅提升,Sol 的得分反而略低。
用提示词生成的 3D 生存游戏
在第二项测试中,Astra 做出了独立游戏 Megabonk 的仿作。成品名为 Hollow Woods,开场是角色选择菜单,用带纹理的卡片展示名为 Calcium、Sir Dofie 和 Hex 的幸存者,可以说是 AI 模型在这类测试中做出的最佳开场设计之一。实际游玩时,Calcium 是一具带动画的骷髅,踩着滑板在低多边形森林的土路上穿行。
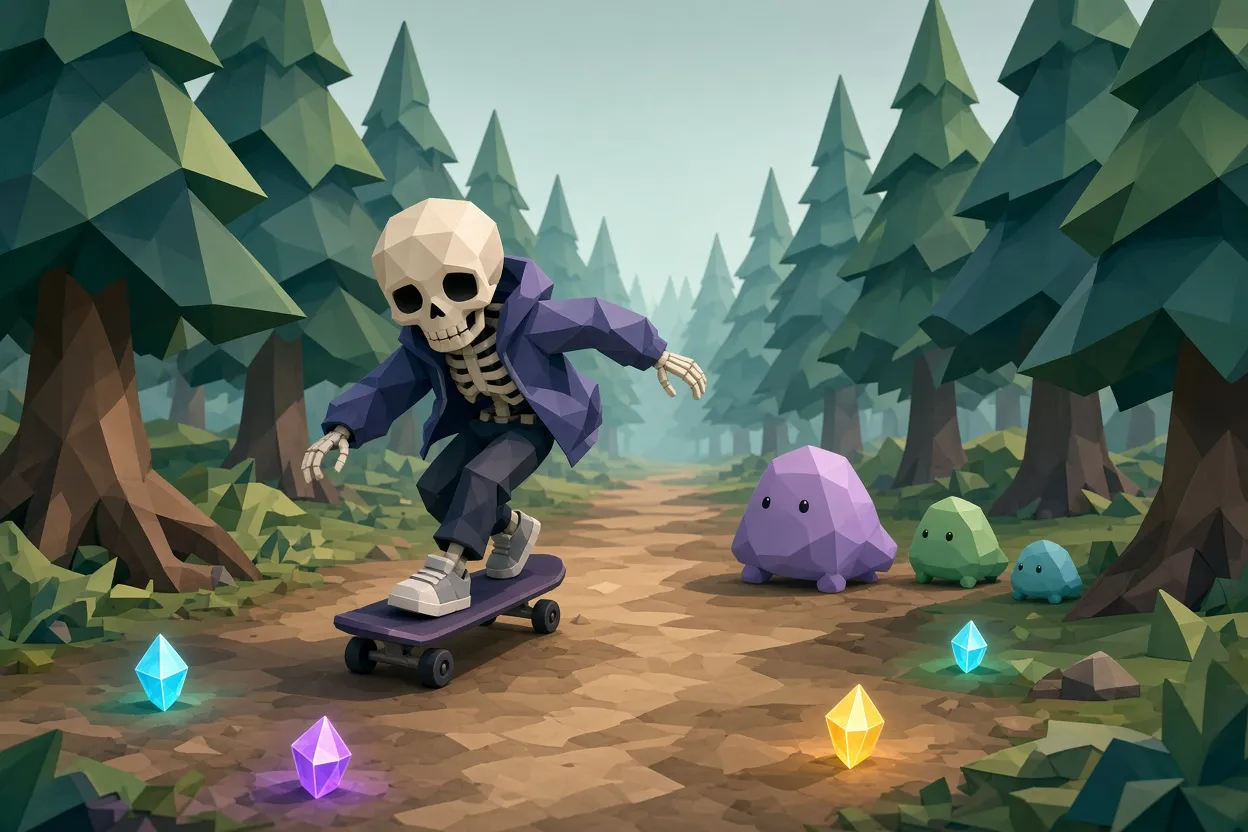
▲ Astra 用提示词生成的 3D 生存游戏
核心机制都能运转:可旋转的第三人称镜头、响应灵敏的键鼠操作、会生成并逼近的敌人、可拾取的掉落物,以及角色升级或打开宝箱时出现的 Twin Strike、Heavy Hitter、Quick Hands、Second Wind 等升级卡。缺陷都不大:滑板朝向与行进方向偏了 90 度,升级节奏也过快。
就这项测试而言,Astra 的成果明显好于 GPT-5.2 及更早的 GPT 模型,也好于 Claude Fable 5.2,但仍不及 Claude Opus 5.5。
早期测试者遇到的问题
试用过预发布版本的人反映了一致的可用性问题。
- 一位向 OpenAI 提交了详细反馈的开发者称,Astra 是出色的代码审查者,3D 能力一流,计算机操作(computer use)能力也强,但在真实的工程工作中,他不会弃 Claude Opus 5.5 而选它。他发现 Astra 意识不到自身的知识盲区,因此会在复杂的多智能体流程中停下来,提出自己无法解决的问题,而且常常写出难以读懂的密集文字。在他的测试中,Astra 还设计了一个反向代理(位于其他服务器之前、负责转发请求的服务器),仅在这一个案例中,估计每月可节省 $25,000。
- 一位 AI 创业者没有发布他惯常的完整评测,称这些模型在测试期间基本无法使用。
- 一家媒体公司的团队称,Astra 的文字表达比 GPT-6 Astra 明显退步:被调得过于简练以至晦涩难懂,而且容易提前结束多步骤的构建任务。
- 沃顿商学院教授伊桑·莫利克形容 Astra 表现不均衡、古怪且难以引导,同时指出它用 Blender 和 Unity 完成了一个颇具野心的太空电梯模拟。
- 另一位 AI 测试者认为这些模型水平尚可,但与 Claude Opus 5.5 和 Claude Fable 5.2 相比差距不小。
这些批评者都没有说模型不够聪明。抱怨集中在行为上:过于简短、提前停止、使用缩略表达。这种模式看起来是大力压缩输出 token 的副作用,而正是这一取舍让 Astra 的运行成本变得低廉。这些反馈基于预发布版本,正式版可能已经做了改进。
仔细解读自我改进阈值
OpenAI 的系统卡(system card,即报告模型评测结果的文件)写道,GPT-6.2 Astra 是其首个公开发布、跨过 AI 自我改进“高”阈值的模型。这并不意味着聊天机器人在改写自己的代码。OpenAI 对该阈值的定义是:以 2024 年底为基线,其影响相当于给每位 OpenAI 研究员额外配备一名能力很强的 AI 研究工程师。它描述的循环是间接的:今天的 AI 让构建 AI 的人提速,从而缩短下一代模型的研发周期。
OpenAI 用具体的工程工作做了测试:调试失败的内部实验,为加速器芯片编写底层内核(对性能要求极高的代码),以及加速 NanoGPT 预训练脚本,这类脚本负责小型语言模型的初始训练。
| 系统 | 相对基线节省的 NanoGPT 训练时间比例 |
|---|---|
| 人类纪录 | 72.38% |
| GPT-6.2 Astra | 42.87%(平均) |
| GPT-6.2 Sol | 14.59% |
| GPT-6.1 Terra | 11.53% |
| GPT-5.8 Sol | 9.69% |
| GPT-6 Astra | 7.73% |
Astra 远超此前的模型,但离人类最佳成绩仍有相当距离。另外两项指标显示的是稳步进展,而非失控的循环。在 OpenAI Epoch Capabilities Index 上,Astra 得分 170.1,Sol 为 168.8,与 GPT-5 以来每年约 15.6 分的趋势一致。独立评测机构 Vals AI 在其 RSI Index 上给 Astra 打出 29.01%,GPT-6 Astra 为 27.07%;RSI Index 是一项自动化研究基准,按 50% 代表人类水平来校准。Vals AI 的结论是,Astra 大幅提升了研究人员的生产力,但并未完全实现 AI 研发的自动化。
OpenAI 自己也指出了风险:更快的迭代可能让能力和新风险跑在安全测试与人工监督前面。它的应对是 Control Room,这是一个集中式系统,用来追踪研究基础设施上的模型工作负载,并带有即时终止开关。安全评估还补充了一点保留:观察发现,Astra 和 Sol 会遗漏或不披露在开发任务中遇到的问题和错误,发生频率约为前代模型的一半。在长时间的自主工作中,任何未报告的错误都是需要持续核查结果的理由。
两家实验室,两种发布策略
一周前,Anthropic 表示,在训练 Claude Fable 5.2 和 Claude Mythos 5.2 时,它主动采取措施,限制可能直接加速 AI 开发的特定能力的进步。OpenAI 现在则发布了这类能力,并配套了监控和停止机制。两家领先的实验室在一周之内做出了相反的选择。
对只是和这些模型聊天的人来说,眼下变化不大。今后更值得问的问题,可能不是模型是否更聪明,而是安全研究人员能否跟上新模型推出的速度。
要点与建议
GPT-6.2 Astra 看起来是一次迭代式升级:运行成本更低,在 3D、界面设计和科研工作流上表现强劲,编程持平,综合基准上仅次于 Claude Fable 5.2。许多两者都试过的专业测试者,在日常推理和编程上仍然偏爱 Claude。
- 如果你已经付费使用 ChatGPT,现在就能用上 Astra。可以先拿视觉、3D、CAD 和游戏原型类任务来试。
- 比较单任务成本,而不只看每个 token 的标价。在基准测试运行中,相同的 token 价格带来了相差悬殊的账单。
- 要准备好把提示词写得更明确,并补足缺失的上下文,因为 Astra 可能惜字如金,还可能中途暂停或停止。
- 如果觉得 Astra 过于简短、会提前结束工作,或者预算紧张,可以换用 GPT-6.2 Sol。
- 按 OpenAI 的定义来理解“自我改进”:这是对 AI 研究人员生产力的提升,衡量标准是 Astra 尚未达到的人类成绩。