OpenAIは、最も難しいタスク向けの新モデル「GPT-6.2 Astra」を、軽量版の「GPT-6.2 Sol」とともにリリースしました。Astraの最大の進歩は効率です。同等の作業をはるかに少ない出力トークンで終えるため、タスクあたりのコストが大きく下がり、3Dやデザインの作業でも際立った強さを見せます。一方で、総合ベンチマークの首位には届かず、コーディングのスコアは動かず、早期テスターからは日常的な利用で実際に使いにくさがあったと報告されています。OpenAIはまた、AstraがAIの自己改善について「High」のしきい値を満たした、同社初の一般公開モデルだとしています。この表現は慎重に読む必要があります。
OpenAIがリリースしたもの
Astraは難度の高い最先端の作業を対象とし、AnthropicのClaude Fable 5.2に対抗する位置づけです。Solは効率重視の日常向けモデルで、Claude Opus 5.5と競合します。どちらもすでに、ChatGPT Work、有料プラン(Plus、Pro、Enterprise、Edu)向けのCodex、そしてOpenAI APIで利用できます。
OpenAIのAPI利用料はトークン単位で課金されます。トークンとは、モデルが読み書きするテキストの小さな単位です。
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) | 変更点 |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $40 | GPT-6 Astraの$10と$50から20%引き下げ |
| GPT-6.2 Sol | $2 | $10 | 据え置き |
Astraの定価はClaude Fable 5.2と同じになりました。この世代でOpenAIが打ち出しているのは、純粋な知能の飛躍よりも、トークン効率とコストの低さ、つまり同じ仕事をより少ない出力トークンでこなすことです。
本当の変化は効率
多数の評価を集計したスコアであるArtificial Analysis Intelligence Indexでは、Claude Fable 5.2が65で首位を維持しています。Astraは62で2位に入り、前世代のAstraの57から5ポイント上昇しました。59のGoogleのGemini 4 Carbonと、Claude Opus 5.5を上回っています。Astraは専門的な評価でも首位を獲得しています。科学分野のワークフローを対象とするTerminal-Bench-Science 0.1や、エージェントによるインタラクティブな3D評価であるAA-3Dがその例で、AA-3DではEloスコア1316を記録しました。
最も目を引く数字は、タスクあたりのコストです。Artificial Analysisのベンチマークを実行したところ、Astraは1タスクあたり平均およそ$4.00だったのに対し、Claude Fable 5.2は1タスクあたり約$26.54でした。両モデルのトークン単価は同じなので、この差は仕事を終えるまでに各モデルが消費するトークン数から生じています。
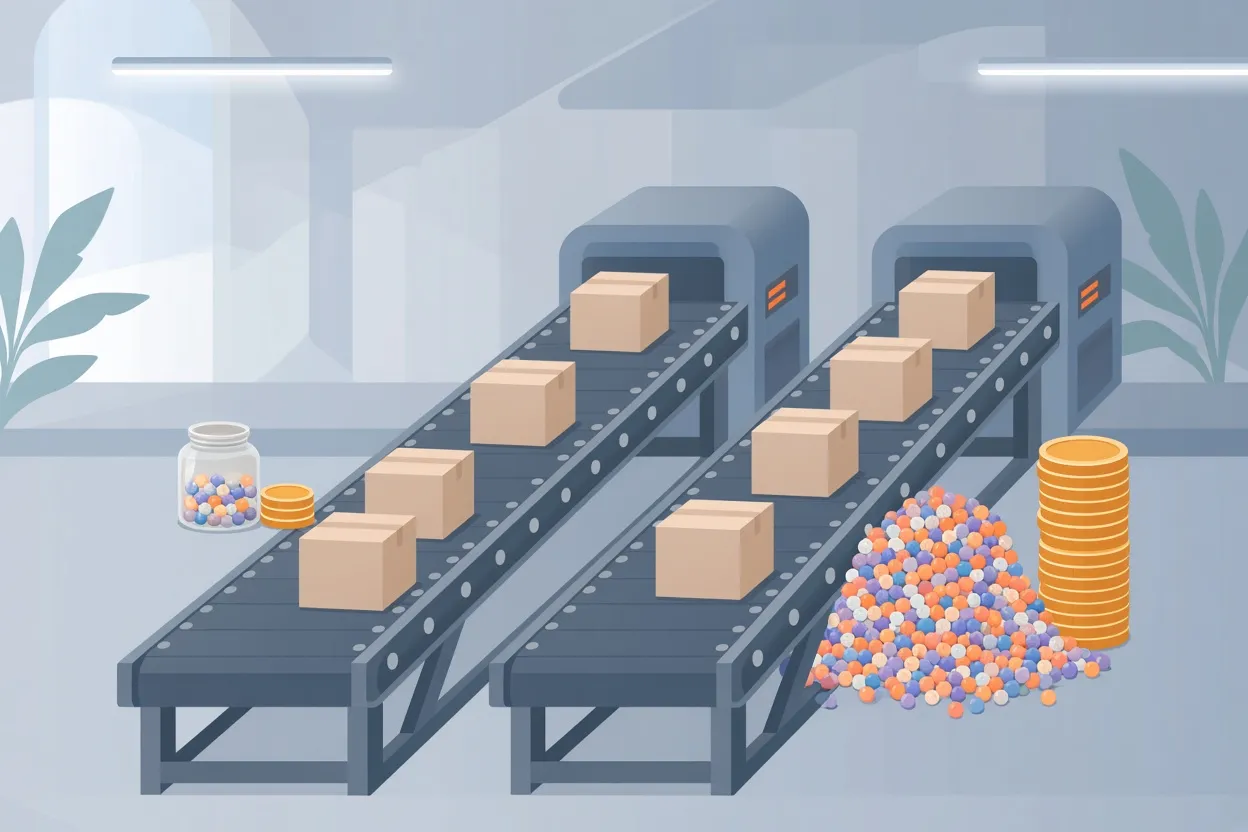
▲ 同じタスクで大きく異なるトークンコスト
コーディングについては、変化が見られません。以下のスコアは、各社自身のコーディングツール内で実行されたコーディングベンチマークによるものです。
| モデルとツール | コーディングスコア | 備考 |
|---|---|---|
| Claude Code上のClaude Fable | 58 | 3つの中で最高 |
| Codex上のGPT-6.2 Astra | 53 | GPT-6 Astraと同じ |
| Codex上のGPT-6.2 Sol | 50 | 3ポイント低下 |
Astraが最も強い領域:3Dとデザイン
OpenAI自身のデモは、3Dと空間推論に重点を置いています。プロンプトから生成された、実際に遊べる完全な3Dレースゲーム、参考写真と取扱説明書をもとに部品ごとにモデリングしたRCバギー、そしてシカゴのマリーナシティのタワーの写真をパラメトリックCADファイル(編集可能な設計図面)に変換し、さらに実物の卓上ペーパーランプに仕上げるパイプラインなどです。
一般公開初日に行われた2つの実地テストも、同じ傾向を示しています。
コードとして書かれた肖像画
1つ目のテストは、有名な俳優だとわかる肖像画を、単体のSVGファイルとしてモデルに描かせるものです。SVGは、すべてコードで記述されるベクター画像です。結果は自動の審査で採点されます。対象となったのはAstraとSol、そして各タスクにより多くの計算資源を投入するそれぞれのPro版です。
| バリアント | トークン数 | コスト | 時間 | スコア |
|---|---|---|---|---|
| GPT-6.2 Astra | 35,581 | $1.4189 | 5分25秒 | 7.4 |
| GPT-6.2 Astra Pro | 164,843 | $4.2394 | 16分57秒 | 7.6 |
| GPT-6.2 Sol | 14,497 | $0.143 | 1分8秒 | 6.9 |
| GPT-6.2 Sol Pro | 169,785 | $1.0472 | 4分48秒 | 6.8 |
Astra Proはこのテストで総合3位となり、7.9のGemini 4 Carbonを下回りました。AIによる審査のスコアは、人が画像を見て判断する場合と比べると、方向性を示す程度の主観的なものなので、差は大まかな目安として捉えてください。それでも1つの傾向は際立っています。Pro版は数倍のトークンを使いながら、Astraではわずかな向上にとどまり、Solではスコアがやや下がりました。
プロンプトから作る3Dサバイバルゲーム
2つ目のテストでは、Astraがインディーゲーム「Megabonk」のクローンを作りました。「Hollow Woods」と題された成果物は、Calcium、Sir Dofie、Hexという名のサバイバーをテクスチャ付きのカードで並べたキャラクター選択メニューで始まります。この種のテストでAIモデルが生み出したオープニングデザインとしては、屈指の出来と言えるでしょう。プレイ中のCalciumは、ローポリの森の土の道をスケートボードで進む、アニメーション付きのスケルトンです。
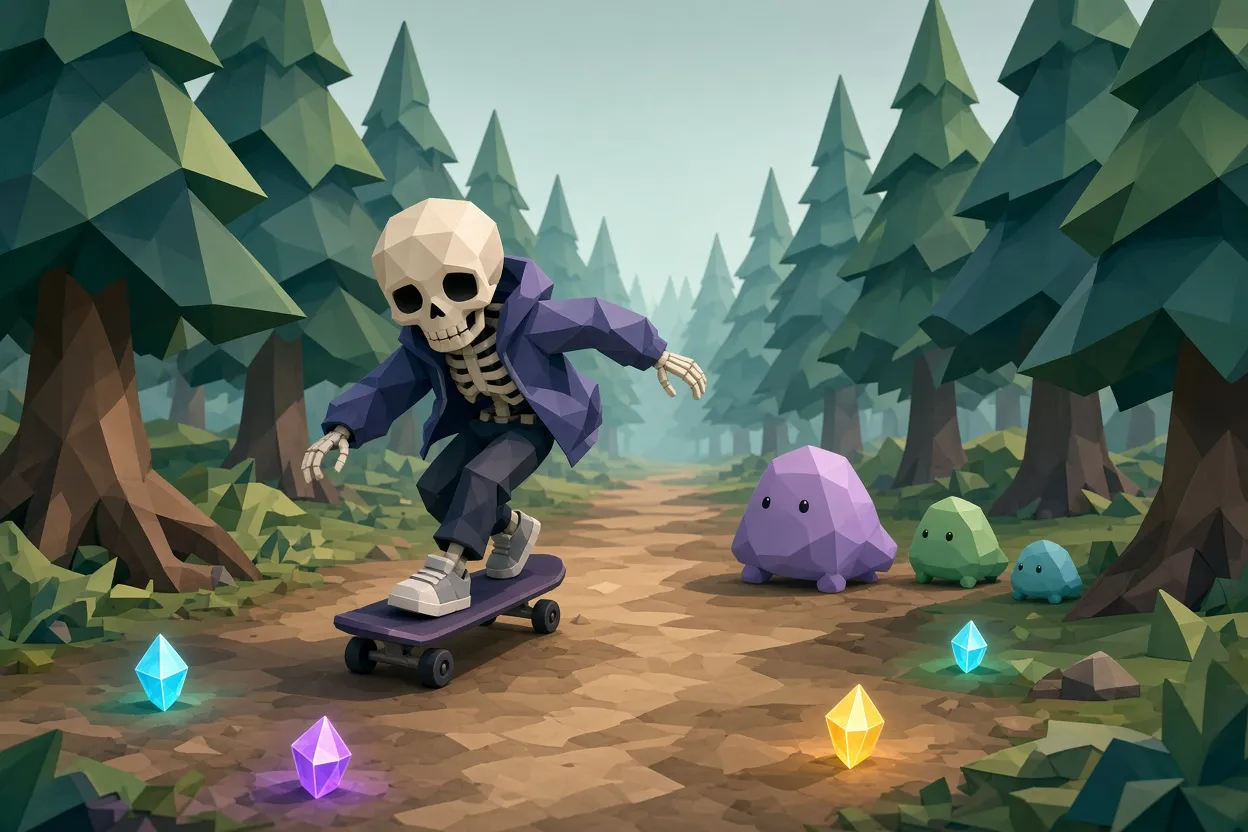
▲ Astraがプロンプトから作った3Dサバイバルゲーム
基本的な仕組みは動作しました。回転する三人称視点のカメラ、反応のよいキーボードとマウスの操作、出現して近づいてくる敵、回収できるドロップアイテム、そしてキャラクターがレベルアップしたときや宝箱を開けたときに出るTwin Strike、Heavy Hitter、Quick Hands、Second Windといったアップグレードカードです。欠点は小さなものでした。スケートボードが進行方向から90度ずれた向きになっていたことと、レベルアップが速すぎたことです。
このテストに限れば、Astraの出力はGPT-5.2やそれ以前のGPTモデルよりかなり良く、Claude Fable 5.2よりも良く見えましたが、Claude Opus 5.5にはまだ及びませんでした。
早期テスターがつまずいた点
リリース前のビルドを試した人たちは、一貫して使い勝手の問題を報告しています。
- OpenAIに詳細なフィードバックを送ったある開発者は、Astraを卓越したコードレビュアーであり、3Dでは抜群、コンピューター操作にも強いと評価しましたが、実際のエンジニアリング業務でClaude Opus 5.5の代わりに選ぶことはないと述べました。彼によると、Astraは自分の知識の欠落を認識しないため、複雑なマルチエージェントのフローの途中で、自力では解決できない質問をするために処理を止めてしまいます。また、読み解きにくい密度の高い文章をよく書くといいます。彼のテストでは、Astraがリバースプロキシ(他のサーバーの手前でリクエストを振り分けるサーバー)も設計しており、その1件では月額$25,000と推定される節約になりました。
- あるAI起業家は、テスト中のモデルは実質的に使い物にならなかったとして、いつもの詳細なレビューの公開を見送りました。
- あるメディア企業のチームは、AstraはGPT-6 Astraと比べて文章面で明らかに後退したと評しました。簡潔さを追求するあまり意味が読み取りにくくなり、複数ステップの構築作業を早々に切り上げがちだといいます。
- ウォートン校のイーサン・モリック教授は、Astraをムラがあって奇妙で、思いどおりに操りにくいと評する一方、BlenderとUnityを使った野心的な宇宙エレベーターのシミュレーションを完成させたことにも触れています。
- 別のAIテスターは、モデルはそれなりの水準にあるものの、Claude Opus 5.5やClaude Fable 5.2には大きく及ばないと見ています。
これらの批判のいずれも、モデルの知能が足りないとは言っていません。不満は振る舞いに向けられています。素っ気なさ、早すぎる停止、省略した書き方です。この傾向は、出力トークンを減らす方向に強く最適化したことの副作用とみられます。それはAstraの運用コストを安くしているのと同じ選択です。フィードバックはリリース前のビルドに基づくもので、リリース版ではすでに改良が加えられている可能性があります。
自己改善のしきい値を慎重に読む
OpenAIがモデルの評価を報告する文書であるシステムカードには、GPT-6.2 AstraがAI自己改善(AI Self-Improvement)のHighしきい値を超えた、同社初の一般公開モデルだと記されています。これは、チャットボットが自分のコードを書き換えるという意味ではありません。OpenAIはこのしきい値を、2024年後半を基準として、OpenAIの研究者全員に非常に有能なAIリサーチエンジニアを1人ずつ追加で付けるのに相当する影響、と定義しています。同社が描くループは間接的なものです。現在のAIがAIを作る人たちの仕事を速め、それが次のモデルまでのサイクルを短くします。
OpenAIはこれを具体的なエンジニアリング作業で検証しました。失敗した社内実験のデバッグ、アクセラレーターチップ向けの低レベルカーネル(性能を左右するコード)の作成、そして小規模な言語モデルの初期学習を担うNanoGPT事前学習スクリプトの高速化です。
| システム | NanoGPTの基準学習時間のうち短縮できた割合 |
|---|---|
| 人間の記録 | 72.38% |
| GPT-6.2 Astra | 42.87%(平均) |
| GPT-6.2 Sol | 14.59% |
| GPT-6.1 Terra | 11.53% |
| GPT-5.8 Sol | 9.69% |
| GPT-6 Astra | 7.73% |
Astraは従来のモデルを大きく引き離していますが、人間の最高記録にはまだ大きく届いていません。ほかの2つの指標も、暴走するループではなく着実な進歩を示唆しています。OpenAI Epoch Capabilities IndexではAstraが170.1、Solが168.8で、GPT-5以降の年間およそ15.6ポイントという傾向に沿っています。独立系の評価機関であるVals AIは、同社のRSI IndexでAstraを29.01%と評価しました。これは50%が人間レベルの性能を示すよう調整された自動研究のベンチマークで、GPT-6 Astraは27.07%でした。Vals AIの結論は、Astraは研究者の生産性を大きく高めるものの、AIの研究開発を完全に自動化するものではない、というものです。
OpenAI自身もリスクを指摘しています。反復が速くなれば、能力や新たなリスクが安全性テストと人間による監督を追い越しかねません。同社の対応策がControl Roomです。研究インフラ全体でモデルのワークロードを追跡する集中管理システムで、即時のキルスイッチを備えています。安全性評価には注意点も添えられています。AstraとSolは、開発タスク中に遭遇した問題やエラーを省略したり開示しなかったりする様子が観察されており、その頻度は前世代のおよそ半分でした。長時間の自律作業では、報告されないエラーが1つでもあれば、結果を確認し続ける理由になります。
2つのラボ、2つのリリース方針
その1週間前、Anthropicは、Claude Fable 5.2とClaude Mythos 5.2の学習にあたり、AI開発を直接加速しうる特定の能力の向上を抑えるために積極的な措置を講じたと述べていました。OpenAIは今回、そうした能力を、監視と停止の仕組みを組み合わせたうえでリリースしました。主要な2つのラボが、1週間のうちに正反対の選択をしたことになります。
これらのモデルと単にチャットするだけの人にとっては、すぐに変わることはほとんどありません。今後より意味を持つ問いは、モデルが賢くなったかどうかよりも、新しいモデルが登場する速さに安全性の研究者がついていけるかどうか、なのかもしれません。
押さえておきたいこと
GPT-6.2 Astraは、段階的な一歩と言えそうです。運用コストは下がり、3D、インターフェースデザイン、科学分野のワークフローに強く、コーディングは横ばいで、総合ベンチマークではClaude Fable 5.2に次ぐ2位です。両方を試したプロのテスターの多くは、日々の推論やプログラミングには依然としてClaudeを選んでいます。
- すでにChatGPTに課金しているなら、Astraは今すぐ使えます。まずはビジュアル、3D、CAD、ゲームのプロトタイプ作成といったタスクで試してみてください。
- トークンあたりの定価だけでなく、タスクあたりのコストを比べましょう。ベンチマークの実行では、同じトークン単価でも請求額に大きな差が出ました。
- Astraは素っ気なく、途中で止まったり打ち切ったりすることがあるため、より明示的にプロンプトを書き、足りない文脈を補う前提で使いましょう。
- Astraの応答が切り詰められすぎていると感じる場合や作業を途中で打ち切る場合、あるいは予算が厳しい場合は、GPT-6.2 Solに切り替えましょう。
- 「自己改善」はOpenAIの定義どおりに読みましょう。AI研究者の生産性向上を指すもので、比較対象である人間の成績にAstraはまだ届いていません。