AIエージェント(人に代わってタスクを実行するソフトウェア)の性能を高める方法は、大きく分けて2つあります。モデルのコンテキストに入れる内容を変えるか、モデルの重みを再学習するかです。ここで取り上げる研究からは、実用的な使い分けが見えてきます。プロンプトやコンテキストの最適化は、ロールアウトと呼ばれる試行を数百回重ねるうちに収束することがあり、APIでしか使えないクローズドなモデルにも適用できます。重みの学習は大量のデータを必要としますが、数千件の例があればスケールし、能力をより小型で安価なモデルに移すこともできます。どちらの方法も、最適化の基準となる評価がなければ機能しません。
最良のプロンプトを勘で当てられない理由
数学の問題の末尾に付け加える3種類の文言を、GoogleのPaLM 2モデルと数学ベンチマークGSM8Kで試した例を見てみましょう。どれが最も良い成績になるかを事前に言い当てられる人は、ほとんどいません。
| プロンプトの末尾に加える文言 | 精度 |
|---|---|
| 「Let's think step by step.」(一歩ずつ考えましょう。) | 71.8% |
| 「Take a deep breath and work on this problem step-by-step.」(深呼吸をして、この問題に一歩ずつ取り組みましょう。) | 80.2% |
| 「Let's combine our numerical command and clear thinking to quickly and accurately decipher the answer.」(数字を扱う力と明晰な思考を合わせて、素早く正確に答えを解き明かしましょう。) | 74.5% |
最も成績の良かった文言は、人が書いたものではありません。Google DeepMindの手法であるOPROが生み出したものです。OPROでは言語モデルが最適化器の役割を担い、過去の指示文とそのスコアを読んだうえで、より高いスコアを狙った新しい指示文を提案します。こうした言い回しが効く理由としては、モデルが書いたプロンプトのほうが、人が書いたものよりも、モデルが学習時に目にしたテキストに近いからだという説明が挙げられています。
ここから得られる教訓は、プロンプトの良し悪しはモデルごとに異なり、直感に反するということです。測定して確かめるしかありません。
最適化に必要な3つの要素
ここでいう最適化とは、データと評価指標によって意図を指定し、あとはアルゴリズムにシステムを改善させることを指します。そのためには、次の3つが同時にそろっている必要があります。
- データ: 学習用データセット、タスク実行の記録、デモンストレーション、人によるフィードバック。
- システムまたはモデル: 言語モデル、複数ステップのワークフロー、またはエージェント。
- 評価と指標: 完全一致、合格率、審査役を務めるモデル、あるいはコストやレイテンシー。
汎用モデルが大型化しても、この必要性はなくなりません。汎用モデルは幅広い能力を身につけるように学習されていますが、実際のアプリケーションは、専門的なワークフローに適応させるという「ラストワンマイル」の問題に直面します。メールを予定に変換するカレンダーツールが、このずれをよく示しています。プロンプトには「日付と時刻を抽出せよ」と書かれていても、本当の意図には、1通のメールに複数の予定が含まれる場合への対応、タイムゾーンの書式、ISO準拠の出力まで含まれます。こうした要件は、文章による指示よりも評価セットのほうがうまく捉えられます。プロンプトの文言を手作業で調整することの重要性は、モデルの進歩とともに薄れていくかもしれませんが、評価を定義する作業は今後も残り続ける技能だと考えられます。
最適化に着手する価値があるのは、ドメインのデータと評価スイートがあり、かつ求める挙動を1つの静的なプロンプトでは表現しにくい場合です。得られる利点には、信頼性、ドメインへの適応、小型モデルによるコストとレイテンシーの低減、そしてアップグレードのしやすさがあります。新しい世代のモデルが登場したら、同じ評価セットに対して最適化器をもう一度実行すればよいのです。
コンテキストを最適化する
コンテキスト最適化では、モデルの重みは固定したままにします。大きく2つの系統があります。
Few-shotの例
Few-shotプロンプティングは、タスクの説明に、入力と出力をセットにした解答例を加える手法です。2022年のある論文は、モデルがこうした例の並び順に非常に敏感であること、そして良い並び順はラベルなしでも見つけられることを示しました。この手法では、ラベルのないプロービング用のセットに対するモデルの予測が、1つの答えに偏ることなくバランスを保っているかどうかを調べます。この尺度はグローバルエントロピーと呼ばれます。ランダムな並び順に比べて、精度が8%を超えて向上することもありました。
例に段階的な推論が含まれていない場合は、ブートストラップがその穴を埋めます。システムは学習用の問題でモデルを実行し、正答にたどり着いた推論のトレースを残します。STaRは、こうしたトレースでモデルをファインチューニングします。答えが誤っていた場合は、正答をヒントとしてモデルに与え、その答えに至る推論を組み立て直させます。一方、DSPyフレームワークはトレースをプロンプトに配置し、開発セット上で最良の組み合わせを探索します。GSM8Kでは、人が書いた推論例を上回る結果になることも少なくありません。
指示文とリフレクション
MIPROv2は、指示文と例を次の3段階でまとめて最適化します。
- 成功した実行だけを残して、デモンストレーションをブートストラップします。
- プログラムのコードと学習データの要約に基づいて、指示文を提案します。
- ベイズモデルで組み合わせを探索します。このモデルは小さなバッチで信念を更新し、ノイズの影響を排除するために定期的に全件評価を行います。
アヤメの花の分類タスクでは、最適化器が簡素な指示文を、希少種を絶滅から救うという劇的な内容の指示文に置き換えました。このような演出は最近のモデルには古めかしく感じられますが、成績の良いプロンプトがいかに直感に反するものになりうるかを示しています。注意点が1つあります。MIPROv2は、指標が確認しないかぎり、推論が妥当かどうかを確認しません。そのため、スコアを不正に稼ぐ近道を防ぐには、審査役のモデルを指標に加えるという手があります。
TextGradは別のアプローチをとります。モデルが出力に対する批評を自然言語で書き、そのフィードバックがパイプラインの各コンポーネントを逆方向にさかのぼって伝わっていきます。名前とは裏腹に、微積分は使いません。ある推論タスクでは、精度が77.8%から91.9%に上がりました。
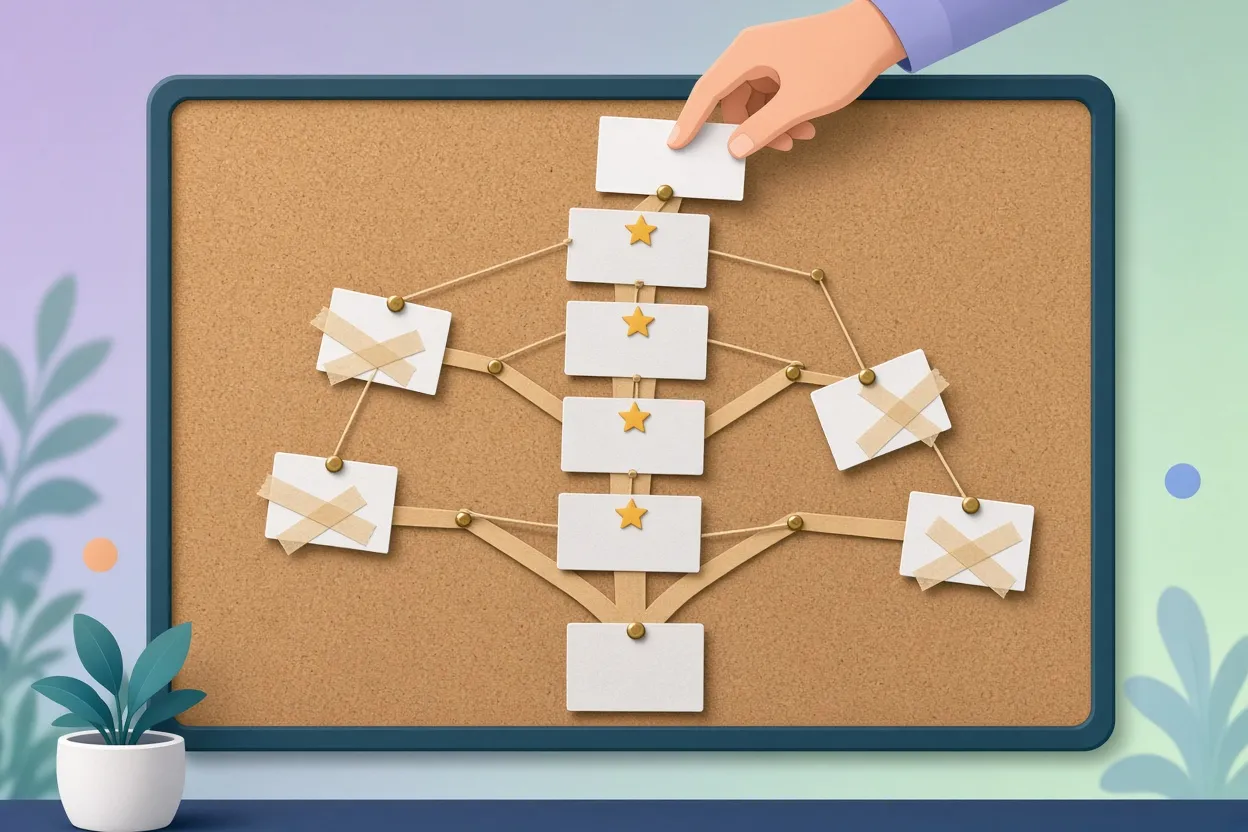
GEPA(Genetic Pareto Prompt Evolutionの略)は、多数のタスクでスコアを付けたプロンプト候補のプールを保持します。残すのは、ほかのどの候補にも支配されない候補(パレートフロンティア)だけです。別のプロンプトが解けるタスクの一部しか解けないプロンプトは、取り除かれます。そのうえで、モデルに失敗を振り返らせてプロンプトを書き直させるか、複数ステップのパイプラインで異なる候補から最良のモジュールをマージするかのいずれかによって、新しい候補を作ります。
▲ プロンプト候補の進化的探索
PAPILLONは、外部のモデルを呼び出す前に、ローカルモデルでクエリから機微な情報を取り除くパイプラインです。GEPAはこのPAPILLONで、スコアをベースラインの82.26から97.83に引き上げました。改善は段階的に進みました。より幅広いプライバシー戦略(87.76)、構造化された出力(94.44)、透明性のある根拠の提示(94.67)、そして網羅的なプロトコルという順です。6つのベンチマーク全体では、GEPAはGPT-4.1 miniのベースラインに対して総合性能を12.19ポイント、マージを併用した場合は13.33ポイント改善しました。
重みを最適化する
教師ありファインチューニング
ファインチューニングとは、学習済みのモデルを特定の用途に向けてさらに学習させることです。エージェントの場合は、有能な教師モデルがタスクをこなし、成功した実行結果を使って生徒モデルが学習します。これは蒸留の一種で、単純ではあるものの、今なお最も広く使われている手法の1つです。
注目すべき知見が2つあります。1つ目は、最も強力な教師が常に最良とは限らないことです。生徒は多くの場合、はるかに高性能なモデルよりも、自分の能力に近い教師から学ぶほうがうまくいきます。2つ目は、データ量が重要だということです。OpenThoughts-AgentによるSWE-bench VerifiedとTerminal-Bench 2.0の結果は、データセットが316サンプルから10万サンプルに増えるにつれて着実に向上しています。FireActでは、GPT-4の実行結果でファインチューニングした130億パラメータのLlama 2モデルが34.4%に達し、プロンプトで動かしたGPT-3.5の31.4%を上回りました。
GRPOによる強化学習
強化学習(RL)では、モデルが自らタスクに挑み、報酬を受け取ります。報酬は検証可能でなければなりません。理想的にはユニットテストやサンドボックスの実行結果で確かめ、審査役のモデルはあくまで代替手段とします。
従来の標準だったProximal Policy Optimization(PPO)は、4つの完全なモデルをメモリ上に保持し、そのうち2つを学習させます。その1つが、各トークンの寄与を推定する価値モデルです。DeepSeekMathの論文で提案され、DeepSeek-R1にも使われたGroup Relative Policy Optimization(GRPO)は、この価値モデルをなくしました。プロンプトごとに複数の回答をグループとしてサンプリングし、各回答の報酬がグループ平均をどれだけ上回るか、または下回るかを、グループのばらつきで割った値でスコアを付けます。これにより、メモリ上のモデルは3つ、学習させるモデルは1つで済みます。MATHベンチマークで2,400ステップの学習を行ったところ、GRPOは約55.5%に達し、PPOの各種バリエーションは50%~53.5%でした。
推奨される役割分担は次のとおりです。まず教師ありファインチューニングで書式と基本的な推論を身につけさせ、モデルが最低限の能力水準を超えたらRLに進みます。RLが不可欠になるのは、誰も解いたことのない問題に取り組む最先端モデルのように、教師が存在しない場合です。RLの成績が教師ありファインチューニングを下回るなら、ファインチューニングにとどまるべきです。
オンポリシー蒸留
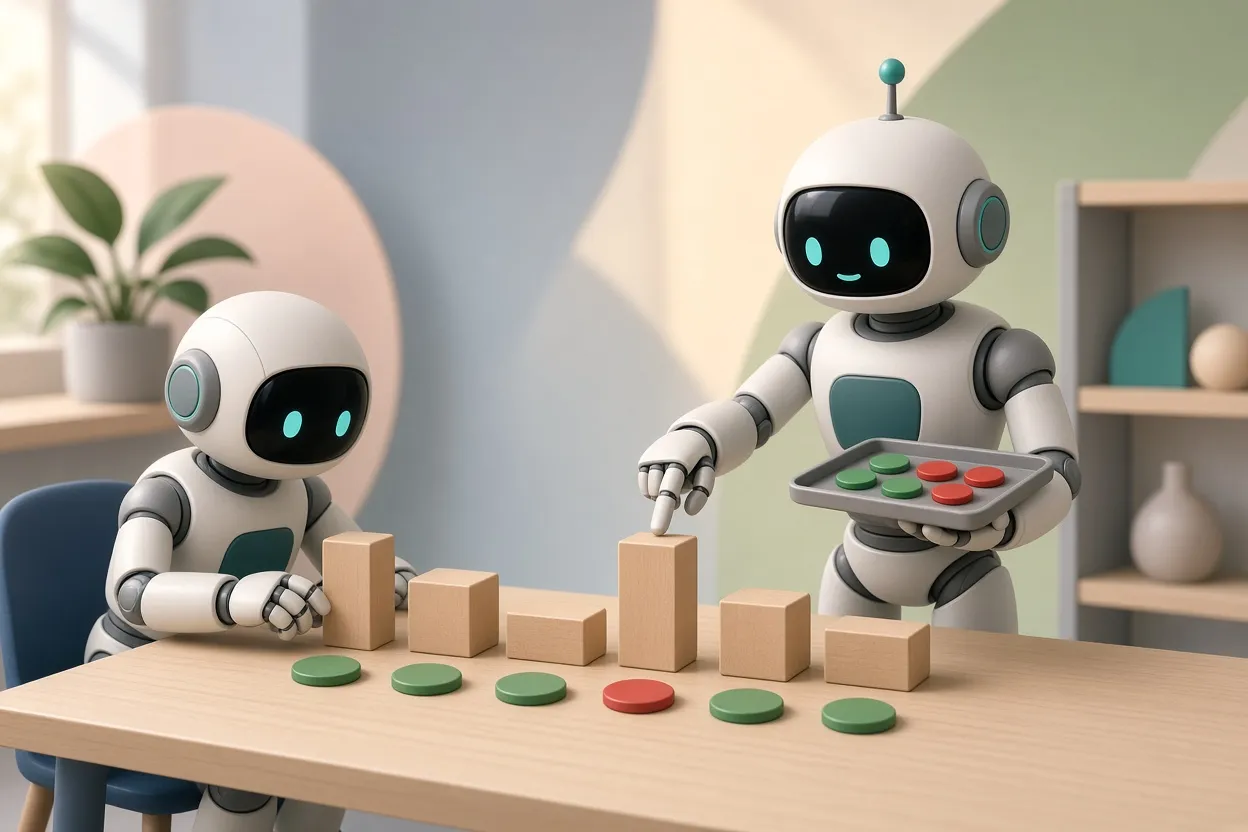
オンポリシー蒸留は、この2つの考え方を組み合わせたものです。生徒が自分で解答を生成し、重みが公開されている教師モデルがすべてのトークンを採点します。「5 + (2 * 3) はいくつですか」という問題を例に考えてみましょう。単なるファインチューニングでは、生徒は自分の誤りから立て直す方法を教わる機会がありません。単なるRLでは、0点が返ってくるだけで、どこで間違えたのかの手がかりはありません。オンポリシー蒸留なら、生徒が先に5と2を足してしまった、まさにそのステップを指摘できます。
▲ 教師モデルによるステップごとのフィードバック
Qwen3モデルシリーズの数値が、その効率の高さを示しています。
| 手法 | AIME'24 | GPQA-Diamond | GPU時間 |
|---|---|---|---|
| オフポリシー蒸留 | 55.0% | 55.6% | 記載なし |
| 強化学習 | 67.6% | 61.3% | 17,920 |
| オンポリシー蒸留 | 74.4% | 63.3% | 1,800 |
エージェントを最適化するエージェント
第3の道は、最適化そのものをエージェントに任せることです。Darwin Gödel Machineは、自分自身のスキャフォールディング、つまりモデルを包んでその各ステップを実行するハーネスのコードを書き換え、過去のバージョンをアーカイブとして保持して探索に使います。Meta-Harnessは、実行ログの全体を読んでより良いハーネスコードを書き、Terminal-Bench 2.0で37.6%の合格率に達しました。Claude Codeのベースラインは27.5%です。アンドレイ・カルパシー氏のautoresearchのアプローチでは、エージェントが学習スクリプトを編集して実行し、指標が改善すれば変更を残し、改善しなければ元に戻します。nanochatでのある実行では、83件の実験を終え、15件の変更が残されました。
エージェントは、測定の対象になっているものなら何でも最適化します。そのため、評価の質と健全性が最大のボトルネックになります。
2つの方法の選び方
| コンテキスト最適化を選ぶ場合 | 重みの最適化を選ぶ場合 |
|---|---|
| モデルがクローズドで、API経由でしか利用できない | 小型モデルが指示に従えない |
| 毎日でも回せるほど高速で軽量な実行が必要 | 有能な教師を安価な生徒に蒸留したい |
| 環境とのやり取り1回ごとのコストが高い | プロンプトが積み重なってコンテキストが肥大化している |
| ロールアウトが数千回ではなく数百回分しかない | 学習用の例が数千件ある |
両者を組み合わせることもできます。BetterTogetherはプロンプト最適化とファインチューニングを交互に行い、どちらか一方だけの場合よりも良い結果が得られたと報告しています。
次に取るべき行動
- まず評価を作ります。データ、動作するシステム、指標がなければ、最適化する対象がありません。
- プロンプトの文言についての直感を信用しないでください。複数の案を自分のベンチマークで試し、商用APIを使う場合は試行を複数回繰り返します。
- クローズドなモデルを使う場合やデータが限られている場合は、GEPAやMIPROv2などのプロンプト最適化器から始めます。GEPAの報告結果では、数百回のロールアウトで十分に収束しました。
- 数千件の例がある場合、より小型のモデルが必要な場合、プロンプトが長くなりすぎた場合は、重みの学習に移ります。教師ありファインチューニングから始め、生徒に近い教師を選び、RLはファインチューニングを上回る場合か教師が存在しない場合にだけ加えます。
- 教師の重みが公開されているなら、純粋なRLの前にオンポリシー蒸留を検討します。Qwen3の事例では、およそ10分の1の計算量でより高いスコアを出しました。
- 基盤となるモデルが変わるたびに最適化をやり直せるよう、評価セットは安定した状態で維持します。