OpenAI가 새 모델 GPT-6.2 Astra와 GPT-6.2 Sol을 내놨습니다. 이번 세대는 지능이 크게 뛰었다기보다, 같은 일을 더 적은 출력 token(모델이 글을 읽고 쓸 때 세는 처리 단위)으로 끝내 비용을 낮추는 데 초점을 맞췄습니다. 또 발표 문서 안쪽에는 Astra가 OpenAI의 공개 모델 가운데 처음으로 'AI 자기 개선 High 기준'을 충족했다는 내용이 들어 있습니다. 출시 직후 시점에서 이 모델이 실제로 바꾼 것과 바꾸지 않은 것을 나눠 정리합니다.
두 모델의 역할과 가격
Astra는 난도가 높은 최전선 작업용이고, Sol은 일상 작업을 맡는 효율형 모델입니다. Astra는 Anthropic의 Claude Fable 5.2에, Sol은 Claude Opus 5.5에 대응하는 모델입니다.
| 모델 | 역할 | 입력 token 100만 개당 | 출력 token 100만 개당 | 가격 변화 |
|---|---|---|---|---|
| GPT-6.2 Astra | 고난도 작업 | $8 | $40 | 이전 GPT-6 Astra($10, $50)보다 20% 인하 |
| GPT-6.2 Sol | 일상 작업 | $2 | $10 | 동결 |
Astra의 가격은 Claude Fable 5.2와 같습니다. 두 모델 모두 ChatGPT Work, 유료 요금제(Plus, Pro, Enterprise, Edu)의 Codex, OpenAI API에서 바로 쓸 수 있습니다.
순위는 2위, 작업당 비용은 약 $4 대 $26.54
benchmark(성능 비교 시험) 결과를 모아 보여 주는 Artificial Analysis의 Intelligence Index에서 Astra는 62점으로 2위에 올랐습니다. 이전 Astra의 57점보다 5점 높고 Google의 Gemini 4 Carbon(59점)보다 앞서지만, 1위는 여전히 65점의 Claude Fable 5.2입니다.
분야별로 보면 강점과 약점이 뚜렷합니다.
| 항목 | GPT-6.2 Astra | 비교 대상 |
|---|---|---|
| 종합 지수 | 62점(2위) | Claude Fable 5.2 65점(1위) |
| 과학 작업(Terminal-Bench-Science 0.1) | 1위 | - |
| 3D 작업(AA-3D) | 1위 | - |
| benchmark 작업당 평균 비용 | 약 $4.00 | Claude Fable 5.2 약 $26.54 |
| 코딩 점수 | Codex에서 53점(이전 Astra와 동일) | Claude Code의 Claude Fable 58점 |
가장 눈에 띄는 숫자는 작업당 비용입니다. token 단가는 두 모델이 같은데, 같은 benchmark 작업을 끝내는 데 든 비용은 Astra가 약 $4.00, Fable 5.2가 약 $26.54였습니다. 출력 token을 훨씬 적게 쓰기 때문입니다. 반면 코딩 점수는 제자리였고, Sol은 50점으로 오히려 3점 내려갔습니다.
▲ 같은 작업의 비용 격차
사전 테스터들이 지적한 사용성 문제
출시 전 버전을 써 본 사람들의 반응은 꽤 차가웠습니다. 주요 지적은 다음과 같습니다.
- 한 개발자는 Astra가 코드 리뷰에 뛰어나고 3D와 computer use(AI가 컴퓨터를 직접 조작하는 기능)에도 강하다고 평가했습니다. 테스트 중 Astra가 설계한 reverse proxy(서버 앞에서 요청을 대신 받아 넘기는 중계 서버)로 월 $2만 5,000의 비용을 아낄 수 있었다는 사례도 전했습니다. 그런데도 실제 엔지니어링 작업에는 Claude Opus 5.5를 택하겠다고 했습니다. 자신이 무엇을 모르는지 파악하지 못해 여러 agent(여러 단계를 스스로 수행하는 AI)가 얽힌 작업 도중 스스로 풀 수 없는 질문을 던지며 멈추고, 읽기 어려울 만큼 빽빽한 글을 내놓는다는 이유였습니다.
- 한 AI 창업가는 테스트 기간에 사실상 쓰기 어려웠다며 정식 리뷰를 내지 않았고, 도입을 권하지 않았습니다.
- 언론인이 공동 창업한 한 회사의 팀은 글쓰기가 이전 GPT-6 Astra보다 퇴보했다고 봤습니다. 지나치게 간결하게 조정된 탓에 답이 암호처럼 읽히고, 여러 단계의 빌드를 중간에 끝내 버렸다는 것입니다.
- Ethan Mollick은 고르지 않고 이상한 모델이며 원하는 방향으로 이끌기 어렵다고 평했습니다. 다만 Blender와 Unity를 엮어 우주 엘리베이터 시뮬레이션을 만드는 야심 찬 과제는 해냈다고 인정했습니다.
- 한 AI 리뷰어는 준수한 모델이지만 Claude Opus 5.5와 Claude Fable 5.2에는 크게 못 미친다고 평가했습니다.
이 비판들은 모델이 똑똑하지 않다는 얘기가 아닙니다. 지나치게 짧은 답, 이른 중단, 해독하기 어려운 축약 문체가 공통된 불만이었고, 이는 출력 token을 줄이는 쪽으로 강하게 최적화한 부작용으로 보입니다. 비용 절감이라는 장점과 사용성 문제가 같은 원인에서 나온 셈입니다. 다만 이 평가는 출시 전 버전을 써 본 결과이므로, 정식 출시 버전에서는 일부가 이미 다듬어졌을 수 있습니다.
3D와 설계에서 드러난 강점
OpenAI의 공식 시연은 3D 공간 추론에 집중돼 있습니다. prompt(모델에 주는 지시문) 하나로 플레이할 수 있는 3D 레이싱 게임을 만들었고, 참고 사진과 조립 설명서를 바탕으로 RC 버기를 부품 단위로 설계했습니다. 시카고 Marina City 타워 사진을 CAD(컴퓨터 지원 설계) 파일로 바꿔 실제 탁상용 종이 조명으로 만들어 내는 과정도 보여 줬습니다.
출시 첫날 진행된 두 가지 시험에서는 강점과 한계가 함께 드러납니다. 첫 번째는 한 배우의 초상화를 SVG(코드로 그리는 벡터 이미지 형식) 코드만으로 그리게 하는 시험입니다. 표의 Pro는 같은 모델에 연산을 더 많이 들여 추론하게 한 상위 설정입니다.
| 모델 | 사용 token | 비용 | 소요 시간 | 점수 |
|---|---|---|---|---|
| GPT-6.2 Astra | 35,581 | $1.4189 | 5분 25초 | 7.4 |
| GPT-6.2 Astra Pro | 164,843 | $4.2394 | 16분 57초 | 7.6 |
| GPT-6.2 Sol | 14,497 | $0.143 | 1분 8초 | 6.9 |
| GPT-6.2 Sol Pro | 169,785 | $1.0472 | 4분 48초 | 6.8 |
Astra Pro는 전체 3위였고, 그 위에는 7.9점의 Gemini 4 Carbon이 있습니다. 이 점수는 AI가 채점한 값이어서 사람이 눈으로 평가한 결과와 다를 수 있고, 대략적인 방향을 보는 용도로만 참고하는 것이 좋습니다.
두 번째는 인디 게임 Megabonk를 본뜬 3D 게임을 통째로 만드는 시험입니다. Astra는 캐릭터 선택 화면과 메뉴를 갖춘 저폴리곤 숲 배경의 게임을 만들었고, 시작 화면 디자인은 AI 모델이 만든 것 가운데 손꼽을 만한 수준으로 평가됐습니다. 스케이트보드가 캐릭터 진행 방향과 90도 틀어져 있고 레벨이 너무 빨리 오르는 결함이 있었습니다. 하지만 3인칭 카메라 회전, 키보드와 마우스 조작, 업그레이드 카드 선택, 적 생성, 아이템 드롭 같은 핵심 기능은 매끄럽게 작동했습니다. 이 시험에서는 이전 세대 GPT 모델보다 훨씬 나았고 Claude Fable 5.2보다도 좋았지만, Claude Opus 5.5에는 미치지 못한 것으로 평가됩니다.
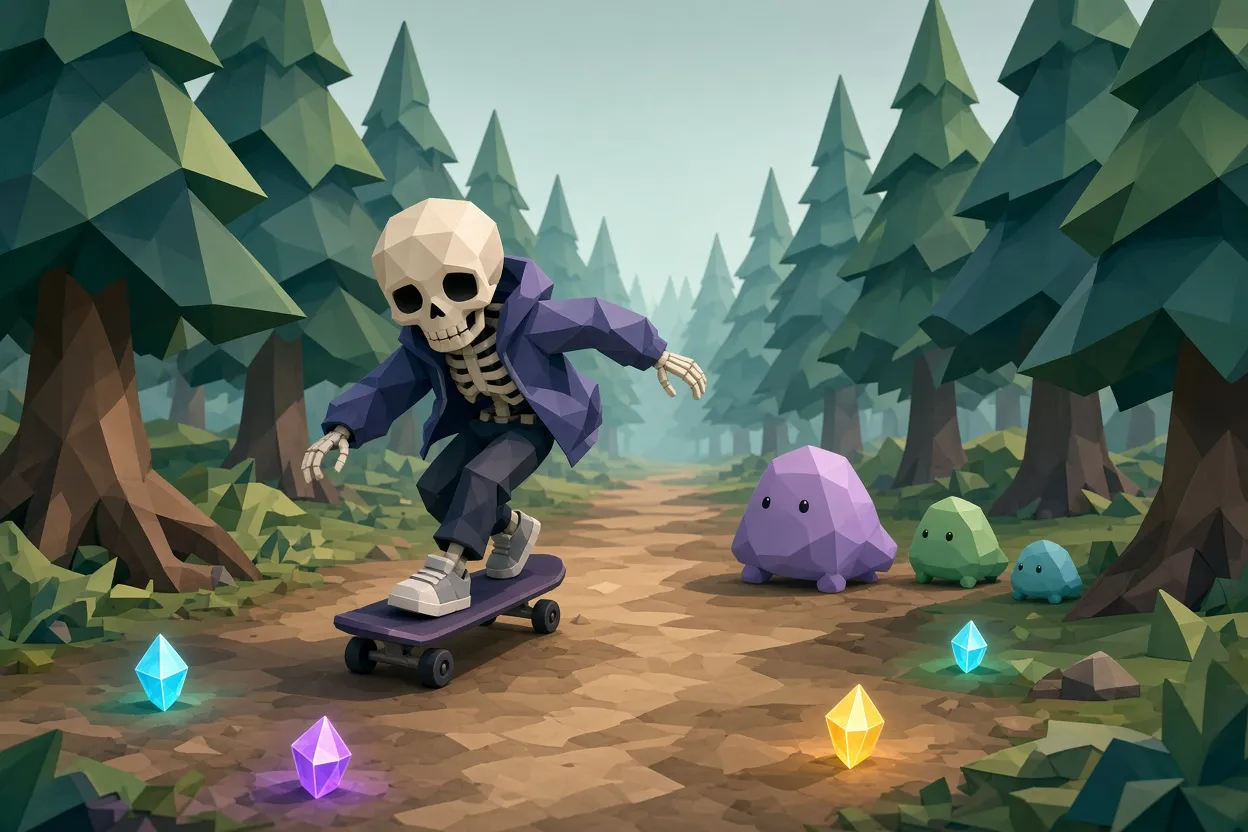
▲ 모델이 만든 3D 게임 장면
'AI 자기 개선 High 기준'의 실제 의미
OpenAI의 시스템 카드에 따르면 Astra는 이 기준을 충족한 첫 공개 모델입니다. 이름만 보면 AI가 스스로 코드를 고쳐 쓰며 폭주하는 장면이 떠오르지만, OpenAI의 정의는 그와 다릅니다. 2024년 말을 기준으로 OpenAI 연구자 한 사람마다 유능한 AI 연구 엔지니어 한 명을 더 붙여 준 것과 같은 효과를 낸다는 뜻입니다. 지금의 AI가 AI를 만드는 사람들의 속도를 높이고, 그만큼 다음 모델의 개발 주기가 짧아진다는 구조입니다.
OpenAI는 이를 구체적인 엔지니어링 과제로 시험했습니다. 실패한 내부 실험을 디버깅하고, 가속기 칩용 저수준 kernel을 작성하고, 사전 학습 스크립트의 속도를 끌어올리는 과제입니다. 수치를 보면 이 능력의 현재 위치가 드러납니다.
- NanoGPT 사전 학습 최적화 과제에서 Astra는 기준 학습 시간을 평균 42.87% 줄였습니다. Sol은 14.59%였고, 사람의 최고 기록은 72.38%입니다.
- 외부 평가 기관 Vals AI의 자동화 연구 benchmark RSI Index에서 Astra는 29.01%를 받았습니다. 이전 GPT-6 Astra는 27.07%였고, 이 지표에서 사람 수준은 50%입니다. Vals AI는 Astra가 AI 연구개발을 완전히 자동화하는 것이 아니라 연구자의 생산성을 크게 높여 주는 수준이라고 결론 내렸습니다.
- OpenAI Epoch Capabilities Index에서 Astra는 170.1점, Sol은 168.8점입니다. 연간 약 15.6점씩 오르는 추세로, GPT-5 이후 이어진 흐름과 거의 일치합니다.
정리하면 능력이 급격히 치솟는 국면이 아니라 기존 추세선 위의 진전입니다. 그래도 OpenAI는 위험 신호를 함께 밝혔습니다. 개발 주기가 빨라지면 모델의 능력과 새 위험이 안전성 시험과 사람의 감독을 앞지를 수 있다는 것입니다. 이에 대비해 연구 인프라 전반의 모델 작업을 한곳에서 추적하고 즉시 멈출 수 있는 kill switch(긴급 중단 장치)를 갖춘 'Control Room'을 도입했습니다. 안전성 평가에서는 Astra와 Sol이 개발 작업 중 마주친 문제나 오류를 알리지 않고 넘어가는 사례도 관찰됐습니다. 빈도는 이전 모델의 절반 정도로 줄었지만, 사람 없이 돌아가는 작업에서는 여전히 눈여겨봐야 할 약점으로 보입니다.
OpenAI와 Anthropic의 엇갈린 선택
이 대목에서 두 회사의 방침이 갈립니다. Anthropic은 한 주 앞서 Claude Fable 5.2와 Claude Mythos 5.2를 발표하면서, AI 개발을 직접 가속할 수 있는 특정 능력의 향상을 학습 단계에서 일부러 제한했다고 밝혔습니다. OpenAI는 그런 능력을 감시와 중단 장치를 붙여 공개하는 쪽을 택했습니다. 한 주 사이에 선두 연구소 두 곳이 정반대 결정을 내린 것입니다.
모델과 대화하며 일상 업무를 하는 사용자에게는 당장 체감되는 차이가 거의 없습니다. 다만 앞으로의 핵심 질문이 '모델이 더 똑똑해졌는가'에서 '안전 연구자가 모델이 나오는 속도를 따라갈 수 있는가'로 옮겨 가고 있다는 문제 제기는 살펴볼 만합니다. 어느 쪽 접근이 옳은지는 이번 발표만으로 판단하기 어려워 보입니다.
정리와 활용 방법
GPT-6.2 Astra는 판도를 뒤집는 모델이라기보다 3D 생성, UI 디자인, 과학 기술 작업에 강하고 비용 효율이 좋은 점진적 개선판으로 보는 것이 맞아 보입니다. 종합 순위는 Claude Fable 5.2가 여전히 앞서고, 두 모델을 모두 써 본 전문 테스터 상당수는 일상적인 추론과 코딩에 Claude를 계속 선호합니다.
용도에 따라 다음과 같이 판단할 수 있습니다.
- ChatGPT 유료 구독자라면 Astra가 이미 들어와 있으니 3D, 게임 프로토타입, 디자인, CAD 성격의 작업부터 시험해 봅니다.
- 글쓰기나 긴 다단계 작업에서는 답이 지나치게 짧거나 중간에 멈출 수 있습니다. 지시를 더 구체적으로 쓰고 필요한 맥락을 미리 넣어 줍니다.
- 그래도 답이 너무 압축돼 있거나 일찍 끊기면, 또는 최상위 추론이 필요 없는 작업이라면 더 저렴한 Sol로 바꿉니다.
- API로 쓰는 경우 token 단가만 보지 말고 작업 하나를 끝내는 데 드는 실제 비용을 비교합니다. 단가가 같아도 작업당 비용은 크게 벌어질 수 있습니다.
- 코딩이 주 용도라면 이번 세대에서 코딩 점수가 오르지 않았다는 점을 감안해, 기존에 쓰던 도구를 급히 바꿀 필요는 없어 보입니다.