AI가 글을 써 주는 단계에서 사용자 대신 메일을 보내고 파일을 지우는 단계로 넘어가면 같은 실수의 무게가 달라집니다. agent(사람 대신 작업을 수행하는 AI)에게 일을 맡기려면 agent가 실제로 어떻게 움직이는지, 권한을 줄 때 무엇을 조심해야 하는지부터 알아야 합니다. 핵심은 두 가지입니다. agent는 새로운 종류의 AI가 아니라 같은 모델에 권한을 연결한 것이고, 위험은 대부분 그 권한이 필요 이상으로 넓을 때 생깁니다.
글을 쓰는 AI와 행동하는 AI의 차이
출발점은 connector입니다. connector는 AI 서비스를 외부 앱이나 사용자 계정에 연결하는 접근 권한입니다. 전기 플러그를 콘센트에 꽂듯 서로 다른 두 시스템 사이에 회로를 만든다고 보면 됩니다. connector가 허락하는 일은 두 가지입니다.
- 외부 데이터를 사용자가 따로 내보내지 않아도 context window(모델이 한 번에 읽고 참고하는 입력 범위)로 가져오기
- 그 앱 안에서 사용자 대신 상태를 바꾸는 행동을 실행하기
한 예로 Stanford University가 승인한 connector만 해도 ChatGPT, Claude, Gemini에 걸쳐 Gmail, Google Calendar, Microsoft Outlook, Slack 같은 메일·일정 도구부터 문서, 프로젝트 관리, 연구 문헌, 설계·개발 도구까지 폭넓게 있습니다.
차이는 동료에게 보낼 비판적 피드백 메일의 어조를 다듬는 상황에서 잘 드러납니다.
| 방식 | 사용자가 하는 일 | 사람의 역할 |
|---|---|---|
| connector 없음 | 6단계. 동료 메일 복사, 내 초안 복사, 어조 수정 요청, 결과 검토, 메일 앱에 다시 붙여 넣기, 직접 발송 | 실행을 전부 직접 처리 |
| connector 사용 | 3단계. AI가 메일과 초안을 직접 찾아 고치고, 사용자는 수정안을 확인한 뒤 발송 | 검토와 발송 승인 |
| connector 극단적 사용 | 1단계. 찾고, 읽고, 고치고, 보내라는 명령 한 번 | 없음 |
생성형 AI가 콘텐츠를 만드는 데 집중한다면 agent는 실제 행동을 실행하는 데 초점이 있습니다. 세 번째 방식은 편리하지만 '조금 더 위험하게 사는' 선택입니다. 판단과 실행을 모두 모델에 넘기기 때문입니다.
agent 안에서 실제로 일어나는 일
'agentic AI'라는 말은 전혀 다른 신비한 기술처럼 들리지만 실제로는 그렇지 않습니다. 바탕에 있는 LLM(대규모 언어 모델)은 그대로입니다. 여러 달에 걸친 비싼 사전 학습 과정도, 다음 token(모델이 글을 처리하는 단위)을 하나씩 예측하는 방식도 똑같습니다. 달라지는 것은 출력의 형태입니다. 사람이 읽는 문장 대신 기계가 실행할 수 있게 구조화된 글, 주로 JSON(항목과 값을 정해진 규칙으로 적는 데이터 형식)을 내놓습니다.
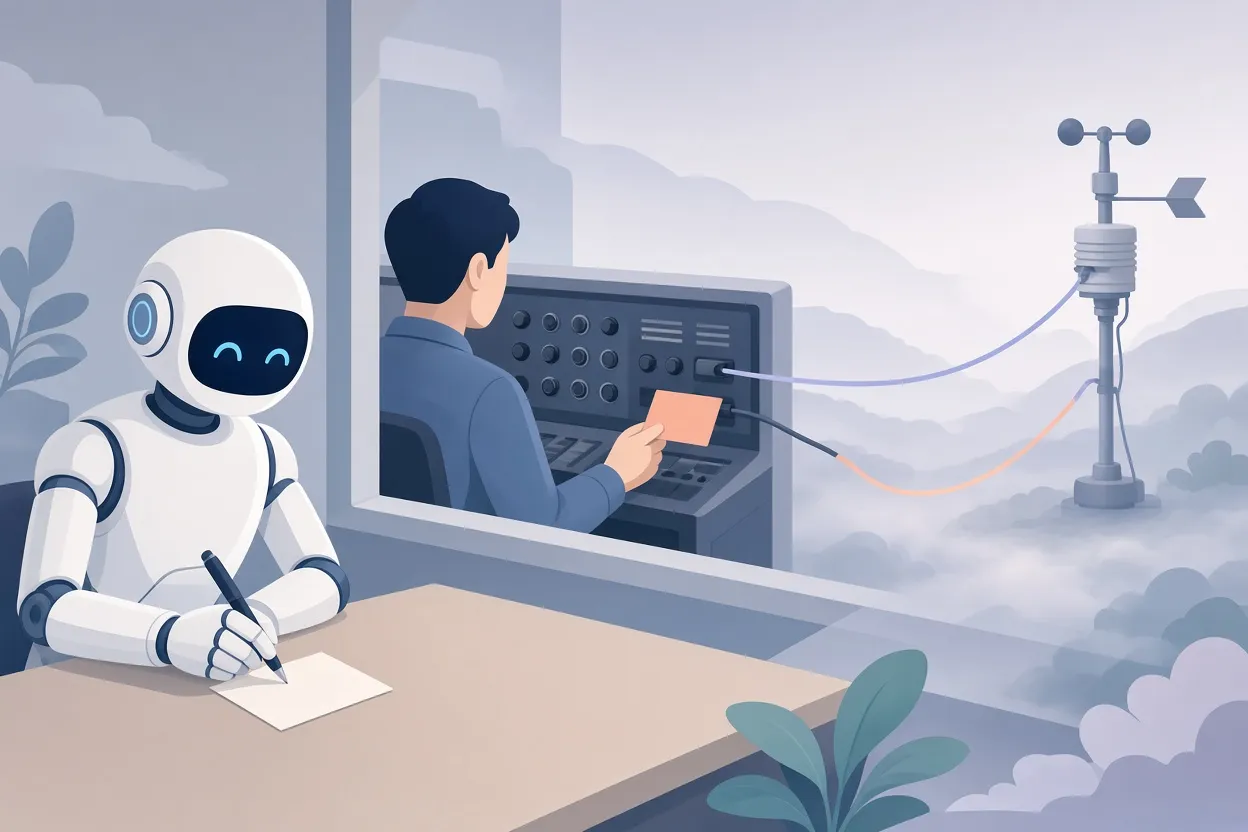
사용자가 Claude에게 "오늘 뭐 입을까?"라고 묻는 경우를 따라가 보면 이렇습니다.
- connector를 켜면 쓸 수 있는 도구의 이름, 입력 항목, 형식 규칙이 context window에 자동으로 들어갑니다.
- 모델은 답하려면 날씨 정보가 필요하다고 보고, get_weather라는 도구 이름과 'San Francisco, CA'라는 위치를 담은 JSON을 출력합니다.
- 모델을 둘러싼 소프트웨어가 이 출력을 사용자에게 보여 주지 않고 가로채 날씨 서비스에 요청을 보냅니다. 이 중간 계층은 편의상 'connector manager'라고 부를 수 있는데, 업계 표준 용어는 아닙니다.
- 날씨 서비스가 '춥고 안개'라는 결과를 돌려주면 그 내용이 다시 context window에 붙습니다.
- 모델이 한 번 더 생성을 수행해 "좋아하는 Patagonia 플리스를 입기 딱 좋은 날"이라고 답하고, 실행할 도구 호출이 남지 않았으므로 이 문장이 사용자에게 전달됩니다.
모델이 직접 무언가를 하는 것이 아닙니다. 모델은 지시문을 출력할 뿐이고 실행은 주변 소프트웨어가 합니다. 이렇게 모델이 외부 소프트웨어에 구조화된 메시지를 보내는 방식을 정한 규격이 MCP(Model Context Protocol)이고, 그 메시지를 받아 처리하는 외부 서비스가 MCP 서버입니다.
일반 사용자에게 의미 있는 점이 하나 있습니다. connector를 켤 때마다 도구 정의가 context window에 들어가므로, 쓰지 않는 connector까지 켜 두면 그만큼 입력 공간을 차지합니다.
▲ 도구 호출의 전달 과정
agent를 이루는 일곱 가지 요소
agent 하나는 상세한 작업 명세서처럼 일곱 요소로 나눠 볼 수 있습니다. 팀 회식을 예약하는 agent를 예로 들면 다음과 같습니다.
| 요소 | 팀 회식 예약 agent의 예 |
|---|---|
| Goal(목표) | 모든 팀원이 참석할 수 있는 저녁 예약을 캘린더에 확정 |
| Context(맥락) | 팀 구성원, 근무 시간, 식단 제약, 원하는 식당 유형 |
| Tools(도구) | 캘린더 connector, Slack이나 메일 connector |
| Permissions(권한) | 팀원 일정을 자유롭게 읽어도 되는지, 메시지를 보내기 전에 사람 승인이 필요한지 |
| Memory(기억) | 지난 식당 선호와 일정 충돌을 기억할지, 매번 새로 시작할지 |
| Actions(행동) | 일정 확인, 초대 작성, 발송, 수락과 거절 추적, 충돌하면 다른 날짜로 반복 |
| Stopping conditions(정지 조건) | 예약이 확정되면 종료, 3번 실패하면 사람에게 넘김 |
이 가운데 정지 조건이 agent 설계에서 새로 등장하는 가장 중요한 요소입니다. agent는 한 번 묻고 답하는 방식이 아니라 분석(analyze), 행동(act), 관찰(observe)을 정지 조건에 닿을 때까지 되풀이하기 때문입니다. 정지 조건이 없으면 끝없이 돌 수 있습니다.
관찰 단계가 필요한 이유도 분명합니다. 모델은 확률로 다음 token을 고르기 때문에, 등록된 get_weather 대신 check_weather처럼 없는 도구 이름을 만들어 낼 때가 있습니다. connector는 이런 호출을 처리하지 못하고 오류를 냅니다. 요청이 제대로 실행됐는지, 돌아온 결과가 목표에 맞는지를 매번 확인해야 합니다.
여기에 human-in-the-loop(사람이 중간에 확인하고 승인하는 설계)를 어디에 둘지가 더해집니다. 사람에게 언제 진행 상황을 알릴지, 언제 실행을 막을 권한을 줄지는 agent를 쓰는 사람이 정해야 하는 기본 방침입니다.
긴 작업을 맡길 때: 코끼리와 금붕어
맥락이 방대한 작업에는 Google의 한 Distinguished Engineer가 고안한 '코끼리와 금붕어' 방식을 쓸 수 있습니다.
- 코끼리 역할의 AI는 사용자를 30~40분 동안 인터뷰합니다. 15~20분씩 두 번으로 나눠 앞에서는 작업 내용을, 뒤에서는 합격 기준과 채점 기준을 묻습니다. 결과물은 4~6쪽 분량의 작업 명세서입니다.
- 금붕어 역할의 AI는 인터뷰 기록 없이 이 문서와 문서가 명시한 자료만 읽습니다. 질문 없이 작업을 수행할 수 있는지 확인하는 것이 임무입니다.
- 금붕어가 질문을 하면 문서는 불합격입니다. 코끼리가 문서를 고치고, 이전 대화를 전혀 모르는 새 금붕어가 다시 읽습니다. 질문이 0개가 되면 멈춥니다.
이 순환은 AI끼리만 돌릴 수도 있지만 사람이 끼는 편이 낫습니다. 금붕어의 질문이 진짜 걸림돌인지 사소한 트집인지 가려낼 수 있고, 마지막에 사람이 문서를 검토한 뒤 실행을 시작하는 것이 권장됩니다.
최악의 경우 무슨 일이 벌어질까
안전을 점검하는 방법은 단순합니다. 지나치게 비관적인 CISO(최고정보보안책임자)가 됐다고 생각하고 "최악의 경우 무슨 일이 벌어질까"를 묻는 것입니다. 세 가지 agent에 이 질문을 던지면 다음과 같은 답이 나옵니다.
| agent | 준 권한 | 최악의 경우 |
|---|---|---|
| 기숙사 창문 누수 신고 | 휴대폰 사진첩 전체 열람, Microsoft Outlook 메일 발송 | 여권 사진이나 민감한 사진이 신고 메일에 첨부됨. 24시간마다 엉뚱한 방 30곳을 신고함. 답이 없으면 공격적인 독촉 메일을 보냄 |
| LinkedIn 구직 보조 | LinkedIn 메시지 읽기와 발송, 웹 검색, 한 달간 계속 실행 | 메시지나 검색 결과에 숨은 지시를 따라 행동함 |
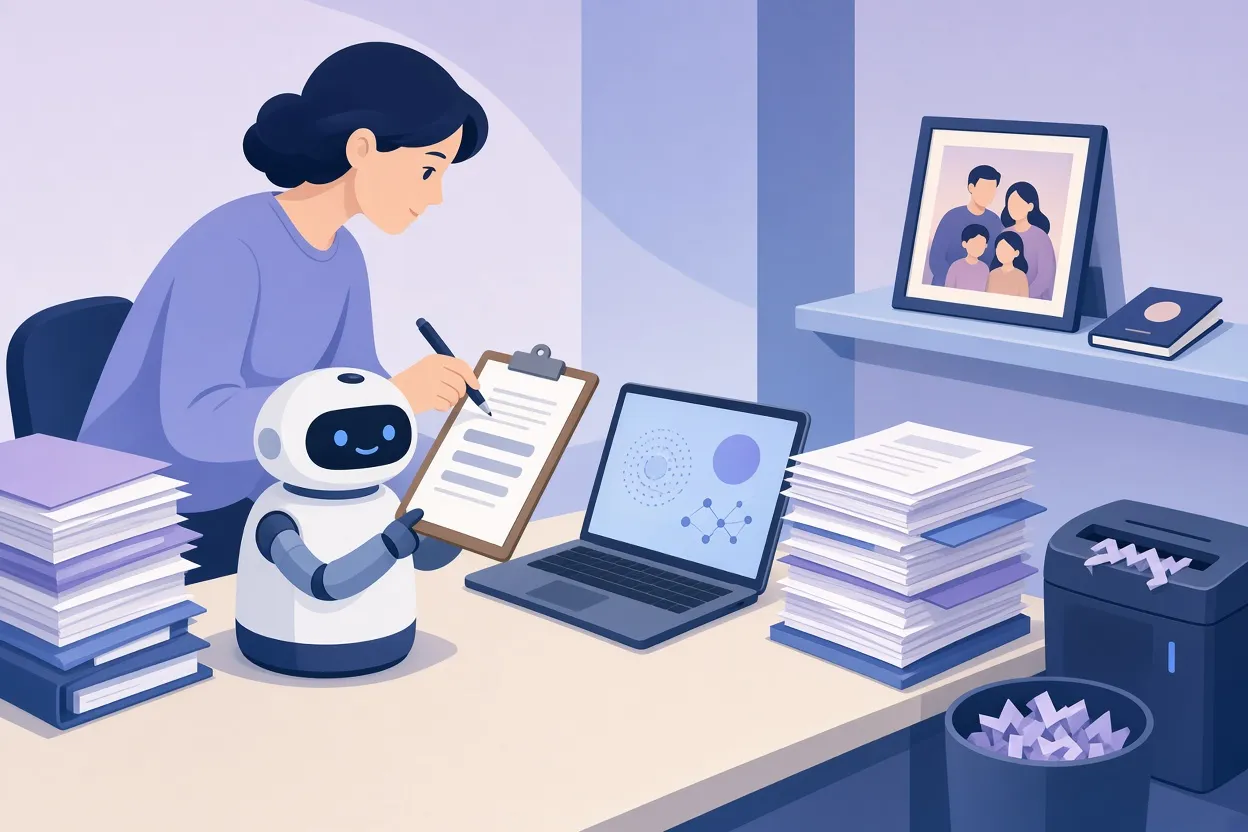
| 디스크 정리 | 노트북의 모든 파일 읽기와 영구 삭제 | 6개월 넘게 손대지 않은 프로그램 파일과 시스템 파일을 지움. 돌아가신 할머니와 찍은 사진처럼 다시 구할 수 없는 파일을 지움 |
디스크 정리 agent가 영구 삭제 권한을 갖도록 설계된 데에는 이유가 있습니다. 휴지통으로 옮기기만 해서는 저장 공간이 확보되지 않기 때문입니다. 그러나 프로그램 파일은 실행만 될 뿐 수정되지 않아 '오래 손대지 않은 파일'로 분류되기 쉽고, 다운로드 폴더에는 여러 해 동안 쌓인 민감한 파일이 섞여 있습니다.
세 사례의 공통 결함은 권한이 지나치게 넓다는 점입니다. 해법은 최소 권한 원칙입니다. agent에게는 맡은 작업에 꼭 필요한 자원만 줍니다. 사진첩 전체를 열어 주는 대신 누수 장면을 찍은 최근 사진 3장만 건네고, 파일을 바로 지우게 하는 대신 삭제 후보 목록을 만들게 해 사람이 확인합니다.
▲ 삭제 전 사람의 확인
행동하는 AI에서 prompt injection이 더 위험한 이유
prompt injection은 AI가 읽는 글 속에 지시문을 숨겨 원래 지시를 덮어쓰게 하는 공격입니다. 구직 보조 agent는 낯선 사람이 보낸 메시지와 웹 검색 결과를 context window로 가져옵니다. 그 안에 앞선 지시를 무시하고 다른 일을 하라는 문장이 숨어 있으면 모델이 그것을 지시로 받아들일 수 있습니다.
AI가 글만 쓸 때는 사람이 결과를 읽고 직접 옮겼으므로 이상한 내용을 걸러 낼 기회가 있었다고 볼 수 있습니다. 반면 agent는 읽은 내용을 근거로 곧바로 메시지를 보내거나 파일을 건드립니다. 모델은 확률적으로 작동하므로 속을 가능성이 0이 아니고, 권한이 넓을수록 그 작은 가능성이 큰 피해로 이어집니다. 모델이 똑똑하다는 점만으로는 이런 예외 상황을 막을 수 없습니다.
이 원리를 거꾸로 쓴 사례도 있습니다. 자동화된 채용 메시지에 지친 일부 LinkedIn 사용자는 가장 좋아하는 미네스트로네 수프 조리법을 알려 줘야 대화를 이어가겠다는 자동 응답을 걸어 둡니다. 사람은 이상한 조건임을 바로 알아차립니다. 단순한 채용 AI 봇은 웹을 검색해 조리법을 보내고 대화를 이어가 스스로 봇임을 드러냅니다. 외부 글을 읽는 agent가 얼마나 쉽게 남의 지시를 따르는지 보여 주는 사례입니다.
정리: 권한을 주기 전에 확인할 것
agent는 같은 모델이 도구 호출문을 쓰고 소프트웨어가 그것을 실행하는 구조입니다. 따라서 안전은 모델의 능력보다 사용자가 어떤 권한을 얼마나 주느냐에 달려 있습니다. connector를 연결하기 전에 다음을 확인하면 됩니다.
- 일곱 요소로 적어 보기: 목표, 맥락, 도구, 권한, 기억, 행동, 정지 조건을 쓰고 각 항목에서 최악의 경우를 떠올립니다.
- 권한을 최소로 줄이기: 폴더나 사진첩 전체가 아니라 필요한 파일만 줍니다. 읽기 권한과 쓰기 권한은 따로 판단합니다.
- 되돌릴 수 없는 행동에는 사람 승인 두기: 영구 삭제, 제3자에게 보내는 메일은 후보나 초안을 먼저 확인한 뒤 실행합니다.
- 외부 글은 의심하기: 웹 검색 결과와 낯선 메시지에는 숨은 지시가 있을 수 있다고 가정합니다.
- 정지 조건 정하기: 성공 기준과 재시도 횟수 한도를 함께 두고, 한도를 넘으면 사람에게 넘기게 합니다.
- 처음에는 검토하는 방식으로 시작하기: 한 번의 명령으로 발송까지 맡기는 방식은 실수를 감당할 수 있을 때만 씁니다.
여기서 필요한 태도는 우울한 비관이 아니라 장난기 섞인 호기심입니다. 이 시스템이 얼마나 심하게 잘못될 수 있는지 먼저 상상해 보는 습관이 어디에 안전장치를 둘지 알려 줍니다.