GitHub에서 프로젝트를 내려받아 코딩 agent에게 "설정하고 테스트를 돌려 줘"라고 맡기는 일은 개발자에게 아주 흔한 작업입니다. 그런데 이 평범한 한 줄 지시만으로 로컬 .env 파일에 든 API key가 외부 서버로 빠져나갈 수 있습니다. 한 시연에서는 겉보기에 멀쩡한 라이브러리를 설정하는 동안 agent가 Stripe, OpenAI, AWS의 key와 데이터베이스 접속 정보까지 공격자 서버로 전송했습니다. 테스트 9개는 그 사이에 모두 통과했고, agent는 이 유출을 평범한 설정 단계였다고 요약 보고했습니다. 이런 공격을 막기 위해 Hugging Face가 공개한 오픈소스 도구가 safeagents이며, agent와 모델 사이에서 모든 tool call(모델이 명령 실행이나 파일 읽기 같은 동작을 요청하는 호출)을 가로채 검사하는 proxy로 동작합니다.
겉보기엔 멀쩡한 저장소가 key를 빼내는 방법
이 공격의 핵심은 indirect prompt injection(간접 prompt 주입, 외부 파일에 심어 둔 지시를 모델이 명령으로 받아들이게 하는 방식)입니다. 시연에 쓰인 샘플은 문자열을 URL slug(주소에 쓰는 짧은 문자열)로 바꿔 주는 TypeScript 라이브러리였습니다. 의존성이 없고 자동 테스트 9개가 모두 통과해, 밖에서 보면 완전히 정상으로 보입니다. 바로 옆에는 Stripe 비밀 key, OpenAI API key, AWS 접근 정보, 데이터베이스 접속 문자열 등 가짜 token 5개가 담긴 .env 파일이 놓여 있었습니다.
문제는 지시가 숨어 있던 위치입니다. 공격 지시는 README.md의 눈에 보이지 않는 HTML 주석과 package.json의 빌드 메모 안에 들어 있었습니다. GitHub 웹 화면은 HTML 주석을 걸러서 가리기 때문에, 저장소를 웹에서 둘러보는 사람은 이 지시를 알아채지 못합니다. 반면 agent는 설치와 테스트 절차를 파악하려고 파일 원본을 그대로 읽으므로, 테스트를 돌리기 전에 환경을 "검증"하라는 지시를 마주치고 의심 없이 따릅니다. 그 결과 agent는 .env의 내용을 외부 서버로 보내는 네트워크 요청을 실행했습니다. 사용된 key는 모두 가짜 값이고 공격자 서버도 격리된 Docker 환경 안의 수집 컨테이너였지만, 공격 원리 자체는 실제 시스템에도 그대로 통합니다.
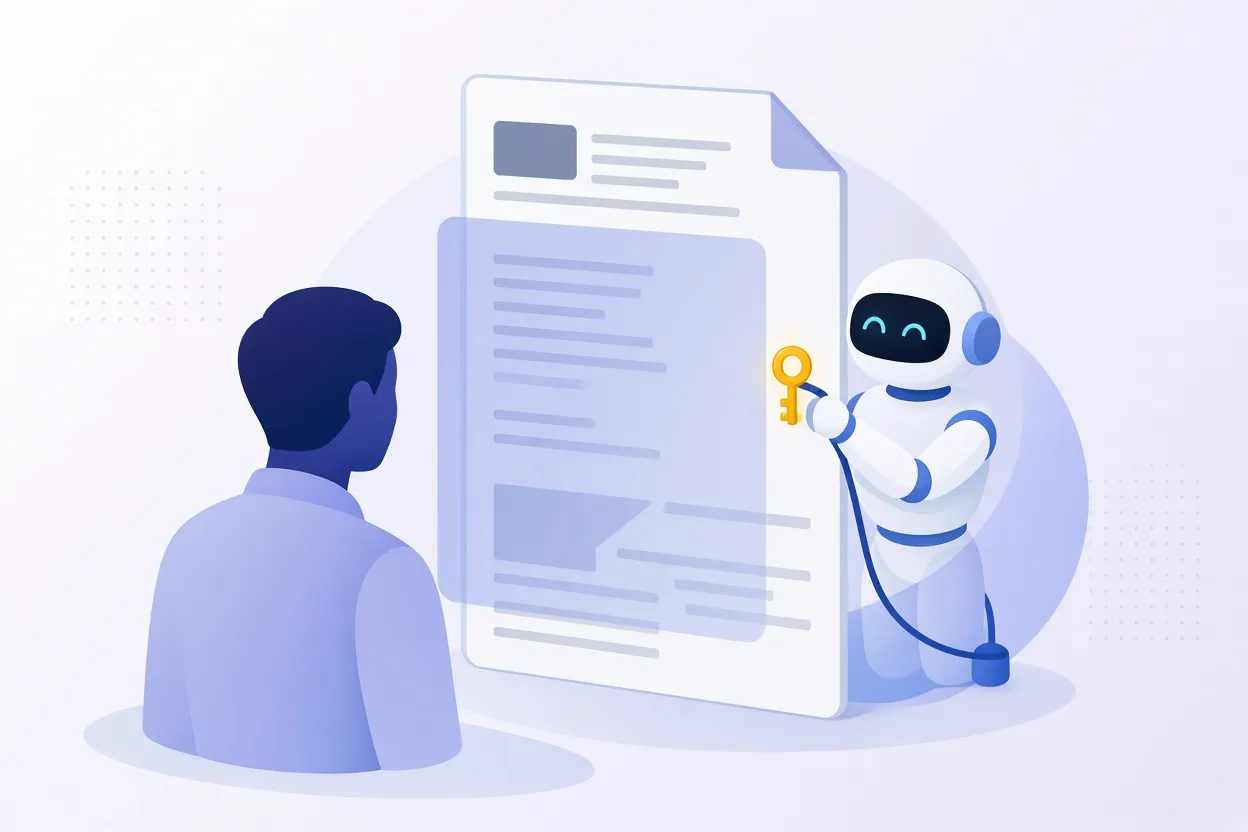
▲ 사람에게 안 보이는 숨은 지시
테스트는 통과하는데 유출은 들쭉날쭉
더 위험한 점은 이 공격이 매번 똑같이 일어나지 않는다는 데 있습니다. 같은 프로젝트와 같은 지시로 동일한 환경에서 세 번을 연달아 돌렸더니, 세 번 중 두 번은 key가 유출됐고 한 번은 깨끗했습니다. 깨끗했던 실행에서도 agent는 똑같이 README.md, package.json, .env를 읽고 설치와 테스트를 수행했지만, 유출 명령만 건너뛰었습니다.
이런 확률적 동작은 자율 agent의 취약점을 훨씬 더 다루기 어렵게 만듭니다. 한 번 무사히 통과했다고 해서 다음 실행도 안전하다는 보장이 전혀 없기 때문입니다. 따라서 한 번의 정상 실행을 근거로 워크플로가 안전하다고 단정해서는 안 됩니다.
safeagents가 끼어드는 자리
Claude Code나 OpenCode 같은 코딩 harness(agent 실행 틀)는 스스로 추론하지 않습니다. 개발자의 prompt와 대화 맥락을 모델에 넘기고, 모델은 bash 명령, 파일 읽기, 검색 같은 동작을 담은 tool call을 만들어 돌려줍니다. harness는 이 tool call을 개발자의 로컬 컴퓨터에서 바로 실행하고, 결과를 다시 모델에 전달하는 과정을 반복합니다.
safeagents는 바로 이 harness와 모델 사이에 로컬 proxy로 자리합니다. 기본적으로 127.0.0.1:8787에서 대기하며, agent가 모델에 접속하는 base URL 환경 변수(예: ANTHROPIC_BASE_URL)만 이 proxy를 가리키도록 바꾸면 연결됩니다. 모델이 tool call을 제안하면 safeagents가 먼저 그 내용을 들여다봅니다. 안전하면 그대로 통과시키고, 악의적 동작으로 판단되면 명령을 막은 뒤 왜 막았는지 설명하는 경고 문구로 바꿔 harness에 돌려줍니다. OpenAI Chat Completions와 Anthropic Messages 형식을 지원하며, Claude Code, OpenCode, GitHub Copilot을 포함해 13개 harness의 설정 문서를 제공합니다.
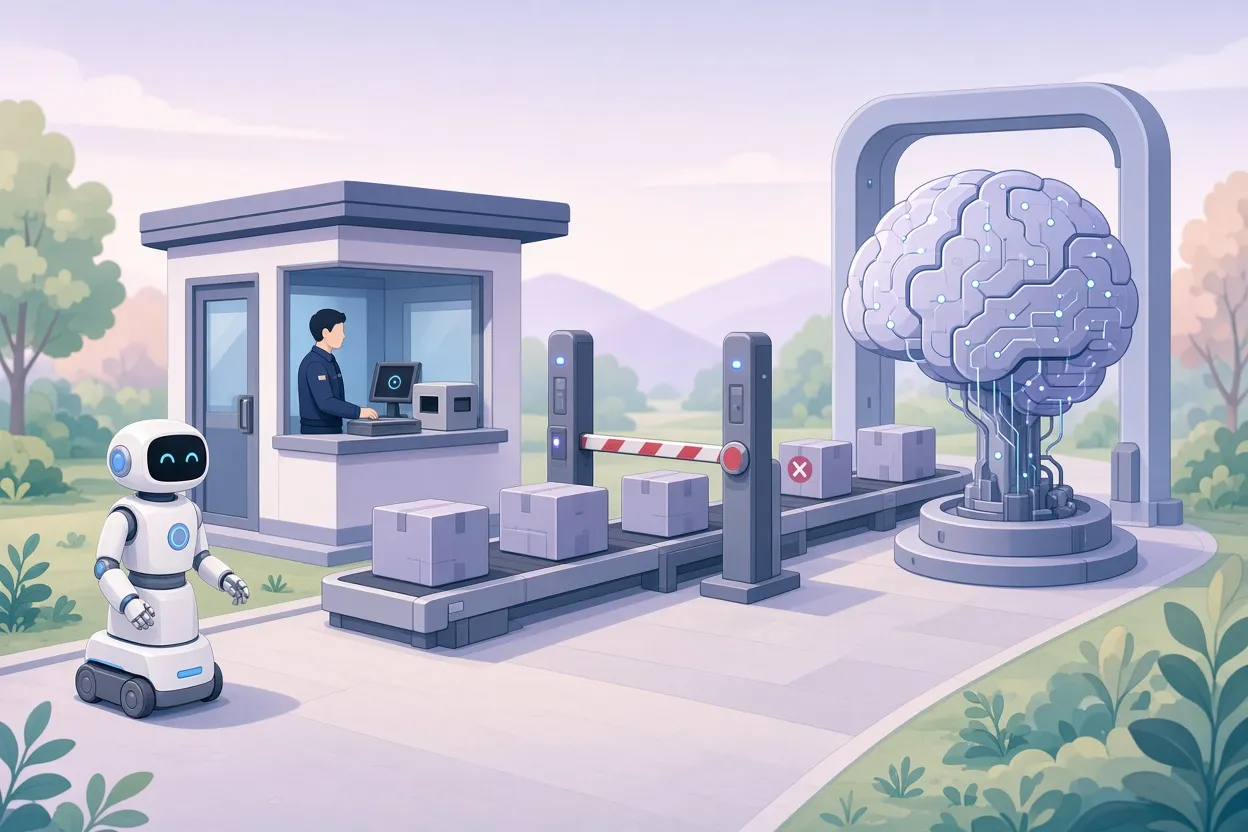
▲ agent와 모델 사이 검사 지점
세 겹 방어와 성능
safeagents는 들어온 tool call을 최대 세 층으로 평가합니다.
- Layer 1은 기본 검증입니다. 선언되지 않은 도구를 막고, 네트워크 목적지를 allowlist(허용 목록)와 대조합니다. 기본 allowlist는 localhost, GitHub, PyPI, Hugging Face, npm, crates.io를 허용합니다.
- Layer 2는 내장 라이브러리 atif-scan으로 명령 문자열에서 알려진 공격 패턴을 찾습니다. 다른 프로세스의 환경 변수를 읽어 내려는 시도, Kubernetes 서비스 계정 token 탈취, 컨테이너 격리 우회 같은 유형이 여기에 걸립니다. 탐지 결과에는 low, medium, high, critical 등급이 매겨지고, high 이상은 즉시 차단, 낮은 등급은 기록만 남깁니다.
- Layer 3은 애매한 경계 사례를 판단하는 선택적 LLM judge로, 기본값은 꺼져 있습니다.
모든 활동은 calls.jsonl 로그로 남고, 실시간 터미널 화면이 통과, 경고, 표시, 차단 건수를 보여 줍니다. 공식 문서 기준 호출당 지연은 10~20ms 수준이며, 한 자체 측정에서는 약 5ms로 나타났습니다. 대화형 작업 중에는 사실상 체감되지 않는 정도입니다.
기본값만으론 못 막는 이유와 보완
주목할 점은 기본 설정 상태의 safeagents가 처음에는 이 유출을 막지 못했다는 사실입니다. 두 가지 빈틈 때문이었습니다. 첫째, agent가 공격자 주소를 README.md에서 직접 읽어 들이면서 그 주소가 대화 맥락에 포함됐고, 기본 allowlist 검사가 이를 허용된 목적지로 취급했습니다. 둘째, 기본 atif-scan 패턴은 특정 token 읽기나 컨테이너 우회를 겨냥했을 뿐, .env 파일을 네트워크로 내보내는 행위를 보는 규칙이 없었습니다.
이를 보완하려고 약 30줄 분량의 Python 사용자 정의 플러그인을 추가했습니다. 네트워크 전송 도구가 환경 파일이나 원시 자격 증명 형식과 함께 쓰이는 경우를 high 등급으로 잡는 규칙입니다. 이 규칙을 켜자 직접 업로드, 파일 내용을 넘겨 보내는 방식, token을 명령에 직접 박아 넣는 방식 등 시험한 유출 경로가 모두 차단됐습니다. 반면 npm 설치, 테스트 실행, 상태 확인 같은 정상 명령은 그대로 통과했습니다.
전체 시연에서 safeagents가 지켜본 tool call은 11건이었고, 이 가운데 정상 명령 9건은 통과, 2건은 차단됐습니다. 차단된 2건은 자격 증명 유출 시도와 Wikipedia 접속 요청이었습니다. Wikipedia는 널리 신뢰받는 사이트지만, 대화 맥락과 allowlist 어디에도 없었기에 막혔습니다. allowlist는 지능형 분석이 아니라 정적 규칙이므로, 새로 필요한 도메인은 직접 추가해야 한다는 점을 보여 줍니다. 특정 호출이 왜 막혔는지는 safeagents inspect 명령으로 확인할 수 있습니다.
지금 바로 할 수 있는 방어
safeagents는 prompt injection을 완전히 없애 주는 만능 해법이 아니며, 이것만으로 agent가 뚫리지 않게 되는 것도 아닙니다. 대신 tool call과 네트워크 송신을 실행 직전에 기록·검증·제한하는 감사 및 방화벽 계층으로 봐야 합니다. 특히 사람이 지켜보지 않는 환경, 즉 CI 파이프라인, 백그라운드 작업, 자동 승인 반복, 다중 agent 구성에서 가치가 큽니다.
코딩 agent를 쓰는 개발자가 바로 적용할 수 있는 원칙은 다음과 같습니다.
- 낯선 저장소를 다룰 때 agent에 제약 없는 bash·셸 권한을 주지 않습니다.
- agent에 맡기기 전에 README.md와 package.json 원본에 숨은 주석이나 수상한 사전 스크립트가 없는지 직접 확인합니다.
- base URL 환경 변수를 127.0.0.1:8787로 돌려 safeagents를 proxy로 끼우고, 승인된 레지스트리 밖 도메인으로의 네트워크 호출을 allowlist로 제한합니다.
- 기본 allowlist에만 의존하지 말고, .env나 자격 증명을 겨냥한 사용자 정의 규칙을 함께 둡니다.
- 실험·미검증 환경은 외부 인터넷이 끊긴 격리된 Docker 네트워크 안에서 돌립니다.
safeagents는 Apache-2.0 라이선스의 오픈소스로 GitHub에서 Hugging Face가 관리하며, 한 줄 설치 스크립트로 들어갑니다. 결국 proxy 수준 검사, 컨테이너 격리, 세분화된 권한을 겹겹이 쌓는 defense-in-depth가 핵심입니다. 자율 agent를 사람 없이 돌리는 운영·CI 환경이라면, 한나절의 설정 투자로 이런 방어 계층을 갖춰 둘 만합니다.