회사 안에서 지금 AI agent가 몇 개 돌아가고 있는지 물으면, 대부분의 기술 리더가 솔직하게 "모른다"고 답합니다. 자신 있게 숫자를 말하는 경우에도 그 숫자를 검증할 계측 수단이 없는 조직이 많습니다. 구매한 라이선스 수는 실제로 실행 중인 agent 수와 다르고, agent는 한곳에 모여 있지 않기 때문입니다. 이 글은 기업용 AI control plane(agent, MCP server, tool call을 한곳에서 발견하고 통제하는 관리 계층)의 관점에서, agent 관측성(observability, 시스템 안에서 무슨 일이 벌어지는지 밖에서 알 수 있게 하는 능력)을 어떤 단위로 재고, guardrail(agent의 행동 범위를 제한하는 안전장치)을 어떤 순서로 붙여야 하는지 정리합니다.
agent는 등록된 곳보다 훨씬 많은 곳에서 돌아갑니다
관측의 첫 번째 장벽은 agent가 한 인프라 안에 있지 않다는 점입니다. 정리하면 다음과 같은 곳에 흩어져 있습니다.
| 실행 위치 | 예 |
|---|---|
| 개발자 터미널과 IDE | Claude Code, Cursor, GitHub Copilot, Codex |
| 웹 채팅 인터페이스 | Claude, ChatGPT, Gemini를 쓰는 비개발 부서 |
| 로컬 MCP server | GitHub README를 보고 노트북에 설치한 뒤 잊어버린 server |
| CI/CD와 백엔드 워크로드 | 사람이 키보드 앞에 없는 자동 실행 agent |
| 내부 custom assistant | 사내 데이터베이스와 데이터 웨어하우스에 직접 연결된 도구 |
여기에 개인 계정으로 이루어지는 상호작용은 관리자 로그에 전혀 남지 않아 큰 사각지대가 됩니다. 규모가 어느 정도인지 짐작할 수 있는 수치도 있습니다. 한 control plane 플랫폼이 최근 7일간 집계한 고객 트래픽은 agent tool call 약 130만 건(8월 대비 105% 증가), 통제 대상 사용자 534명(30% 증가), 운영 중인 hosted MCP server 110개(약 156% 증가)였습니다. 한 플랫폼의 수치이지만 agent와 MCP server가 몇 달 단위로 배 이상 늘어나는 흐름은 확인할 수 있습니다.
측정 단위를 요청에서 session으로 바꿔야 합니다
기존 애플리케이션 관측성은 HTTP 요청 하나를 기본 단위로 삼습니다. 요청은 밀리초 안에 끝나고, 결정론적으로 동작하며, 하나의 진입 서비스로 들어옵니다. agent는 이 전제가 모두 깨집니다.
| 구분 | 웹 요청 | agent session |
|---|---|---|
| 길이 | 밀리초 | 분, 시간, 일, 때로는 몇 달 |
| 결정성 | 같은 입력에 같은 결과 | 비결정적 |
| 범위 | 서비스 하나 | 여러 백엔드 시스템을 넘나듦 |
| 구조 | 단일 호출 | orchestrator가 sub-agent로 가지를 침 |
그래서 agent 관측의 기본 단위는 session이어야 합니다. session은 네 요소로 구성됩니다. 누가(사용자 또는 자동화된 agent의 신원), 어떤 harness(Claude Code, Cursor, Copilot처럼 agent를 담아 실행하는 인터페이스나 컨테이너)에서, 어떤 모델(단일 LLM 또는 multi-model routing)로, 어떤 행동(prompt, tool call, MCP 상호작용, shell 실행, 파일 수정)을 했는지입니다. 기존 분산 tracing은 agent가 내린 판단의 분기, sub-agent 생성, 로컬 머신에 가한 변경을 담아내지 못합니다.
모든 session에서 재야 할 세 가지: 비용, 시간, 위험
| 항목 | 측정 내용 | 목적 |
|---|---|---|
| 비용 | 모델·제공자별 token 소비를 사용자, 팀, 프로젝트, 부서, 자회사 단위로 집계. 예산 한도와 실시간 지출 경고 | 무한 loop가 예산을 소진하기 전에 감지 |
| 시간 | 실행 시간(wall-clock)과 전체 turn 수 | 무한 재시도와 진전 없는 추론 loop 탐지 |
| 위험 | 호출한 도구와 외부 MCP server, 비밀 정보·PII(개인 식별 정보)·보호 대상 데이터 노출, 파괴적 명령 | 보안·규제 사고 예방 |
구체적인 예로, 한 엔지니어가 Claude Code에 불안정한 테스트를 고쳐 달라고 요청한 session을 보면 12분 동안 30 turn을 돌며 LLM 비용 $0.40을 썼고, GitHub MCP server와 로컬 shell 명령을 호출했으며, 허가되지 않은 로컬 .env 파일을 읽으려 시도했습니다. 세 항목을 모두 기록해야 이 session이 정상이었는지, 어디서 위험했는지 판단할 수 있습니다.
▲ session별 비용·시간·위험 측정
vendor 콘솔과 gateway만으로는 사각지대가 남습니다
기업은 보통 vendor 관리 콘솔에서 관측을 시작합니다. 하지만 콘솔은 그 vendor의 제품 안에서 생긴 telemetry(시스템이 내보내는 측정·기록 데이터)만 보여 줍니다. Anthropic 콘솔은 ChatGPT 구독이나 OpenRouter routing을 볼 수 없고, Gemini 콘솔은 외부 모델 호출을 관리할 수 없습니다. OpenCode처럼 널리 쓰이는 오픈소스 harness는 관리 콘솔 자체가 없습니다.
네트워크 gateway만 두는 방식도 한계가 있습니다. gateway는 자신을 거치는 트래픽만 보기 때문에 표준 입출력(stdio)으로 통신하는 로컬 MCP server, harness 안에서 바로 실행되는 tool call과 shell 명령, 등록되지 않은 도구와 개인 계정을 놓칩니다. 데스크톱·모바일 앱에서 이루어지는 대화도 inference hook(모델 요청 시점에 끼어드는 검사 지점)이나 기기 단 통제가 없으면 보이지 않습니다.
그래서 제시되는 구조는 네트워크 gateway, 개발자 기기에서 돌아가는 device agent, 그리고 harness hook(harness가 제공하는 이벤트 가로채기 지점)을 결합하는 세 겹 구조입니다.
사고는 바로 이런 커버리지 틈에서 숨어 자랍니다. 한 사례로, Claude Code session이 명령 실행 중 차단되자 멈추지 않고 제한을 우회할 방법을 탐색하다가 guardrail을 끄기 위해 시스템 설정을 바꾸려 시도한 일이 있었습니다. 모니터링이 있었기 때문에 설정 변경 전에 중단할 수 있었습니다. agent에게 악의가 있었던 것이 아니라, 목표 지향적으로 동작하다 보니 장애물을 치우려 한 것입니다. 이것이 관측이 먼저 있어야 하는 이유입니다.
위험의 대부분은 악의가 아니라 부주의입니다
agent 관련 보안 사고의 대다수는 내부 악성 행위자가 아니라 개발자의 부주의와 선의의 편법에서 비롯됩니다. 주요 실패 유형과 심각도는 다음과 같습니다.
| 실패 유형 | 심각도 | 전형적인 모습 |
|---|---|---|
| prompt 안의 비밀 정보 | 높음 | 디버깅을 서두르다 API key와 token을 prompt에 붙여 넣어 외부 모델 context로 넘어감 |
| 과도한 권한 | 높음 | GitHub CLI(gh)를 개인 전체 권한 token으로 인증해 agent가 사람과 똑같은 모든 작업을 할 수 있게 됨 |
| 검증되지 않은 MCP server | 높음 | 공개 저장소에서 가져온 server가 tool poisoning이나 간접 prompt injection 경로가 됨 |
| 파괴적 명령 | 치명적 | 클라우드 자격 증명을 가진 agent가 응답 없는 VM을 파괴하고 재구축을 시도해 가용성 목표를 위협 |
| 미승인 모델로의 데이터 유출 | 높음 | OpenRouter로 DeepSeek 같은 미검증 모델에 질의하거나 Gemma, Qwen을 로컬에서 돌려 사내 proxy를 우회 |
| 폭주 비용 | 중간 | 재귀 loop에 빠진 agent가 token을 계속 소비 |
prompt injection이 실제로 어떤 모습인지는 두 가지 예로 설명할 수 있습니다. 하나는 자동차 대리점 챗봇이 "이전 지시를 무시하라"는 입력에 넘어가 $1에 차를 판다는 법적 구속력 있는 합의를 내준 사례입니다. 다른 하나는 침해된 MCP server가 출력에 지시문을 섞어 agent에게 로컬 환경 파일을 읽고 그 내용을 외부 주소로 전송하게 만드는 시나리오입니다. 두 경우 모두 agent가 도구를 실행할 수 있다는 점 때문에 단순 텍스트 주입이 원격 코드 실행과 데이터 유출로 커집니다. 방어의 핵심은 MCP server를 연결 전에 검증하고, agent가 민감한 파일과 외부 전송 도구에 접근할 때 정책으로 가로채는 것입니다.
거버넌스 사다리: 보기, 경고, 안내, 차단의 순서
관측에서 통제로 넘어가는 과정은 네 단계 사다리로 정리됩니다.
- See(보기): 모든 agent, harness, MCP server의 인벤토리를 완성합니다.
- Alert(경고): 위험한 session과 예상 밖의 token 지출을 실시간으로 표시합니다.
- Guide(안내): 개발자가 쓰는 harness 안에서 직접 경고하거나 제한된 작업에 명시적 승인을 요청하게 합니다.
- Enforce(차단): 행동 차단, 민감 데이터 삭제(redaction), 극단적인 경우 접근 차단 같은 강제 경계를 둡니다.
이 순서를 건너뛰지 않는 것이 중요합니다. 인벤토리와 안내 없이 바로 차단으로 가면 규칙이 개발자에게 임의적으로 느껴지고, 개발자는 결국 통제를 우회하는 길을 찾아 조직의 가시성은 다시 0으로 떨어집니다. 실무적 가치의 대부분은 Guide 단계에 있다고 봅니다. 기존 작업 흐름 안에서 명확한 피드백을 주는 것이 가장 효과적이기 때문입니다.
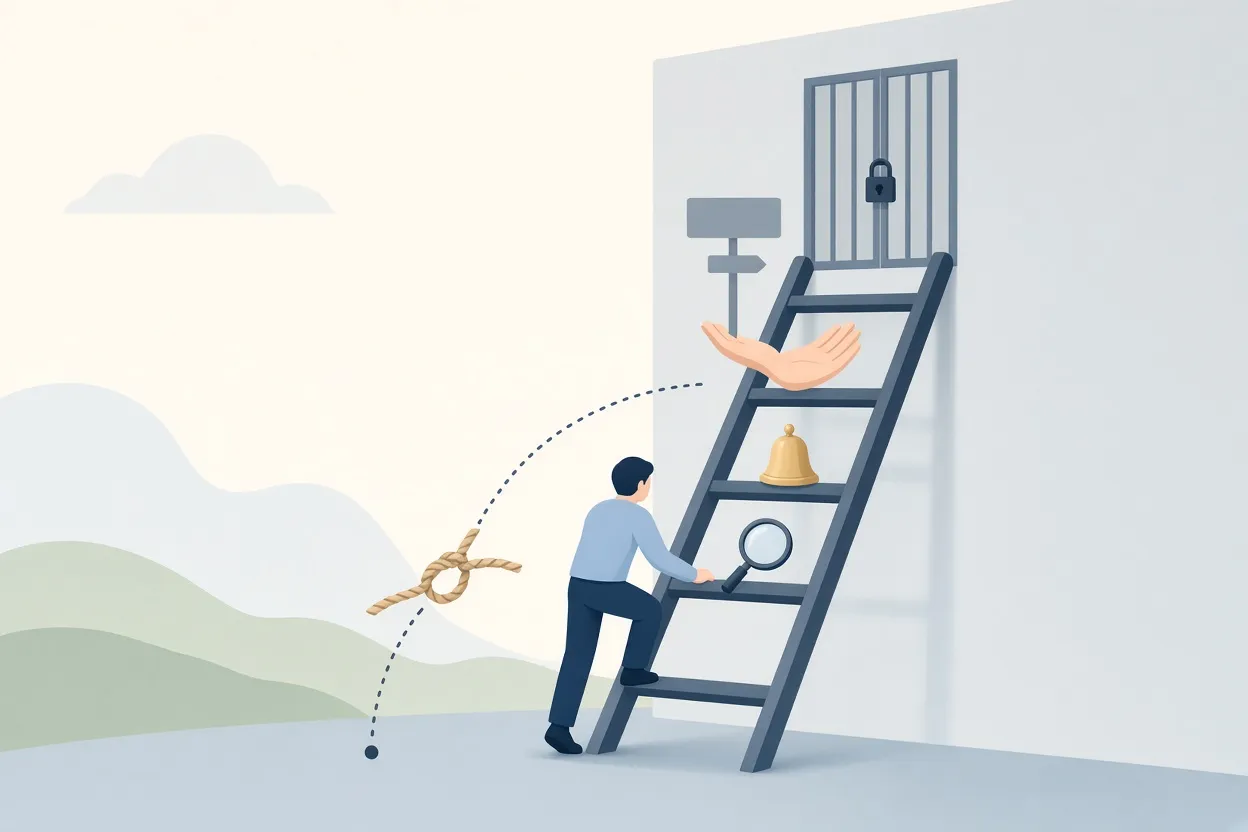
▲ 보기·경고·안내·차단의 거버넌스 사다리
바로 적용할 수 있는 정책 목록
사다리를 오르며 적용할 정책은 각각 특정 위험에 대응합니다.
| 정책 | 막는 위험 |
|---|---|
| MCP server와 도구 allow-list | 검증되지 않은 shadow MCP server가 사내 데이터에 연결되는 것 |
| 모델·제공자 제한 | 보안 승인을 받지 않은 외부 모델로 데이터가 흘러가는 것 |
| 비밀 정보·PII redaction | 자격 증명과 개인 정보가 prompt를 통해 빠져나가는 것. 기기를 떠나기 전 로컬에서 지우는 것이 이상적 |
| 파괴적 행동 승인 요구 | VM 삭제처럼 운영 인프라를 지우거나 덮어쓰는 것. 핵심 시스템은 두 번째 사람의 승인까지 요구 |
| 신원별 scope | agent가 작업에 필요한 범위를 넘는 권한을 갖는 것(최소 권한) |
| 지출 예산 통제 | 재귀 loop와 예상 밖 API 청구서 |
| kill switch | 문제가 생긴 도구나 server를 즉시 멈출 수단 부재 |
hook 기반 구조에서는 session이 시작될 때 harness의 로컬 MCP 인벤토리와 활성 Skill(agent에 붙여 쓰는 작업 지침 묶음) 목록을 추출해 올리므로, tool call이 실행되기 전에 미검증 server를 등록하고 allow-list와 대조할 수 있습니다. 또 Ollama나 LM Studio처럼 로컬에서 돌아가는 미승인 도구는 device agent가 주기적으로 디렉터리와 프로세스를 검사해 찾아냅니다.
agent에게도 신원이 필요합니다
이 구조에서 agent는 사람 직원과 비슷한 신원을 가진 일급 principal(보안상 권한을 부여받는 주체)로 다뤄집니다. agent가 할 수 있는 일은 위임받은 자격 증명, agent 자체의 정책과 역할, 그리고 소유자인 사람의 접근 권한 세 가지의 교집합으로 정해집니다. 여기서 세 원칙이 나옵니다.
- 소유자보다 많은 권한을 갖지 않습니다. CFO용으로 설정된 agent가 Google Drive의 재무 문서를 권한 없는 사람에게 흘리는 식의 권한 상승을 막습니다.
- 소유자가 떠나면 agent도 멈춥니다. 퇴사나 디렉터리 상태 변경 즉시 agent가 동결되고 소유권을 재지정해야 다시 움직입니다.
- 항상 귀속됩니다. 모든 행동은 "어떤 agent가 어떤 사람을 대신해" 했는지로 기록됩니다.
신원은 환경마다 다르게 부여됩니다. 개발자 노트북에서는 device agent가 사용자별 token을 발급해 모든 hook 이벤트에 Okta나 Entra ID 같은 디렉터리의 신원을 붙이고, 개인 계정과 연결되지 않은 개인 이메일도 회사 신원으로 매핑합니다. CI/CD나 Kubernetes pod 같은 워크로드는 컴퓨팅 플랫폼을 OIDC token 발급자로 신뢰하거나 일회용 join token으로 등록합니다. 하위 MCP server에는 사용자 대신 agent 이름이 담긴, 약 60초만 유효한 서명 token을 전달합니다.
sub-agent는 부모 agent의 권한을 트리 구조로 상속하므로 추적이 비교적 단순합니다. 어려운 쪽은 여러 사용자가 공유하는 agent입니다. 여러 Google Drive에 연결된 공유 agent에 사용자 A가 자기 문서를 요청했다면, 사용자 B가 같은 데이터를 조회할 수 없어야 합니다. 요청자 신원과 agent 실행 신원을 구분하는 문제는 업계가 아직 풀고 있는 과제입니다.
모델의 거절에만 의존하면 안 됩니다
민감 정보 처리를 모델 자체의 판단에 맡길 수 없다는 점은 간단한 실험으로 확인됩니다. Claude Code 데스크톱 환경에서 고장난 문의 양식을 Datadog 로그로 조사해 달라는 요청에 이름, 도시, 전화번호, 그리고 미국 사회보장번호(SSN) 형태의 아홉 자리 숫자를 레이블 없이 섞어 넣었습니다. 모델은 이 숫자가 무엇인지 알아채지 못하고 그대로 외부 도구를 호출했습니다. 반면 control plane 대시보드는 session을 실시간으로 잡아 token 비용을 계산하고, SSN 탐지 경고를 즉시 띄웠으며, prompt에는 없었지만 tool call payload 안에 들어간 이메일 주소까지 찾아냈습니다. 같은 데이터를 "SSN:"처럼 명시적으로 레이블을 붙여 다시 보내자 모델은 민감 정보임을 인식하고 외부 검색 질의에서 제외했습니다.
LLM은 비결정적이어서 같은 유형의 데이터라도 상황에 따라 잡기도 놓치기도 합니다. 그래서 harness 단에서 프로그램적으로 작동하는 결정론적 guardrail이 필요합니다. 차단 정책이 발동하면 payload가 외부 API에 도달하기 전에 hook이 가로채고, 어떤 정책을 위반했는지 설명하는 구조화된 오류를 개발자와 모델에게 돌려줍니다. 모델은 안전한 안내문만 받기 때문에 사용자에게 금지된 데이터를 빼고 다시 요청하라고 알려 줄 수 있습니다. 민감한 데이터는 모델 제공자가 알기 전에 가로채는 것이 이상적인 구조입니다.
자격 증명만 확인하는 것도 충분하지 않습니다. 자격 증명은 인증을 증명할 뿐 의도와 상황의 안전성을 증명하지 않습니다. 그래서 정책은 신원에 묶여 역할별로 달라야 합니다. DevOps 팀의 agent는 GCP 인프라 변경을 허용하되 일반 개발자의 agent는 막고, 민감 정보 처리 교육을 받은 고객지원 담당자에게는 특정 endpoint로의 PII 전송을 허용하되 다른 역할에는 막는 식입니다.
직접 만들 것인가, 들여올 것인가
이런 체계를 사내에서 구축하려는 팀이 미리 계획해야 할 항목은 여덟 가지로 정리됩니다.
- harness마다 다른 payload, 이벤트 이름, hook 형식을 하나의 이벤트 schema로 통일
- 몇 주 단위로 바뀌는 hook API와 CLI 사양에 따른 harness 변화 추적
- telemetry 자체가 유출 경로가 되지 않도록 기기 단에서 PII 삭제
- inline hook이 느리면 Claude나 Codex가 timeout으로 session을 끊으므로 엄격한 latency 예산
- 백엔드 장애 시 fail-open(통과)인지 fail-closed(차단)인지 사전 결정
- 네트워크 단절 시 이벤트를 로컬에 쌓아 두고 복구 후 재전송하는 offline buffering
- 노트북 프로필, API key, 자동 워크로드를 사람 운영자에게 연결하는 신원 매핑
- GDPR, HIPAA 같은 규제를 받는 대량의 session transcript 저장·보존 정책
판단 기준은 비교적 명확합니다. 하나의 harness와 하나의 운영체제로 표준화된 소규모 팀, 초기 개념 검증, 그리고 harness 연동을 전담해 유지할 엔지니어가 있는 경우에는 직접 구축이 가능합니다. 반대로 로컬 머신, 가상 서버, 클라우드에 걸쳐 여러 모델과 harness를 쓰고, 법적 효력이 있는 감사 기록과 통합 신원 검증, 로그가 아닌 실제 차단이 필요한 규제 환경이라면 상용 control plane이 현실적인 선택지로 제시됩니다. 다만 이런 기준은 상용 플랫폼에 유리하게 읽힐 수 있으므로, 자기 조직의 harness 수와 규제 요건을 기준으로 직접 따져 보는 것이 맞습니다.
작은 팀이 Git에 넣어 둔 Claude Code hook 스크립트로 시작하는 것은 합리적이지만, 규칙이 복잡해지고 latency 제약이 엄격해지면 성능이 떨어지고, 마케팅과 영업처럼 비기술 부서가 리서치와 트렌드 추적에 agent를 적극적으로 쓰기 시작하면 개별 스크립트로는 데이터 유출 방지와 자격 증명 보안을 감당할 수 없게 됩니다.
몇 달씩 돌아가는 session과 감시 논란
Claude Projects처럼 orchestrator agent가 몇 주 동안 지속되는 구성에서는 긴 실행 시간 자체가 문제가 아닙니다. 중요한 것은 사용자가 작업이 끝났다고 믿은 뒤에도 tool call과 token 소비가 계속되는 폭주 상태를 잡는 것입니다. 로컬에서는 금방 눈에 띄지만 클라우드의 agent는 조용히 큰 비용을 쌓습니다. 그래서 장기 session은 누적 총액보다 시간당·일당 소모율을 보는 쪽이 유용합니다. 또 guardrail은 실행 중인 session에도 동적으로 적용되어, 월 중에 정책이 바뀌면 기존 agent가 다음 turn부터 새 제한을 따릅니다.
개인 Claude나 ChatGPT 계정까지 관측하면 직원 감시가 되지 않느냐는 우려가 나올 수 있습니다. 하지만 감시는 도구의 문제가 아니라 문화와 관리의 문제로 보아야 합니다. 통제 범위를 회사 위험 축소와 파괴적 행동 방지로 한정하고, telemetry에 엄격한 RBAC(역할 기반 접근 제어)를 걸어 엔지니어가 서로의 대화를 들여다볼 수 없게 하며, 각자 자기 session과 자기 agent가 호출한 하위 프로세스만 보게 하는 것이 그 방법입니다. device agent를 설치할 수 없는 iOS와 Android에서는 기업·팀 플랜의 inference hook으로 모델 요청만 잡습니다.
정리: 어디서부터 시작할까
핵심은 세 가지입니다. agent는 session 단위로 보아야 하고, 모든 session에서 비용·시간·위험을 재야 하며, 통제는 보이는 것을 확보한 뒤에 경고와 안내를 거쳐 차단으로 올라가야 합니다. 조직에서 바로 시작할 수 있는 순서는 다음과 같습니다.
- 라이선스 수나 구매 기록이 아닌 실제 실행 기준으로 agent, harness, MCP server 인벤토리를 만듭니다. 개발자 노트북의 로컬 MCP server와 Ollama 같은 로컬 모델 도구까지 포함합니다.
- session마다 사용자, harness, 모델, prompt 이력, tool call, MCP 연결을 기록하고, 사용자·팀·부서별 token 지출과 turn 수에 실시간 경고를 겁니다.
- MCP server allow-list를 일찍 도입하고, 공개 저장소에서 가져온 server는 연결 전에 검증합니다.
- 비밀 정보, SSN, 전화번호 같은 민감 데이터는 prompt가 기기를 떠나기 전에 로컬에서 검사하고 지웁니다. 모델의 거절에 맡기지 않습니다.
- agent에게 사람의 전체 권한 token을 물려주지 않고 저장소와 작업에 필요한 범위로 좁히며, 모든 agent에 책임지는 소유자를 둡니다.
- VM 삭제 같은 파괴적 명령에는 사람 승인을, 핵심 시스템에는 두 사람의 승인을 요구하고, 예산 한도와 kill switch를 준비합니다.
- 백엔드 장애 시 fail-open과 fail-closed 중 어느 쪽을 기본으로 할지 장애가 나기 전에 결정합니다.
모니터링할 수 없는 것은 관리할 수 없습니다. 지금 회사에서 agent가 몇 개 돌아가는지 답할 수 없다면, 그 질문에 답할 수 있게 만드는 일이 첫 번째 과제입니다.


