Anthropic 针对 Claude Code 给出的最新建议,是让开发者不再亲手做五件事:引导模型、批准命令、对高风险操作说“不”、检查成果、启动会话。这些工作如今分别交给模型、harness(包裹模型并运行其工具的软件)或任务实际执行的环境。开发者的角色也随之改变,从一次盯着一个会话,转为同时管理多个并行会话。
这一变化背后的数字相当可观。Anthropic 工程团队的代码变更量从 5 月的每天约 2,500 次增至 9 月的每天 30,000 次以上,增长约 12 倍。2026 年 11 月,Anthropic Claude Code 团队的一名成员在 AI Engineer 大会的演讲中介绍了支撑这一跃升的做法。核心观察是:多数开发者仍在单个会话里按顺序使用 Claude Code,而 Anthropic 的工程师同时监管着数十个并发会话。
五项工作一览
| 工作 | 旧习惯 | 由谁接手 |
|---|---|---|
| 引导 | 一步步纠正模型,写冗长的规则文件 | 模型本身,加上一份精简的 CLAUDE.md |
| 批准 | 逐条确认命令,或干脆跳过权限检查 | 自动模式及其分类器 |
| 说“不” | 在提示词里请模型不要做某事 | 拒绝规则、沙箱、云端会话 |
| 检查 | 事后阅读成千上万行改动 | 通过/失败关卡、钩子、审查智能体 |
| 启动会话 | 每个子任务开一个会话 | 带编排器的 Claude Code Projects |
下文逐一说明每项工作该怎么改,先从与危险命令有关的两项说起。
批准:在你划定的范围内,让分类器来判断
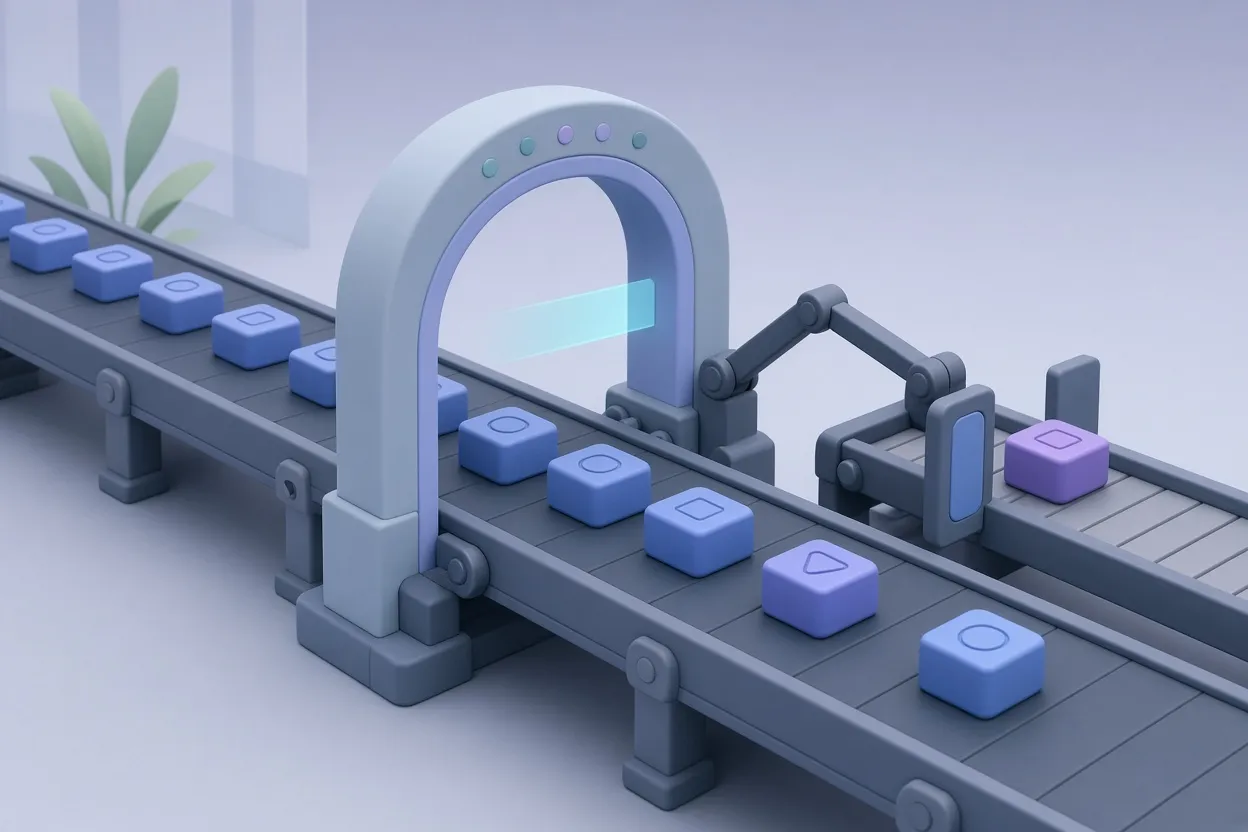
旧的工作流只有两个选择:要么手动确认每一条命令,要么完全跳过权限检查、自担风险。自动模式如今已是 Claude Code 终端和桌面应用的默认设置,它取代了这两种做法。每条待执行的 shell 命令在运行前,都由一个独立的分类器评估。被判定为安全的命令,例如运行测试或安装软件包,会直接放行;它拿不准的命令则会被拦下。
默认情况下,自动模式把写入权限限制在当前目录和代码仓库内,并拦截向部署分支推送之类的高风险操作。例如,向预发布服务器部署时,如果目标仓库不在受信任范围内,操作就会被拦住。
扩大这个范围应当是有意为之,而不是无意间放开:
- 在 settings.json 中用平实的英文写下规则,列明你信任的 GitHub 组织、Amazon S3 存储桶和内部域名。
- 运行
/auto-mode-setup,让 Claude Code 分析你的项目历史和近期会话,为你起草一份权限配置。
Anthropic 2026 年 8 月的一项研究说明了为什么该信任分类器,而不是自己的注意力。参与把关的人类开发者只发现了 14% 的明显危险命令,自动模式则拦截了 89%。
▲ 执行前的命令筛查
说“不”:对无法撤销的操作设硬性拦截
89% 的拦截率仍意味着大约每 10 条危险命令中就有 1 条可能漏过。仅靠自动模式并不构成安全边界。这个缺口要由拒绝规则来补:它们是写在 .claude/settings.json 中的条目,起到程序层面的硬性拦截作用,先于分类器评估,并且无条件生效。
判断什么值得写成拒绝规则,只需问一个问题:“我能撤回吗?”
- 能: 对代码、测试和文档的修改,以及运行测试。这些副作用可以通过版本控制撤销,交给模型处理即可。
- 不能: 永久删除文件、泄露密钥或凭据,以及任何发往外部的内容。这些需要拒绝规则。
在提示词里请 Claude 不要碰密钥,与在权限配置中强制执行这一限制,两者有重要区别。提示词只是请求;针对 .env 或 ~/.ssh 目录等文件的读写设置拒绝规则,才是拦截。
针对命令的拒绝规则也并非面面俱到。通过 npm 这类包管理器运行测试时,会执行已安装依赖中的第三方代码。这些代码可能试图读取环境变量或 SSH 密钥并发送到别处,而整个过程中不会出现任何可疑的 shell 命令供分类器标记。有两种环境层面的防御可以应对:
/sandbox在操作系统层面隔离进程,限制文件访问和对外网络连接。- 云端会话把任务放在一台用完即弃的远程机器上运行,上面没有你的任何本地凭据。长达数小时的自主任务建议放在这里。
检查:开工之前先把关卡建好
当会话无人值守运行数小时,事后阅读成千上万行改动并不现实。而且,结果看起来完成了,不代表就是对的。以把认证系统迁移到新的 API 端点为例:同一条提示词可能产出一个仍保留旧端点的版本,一个只对新登录有效的版本,或者一个让所有活跃用户都被登出的版本。三者都可能通过表面检查。
解决办法是在过程中设置通过/失败关卡,而不是只在最后做一次审查:
- 设定客观的里程碑。 对代码而言,是自动化测试或界面截图;对市场调研报告这类知识工作而言,是“每个引用链接都能打开”“每个数字都与电子表格一致”这样的检查。
- 先让 Claude 定义什么是“完成”、什么是“好”。 这会促使模型在给你看第一版之前,先自行评估并迭代草稿。
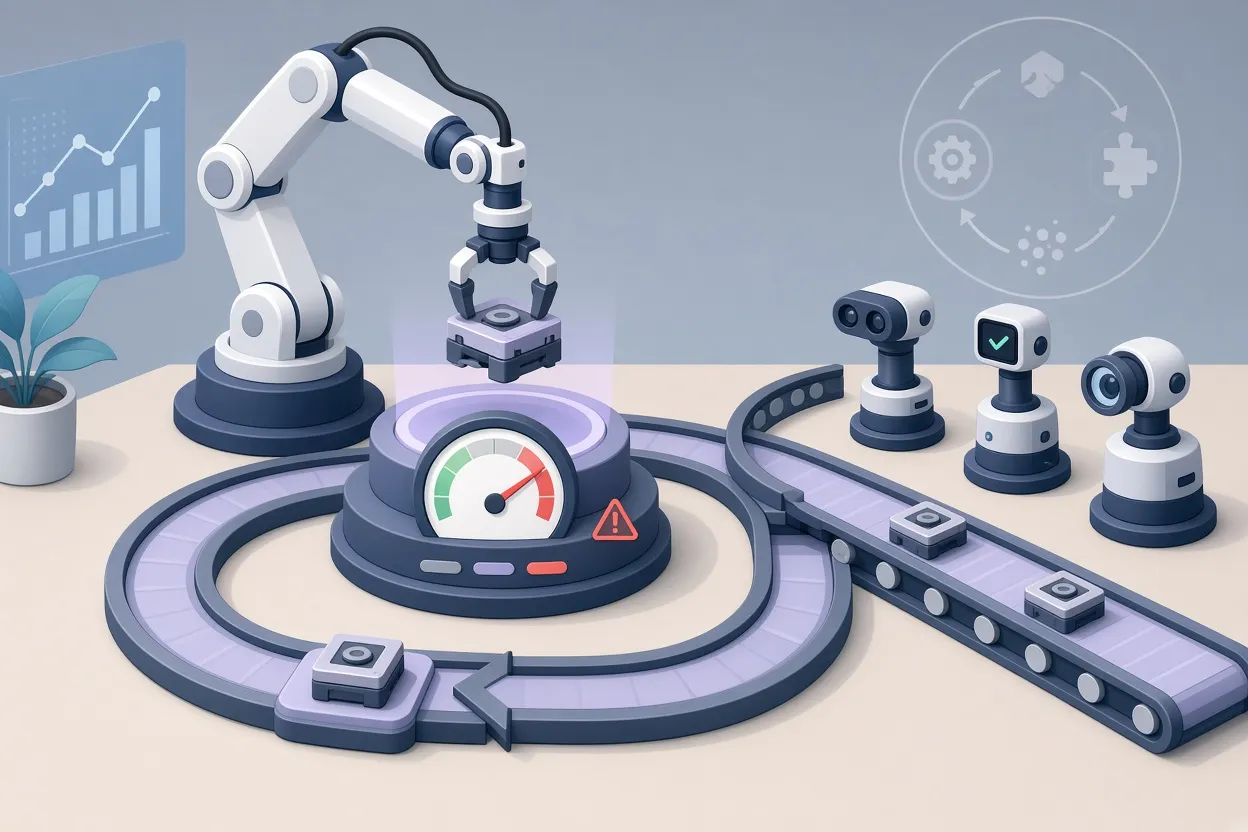
- 用钩子把检查自动化。 钩子(hooks)是在会话中特定事件发生时触发的脚本。一种配置是:每次工具调用后运行代码检查(lint),任务完成时运行任务级测试,会话结束时运行完整测试套件。
- 把退出码设对。 常见的默认值会发出错误信号,见下表。
| 钩子失败时的退出码 | Claude Code 的反应 |
|---|---|
| 1(常见默认值) | 将任务标记为完成 |
| 2 | 回头修复失败之处 |
钩子脚本若以退出码 1 失败,出了问题的任务就会被当作已完成放过去。退出码 2 才会让 Claude Code 回头修复。
自动化关卡之后,是由其他智能体进行审查。在 Anthropic 的内部流程中,每个拉取请求(pull request)在人类工程师查看之前,都要先经过全新的、相互独立的 Claude 审查智能体。这些智能体会检测缺陷、核实严重程度、过滤误报,然后才发表评论。
▲ 自动化的测试、返工与审查循环
引导:把 CLAUDE.md 精简到只剩 Claude 找不到的内容
在 Claude Opus 4.5 时期,开发者必须一步步盯着模型、给提示、做纠正。许多人还在 CLAUDE.md(Claude Code 为项目读取的指令文件)里塞满了全大写的“IMPORTANT”“NEVER”之类的强硬指令。
到了 Claude Opus 5.5,这种习惯反而会拖后腿。措辞激进或重复的指令往往适得其反,导致多余的工具调用和更差的表现。推荐的筛选标准很严格:只保留 Claude 无法通过查看代码仓库自行发现的信息。凡是能从文件中推断出来的都删掉;隐藏的架构模式和外部文档链接则保留。
把这一思路用到代码之外的一种做法,是在单个目录里运营整个业务,并把 CLAUDE.md 当作路由图。这个文件本身不承载知识,只指明业务知识库(wiki)、品牌素材和财务账目各自放在哪里。
要清理现有文件,可运行 /doctor prompt-audit。它会对照当前使用的模型检查你的指令,标出臃肿或适得其反的规则。
启动会话:一个根会话,多个工作会话
最后一个手动步骤,是为每个子任务新开一个会话。Claude Code Projects 目前面向 Pro、Max 和 Ultra 套餐提供测试版,它省去了这一步。一个根会话接收项目的完整待办清单,比如一周的里程碑,并为每项交付物启动一个独立的工作会话。
项目设置允许为不同角色指定不同模型。一种搭配是让高层推理模型 Claude Fable 5.2 担任编排器,由 Claude Opus 5.5 工作会话负责执行。这种结构不限于编程,同样适用于客户交付物、研究简报和视频制作流程。
这周该改什么
贯穿始终的一点是:精力从亲手执行转向设计 harness、环境和关卡。对那些无法亲自判断每条命令的人来说,这一点似乎最为重要,因为护栏承担了原本要由审查者来做的工作。一个可行的操作顺序:
- 运行
/doctor prompt-audit,删掉 CLAUDE.md 中 Claude 能从代码仓库里了解到的一切内容。 - 运行
/auto-mode-setup,然后在 settings.json 中列出你信任的代码仓库、域名和存储桶。 - 用“我能撤回吗?”检视你的工作流,为每个“不能”写下拒绝规则:删除操作、凭据文件、对外发送的消息。
- 本地使用
/sandbox,把长时间的自主运行任务移到云端会话。 - 为代码检查和测试添加钩子,并确认失败时以退出码 2 退出。
- 选一个有分量的项目,把待办清单交给 Claude Code Projects 中的单个根会话,然后把仍然剩下的手动瓶颈也自动化。