给每位员工都配了 AI 工具却仍然看不到多少变化的企业,通常并不是撞上了模型能力的上限。更常见的障碍是:最要紧的那些流程从未写成文字,而掌握这些流程的人只是拿到了一套软件,却没有想用它的理由。主持这类项目的实践者——包括一家围绕 AI 重建企业工作流的公司的一位工程师,以及 Anthropic 的一位研究产品经理——给出了另一条路径:把专家实际在做的事记录下来,分阶段引入自动化,让来自同事的实证去完成说服。
落地在哪里出了问题
大多数失败的转型,根源在变革管理,也就是让人们改变工作方式的那部分工作,而不在模型不够强。这是那位工程师的判断,他参与过六个不同行业的客户转型项目。把做好的 AI 工具“盛在银盘里”端给员工,却不去处理组织和人的行为方式,这样的做法屡屡失败。
第二个问题是隐性知识,即人们一直在用、却从未说出口的诀窍。软件领域提供了一个有用的对照。据 Anthropic 的这位产品经理介绍,支撑 Claude Code 的 JavaScript 运行时 Bun,其约 100 万行的代码库由 AI 模型在大约一周内重写成了 Rust,随后又用了几周做验证和测试。这样的工作以往需要一支大团队花上一年多。它之所以能成,部分原因在于单元测试和集成测试精确定义了什么才算正确行为。
业务工作流没有这样的测试套件。那位工程师估计,领域专家每天依赖的考量和经验法则,他们自己只能说清大约一半。其余部分他们往往并未意识到,因此靠访谈和问卷画出的流程图总是不完整。
捕捉专家想不到要说的东西
这位工程师所在公司采用的方法,类似于消费级软件的用户研究。有人坐在员工旁边,看着员工做真实的工作。一旦出现意料之外的情况,比如跳过了某份文件或某条规则,观察者就当场追问原因。员工通常有充分的理由,而这种理由永远不会被写进书面的操作指南。
该公司不想只依赖人工观察,因此目标是打造能自动引出这类知识的工具。部署本身成为捕捉过程的一部分:
- 影子模式。AI 被动观察并跟踪真实的生产活动,不采取任何行动。
- 预先完成。AI 把任务准备好并提出操作建议,由人逐项审查并明确批准。
- 修正记录。系统记录每一次交互和每一处人工改动,这些修正会随时间推移不断完善模型的行为。
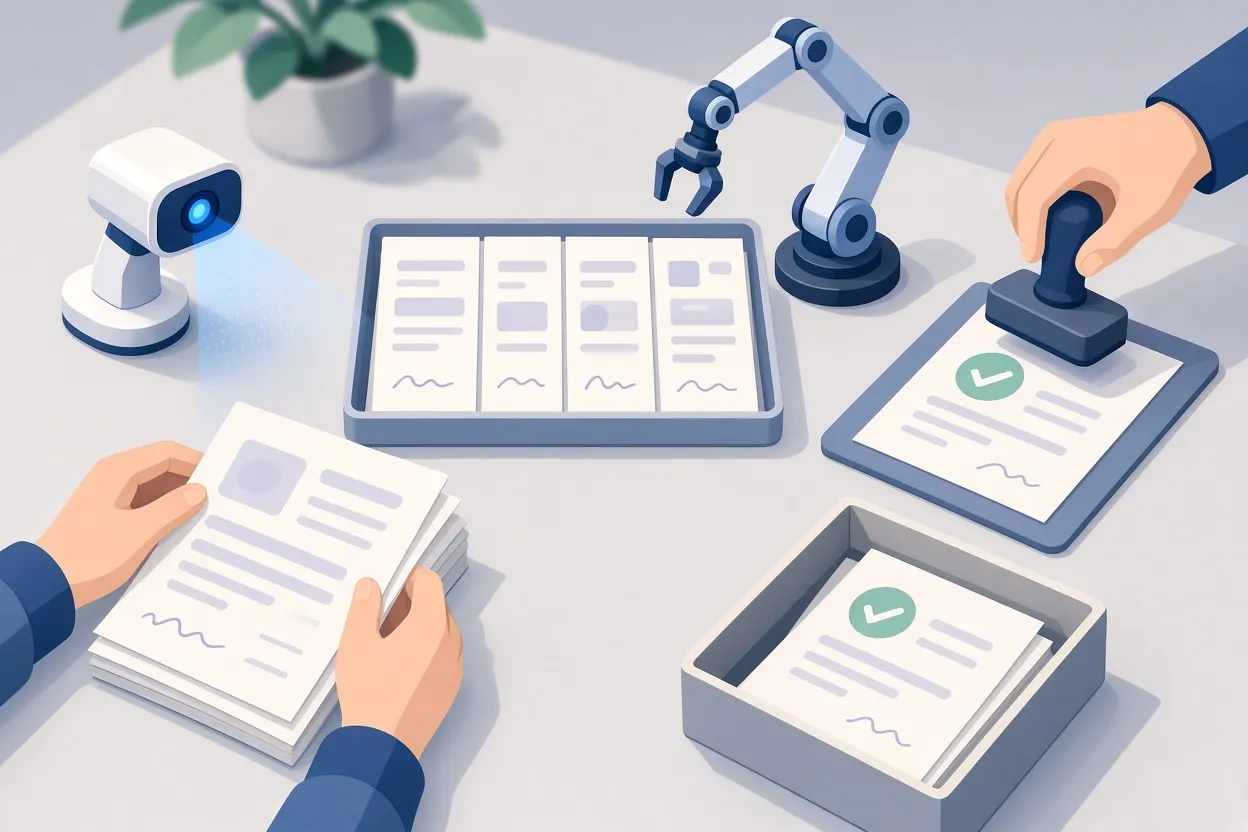
▲ 从影子模式到人工审批的分阶段上线
一种相关的做法是,让 AI 模型通读完整的业务操作记录,而不是只依赖围绕预先选定的信号搭建的仪表盘。读过完整记录的智能体,能注意到没有人想到要去找的异常、规律和错误。
员工自己选择的采用
传统的变革管理依靠自上而下的指令和打勾式的硬性要求。那位工程师认为,这套做法对 AI 来说基本已经过时,他更倾向于接近产品驱动式采用的方式:人们用这个工具,是因为喜欢它。
有两项设计选择支撑这一点:
- 从人们讨厌的杂务入手。软件替员工卸下每天都发怵的运营负担,才能赢得好感。
- 让审查轻松且有回报。AI 预填好工作后,一项重复性的 20 分钟任务就缩减为快速核对这一步,而应用内奖励或排行榜能让这一步不那么像是在应付合规。
Anthropic 的这位产品经理补充了第三个要素:给一小群热情的早期采用者充裕的 token 额度(token 是计量 AI 用量的单位),让他们做出具体的实证。当受信任的同事拿出让人无法否认的成果时,兴趣会在各部门间扩散,无需高管施压。
有一个案例说明了这种效果。一家学徒期长达三个月、要求严格的公司,构建了一个 AI 智能体来捕捉专家知识,用于任务自动化。此后,新员工通过向这个智能体提问,学会工作的速度明显加快,并且从入职第一天起就把它当作工作方式的一部分。曾经抵触这些工具、有 20 年资历的员工,在看到新人表现超过自己之后改变了想法。
▲ 同事实证吸引资深员工走近AI工具
同样的逻辑也适用于受监管领域里持怀疑态度的专业人士。泛泛地谈 AI 可能做到什么,说服不了他们。在他们自己领域的一个狭窄环节做一次聚焦的演示则可以,比如展示一套痛苦的 12 步流程被压缩成一条端到端的自动化工作流。一旦人们看到一个有野心的成果在自己的领域里可靠运行,他们的思路往往会从个人效率转向重新设计流程。
瞄准整个流程,而不是让某一步更快
一个反复出现的弱点是雄心不足:把 AI 塞进现有工作流,而不是把一整套端到端的系统交给自主智能体。Anthropic 的这位产品经理说,与一家成熟企业合作的第一步是诊断:业务的瓶颈在哪里,哪些流程可以被重塑,而不只是提速。他举了 Shopify 的例子,这家公司围绕 AI 重构了自己的运作流程,产品经理直接构建功能,工程师获得的杠杆也大得多。
两位实践者还都会对客户最初提出的需求提出异议。企业往往要等外部视角指出来,才意识到某个运营问题的存在。
判断它是否奏效
AI 部署从来不会真正完成,因为有竞争力的团队一直在迭代。成熟度体现在衡量上:
- 评测套件,即 evals,是对模型输出的可重复测试。成熟的团队会刻意保持评测的难度,这样新模型到来时仍能显示出提升。
- 专家知识从临时的提示词中移出,沉淀为可复用的上下文和参考文档。
- 单位经济指标,例如把单次任务成本与交付的价值相对照。在软件领域,这意味着把每次拉取请求(pull request)审查的成本,与审查质量和下游缺陷放在一起看。
- 经过压力测试的护栏,确保智能体不越出公司政策的范围。
| 案例 | 之前 | 之后 |
|---|---|---|
| 政府机构合规审查 | 借助外部承包商,耗时数月、耗资数百万美元 | 使用 Claude 约一周 |
| 将约 100 万行的代码库重写为 Rust | 一支大团队需要一年多 | AI 工作约一周,外加几周验证 |
| 某公司的新员工入职培训 | 三个月学徒期 | 借助由专家训练的智能体,明显加快 |
节省人力并不总是最大的收获。在以零人工投入为目标的工作流中,人力成本通常是模型推理成本的 100 倍以上,因此压缩算力开支意义不大。在高风险工作中,连人力都可能不是重点。在一条法律合规工作流中,客户的内部评估认为单次出错的成本中位数为 $70万,尾部风险最高可达 $1亿。在这种情况下,把错误率从 0.03% 压到 0.01% 具有巨大的财务价值。
收益也会从计划之外的方向到来。降低一项任务的成本和耗时,可以让一项原本只留给付费最高的客户的服务,变成面向全体客户提供的服务,两位实践者把这种模式与杰文斯悖论联系起来。同样,Anthropic 的客户已经把 Claude 用到了药物发现和临床试验工作中,走在了公司预见到这些用途之前。
对于代码无法检验的主观性工作,实用的方法是把人工抽查与充当裁判的第二个模型结合起来。不应假定智能体比专家更聪明。它们的长处是耐心:一个人或许能审阅 10 到 100 小时的记录,而自动化评测可以检查数千小时。专家仍然需要先亲自阅读原始材料,再把发现转化为评测。衡量 AI 投资回报率这门学问仍不成熟。
在成本方面,Anthropic 的这位产品经理估计,每一美元能买到的智能水平大约每年提升 100 倍,这也是早期在探索上大举投入的公司如今获得丰厚回报的原因。
要点与下一步
分发工具是容易的部分。更难的是把专家所知挖掘出来,并给人们一个采用成果的理由。对这些案例的一种合理解读是:采用跟随证据,而不是跟随指令。
对于正在规划或补救落地工作的团队:
- 坐到做事的人身边,对看到的每一处偏离都问个为什么。
- 从影子模式起步,再过渡到 AI 备好工作、由人批准,并记录每一次修正。
- 先瞄准最招人讨厌的杂务,并让审查环节保持轻量。
- 给一个小型试点小组充足的资源,让它的成果通过同事传开。
- 为持怀疑态度的人在一个狭窄领域做出一个有野心的端到端演示。
- 尽早确定要衡量什么,并把出错成本与人力节省放在一起权衡。