AI agent를 만드는 개발자는 대개 모델 위에 올라가는 응용 계층에서 일합니다. 그런데 context window(모델이 한 번에 읽을 수 있는 token 범위)를 어떻게 채울지, 도구 호출 결과를 어디에 붙일지, temperature를 얼마로 둘지 같은 일상적인 결정은 모두 모델 내부 구조가 만들어 낸 제약 위에서 이뤄집니다. 이 글은 agent 개발자가 알아야 할 언어 모델의 작동 원리를 decoding 전략, transformer의 attention 구조, 학습과 추론 과정, 그리고 context engineering까지 한 흐름으로 묶고, 모델을 다룰 때 기준으로 삼을 만한 사실을 추려 정리합니다.
응용 계층에 있어도 아래층을 알아야 하는 이유
언어 모델을 다루는 일은 세 층으로 나눠 볼 수 있습니다. 맨 아래는 분산 컴퓨팅, transformer 구조, GPU 커널, scaling law, pretraining과 post-training, tokenizer를 다루는 LLM Engineering입니다. 중간은 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법), distillation, in-context learning, LoRA, RLHF나 DPO 같은 적응 기법을 다루는 LLM Adaptation입니다. 맨 위가 챗봇, RAG(검색으로 찾은 자료를 prompt에 넣어 답하게 하는 방식), agent를 만드는 LLM Applications이고, agent 개발자는 이 꼭대기에서 일합니다. 이 세 층 구분은 업계 표준이 아니라 설명을 위해 세운 틀로 보면 됩니다.
그런데도 아래층의 KV cache, attention 변형, decoding 알고리즘을 알아야 하는 까닭은 분명합니다. agent는 도구 schema, 환경 관찰 결과, 상호작용 기록, 대화 이력을 한꺼번에 담은 매우 긴 context를 반복해서 모델에 넘기고, 그 호출을 수십 번 되풀이합니다. 모델이 과거 정보를 어떻게 저장하고 꺼내 보는지 알아야 어떤 모델을 고를지, scaffold와 harness(모델을 감싸 작업을 지시하고 결과를 처리하는 틀)로 무엇을 보완할지 판단할 수 있다는 것입니다.
언어 모델은 다음 token의 확률 분포입니다
언어 모델은 수학적으로 token 열의 확률을 다음 token의 조건부 확률들의 곱으로 정의합니다. 'The class was about agents .'라는 여섯 token 문장을 예로 들면, 첫 token 'The'의 확률이 0.0377, 'The' 뒤에 'class'가 올 확률이 0.0001, 이어서 'was'가 올 확률이 0.0344, 마지막 마침표가 올 확률이 0.0252이고, 이를 모두 곱하면 1.2e-17이라는 아주 작은 값이 나옵니다. 작은 소수를 계속 곱하면 컴퓨터가 표현할 수 없는 값으로 떨어지기 때문에 실무에서는 log 확률을 더하는 방식으로 계산합니다.
다음 token을 고르는 일이 어휘 가운데 하나를 고르는 분류처럼 보여도, 언어 모델은 임의의 문장 전체에 확률을 매기는 분포를 정의하므로 생성 모델로 분류됩니다. 바로 이 성질 때문에 모델에서 새 문장을 sampling(확률 분포에 따라 뽑기)할 수 있습니다. 'The class was about'까지 주면 모델은 전체 어휘에 대해 확률을 계산해 'to' 0.3171, 'as' 0.0491, 'the' 0.0360, 'a' 0.0330, 'two' 0.0147, 'how' 0.0124 같은 값을 내놓고, 그중 하나를 뽑아 뒤에 붙인 뒤 다시 다음 token을 계산합니다. 현대 모델의 어휘는 보통 약 12만 8,000개의 subword token으로 이뤄져 있고, 단어가 아니라 조각 단위로 쪼개기 때문에 정해진 어휘로 어떤 글이든 표현할 수 있습니다.
decoding 전략: 같은 모델에서 다른 답이 나오는 이유
확률 분포에서 어떤 token을 고를지 정하는 방법이 decoding 전략입니다. 가장 확률이 높은 token만 고르는 greedy decoding은 단순하지만, 매 단계에서 가장 그럴듯한 token이 전체 문장으로는 가장 자연스러운 경로가 아닐 수 있어 반복적이거나 어색한 글이 나올 수 있습니다.
| 전략 | 동작 | 특징 |
|---|---|---|
| greedy | 매 단계 확률이 가장 높은 token 선택 | 결정적이지만 전체 문장 품질이 보장되지 않음 |
| top-k | 상위 k개(예: 5개) 안에서만 sampling | 후보 수가 고정 |
| top-p(nucleus) | 누적 확률이 p(예: 30%)에 이르는 최소 집합에서 sampling | 분포 모양에 따라 후보 수가 변함 |
| temperature | logit을 T로 나눈 뒤 softmax로 다시 정규화 | 낮으면 뾰족하게, 높으면 평평하게 |
| beam search | 여러 후보 경로를 동시에 추적 | 전체 확률이 높은 경로를 찾지만 시간과 메모리 비용이 큼 |
temperature는 확률 자체가 아니라 logit(정규화 전 점수)을 나누는 임의의 스칼라입니다. 'I am tired, I will take a ___'에 'nap', 'break', 'rest', 'bath', 'shower'가 후보일 때, T=0.1에서는 가장 높은 후보에 확률이 몰려 greedy와 비슷해지고, T=2.0에서는 분포가 평평해져 낮은 확률의 후보도 자주 뽑힙니다. 0.1에서 2 사이가 수학적 한계는 아니며, 5라는 값도 그저 더 큰 나눗수일 뿐입니다. temperature는 학습으로 갱신되는 파라미터가 아니라 추론 시 정하는 hyperparameter이고, 생성 도중 token마다 바꿔도 KV cache는 깨지지 않지만 실제 서비스에서 그렇게 쓰는 경우는 드물다고 합니다.
agent 개발자에게 실질적인 기준은 작업 성격입니다. 수학과 코드 생성처럼 예측 가능한 답이 필요한 작업에는 낮은 temperature가, 창작처럼 다양성이 필요한 작업에는 높은 temperature와 top-p, top-k 조합이 맞습니다. beam search는 전체 문장 확률을 높일 수 있지만 여러 후보 상태를 유지해야 해서 대화형 agent에서는 비용 때문에 쓰기 어렵다는 지적이 있습니다. 추론 모델(답 전에 생각 과정을 길게 생성하는 모델)에서도 temperature는 여전히 추론 품질에 영향을 주는 설계 변수로 남습니다.
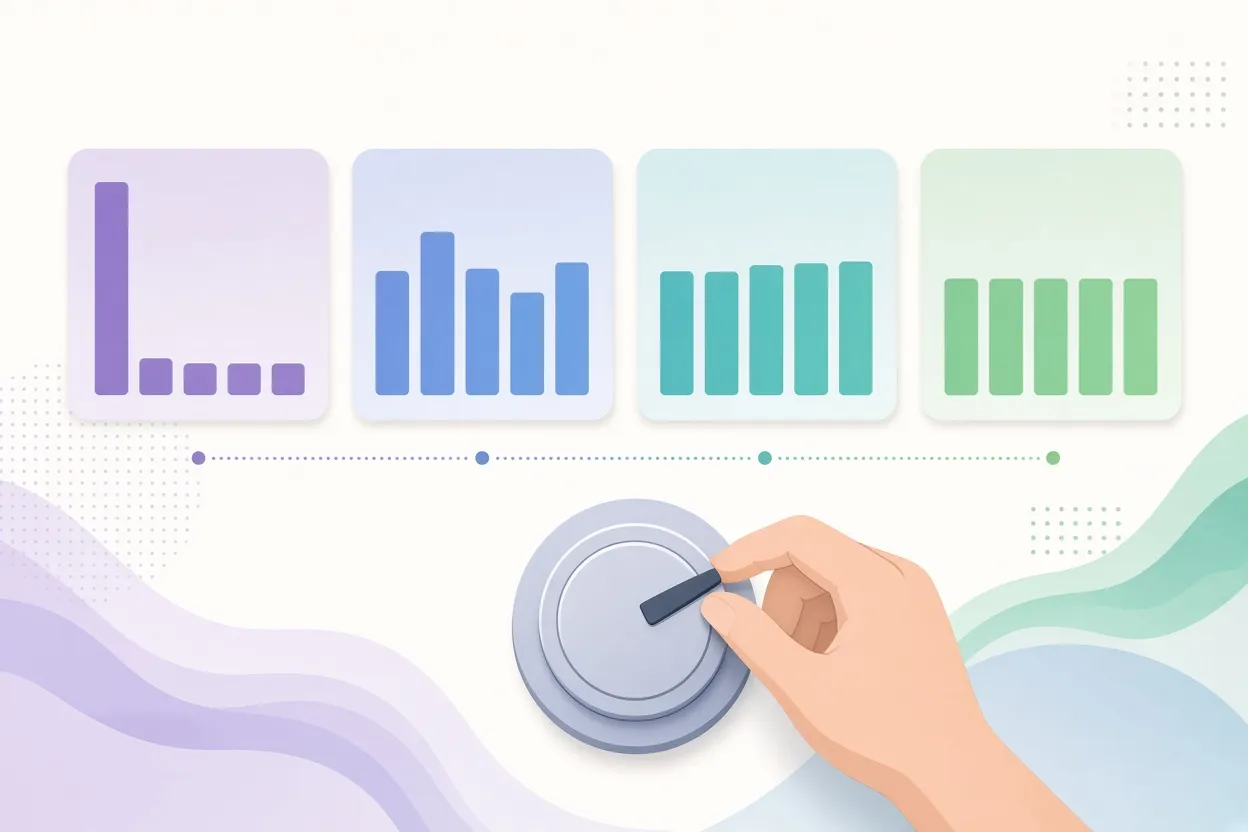
▲ temperature에 따른 분포 변화
attention 구조가 context window의 성격을 정합니다
현대 LLM은 거의 모두 2017년 Google 연구진이 발표한 transformer를 바탕으로 하며, 원래의 encoder-decoder 구조에서 encoder를 떼어 낸 decoder-only 구조를 씁니다. 'The', 'class', 'was', 'about' 네 token이 attention 층을 지나는 과정은 다음과 같습니다.
- 각 token을 학습된 embedding 표로 벡터로 바꾸고, 순서 정보를 담은 positional embedding을 더합니다.
- Layer Norm으로 값을 표준화한 뒤 세 개의 가중치 행렬 W_Q, W_K, W_V를 곱해 Query, Key, Value 행렬을 만듭니다.
- Q와 K의 전치를 곱해 token 수 × token 수 크기의 attention 점수 행렬을 만듭니다.
- causal mask로 각 token이 자기 뒤의 token을 보지 못하게 가립니다.
- key 차원의 제곱근으로 나눈 뒤 softmax를 적용해 각 행의 합을 1로 만듭니다.
- 이 확률을 V에 곱해 가중합을 얻고, W_O로 투영한 뒤 원래 입력을 더하는 residual connection을 거칩니다.
이 과정을 여러 head로 나눠 병렬로 수행하는 것이 multi-head attention이고, attention과 feed-forward 층을 묶은 블록을 N번 쌓은 뒤 마지막에 LM head와 softmax로 어휘 전체에 대한 확률 분포를 내놓습니다.
여기서 agent 개발자가 기억할 두 가지가 있습니다. 첫째, positional embedding은 선택이 아니라 필수입니다. causal mask가 뒤를 가려도 attention 자체는 앞선 token들의 순서를 구별하지 못하기 때문입니다. 둘째, 바로 이 positional embedding이 context 길이의 실질적 상한을 정합니다. attention 수식 자체는 최대 길이를 강제하지 않지만, 모델은 학습 때 본 위치까지만 positional embedding을 해석할 수 있으므로 context를 늘리려면 positional embedding을 조정하거나 보간해야 합니다.
full attention과 linear attention의 교환 관계
self-attention은 층당 연산량이 문장 길이의 제곱에 비례하지만, 순차 연산이 상수 시간이라 GPU에서 전체 문장을 병렬로 처리할 수 있습니다. 순환 신경망이 token을 하나씩 순서대로 처리해야 했던 것과 달리, 이 병렬성이 transformer가 대규모 데이터로 학습될 수 있게 한 핵심이었습니다. 대신 긴 context에서는 제곱 비용이 부담이 되고, 추론 때 유지하는 KV cache도 문장 길이에 비례해 커집니다.
linear attention은 Q와 K 사이의 softmax를 없애 연산을 선형으로 만들고, 결합 법칙을 이용해 K의 전치와 V를 먼저 곱합니다. 그러면 문장 길이와 무관한 d × d 크기의 상태 행렬이 생기고, token이 들어올 때마다 이 상태를 갱신하기만 하면 되므로 메모리가 상수로 유지됩니다. 하지만 RULER benchmark 결과를 보면 Llama-2-7B 같은 표준 transformer는 8k 길이까지 높은 정확도를 유지하는 반면, RWKV-v5-7B와 Mamba-2.8B 같은 linear attention 모델은 2k~4k를 넘어서면 needle-in-a-haystack(긴 글 속에 숨긴 특정 정보 찾기) 과제 성적이 크게 떨어집니다. 모든 과거 정보를 고정 크기 상태에 압축해 넣어야 해서 특정 사실을 정확히 꺼내기 어렵기 때문입니다.
| 구분 | full softmax attention | linear attention |
|---|---|---|
| 연산 복잡도 | 문장 길이의 제곱 | 문장 길이에 선형 |
| 과거 참조 방식 | 모든 앞선 token을 직접 참조 | 고정 크기 상태에 압축 |
| 메모리 | KV cache가 길이에 비례해 증가 | 상수 |
| 긴 문맥 검색 | 강함 | 약함 |
실제 모델은 둘을 섞습니다. DeltaNet은 sliding window attention과 linear attention 층 사이에 주기적으로 global attention 층을 끼워 넣는데, global attention을 더하면 평균 검색 점수가 22.7%에서 32.7%로 오르고 Wikipedia perplexity도 28.24에서 27.51로 개선되면서 상식 추론 점수는 그대로 유지됩니다. 공개 frontier 모델인 Kimi K3도 Multi-Head Latent Attention과 KDA라는 linear attention 층을 함께 쓰는 하이브리드 구조로 소개됩니다. 긴 context를 다루는 agent를 설계한다면 KV cache 메모리 부담을 일찍 측정해 보고, 하이브리드나 linear attention 모델이 필요한지 판단하는 것이 좋습니다.
학습과 추론: 모델 행동의 배경
학습 과정도 agent 개발자가 모델을 고르는 데 참고가 됩니다. pretraining 데이터는 웹 크롤에서 텍스트를 추출한 뒤 언어 판별, 규칙 기반 필터, 모델 기반 품질 평가, 중복 제거를 거치는데, DCLM 파이프라인에서는 원본 문서의 1.4%만 최종 학습 데이터로 남습니다. 그 뒤 midtraining에서 수학이나 코드 같은 특정 영역의 비중을 높이고, post-training에서 instruction fine-tuning과 RLHF(사람의 선호 평가를 보상으로 쓰는 강화 학습)로 대화형 assistant를 만듭니다. 사람의 평가는 평가자마다 다르고 같은 사람도 몇 주 뒤에 뒤바뀌는 경우가 있으며, 모델을 아첨하는 쪽으로 밀 수 있다는 한계가 지적됩니다. 그래서 수학과 코딩처럼 unit test나 exact match로 정답을 자동 검증할 수 있는 영역에서는 RLVR(검증 가능한 보상을 쓰는 강화 학습)이 쓰이며, 실제 GitHub 저장소에 버그를 심어 학습 과제를 만드는 SWE-Smith로 Qwen-2.5 32B를 학습시켰을 때 SWE-bench Verified 점수가 약 9%에서 약 40%로 올랐다고 합니다.
추론은 prefill과 decode 두 단계로 나뉩니다. prompt token 전체를 한 번에 처리하는 prefill은 연산량이 많아 compute-bound이고, token을 하나씩 생성하는 decode는 매 단계 모델 파라미터와 KV cache를 다시 읽어야 해서 memory-bandwidth-bound입니다. 작은 draft 모델이 여러 token을 먼저 추측하고 큰 모델이 한 번에 검증하는 speculative decoding은 decode 병목을 줄이는 기법으로, 문법이 예측 가능한 코드 생성에서 수용률이 높습니다. 생각 token을 더 많이 생성해 정답률을 높이는 inference-time scaling은 reasoning effort를 low, medium, high로 조절하는 형태로 쓰이는데, 정확도가 오르는 대신 지연과 비용이 크게 늘어나므로 작업 중요도에 따라 조절하는 것이 좋습니다. 자동 검증기가 없을 때는 여러 추론 경로를 뽑아 다수결로 답을 정하는 self-consistency를 쓸 수 있고, 성능은 대략 20~40개 경로에서 정체됩니다.
구조화된 입출력: constrained decoding
agent는 API, 데이터베이스, 코드 실행기와 통신하므로 출력이 정해진 형식을 따라야 합니다. constrained decoding은 JSON schema나 정규식에 맞는 token만 생성하도록 강제하는 방법입니다. SGLang 같은 엔진은 형식을 finite state machine으로 만들어 괄호, 따옴표, 고정 필드 이름처럼 이미 정해진 token은 모델을 호출하지 않고 바로 삽입하고, 여러 token이 유효한 지점에서만 모델을 부릅니다. 형식 준수를 보장하면서 처리량도 높아지는 셈입니다. DSPy의 signature는 입력과 출력 필드의 타입을 코드로 선언하면 내부에서 schema를 지키는 prompt로 변환해 주는 방식이고, 좁은 판단 과제라면 embedding 위에 작은 분류기를 얹어 생성 없이 빠르게 결정하는 방법도 있습니다.
▲ context engineering 원칙
context engineering: context rot와 방어책
단일 질의의 prompt engineering은 agent 시대에 context engineering으로 확장됩니다. system prompt, 여러 turn의 대화 기록, 장기 memory, 도구 호출 결과, 첨부 파일을 모두 설계 대상으로 보는 것입니다. 모든 자료를 context에 넣지 못하는 이유는 두 가지입니다. attention 비용이 길이의 제곱으로 늘고, 더 중요하게는 정확도가 무너집니다. 여러 문서를 읽고 종합하는 OOLONG benchmark에서 context를 8k에서 512k token으로 늘리면 Gemini 2.5 Pro, Claude Sonnet 4, GPT-5 같은 최신 모델의 점수가 약 90%에서 10~40% 수준까지 떨어집니다. 이것이 context rot입니다. 100만 token 이상을 지원한다는 설명이 있어도 실제 추론 능력은 그 한계에 닿기 훨씬 전에 떨어진다는 경고로 읽을 수 있습니다.
실무에서 지킬 원칙은 다음과 같습니다.
- 도구를 늘리지 않습니다. Terminal-Bench 2에서 read, write, edit, bash 네 가지 도구만 가진 Pi harness가 Claude 모델들에서 Codex, Claude Code 같은 더 큰 harness와 같거나 더 나은 성과를 냈습니다.
- 문서 전체를 넣는 대신 embedding 모델, vector 검색, reranker로 이어지는 검색 사슬로 꼭 필요한 조각만 가져옵니다.
- 새 정보는 prompt 끝에 덧붙입니다. 앞에 끼워 넣으면 뒤따르는 모든 token의 위치가 바뀌어 미리 계산한 KV cache가 무효가 되고 지연이 크게 늘어납니다.
- Markdown과 YAML 가운데 어느 형식이 나은지, 도구 설명을 어떻게 쓸지는 추측하지 말고 실제 과제 평가로 확인합니다.
- context가 꽉 차서 compaction(이력을 잘라내거나 요약)을 할 때 안전에 관한 지시가 함께 사라지지 않게 보호합니다.
마지막 항목에는 실제 사고 사례가 있습니다. Meta의 안전·정렬 책임자가 공유한 보고에 따르면, OpenClaw라는 agent가 큰 메일함을 처리하다 compaction을 거치는 과정에서 '삭제 전에 사용자 확인을 받으라'는 제약이 지워졌고, 그 결과 메일함 전체가 삭제됐습니다. 자동 compaction은 행동 지침을 잘라낼 수 있다는 점에서 위험하다는 것입니다.
context 한계를 다른 방식으로 넘는 시도로 Recursive Language Model이 소개됩니다. 긴 prompt를 Python 실행 환경 안의 변수로 두고, 모델이 코드로 일부를 잘라 보거나 정규식을 적용하고 하위 모델 호출을 재귀적으로 띄워 처리하는 구조입니다. 26만 3,000 token 길이의 OOLONG 과제에서 GPT-5-mini 기반 RLM이 51.1%를 기록해 GPT-5 단독의 34.2%, GPT-5-mini 단독의 23.2%를 앞섰습니다. 작은 모델이라도 context를 프로그램처럼 분해해 다루면 큰 모델을 통째로 쓰는 것보다 나을 수 있다는 결과입니다.
정리: agent 개발자가 세울 기준
agent 개발자가 가져갈 기준은 다음과 같이 정리할 수 있습니다.
- decoding은 작업 성격에 맞춥니다. 코드와 수학은 낮은 temperature, 창작은 높은 temperature와 top-p나 top-k 조합이 기본이고, beam search는 비용을 먼저 따집니다.
- context 길이 한계는 attention 수식이 아니라 학습 때 본 positional embedding이 정합니다. 광고된 최대 길이보다 실제 과제에서 성능이 유지되는 길이를 직접 확인합니다.
- 긴 context에서 정확한 검색이 필요하면 full attention이나 global attention을 포함한 하이브리드 모델이 유리하고, KV cache 메모리 부담은 설계 초기에 측정합니다.
- 추론 비용은 prefill과 decode로 나눠 생각하고, reasoning effort는 작업 중요도에 따라 조절합니다.
- 출력 형식은 constrained decoding으로 보장하고, 도구는 최소한으로, 검색은 선별적으로, 새 정보는 끝에 덧붙이며, compaction에서 안전 지시를 지킵니다.
당장 할 수 있는 일은 지금 운영 중인 agent의 context 구성을 점검하는 것입니다. 도구 목록이 꼭 필요한 것만인지, 대화 기록과 검색 결과가 어디에 삽입되는지, compaction 규칙이 system prompt의 어떤 지시를 지우는지를 확인하고, 형식 변경은 반드시 평가 데이터로 비교해 보는 것이 좋습니다.


