Claude Code에 Code Mode라는 실험 기능이 들어갔습니다. Claude가 도구를 하나씩 부르는 대신 JavaScript 코드를 써서 여러 도구를 한 번에 호출하고, 코드 안에서 걸러 낸 결과만 context window(모델이 한 번에 읽는 작업 기억 공간)에 넣는 방식입니다. 같은 모델을 쓰면서도 작업 품질은 올라가고 비용은 줄어든다는 것이 핵심입니다. 한 비교 실험에서는 입력 token(모델이 글을 쪼개 처리하는 단위)이 일반 모드의 53%, 비용이 약 71% 수준으로 내려갔습니다. 다만 기본값으로는 꺼져 있는 실험 기능이어서, 무엇이 달라지는지와 어떤 조건에서 켜 볼 만한지를 함께 살펴볼 필요가 있습니다.
도구를 하나씩 부르면 생기는 낭비
지금까지 AI agent(도구를 써 가며 스스로 작업을 수행하는 AI)의 harness(모델을 감싸 도구와 실행 환경을 이어 주는 틀)는 파일 읽기, 편집, bash 실행, 웹 가져오기 같은 동작을 하나씩 돌려 가며 모델이 일을 끝낼 때까지 반복해 왔습니다. 간단한 작업에는 잘 맞지만, 여러 단계가 얽힌 작업으로 커지면 효율이 떨어집니다.
문제는 중간 결과가 지나가는 길입니다. 예를 들어 Stripe에서 결제 데이터를 가져오면 그 원본 데이터가 context window에 그대로 쌓입니다. 모델은 이를 읽고 다음 차례에 Cloudflare 같은 두 번째 도구를 부르고, 그 결과도 다시 쌓입니다. 중간 결과가 모두 대화 기록에 남기 때문에 모델은 매 차례 길어진 기록 전체를 다시 읽어야 합니다.
prompt caching(반복되는 입력을 저장해 두고 할인된 값으로 다시 쓰는 기능) 덕분에 반복되는 token은 정상 요금의 10%만 냅니다. 그래도 덩치 큰 원본 데이터가 계속 쌓이면 불필요한 비용이 나가고 추론 품질도 떨어집니다. 한 도구의 출력을 모델의 기억 공간에 기록하지 않고 곧바로 다음 도구의 입력으로 넘길 수 있다면 이 낭비가 사라집니다.
먼저 나온 해법과 그 한계
이 발상 자체는 1년 넘게 있었습니다. Cloudflare가 MCP(Model Context Protocol, AI 모델과 외부 도구를 잇는 표준 규격)를 더 잘 쓰는 방법으로 소개하면서 널리 알려졌고, Codex나 OpenCode 같은 도구에도 여러 형태로 구현돼 있습니다.
Cloudflare의 사례는 효과를 잘 보여 줍니다. Cloudflare API 전체에 해당하는 도구 약 2,600개의 정의를 모델에 그대로 읽히는 대신, 필요한 API를 찾는 search와 TypeScript 코드를 서버 쪽 sandbox(격리된 실행 공간)에서 돌리는 execute 두 개로 줄였습니다.
| 방식 | 노출하는 도구 수 | 도구 정의에 드는 token |
|---|---|---|
| 도구 정의를 모두 노출 | 약 2,600개 | 약 117만 |
| search와 execute만 노출 | 2개 | 1,069 |
token 사용량이 99.8% 줄어든 셈입니다. Datadog도 곧 비슷한 방식을 받아들였습니다.
다만 서버 쪽 방식은 그 회사의 MCP 서버 안에서만 문제를 풉니다. Stripe, PostHog, Supabase를 동시에 엮으려면 사용자 쪽에서 코드를 실행하는 층이 필요합니다. 그래서 여러 MCP 서버를 하나로 묶는 Executor 같은 게이트웨이가 쓰였습니다. MCP 서버 33개를 연결해 두고도 Claude Code에는 search와 execute 정도의 도구만 보이게 하고, 팀별로 권한 묶음을 나눠 쓰는 식입니다. 하지만 이런 실행 환경은 호출이 끝날 때마다 상태가 사라져, 앞에서 만든 변수를 뒤에서 다시 쓸 수 없습니다.
Claude Code의 Code Mode가 다른 점
Anthropic은 이 방식을 MCP에만 두지 않고 Claude Code의 harness 전체로 넓혔습니다. 파일 읽기와 쓰기, 편집, bash 실행, 웹 가져오기 같은 기본 도구와 MCP 기능이 모두 JavaScript 함수로 제공됩니다. Code Mode를 켠 뒤 쓸 수 있는 도구를 물어보면 Claude Code는 repl과 poll 두 가지만 가지고 있다고 답합니다.
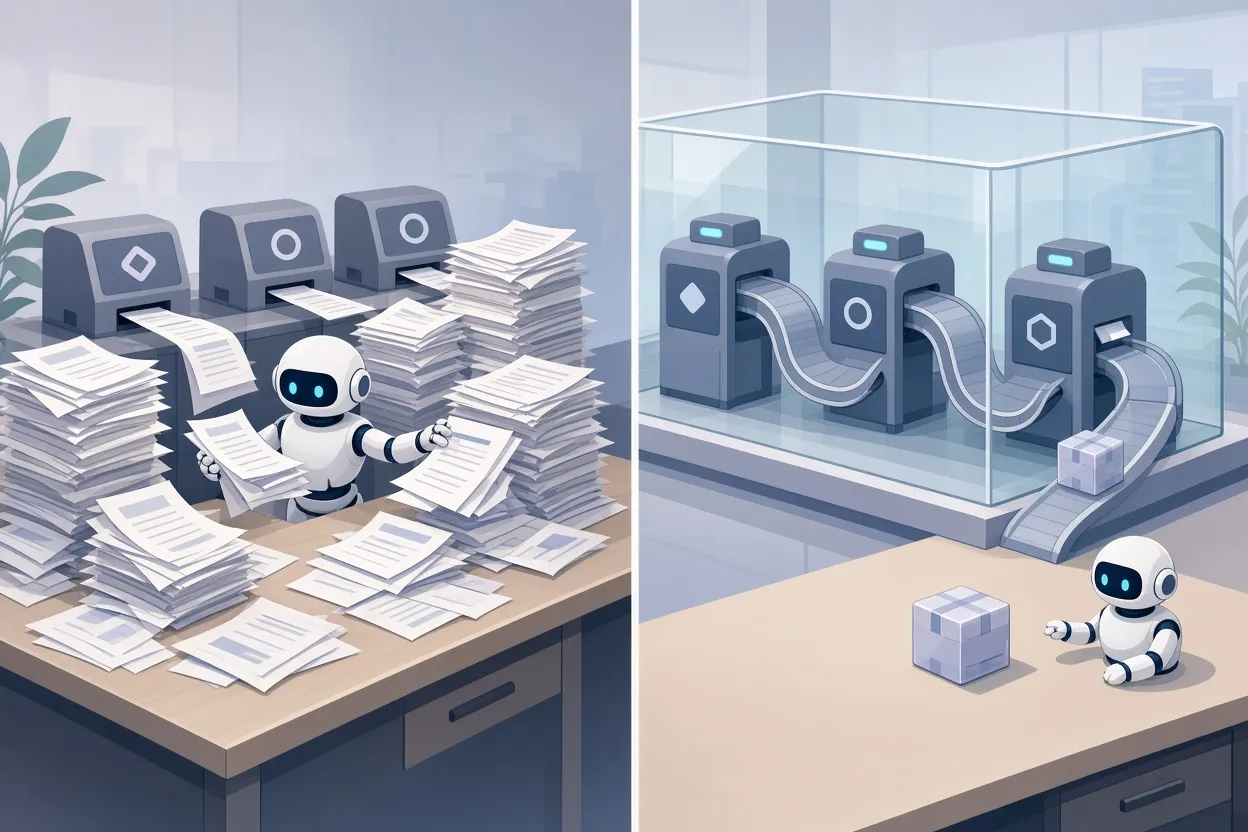
▲ 걸러진 결과만 받는 구조
세션 내내 살아 있는 REPL
REPL(Read-Evaluate-Print Loop, 코드를 넣으면 바로 실행해 결과를 돌려주는 대화형 실행 환경)은 Claude Code 세션이 이어지는 동안 계속 켜져 있는 JavaScript 실행 환경입니다. 앞선 호출에서 만든 변수가 메모리에 남아 있어, 다음 호출에서 그 데이터를 다시 내려받거나 해석하지 않고 바로 거르고 가공할 수 있습니다.
Claude가 평범한 코드를 쓰기 때문에 할 수 있는 일도 늘어납니다.
- 파일 수백 개를 반복문으로 한 번에 처리
- Promise.all로 여러 호출을 동시에 실행
- 중복 제거, 합산, 조건에 맞는 행만 추리기
- 결과를 지나치게 많이 돌려주는 MCP 서버의 출력을 변수에 담고, 일부만 미리 본 뒤 필요한 부분만 꺼내기
이 가공은 모두 결과가 context window로 돌아오기 전에 끝납니다. 일반 bash 스크립트는 harness의 도구나 subagent(주 agent가 일을 나눠 맡기는 보조 agent), MCP 서버에 직접 닿지 못하지만, Code Mode의 코드는 이들을 모두 다룰 수 있다는 점도 다릅니다.
poll은 REPL의 짝입니다. 오래 걸리는 반복 작업은 자동으로 백그라운드로 넘어가고, Claude가 주기적으로 끝났는지 확인합니다.
실제 작업 예
Stripe 데이터와 PostHog 데이터를 합쳐 생애 가치가 가장 높은 고객과 그 유입 경로를 HTML 파일로 보여 달라고 요청하면, Claude는 Stripe 결제 내역을 페이지 단위로 끝까지 가져오는 반복문을 쓰고 이를 PostHog 분석 데이터와 결합하는 비동기 JavaScript 코드를 작성합니다. 고객 원본 데이터가 대화 기록에 쏟아지지 않고 완성된 대시보드만 돌아옵니다.
수치로 본 효과
Claude Code 2.1.318 버전에서 Claude Sonnet 3.5로 실제 오픈소스 이슈를 풀게 하면서, Code Mode를 켠 경우와 끈 경우를 짝지어 8회 비교한 실험이 있습니다.
| 항목 | 일반 모드 대비 Code Mode |
|---|---|
| 입력 token | 53% |
| 출력 token | 61% |
| 총비용 | 약 71% |
Claude Code 밖에서도 같은 방향의 결과가 나오고 있습니다.
- Browser Use 1.0.0은 미리 정의해 둔 상태·동작 라이브러리의 90%를 지우고, Python REPL이 Chrome DevTools Protocol을 직접 다루게 바꿨습니다. benchmark(성능 비교 시험) 성적은 최대 50% 좋아졌고, 비용은 2~5배 싸졌으며, 속도는 2~3배 빨라졌다고 합니다.
- 한 연구자가 공개한 Unharnessed는 Opus 5.5에 단순한 Python REPL만 주고 Terminal-Bench 4.0에서 정확도 71.2%, 작업당 $12.19를 기록했습니다. 같은 benchmark에서 기본 Claude Code는 정확도 64.85%, 작업당 $14.30였습니다.
미리 짜 둔 틀을 덜어 내고 모델에게 코드를 쓸 자유를 줄수록 정확도와 비용이 함께 나아지는 흐름으로 읽힙니다. 모델이 harness가 하던 일을 점점 흡수한다는 뜻에서 '모델이 harness를 삼킨다'는 말로 표현되기도 합니다.
켜는 방법과 주의할 점
Code Mode는 실험 기능이고 기본값은 꺼짐입니다. Anthropic도 문법과 기본 동작이 이후 버전에서 바뀔 수 있다고 밝히고 있습니다.
- 터미널에서
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude로 Claude Code를 실행합니다. settings.json에 같은 값을 넣어 둘 수도 있습니다. - 사용할 수 없다는 오류가 나오면 hook(도구 호출 전후에 끼어들어 실행되는 사용자 스크립트) 기반 확장을 확인합니다. 개별 도구 호출을 가로채 검사하는 확장은 Code Mode와 충돌합니다. Code Mode에서는 도구 호출이 기존 방식의 이벤트를 내보내지 않기 때문입니다. 해당 확장을 끄고 세션을 다시 시작하면 켜집니다.
- Ctrl+O를 눌러 실행 기록을 펼치면 Claude가 REPL에서 작성해 돌린 JavaScript 코드를 직접 볼 수 있습니다.
개별 도구 호출을 검사하는 hook에 의존해 온 환경이라면, 그 확장이 Code Mode에 맞게 고쳐질 때까지는 둘 중 하나를 골라야 한다는 점을 감안해야 합니다.
다음 단계: 맥락 자체를 코드로 다루기
Code Mode는 더 큰 변화의 출발점으로 보입니다. MIT 연구자들은 'Mismanaged Geniuses Hypothesis'라는 글에서, 지금의 최상위 모델은 이미 충분히 유능하지만 경직된 harness에 발이 묶여 있다고 주장했습니다. 다음 세대 모델을 기다리기만 할 것이 아니라, 일을 유연하게 쪼개 모델을 제대로 관리하는 법을 소프트웨어가 익혀야 한다는 것입니다.
Claude Code 2.1.318에는 아직 공개되지 않은 함수 세 개, spawnContext, listContexts, releaseContext가 들어 있습니다. subagent를 코드로 만들고 묶고 끝낼 수 있는 독립된 맥락으로 다시 짜고 있다는 신호입니다. 예컨대 코드를 더 빠르게 해 달라는 요청을 받으면 대화를 5~10갈래로 나눠 서로 다른 최적화 방법을 동시에 시험하고, 성적이 좋은 3개만 본 대화로 돌려보내는 활용이 가능해집니다. 이렇게 만든 subagent는 주 agent와 양방향으로 소통할 수 있습니다. 다만 이 함수들은 미공개 상태이고 바뀔 수 있습니다.
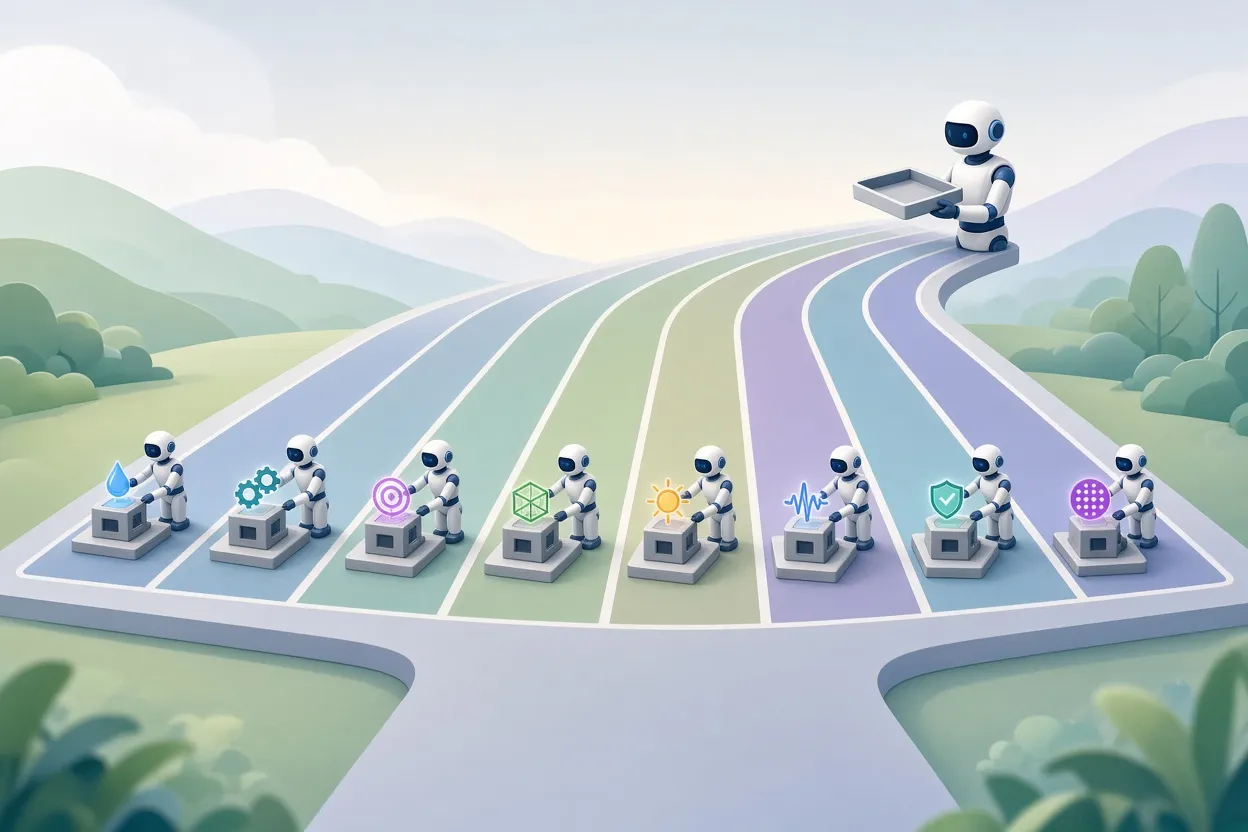
▲ 맥락을 나눠 시험하는 subagent
이 방향은 MIT CSAIL 연구진이 내놓은 Recursive Language Models(RLM) 연구와 맞닿아 있습니다. RLM에는 세 가지가 필요합니다.
- 호출 사이에 유지되는 REPL
- REPL 안에서 코드로 subagent를 내보내는 기능
- 주 prompt(모델에 주는 지시와 입력)를 바깥 변수로 다루는 것
200만 token짜리 입력을 그대로 넣으면 context window가 꽉 차지만, RLM에서는 이를 변수에 담아 두고 모델이 코드로 잘라 subagent에 나눠 맡깁니다. 같은 방식을 대화 기록에 적용하면, 장황한 도구 호출 기록을 짧은 요약으로 바꾸거나 쓸모없는 로그를 잘라 내는 일을 모델이 스스로 할 수 있습니다. 지금의 대화 압축은 중요한 뉘앙스를 놓치기 쉬워서, 코드로 골라 자르는 쪽이 더 나은 대안으로 보입니다.
걸림돌은 prompt caching입니다. 지난 기록을 고치면 캐시를 다시 쓸 수 없게 될 수 있어, 기록을 지워 아낀 token보다 캐시가 깨져 치르는 값이 더 크면 오히려 비용이 늘어납니다. Anthropic은 API에 도구 결과와 thinking 블록을 정리하는 context editing 기능을 넣었고, Meta의 Context Language Models 연구는 중간 기록을 고쳐도 캐시가 깨지지 않도록 앞부분과 뒷부분을 나눠 캐시하는 방법을 다룹니다. 2027년쯤의 Opus 6이나 Opus 7 같은 모델이 REPL로 맥락과 subagent를 다루는 방식을 직접 학습하게 되면, 최상위 모델이 온전한 RLM에 가까워질 것으로 보입니다.
정리: 지금 켜 볼 만한가
Code Mode의 요지는 도구와 데이터를 대화 기록이 아니라 코드로 다루게 한다는 것입니다. 중간 결과가 context window를 거치지 않으니 token이 줄고, 모델이 읽어야 할 잡음이 줄어 작업 품질도 나아집니다. MCP 서버를 여럿 연결해 쓰거나, 많은 데이터를 여러 도구로 엮는 작업이 잦을수록 효과가 클 것으로 보입니다. 반대로 실험 기능이라 동작이 바뀔 수 있고 일부 hook 확장과 함께 쓸 수 없다는 점은 감안해야 합니다.
직접 확인해 보려면 다음 순서를 권합니다.
- 환경 변수로 Code Mode를 켜고, 두 개 이상의 도구나 MCP 서버를 엮어야 하는 작업 하나를 맡겨 봅니다.
- 켜지지 않으면 개별 도구 호출을 가로채는 hook 확장이 있는지 확인하고 끈 뒤 다시 시작합니다.
- Ctrl+O로 Claude가 쓴 코드를 펼쳐, 중간 데이터를 변수에 담아 다시 쓰는지와 걸러진 결과만 돌려주는지 봅니다.
- 응답이 지나치게 긴 MCP 서버를 쓴다면 결과를 변수에 담고 일부만 미리 보게 한 뒤 필요한 부분만 꺼내도록 요청합니다.
- 큰 데이터를 도는 긴 작업은 백그라운드로 넘기고 poll로 확인하게 둡니다.
같은 작업을 일반 모드와 Code Mode에서 각각 돌려 token 사용량과 결과물을 비교해 보면, 자신의 작업 환경에서 켜 둘 만한지 판단할 수 있습니다.