Anthropicは、Claude Codeに「Code Mode」という実験的な機能を追加しました。コーディングエージェントによるツールの使い方を変える機能です。ツールを1つずつ呼び出して結果をすべて読むのではなく、ClaudeがJavaScriptを書いて1ステップで複数のツールを呼び出し、結果をコードの中で処理し、絞り込んだ出力だけをモデルに返します。8回実行したあるテストでは、同じモデルの入力トークン(モデルが読み取り、課金の対象になるテキストの単位)が通常の53%で済み、コストは通常の約71%でした。この機能は初期設定ではオフで、Anthropicは構文や既定の動作が変わる可能性があるとしています。
ツールを1つずつ呼び出すとコストがかさむ理由
ハーネスとは、モデルを取り巻くソフトウェアで、モデルをツールや実行環境につなぐものです。従来のハーネスはループを回します。モデルがファイルを読み、編集し、bashコマンドを実行し、Webページを取得し、作業が終わったと判断するまでこれを繰り返します。それぞれの結果はコンテキストウィンドウ、つまりモデルが毎ターン読む作業メモリに入ります。
このループは単純な作業ではうまく機能します。しかし、複雑で多段階の作業では非効率になります。とくに、エージェントが多数のツールや、それぞれ数十の関数を公開するMCPサーバーに接続している場合に顕著です。MCP(Model Context Protocol)は、モデルを外部サービスにつなぐ標準的な方法です。
Stripeからレコードを取得し、次にCloudflareからメトリクスを取得し、その両方を3つ目のツールに渡すエージェントを考えてみましょう。中間のペイロードはそれぞれコンテキストウィンドウに入り、モデルは以降のターンのたびに、膨らみ続けるやり取りの記録全体を読み直します。プロンプトキャッシュは、繰り返される入力を標準料金の10%で課金するため、コストを和らげます。それでも、大きな生のペイロードは何の役にも立たない支出を増やし、モデルの推論の質も下げます。
代替策は、あるツールの出力を次のツールの入力へ直接流すロジックをモデルに書かせることです。そうすれば、中間データはコンテキストウィンドウに入りません。モデルはターンごとの中継役をやめ、ツールをオーケストレーションするプログラマーとして動き始めます。
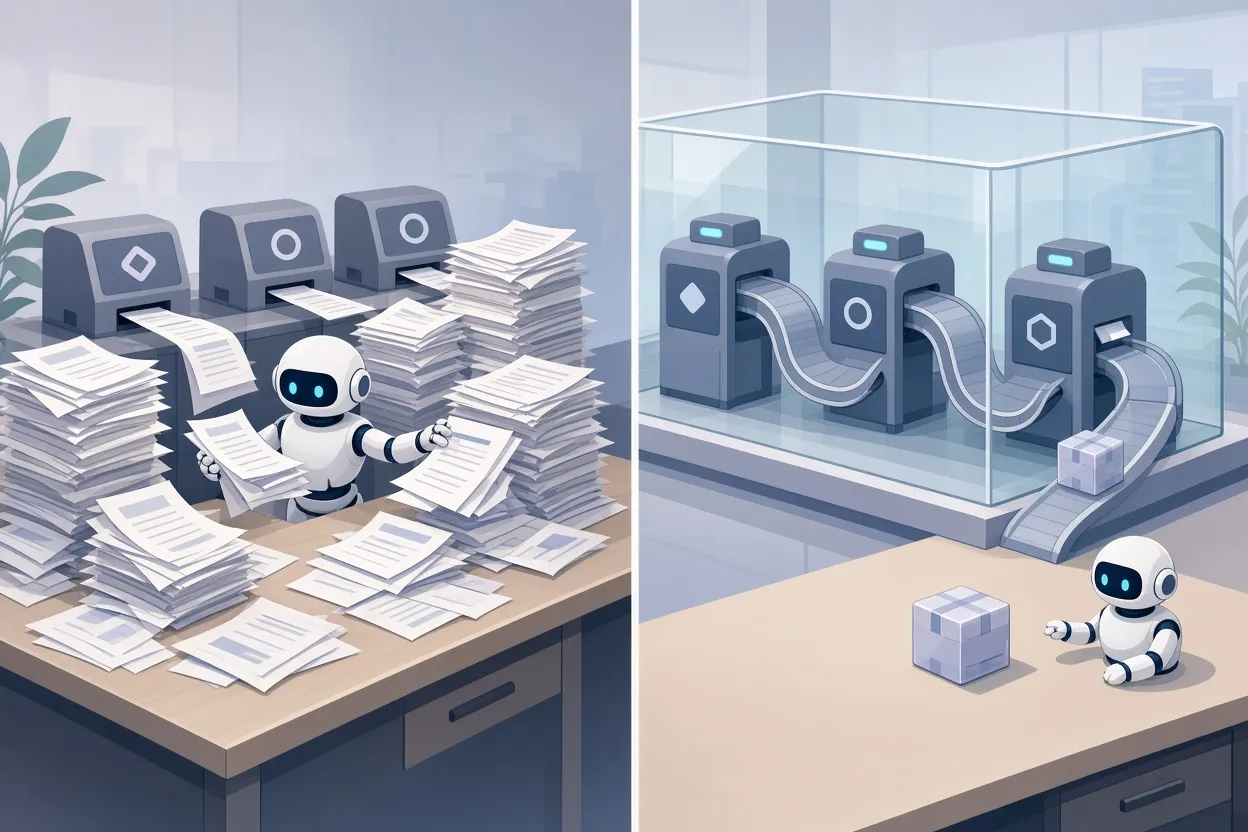
▲ 生のツール出力と絞り込んだ結果の対比
単一のMCPサーバーからハーネス全体へ
この発想は1年以上前からあります。広めたのはCloudflareで、開発者は巨大なツールスキーマをモデルに直接公開することでMCPを非効率に使ってきた、と論じた記事がきっかけでした。同社自身のAPIは約2,600のツールに及びます。Cloudflareはそれらの定義をすべて読み込む代わりに、インターフェースを2つのツールに絞りました。Claudeが必要なエンドポイントを調べるためのsearchと、Claudeが組み立てたTypeScriptを安全なサーバー側サンドボックス内で実行するexecuteです。
| 方式 | 公開するツール数 | ツール定義のトークン数 |
|---|---|---|
| 完全なスキーマ | 約2,600 | 1,170,523 |
| searchとexecute | 2 | 1,069 |
これは99.8%の削減です。Datadogも同様のパターンを採用し、多数の専用MCPエンドポイントを、サンドボックス内でクエリを実行するコード実行ツールに置き換えました。
サーバー側のコードモードには限界があります。解決できるのは、1つのプロバイダーのMCPサーバー内でのツールの肥大化だけです。Stripe、PostHog、Supabaseを1つのスクリプトで連結するには、クライアント側に実行レイヤーが必要です。Claude Codeがそれを提供する前、開発者はExecutor.shのようなMCPゲートウェイを使っていました。Executor.shは、統一されたsearchとexecuteのツールを備えた1つのMCPサーバーとして振る舞い、接続されたすべてのAPIに対するスクリプトを1つのランタイムで実行します。たとえば、あるセルフホストのExecutor.shインスタンスは33のMCP連携を管理し、サポート、エンジニアリング、財務の各チーム向けの権限パッケージにまとめています。
Code Modeはこのパターンを、MCPを越えてClaude Code自身のツール、つまりファイルの読み取り、ファイルの書き込み、編集、bashにまで広げます。このアプローチの派生形は、Codex、OpenCode、Pi、Prime Agentにも見られます。これは「モデルがハーネスを飲み込む」と要約されることもある、より大きな流れに当てはまります。外部のハーネスコードが担っていた作業を、モデルが引き受けるという流れです。
Claude Code内でのCode Modeの仕組み
Code Modeをオンにすると、Claude Codeはreplとpollという2つのツールを通じて動作します。
状態を保持するJavaScriptセッション
REPLは「read-evaluate-print loop」の略です。ここでは、Claude Codeのセッション全体を通じて動き続けるJavaScriptコンソールを指します。bashコマンド、ファイルの読み取り、編集、Web取得、MCPの関数はすべて、その中で呼び出し可能なJavaScript関数として現れます。
プロセスが動き続けるため、ある呼び出しで定義した変数は、次の呼び出しでもメモリに残っています。Claudeはデータセットを一度保存しておけば、ダウンロードやパースをやり直すことなく、あとから絞り込みや変換ができます。Cloudflare WorkersやExecutor.shのようなサーバー側の環境は呼び出しのたびに状態を破棄するため、このように変数を再利用することはできません。
モデルが読む前に絞り込む
1つのスクリプトの中で、Claudeは数百のファイルをループ処理し、Promise.allで呼び出しを並列実行し、reduceで行を集計し、Setで重複を除き、行を絞り込めます。これらはすべて、結果がコンテキストウィンドウに戻る前に行われるため、コンテキストの容量を節約でき、モデルとの余分な往復もなくなります。
これは、あまりに多くのデータを返してしまう設計のよくないMCPサーバーにも有効です。Claudeはかさばる出力を変数に代入し、数件をプレビューしたうえで、残りに対して的を絞ったコードを実行できます。
bashスクリプトでは同じことはできません。bashは、ハーネスレベルのツール、サブエージェント(メインのエージェントがサブタスクのために起動する補助エージェント)、MCPサーバーに直接アクセスできないからです。Code Modeは、この3つすべてをコードから制御できるようにします。
長い処理はバックグラウンドで
pollツールは、長いループを回すスクリプトを扱います。そうしたスクリプトは切り離されてバックグラウンドで動き続け、Claudeは完了したかどうかを定期的に確認します。
例
StripeのデータとPostHogのデータを組み合わせ、生涯価値が最も高い顧客とその流入元を示すHTMLファイルを作ってほしい、という依頼があったとします。Code Modeでは、Claudeは非同期スクリプトを1つ書きます。その中のループでStripeの課金データをページ送りで取得し、PostHogのアナリティクスと結合し、HTMLダッシュボードを書き出します。生の顧客オブジェクトや課金オブジェクトが会話に入ることはありません。
計測結果が示すもの
Claude Codeのリリースを追跡するある自動エージェントが、Claude SonnetモデルにCode Modeありとなしの両方で実際のオープンソースのissueに取り組ませたテストを記録しています。使われたのは、この機能が登場したリリースであるClaude Code 2.1.318です。8組の対になった実行の結果は次のとおりです。
| 指標 | 通常モードに対するCode Modeの割合 |
|---|---|
| 入力トークン | 53% |
| 出力トークン | 61% |
| 総コスト | 約71% |
外部の2つのプロジェクトも、同じ方向を示しています。
- Browser Use 1.0.0は、あらかじめ定義していた状態とアクションのライブラリの90%を削除し、生のChrome DevTools Protocolを操作するPython REPLに置き換えました。このプロジェクトは、硬直的なスキーマベースのエージェントと比べて、ベンチマーク性能が最大50%向上し、コストが2~5分の1になり、実行が2~3倍速くなったと報告しています。
- Unharnessedというプロジェクトは、Terminal-Bench 4.0でOpus 5.5にシンプルなPython REPLを与え、1タスクあたり$12.19で正答率71.2%に達しました。Claude Codeは1タスクあたり$14.30で64.85%でした。
MITの研究者3人は、「The Mismanaged Geniuses Hypothesis」と題したエッセイで、これらの結果を捉える枠組みを示しています。現在のフロンティアモデルはすでに十分な能力を持ちながら硬直的なハーネスに足を引っ張られており、ソフトウェアは次の世代を待つだけでなく、柔軟なタスク分解を通じてそうしたモデルを管理することを学ぶ必要がある、というのが彼らの主張です。Code Modeはこの原則を適用したものに見えます。コンテキストを早々に埋めてしまうことなく、モデルがデータを動かしワークフローを実行する余地を与えるからです。
今後向かうかもしれない方向
Claude Code 2.1.318には、隠された未公開の関数も3つ含まれています。spawnContext、listContexts、releaseContextです。これらは、サブエージェントが、コードから起動、結合、終了できる隔離されたコンテキストとして再構成されつつあることをうかがわせます。未公開のため、変更される可能性があります。
使い道の1つがフォークです。コードの高速化を頼まれたClaude Codeは、会話を5~10回フォークし、それぞれのフォークで異なる最適化戦略を並列に試し、上位3つの結果だけをメインの会話に返す、といったことができるかもしれません。この方法で起動されたサブエージェントは、調整役のエージェントとの双方向のチャネルを保ちます。子プロセスから親に話しかけられない硬直的なワークフローとは、この点が異なります。
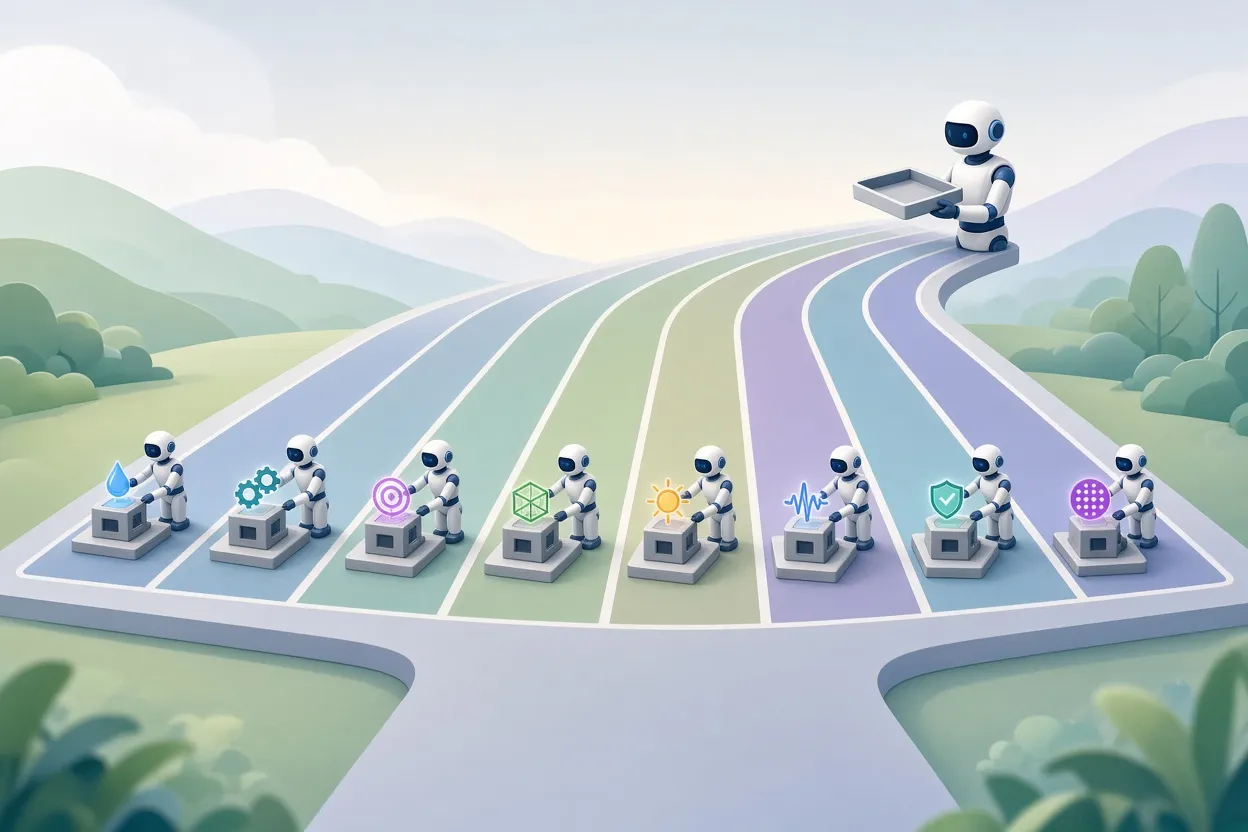
▲ 上位の結果だけを残す並列コンテキストフォーク
これは、MIT CSAILによるRecursive Language Models(RLM)の研究と符合します。RLMには3つの要素が必要です。呼び出しをまたいで持続するREPL、そのREPLの中からサブエージェントを送り出す能力、そして生のコンテキストとしてではなく外部変数として扱われるプロンプトです。
3つ目の要素は、大きな入力の扱い方を変えます。200万トークンの入力を貼り付けると、通常はコンテキストウィンドウが飽和します。RLMはその入力を変数に格納し、モデルはそれを切り分けて一部をサブエージェントに渡すコードを書きます。たとえば、コードベースを20のサブエージェントに分割するといった具合です。
同じ発想は会話履歴にも当てはめられます。モデルは冗長なツールのやり取りの記録を短い要約に置き換えたり、無関係なログを削ったりできるかもしれません。現在のコンパクション手法は不完全で、重要なニュアンスを失うことがあるため、コードで履歴を切り分けるほうがよい選択肢かもしれません。ただし、コスト面の落とし穴があります。以前のメッセージを編集すると、プロンプトキャッシュが無効になることがあるのです。Context Language Modelsに関するMetaの研究論文は、その破綻を避けるためにプレフィックスとサフィックスのキャッシュを検討しています。AnthropicのAPIは、ツールの結果や思考ブロックを刈り込むコンテキスト編集を提供していますが、節約できるトークンがキャッシュを壊すことによるペナルティより小さければ、総コストは上がりかねません。
確定した計画ではなく予測ですが、Opus 6やOpus 7といった2027年に登場しうるモデルは、REPL主導のコンテキスト管理とサブエージェント管理を、ポストトレーニングで直接学習するかもしれません。RLMが真価を発揮するのは、おそらくそうした学習があって初めてでしょう。
有効にする方法
- 環境変数を設定して、
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claudeでClaude Codeを起動します。この変数はsettings.jsonに書くこともできます。 - インストール済みのmodが原因でCode Modeを利用できないとClaude Codeが報告した場合は、トランスクリプトを伏せ字にするものなど、個々のツール呼び出しをチェックするフックやmodを無効にして、セッションを再起動します。こうしたフックが競合するのは、個々のツール呼び出しが通常のハーネスイベントを発行しなくなるためです。
- Claudeに、どのツールを持っているか尋ねます。replとpollが挙がるはずです。
- Ctrl+Oを押してログを展開し、Claudeが書いて実行したJavaScriptを読みます。
要点と次のステップ
Code Modeは、ツールのオーケストレーションを会話の外に出し、コードの中に移します。コンテキストウィンドウに入るのは絞り込まれた結果で、Claude Codeでのあるテストでは、同じモデルが入力トークンを約半分、コストをおよそ71%に抑えました。この数字は8組の対になった実行から得られたものなので、保証ではなく初期の兆候として受け止めてください。
いま有効にすべきかどうかは、作業の内容によります。最も役立ちそうなのは、複数のツールやMCPサーバーを連結し、大きなペイロードが返ってくる作業です。こうした作業では、Code Modeを使わなければ中間データがコンテキストに積み上がってしまいます。一方、各ツール呼び出しを検査するフックに依存する構成には、現時点ではあまり向きません。フックが更新されるまで無効にしておく必要があるからです。
試す場合は、次の点を意識してください。
- 中間のデータセットは、取得し直すのではなく、Claudeに変数で保持させます。
- 多段階のデータ処理は、多数の個別の呼び出しではなく、1つのスクリプトにまとめさせます。
- 出力の多いMCPサーバーでは、出力を変数に取り込み、まず小さな一部をプレビューさせます。
- 大きなデータセットに対するループにはバックグラウンドのポーリングを使い、長時間の実行がタイムアウトしないようにします。
- 生成されたコードをCtrl+Oで確認し、実験的である間は機能の動作が変わるものと考えておきます。