AIエージェントを開発する人がモデルを自ら学習させたりGPUカーネルを書いたりすることはめったにありません。それでも、ツール、メモリ、プロンプトについて下す判断は、モデルの内部で起きていること、つまり次のトークンをどう選ぶか、アテンションによって前のテキストをどう参照するか、その参照にどれだけのメモリがかかるかによって制約されます。こうした仕組みを背景知識の雑学ではなくエージェント開発の前提として扱えば、具体的な設計ルールが見えてきます。サンプリングはタスクに合わせて調整する、コンテキストが長くなるほど精度は下がると想定する、ツールの数は少なく保つ、新しい情報はプロンプトの末尾に追加する、そして自動的なコンテキスト圧縮で安全性に関する指示を消させない、というルールです。
スタックの中でエージェント開発者はどこにいるのか
大規模言語モデルを扱う仕事は、3層のスタックとして整理できます。最下層はLLMエンジニアリングで、分散コンピューティング、Transformerアーキテクチャ、カスタムGPUカーネル、スケーリング則、事前学習、事後学習、強化学習、トークナイザーが含まれます。中間層はLLMの適応で、教師ありファインチューニング、蒸留、インコンテキスト学習、LoRA(小さな低ランクの重み更新を学習することで安価にモデルをファインチューニングする手法)、RLHFやDPOによる選好アラインメントが該当します。最上層はLLMアプリケーションで、チャットボット、検索拡張生成、エージェントです。
エージェント開発者はこの最上層にいます。それでも下の層を学ぶべきだという主張の根拠は実務的なものです。KVキャッシュやアテンションの派生方式を理解している開発者は、コンテキストの上限や計算のオーバーヘッドを本番環境で初めて思い知るのではなく、事前に見越すことができます。なお、このスタック自体は非公式な整理の枠組みであり、業界標準ではありません。
モデルは次の単語をどう選ぶのか
言語モデルは、トークン(単語や単語の一部)の列に対して、条件付き確率の積、つまり直前までのすべてを踏まえた各トークンの出現確率を掛け合わせることで確率を割り当てます。「The class was about agents .」という文では、最初のトークン「The」の周辺確率が0.0377、「The」に続く「class」が0.0001、最初の2語に続く「was」が0.0344、最後のピリオドが0.0252です。文全体の積は1.2e-17になります。小さな数を何度も掛けると浮動小数点演算でアンダーフローが起きるため、実務では代わりに対数確率を足し合わせます。
この定義こそが、言語モデルが識別モデルではなく生成モデルに分類される理由です。ロジスティック回帰やSVMのような識別モデルは、猫の写真と犬の写真を分けるような決定境界を学習します。生成モデルはデータの分布そのものを学習するので、そこからサンプリングできます。次のトークンを選ぶ処理は語彙に対する分類のように見えるため境界があいまいに感じられますが、モデルは任意のテキスト列に対する完全な同時分布を定義しており、それが生成を可能にしています。
生成は1トークンずつ進みます。「The class was about」が与えられると、モデルは語彙全体に確率を分配します。現代のモデルの語彙は通常約128,000のサブワードトークンを持ち、たとえば「to」が0.3171、「as」が0.0491、「the」が0.0360、「a」が0.0330、「two」が0.0147、「how」が0.0124といった具合です。「to」をサンプリングするとコンテキストが伸び、次の分布では「be」が0.1501、「begin」が0.0855、「go」が0.0627、「start」が0.0496になります。
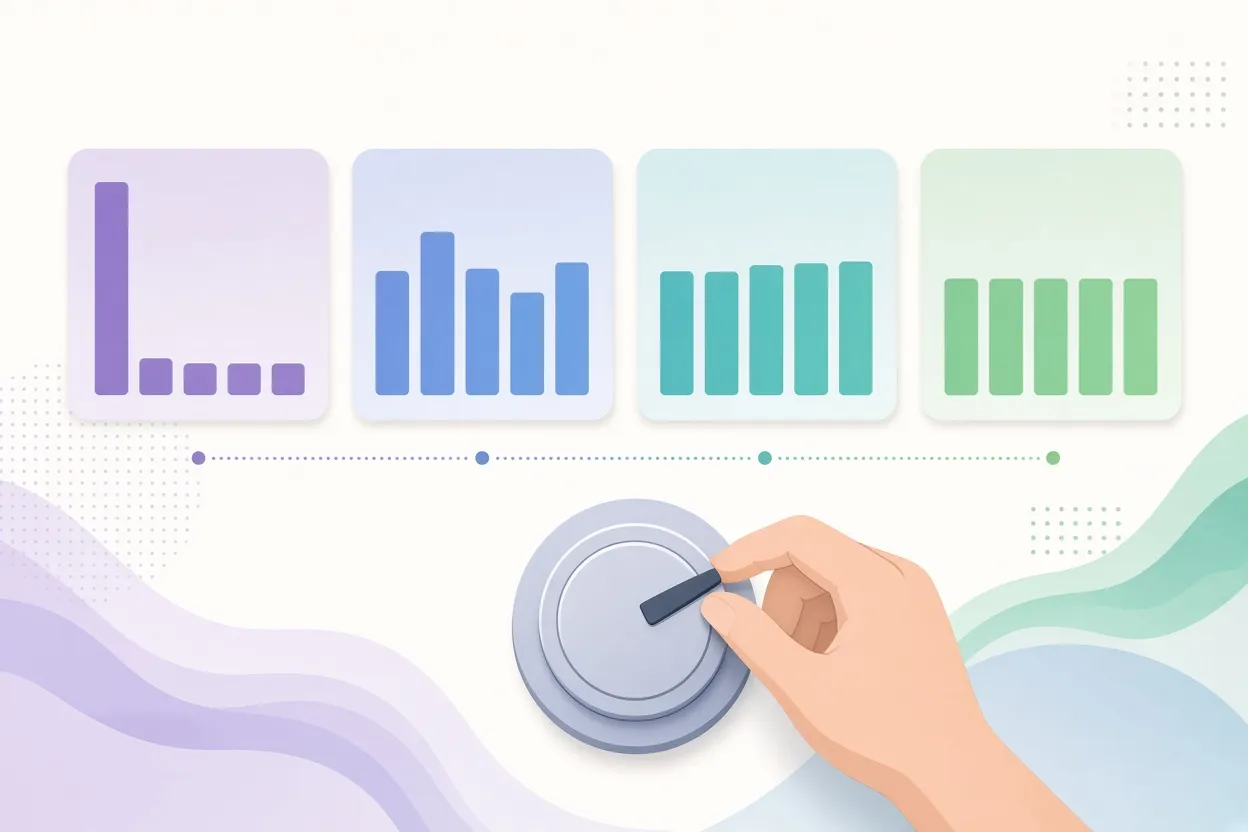
▲ 温度がトークン確率に与える影響
その分布からどう引くかは開発者が決めます。温度(temperature)は、softmaxが合計1になるよう再正規化する前の生のロジットに適用する除数です。自然な上限はなく、温度5は単なるスケーリング係数にすぎません。低い値はピークを鋭くして貪欲法(greedy decoding)に近い振る舞いへ寄せ、高い値は分布を平らにして出にくいトークンを持ち上げます。「I am tired, I will take a ___」というプロンプトでは、「nap」「break」「rest」「bath」「shower」といった候補が、T=0.1では1本の突出した棒だったものが、T=2.0ではほぼ均等な棒に変わります。
| 手法 | 動作 | トレードオフ |
|---|---|---|
| 貪欲法(greedy decoding) | 常に最も確率の高いトークンを選ぶ | 高速で決定的だが、繰り返しや局所的に最適なだけのテキストになりうる |
| Top-k | 確率上位k個のトークンからサンプリング(例:k=5) | モデルの確信度にかかわらず候補数が固定 |
| Top-p(nucleus) | 累積確率がpに達する最小の集合からサンプリング(例:30パーセント) | 候補数が分布に応じて変わる |
| 温度 | softmaxの前にロジットをTで割る | 低いTは予測可能性、高いTは多様性 |
| ビームサーチ | 複数の候補列を同時に追跡 | 列全体の尤度は高まるが、時間とメモリを大幅に消費 |
経験則はタスクで決まります。数学やコードは低い温度を求め、創作的な文章は高いエントロピーを求めるため、通常はtop-pやtop-kと組み合わせます。ビームサーチは貪欲法より確率の高い列を見つけられますが、複数の仮説をメモリに保持するため、対話的なエージェントではコストが見合わないことが多くなります。ビームサーチの候補は、累積確率、タスク固有の価値関数、外部の検証器のいずれかでランク付けできます。
エージェントのループにとって重要な細部が2つあります。温度は推論時のハイパーパラメータであって学習された重みではありませんが、強化学習のロールアウトは固定した温度でサンプリングします。また、トークンごとに温度を変えてもKVキャッシュは無効にならないため、本番システムでそうすることはまれとはいえ技術的には可能です。推論モデルは多段階の思考を加えますが、温度は推論の質を左右する現役の調整項目であり続けます。
アテンションの内側:コンテキストにコストがかかる理由
現代のLLMはほぼすべてデコーダのみのTransformerで、Googleのヴァスワニらが2017年に発表した論文「Attention Is All You Need」に由来します。この論文は翻訳向けにエンコーダ・デコーダ構成を導入しました。現代の生成モデルはエンコーダを省いてデコーダを残していますが、どちらも同じアテンションブロックを共有しています。
「The」「class」「was」「about」というトークンでこのブロックをたどると、コンテキストの上限がどこから来るのかが見えてきます。
- 各トークンを学習済みの埋め込みテーブルで引き、ベクトルを得ます。
- 位置埋め込みを加えます。アテンション単体は順序に依存しない(permutation-invariant)ため、位置情報がなければ、参照できるトークンのどれが先に来たのかをモデルは判別できません。
- 積み重ねたベクトルをレイヤー正規化に通します。
- 学習済みの3つの行列W_Q、W_K、W_Vで、それぞれバイアス項付きのクエリ、キー、バリューに射影します。
- QにKの転置を掛けると、n×nのスコア行列が得られます。nは系列長です。
- 因果マスクによって、各トークンが後続のトークンを参照できないようにします。学習時は系列全体を並列に処理するため、マスクがなければ「The」の次の予測に「class」や「was」の情報が漏れてしまいます。
- スコアをキー次元の平方根で割り、各行の合計が1になるようsoftmaxをかけ、Vと掛け合わせます。
- 出力射影W_Oで結果をモデル次元に戻し、残差接続で元の入力を足して勾配が流れ続けるようにします。
マルチヘッドアテンションは、Q、K、Vの射影を複数組並列に走らせ、出力を連結してより幅の広いW_Oで射影することで、モデルが異なる表現部分空間を同時に参照できるようにします。完全なブロックにはフィードフォワード層ともう1つの残差接続が加わり、そのブロックをN回積み重ね、最後に言語モデリングヘッドとsoftmaxが次トークンの分布を出します。重みは乱数で初期化されるため、勾配降下法で学習が進むまで、初期の順伝播はノイズしか生みません。
元論文の計算量の表は、Transformerの成功とコンテキストの問題の両方を説明しています。自己アテンションは層あたりO(n^2 * d)のコストがかかり(dは表現の次元)、逐次処理はO(1)で済むため、系列全体をGPU上で並列に処理できます。リカレントネットワークはO(n * d^2)ですが、O(n)の逐次ステップが必要です。並列性こそがTransformerに巨大なコーパスでの学習を可能にし、2乗の項こそが長いコンテキストを高コストにしています。規模感でいえば、元の「Transformer (big)」モデルはおよそ2億パラメータで、学習に2.3 x 10^19 FLOPsを要しました。2017年には大規模でしたが、今日の1兆パラメータ級モデルの前では微々たるものです。
線形アテンションとハイブリッドモデル
DeltaNetの定式化に見られる線形アテンションは、クエリとキーの間のsoftmaxを取り除きます。すべてが線形になると、行列の結合法則によってKの転置とVの積を先に計算でき、系列長に依存しないd×dの状態行列が得られます。この状態は、関係のない記憶を消して新しいキーとバリューの外積を加えることでステップごとに更新され、2^9から2^16トークンまで実行時間とGPUメモリは線形にしか増えません。
その代償は検索性能に現れます。RULERベンチマークのneedle-in-a-haystackタスクでは、エッセイのテキストにマジックナンバーを隠して末尾で問い合わせますが、Llama-2-7Bが8kトークンまで高い精度を保つのに対し、RWKV-v5-7BとMamba-2.8Bは2kから4kトークンを超えると急激に劣化します。固定サイズの状態は履歴全体を圧縮しなければならないため、個別の事実が失われるのです。
| 特性 | 完全なsoftmaxアテンション | 線形アテンション |
|---|---|---|
| 系列長に対する計算量 | O(n^2) | O(n) |
| コンテキストの仕組み | すべてのトークンがそれ以前のすべてのトークンを参照できる | 履歴を固定サイズのd×d状態に圧縮 |
| 推論時のメモリ | KVキャッシュが線形に増加、O(n) | 状態サイズは一定 |
| 長距離の検索 | 強い | 弱い |
実際には設計者は両者を混ぜます。DeltaNetはスライディングウィンドウ層と線形層を交互に配置し、定期的にグローバルアテンション層を挟みます。グローバルアテンションを加えたことで平均検索精度は22.7パーセントから32.7パーセントに上がり、Wikipediaのパープレキシティは28.24から27.51に改善し、常識推論のスコアは損なわれませんでした。オープンなフロンティアモデルであるKimi K3は、Multi-Head Latent AttentionとKDA線形層、安定化したレイヤー正規化、フィードフォワードブロックを組み合わせ、生成中のメモリをゲーティングで制御しています。
もう1点あります。どちらのアテンションの定式化も、その数式の中で最大コンテキスト長を課してはいません。厳格な上限は学習済みの位置埋め込みから生じます。モデルは学習中に見た位置しか解釈できないため、コンテキストを延ばすにはこの埋め込みを調整するか補間する必要があります。
プリフィル、デコード、KVキャッシュ
推論は2つの動作モードで進みます。プリフィルでは、プロンプトのすべてのトークンが一度にモデルを通り、演算強度の高い密な行列積が走ります。Rooflineパフォーマンスモデルでいえば、このフェーズは計算律速です。デコードでは、モデルは1ステップに1トークンを出力します。中間の活性化は捨てられますが、キーとバリューはKVキャッシュとして保持され、トークンごとに増えていきます。各ステップで1トークン分の更新のためにモデルの重みとキャッシュを読み込み直すので、デコードはメモリ帯域律速です。Time to First Tokenはプリフィルを、Time Per Output Tokenはデコードを測る指標です。
ツールのスキーマ、環境の観測、対話の履歴という長いコンテキストをループするエージェントにとって、この区別には実際の影響があります。KVキャッシュのメモリは早い段階でプロファイルすべきで、ハイブリッドや線形アテンションのモデルがワークロードに合うかどうかも知っておく価値があります。投機的デコーディングは帯域のボトルネックを緩和します。小さなドラフトモデルが複数のトークンを提案し、ターゲットモデルが1回の並列パスでそれらを検証し、最初に却下された位置から生成を再開するという仕組みです。コードの構文は予測しやすいため、受理率は要約(XSum)よりコード(HumanEval)のほうが高く、ドラフトを長くしすぎるといずれ受理率が下がって利得が消えます。
推論モデルは推論時に追加のトークンを使って自らの誤りを捉えます。Agent's Last Examベンチマークでは、GPT-5 AstraとClaude Opusのいずれでもトークン予算に応じて精度が上がります。努力量(effort)はlow、medium、high、maxに設定でき、高い努力量は精度を改善しますが、レイテンシと費用の代償は大きくなります。Kimi K3はこの制御を、正解に+1、予算内の不正解に0、予算超過の不正解に-1という報酬で学習させ、その後3つのドメインと3段階の努力量にわたる9つの教師モデルを1つの生徒モデルに蒸留しています。
構造化出力とコンテキストエンジニアリング
エージェントは、API、データベース、コードインタープリタを呼び出す複合システムの中にあるため、出力には厳密な契約が必要です。制約付きデコーディングは、生成を正規表現やJSONスキーマに従わせます。SGLangはスキーマを有限状態機械にコンパイルし、引用符や波括弧のような固定の構文をモデルの順伝播なしに挿入して、複数のトークンが有効な遷移でのみモデルを呼び出します。これによりLlama-7Bで、vLLM、Guidance、LMQLに対して大幅なスループット向上を得ています。DSPyのシグネチャは同じ契約をコードで宣言的に表現し、name、email、intentといった型付きの入出力フィールドを定義して、スキーマを強制するプロンプトにコンパイルします。範囲の狭い判断であれば、埋め込みの上に載せた小さな分類ヘッドや、状態の埋め込みに対して候補アクションをスコアリングする対照モデルを使えば、自由形式の生成を完全に避けられます。
▲ エージェント向けコンテキストエンジニアリングの実践
初期の実践は単一ターンのプロンプトエンジニアリングに集中していました。エージェントに必要なのはむしろコンテキストエンジニアリングで、システムプロンプト、マルチターンの履歴、長期記憶、ツールの出力、添付ファイルをまとめて取捨選択することです。すべてをウィンドウに放り込むやり方は二重に失敗します。アテンションのコストが2乗で増え、精度が崩壊するのです。多数の文書にまたがる推論と集約を試すOOLONGベンチマークでは、Gemini 2.5 Pro、Claude Sonnet 4、GPT-5を含む主要モデルのスコアが、8kトークンで90パーセント近くだったものが512kトークンではおよそ10から40パーセントに落ちます。この「コンテキストの劣化(context rot)」は、公称のウィンドウ上限よりはるかに手前で現れます。
実践的な指針は、上で見た仕組みからそのまま導けます。
- ツールの乱立を避ける。 Terminal-Bench 2では、read、write、edit、bashだけを持つPiという最小限のハーネスが、Claudeの各モデルにおいてCodexやClaude Codeのような大きなフレームワークと同等かそれ以上の成績を出しました。
- 放り込まず、検索する。 埋め込みモデル、ベクトル検索、リランカーを使って、関連するチャンクだけを取り出します。
- 末尾に追加する。 新しい情報を先頭に挿入すると後続のすべてのトークンの位置がずれ、計算済みのKVキャッシュが無効になってレイテンシが増えます。順に末尾へ追加すればキャッシュは有効なままです。
- 形式をベンチマークする。 Markdown、YAML、生テキストのどれが特定のモデルとタスクに向くかは、実験で確かめるべき問題です。
- 圧縮を守る。 コンテキストがいっぱいになると、システムは履歴を切り詰めるか要約します。Metaの安全性・アラインメント担当の責任者が報告した事例では、非常に大きな受信トレイを圧縮したあとのエージェントが、メールを削除する前にユーザーに確認するという指示を失い、受信トレイを消去してしまいました。安全性に関わる指示は、自動的な刈り込みから保護する必要があります。
再帰的言語モデル(RLM)は別の道を示します。プロンプトをPythonなどの実行サンドボックス内の変数として保存し、モデルはすべてを一度に読む代わりに、スライスを調べ、正規表現を適用し、サブクエリを再帰的に生成します。263kトークンのOOLONGタスクでは、GPT-5-miniを基盤とするRLMが51.1パーセントを記録し、GPT-5の34.2パーセント、素のGPT-5-miniの23.2パーセントを上回りました。サブコールなしでも40.9パーセントに達しています。
押さえておきたいこと
仕組みと設計ルールは一致しています。サンプリングの設定はエージェントが予測可能か探索的かを決めるため、コードと数学には低い温度を設定し、自由度の高い作業でだけ上げます。アテンションは長いコンテキストを高コストにし、ある点を超えると信頼できなくするため、コンテキストウィンドウはごみ箱ではなく予算として扱います。KVキャッシュは末尾追加のみのコンテキストに報い、先頭挿入を罰します。線形およびハイブリッドのアテンションは検索精度と引き換えに効率を得ており、長時間動くエージェントの基盤モデルを選ぶときに効いてきます。いまエージェントを開発している人は、ツール一覧の棚卸し、大量データの検索経由への移行、キャッシュが生き残るようなコンテキストの並べ替え、そして安全性に関する指示が圧縮後も残ることを確認する明示的なテストの作成から始められます。


