NVIDIAはGTC Berlin 2026で、AIエージェントの性能向上の最大の源泉は、いまやモデルそのものではなく、モデルを包み込むソフトウェアにあると主張しました。同社が新たに発表したAgent Toolkitは、ハーネス、サンドボックス実行環境、ナレッジ層、テレメトリーツールを一つにまとめたものです。NVIDIAはこの主張を印象的な数字で裏付けています。2026年8月21日付のNVIDIA開発者ブログによると、Claude Opus 5は重みを一切変更しないまま、NVIDIA AVOハーネス上で動かしただけでARC-AGI-3の公開セットのスコアが30%から100%に上昇したといいます。NVIDIAでソフトウェア製品管理担当バイスプレジデントを務めるアデル・エル・ハラック氏は、同社がこの層を構築する理由、Agent Knowledge Foundationが多くの企業がすでに運用している検索拡張生成(RAG)とどう違うのか、そしてKumo予測モデルがどこに位置づけられるのかを説明しました。
エージェントを構成する5つの要素、モデルはその一つにすぎない
この枠組みは、NVIDIAのCEOであるジェンスン・フアン氏の基調講演に由来し、エージェントを5つの要素に分けています。
| 要素 | 役割 | NVIDIAの対応する部品 |
|---|---|---|
| モデル | 頭脳。1つの大規模言語モデル、または複数モデルからなるシステム | Nemotron 3 Ultra、またはClaude Opus 5などのサードパーティーモデル |
| ハーネス | モデルがテキストを出力するだけでなく行動できるようにする身体、いわば外骨格 | AVOハーネス、パートナー各社のハーネス |
| サンドボックス | エージェントに許される行動の封じ込めと制御 | OpenShell |
| ナレッジ | 企業データをエージェントが使える形に変換したもの | Agent Knowledge Foundation |
| ツール | 実行能力。自然言語から呼び出すCUDA-Xライブラリなどを含む | CUDA-Xライブラリ、MCP連携 |
この分割の要点は、モデル単体ではトークンを生成するだけだという点にあります。そのトークンを完了したタスクへと変えるものはすべて残りの4つの箱の中にあり、NVIDIAはそこにエンジニアリングの力を注いでいると説明しています。
LangChainの競合ではなく「道具箱」
当然の疑問として、Agent ToolkitはLangChain、CrewAI、Agnoといったフレームワークと競合するのかという点があります。NVIDIAの答えは「ノー」です。このツールキットは、パートナーがすでに構築しているフレームワークに対して、モデル、ライブラリ、連携機能、ハードウェアアクセラレーションを届ける傘のような存在と位置づけられています。NVIDIAはハリソン・チェイス氏率いるLangChainチームと直接協力しており、Deep AgentsなどのLangChain製ハーネスを自社のリファレンス実装に取り込んでいます。また、Nous ResearchとはHermesエージェントで連携し、OpenClawの開発チームとも協力しています。
ツールキットは完成したアプリケーションではなく、モジュール化された部品と、ブループリントと呼ばれるオープンなリファレンスエージェントの形で提供されます。ブループリントには、選定したモデルまたはモデル群、実行ハーネス、タスク固有のツールとスキル、Model Context Protocol(MCP)連携、そしてOpenShell内での実行時の封じ込めがひとまとめになっています。Blenderで3Dデザイン作業を進めるエージェントから、LangChainで構築した企業向けワークフローまで幅広く、開発チームはゼロから作るのではなく、これらを複製・改変して自社ソフトウェアに組み込むことが想定されています。例としては、NVIDIA NeMoClaw for Agent OptimizationやNeMoClaw for LangChain Deep Agents Codeがあります。
Agent Knowledge Foundation:RAGに何を加えるのか
RAGは、2022年11月のChatGPT登場とほぼ同時に現れました。ハルシネーションによって、根拠づけ(グラウンディング)が必須になったためです。第1波は非構造化文書に対するベクトル埋め込みに依存しており、NVIDIAは今もこの領域に多くの投資を続けています。埋め込みモデルとリランキングモデルの質が上がれば、エージェントが正しいコンテキストにたどり着くまでの検索回数が減る、というのがその論理です。同社のNeMo Retrieverのパース、埋め込み、リランキングの各コンポーネントは、まさにこの目的でMilvusのベクトルストアにデータを供給します。
Agent Knowledge Foundationはさらに一歩進み、構造化データを一級の入力として扱います。エンティティとそれらを結ぶ動詞を表すナレッジグラフ、オントロジー、スキーマを加えることで、エージェントがテキストの類似度だけでなくビジネスロジックをたどれるようにします。
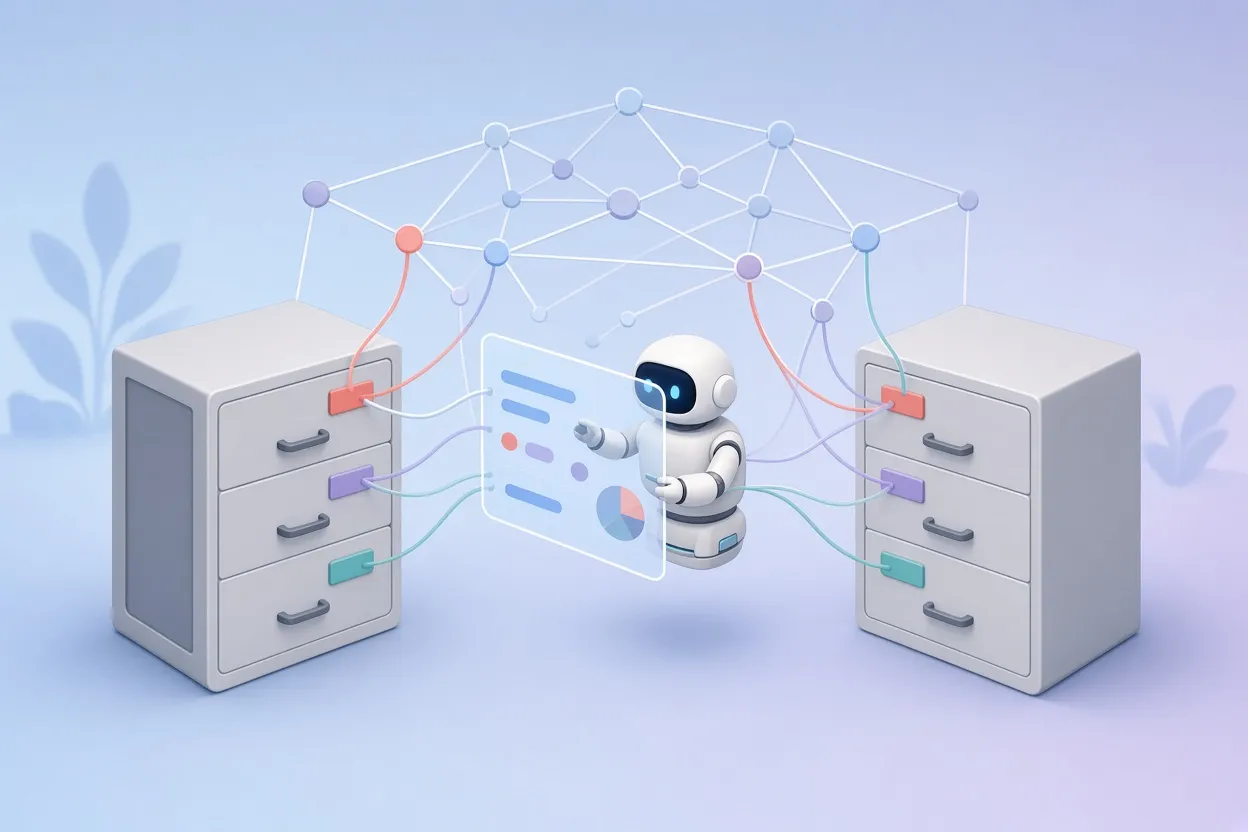
▲ 別々のデータスキーマを調和させるナレッジグラフ
出発点となる課題は、数千に及ぶリレーショナルテーブルにまたがるスキーマの乱立です。携帯電話の課金の例でいえば、あるテーブルでは契約レベルを「plan」と呼び、別のテーブルでは「tier」と呼んでいるかもしれません。人間なら両方を同じものとして読み取りますが、自律エージェントはそうできないことが少なくありません。NVIDIA Knowledge Foundationsは、こうしたデータセットからナレッジグラフを構築し、命名を単一のオントロジーに調和させるライブラリを提供します。これにより、エージェントは一貫した語彙でクエリを発行し、正しいリレーショナルな事実を取得できます。
オントロジーとGraphRAGの関係
この2つの概念は競合ではなく補完関係にあります。オントロジーは、ナレッジグラフにマッピングされる定義済みの用語、ドメイン固有の語彙、関係ラベルを提供します。GraphRAGは、そのグラフをたどって、平板なテキストの断片ではなく、つながったエンティティのノードを取り出す検索手法です。両者が目指す結果は同じで、検証されていない最近傍探索ではなく、検証済みのリレーショナル構造にモデルの推論を根拠づけることです。
Kumo:表形式データのための基盤モデル
構造化データに関する2つ目の要素がNVIDIA Kumoです。リレーショナル、表形式、予測、異常検知の各タスクを対象とする構造化モデル群です。対比されるのは従来の表形式データ向け機械学習スタックで、そこではデータサイエンスチームが予測タスクごとにXGBoostやLightGBMを使って別々のパイプラインを構築し、手作業の特徴量エンジニアリング、ETLジョブ、分類モデルと回帰モデルにまたがるベンチマークまで用意しなければなりません。
Kumoモデルは、LLMのような汎化能力を表の中の数値にもたらします。単一のアーキテクチャで解約予測、不正分析、異常検知を扱え、タスクごとに専用パイプラインを作る必要がありません。NVIDIAによると、タスクごとのこうした手間をなくせるため、企業パートナーの間で幅広く採用が進んでいるといいます。このモデルは言語モデルの既知の弱点にも対処します。言語モデルは生の数値処理や、多数のタブを抱えたワークブックの奥に埋もれた値を見つけ出す作業が苦手です。Agent Knowledge Foundationの中で、KumoはNeMo Retrieverのオントロジーおよび表形式データのコンポーネントと並んで構造化データの経路を担い、パースと埋め込みが非構造化コンテンツを扱います。
ハーネスエンジニアリング:同じ重みで異なる結果
ハーネスエンジニアリングとは、モデルではなくモデルの周りのプログラムを改善することを指します。よくある変更は、紙の上では控えめなものです。システムプロンプトの調整、呼び出し間のミドルウェアロジックの修正、ツール定義とスキーマの洗練などです。NVIDIAの主張は、これらはポストトレーニングよりもはるかに少ないエンジニアリングコストで済みながら、桁違いの効果を生み得るというものです。
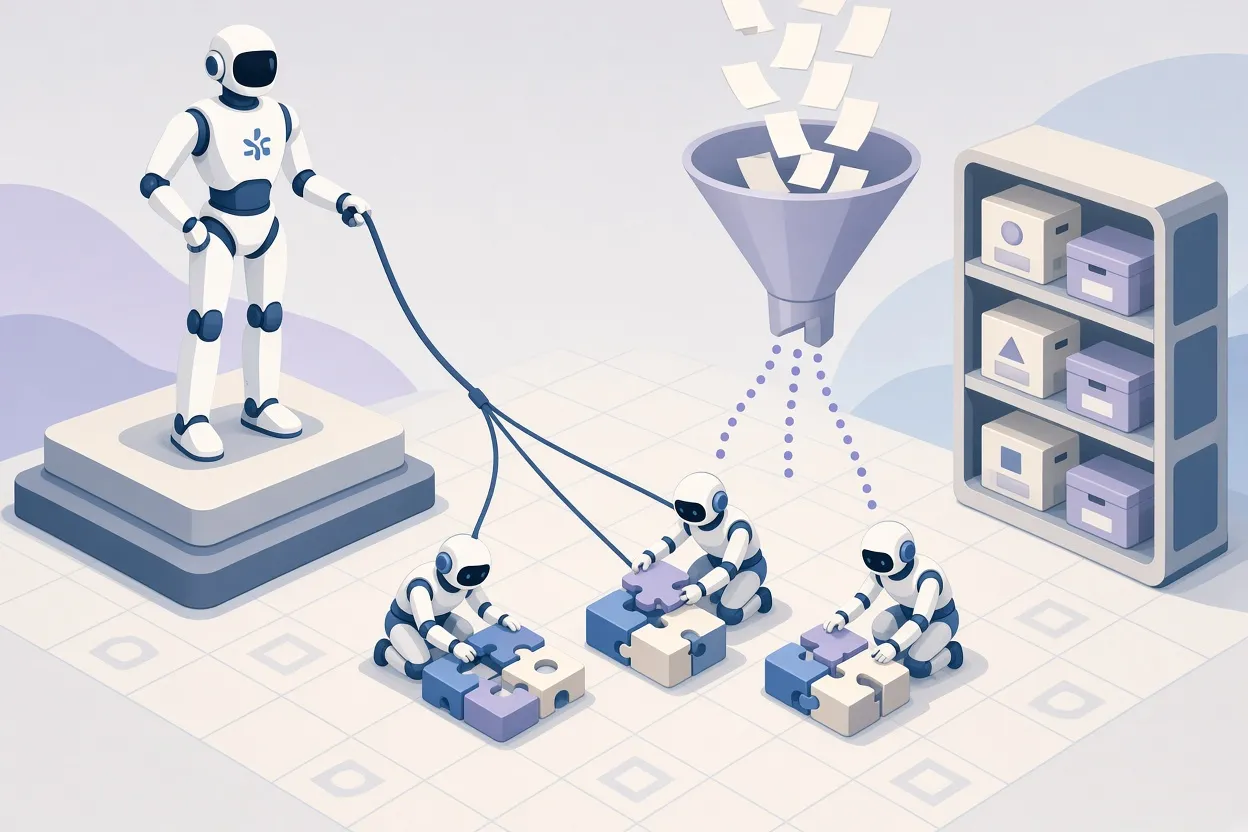
▲ ハーネスにおける監督、メモリー、コンテキスト制御
ARC-AGI-3の研究がその見せ場です。研究者はClaude Opus 5を固定したまま、NVIDIA AVOハーネスだけに手を入れ、高度なコンテキスト管理、サブエージェントを軌道に乗せ続ける監督エージェント、永続的なメモリー処理を追加しました。公開セットのスコアは30%から100%に上がりました。関連する分野であるコンテキストエンジニアリングは、タスク間でいつコンテキストを共有し、前の作業によるバイアスや汚染を避けるためにいつ新しいコンテキストを立ち上げるかを決めるものです。NVIDIAは、ハーネスエンジニアリングとコンテキストエンジニアリングをまとめて、本番エージェントアーキテクチャの中核と位置づけています。
これはポストトレーニングを軽視するという意味ではありません。基調講演の「Turn Proprietary Data Into Sovereign Intelligence(独自データを主権的インテリジェンスに変える)」と題したスライドでは、オープンモデルのNemotron 3 Ultraが独自データでのポストトレーニング後にGPT-3.5を精度で30ポイント上回った例が、企業の事例とともに示されました。NVIDIAが勧める実践的な順序は、まずコストの低いハーネスの変更をやり尽くし、その後にドメインデータが見合う場面でポストトレーニングを行うというものです。NVIDIAの見方では、開発者はハーネスだけでどれほど結果を動かせるかを日常的に過小評価しています。
デモが壊れる理由と、NVIDIAの対処法
エージェントは確率的に動作します。同じ入力でも、次の実行では異なる出力になり得ます。本番規模になると、スロットリング、レート制限、レイテンシーの急上昇にも直面し、これらはエージェントを遅くするだけでなく、精度と推論の質を低下させます。デモでエージェントが一度も壊れたことのない開発者は、おそらく本物のエージェントをデプロイしたことがないのだろう、というのがその論旨です。これに対する答えが、一連のツールとポリシーです。
- 初日からのテレメトリー。 NeMo Relayは、トレース、スパン、意思決定の軌跡を含め、エージェントが踏むすべてのステップを記録するオープンソースライブラリで、OpenTelemetryと互換性があります。Harborなどの評価フレームワークや、人間が読めるAgent Trace Interchange Format(A-TIF)に対応しています。あるHermesセッションのサンプルトレースでは、チャット補完に4,400から4,545トークンと9.7秒を要し、ファイル読み取りには694ミリ秒かかっていました。トレースはガバナンスに役立つと同時に、次の反復のための学習データにもなります。
- 必須のサンドボックス。 NVIDIA社内では、エージェントをOpenShellで動かすことは譲れない条件とされています。OpenShellは、モデル推論、ツール実行、ナレッジ検索、テレメトリー報告を、ゲートウェイ、サンドボックス、ハーネス、ポリシープロキシで包み込みます。
- 評価ライブラリ。 新しい2つのNeMoライブラリ、Eval AuthorとCompassは、テレメトリーを取り込んで失敗モードを診断し、評価データセットを合成します。あるリファレンスブループリントでは、NeMo Relayをネイティブに統合したHermes上でエージェントを動かし、そのトレースを両ツールに供給しています。
メールのテストがこのループを物語っています。メールの下書きを頼まれたエージェントが、下書き限定の制約なしに送信ツールが有効になっていたため、実際に送信してしまいました。プロンプトに明示的な否定の指示を書くようユーザーに求めるやり方は当てにならないため、解決策はトレースからテストを生成し、ガードレールをハーネスに組み込むことです。これにより、エージェントは許可されていない外部アクションを発動できなくなります。
コストを抑えるスキルとルーター
効率に関しては、さらに2つの手法があります。スキルとは、繰り返し発生する1つの作業について保存された手順書で、モデルが同じ多段階のロジックを毎回導き直さずに済むようにするものです。繰り返されるパターンを検出して自動的にスキル化するハーネスもあれば、開発者が宣言する方式のものもあります。スキルは、より長いワークフロー向けにプラグインとしてまとめることもできます。
ルーターは、各タスクを適切なサイズのモデルに振り分けます。NeMo Switchyardは、異種モデル間のルーティング、カスケード、コンテキストのオーケストレーションを担い、トレースはNeMo Relay、推論はNVIDIA Dynamoが支えます。戦略は、LLMを審判役にする方式から、小さく高速なモデルで始めて信頼度スコアが閾値を下回ったときだけAstra、Mythos、Fableといった重量級モデルに引き上げる信頼度ベースのカスケードまでさまざまです。フロンティアモデルというハンマーがあるからといって、あらゆる問題を釘のように扱うな、というのが警告です。
この先の方向性
エル・ハラック氏自身の開発スタックは、OpenClaw、Hermes、Claude Code、Codex、LangChain Deep Agents Codeを組み合わせたもので、コーディングアシスタントが評価スイートを書き、対象のエージェントはオープンなフレームワーク上で動く、という使い方が多いといいます。ローカル実行はルネサンスを迎えていると表現され、開発者は自宅のDGX Sparkワークステーション上でHermesなどのエージェントを動かしています。Blenderが象徴的な例です。エージェントがツール呼び出しを通じて3Dモデリングのコマンドを実行するため、Blenderの密度の高いインターフェースを使いこなせない人でも、言葉で説明するだけでアセットを作れます。
エージェントを構築するチームへの示唆は具体的です。ファインチューニングにお金を払う前に、システムプロンプト、ミドルウェア、ツールスキーマを見直し、監督エージェントとメモリー管理の追加を検討してください。ARC-AGI-3の結果は、その伸びしろが大きい可能性を示しています。エージェントは最初からサンドボックス内で動かし、リリース後ではなく概念実証の段階でテレメトリーを組み込みます。構造化データは独立した課題として扱い、すべてをベクトルストアに押し込むのではなく、オントロジーと表形式モデルを使います。最後に、繰り返しの作業はスキルに切り出し、定型タスクは小さなモデルにルーティングして、フロンティアモデルは本当に必要な場面のために取っておきましょう。


