英伟达在GTC Berlin 2026上提出一个观点:当前AI智能体最大的性能提升,来自包裹在模型外围的软件,而非模型本身。该公司新推出的Agent Toolkit打包了执行框架(harness)、沙箱运行时、知识层和遥测工具,并用一个醒目的数字为这一主张背书:据英伟达开发者博客2026年8月21日的一篇文章,Claude Opus 5在权重完全不变的情况下,接入英伟达AVO执行框架后,在ARC-AGI-3公开集上的得分从30%提升到100%。英伟达软件产品管理副总裁Adel El Hallak阐述了公司为何要构建这一层、其Agent Knowledge Foundation与多数企业已在使用的检索增强生成(RAG)有何不同,以及Kumo预测模型处于什么位置。
智能体的五个组成部分,模型只是其中之一
这一框架来自英伟达CEO黄仁勋的主题演讲,他将智能体拆分为五个部分:
| 部分 | 作用 | 英伟达的对应产品 |
|---|---|---|
| 模型 | 大脑;一个大语言模型或由多个模型组成的系统 | Nemotron 3 Ultra,或Claude Opus 5等第三方模型 |
| 执行框架 | 身体或外骨骼,让模型能够行动而不只是输出文本 | AVO执行框架、合作伙伴的执行框架 |
| 沙箱 | 对智能体可做之事的隔离与控制 | OpenShell |
| 知识 | 把企业数据变成智能体可用的形式 | Agent Knowledge Foundation |
| 工具 | 执行能力,包括用自然语言调用CUDA-X库 | CUDA-X库、MCP集成 |
拆分的要点在于:模型本身只会生成token。把这些token变成一项完成的任务,全靠另外四个部分,英伟达表示这正是它投入工程力量的地方。
是工具箱,不是LangChain的竞争者
一个自然的问题是,Agent Toolkit是否与LangChain、CrewAI或Agno等框架竞争。英伟达的回答是否定的。该工具包被描述为一个总括性的集合,把模型、库、集成和硬件加速输送到合作伙伴已经构建的框架中。英伟达与Harrison Chase及LangChain团队直接合作,并已将Deep Agents等LangChain执行框架纳入自己的参考实现。它还与Nous Research合作开发Hermes智能体,并与OpenClaw背后的团队合作。
工具包并非一个成品应用,而是以模块化组件加上名为"蓝图"的开放参考智能体形式交付。一个蓝图打包了选定的一个或一组模型、一个执行框架、特定任务的工具和技能、Model Context Protocol(MCP)集成,以及在OpenShell内的运行时隔离。蓝图的范围从驱动Blender中3D设计工作的智能体到用LangChain构建的企业工作流,团队可以克隆、修改并把它们嵌入自己的软件,而不必从零开始。例子包括NVIDIA NeMoClaw for Agent Optimization和NeMoClaw for LangChain Deep Agents Code。
Agent Knowledge Foundation:在RAG之上增加了什么
RAG几乎在2022年11月ChatGPT发布后立刻出现,当时幻觉问题使得信息锚定成为必需。第一波方案依赖对非结构化文档的向量嵌入,英伟达至今仍在这里大力投入:按其论点,更好的嵌入和重排序模型意味着智能体只需更少的搜索轮次就能找到正确的上下文。该公司的NeMo Retriever解析、嵌入和重排序组件正是为此向Milvus向量库输送数据。
Agent Knowledge Foundation更进一步,把结构化数据视为一等输入。它加入了知识图谱、本体和模式(schema),用来表示实体以及连接实体的动词,让智能体依据业务逻辑而非仅靠文本相似度来导航。
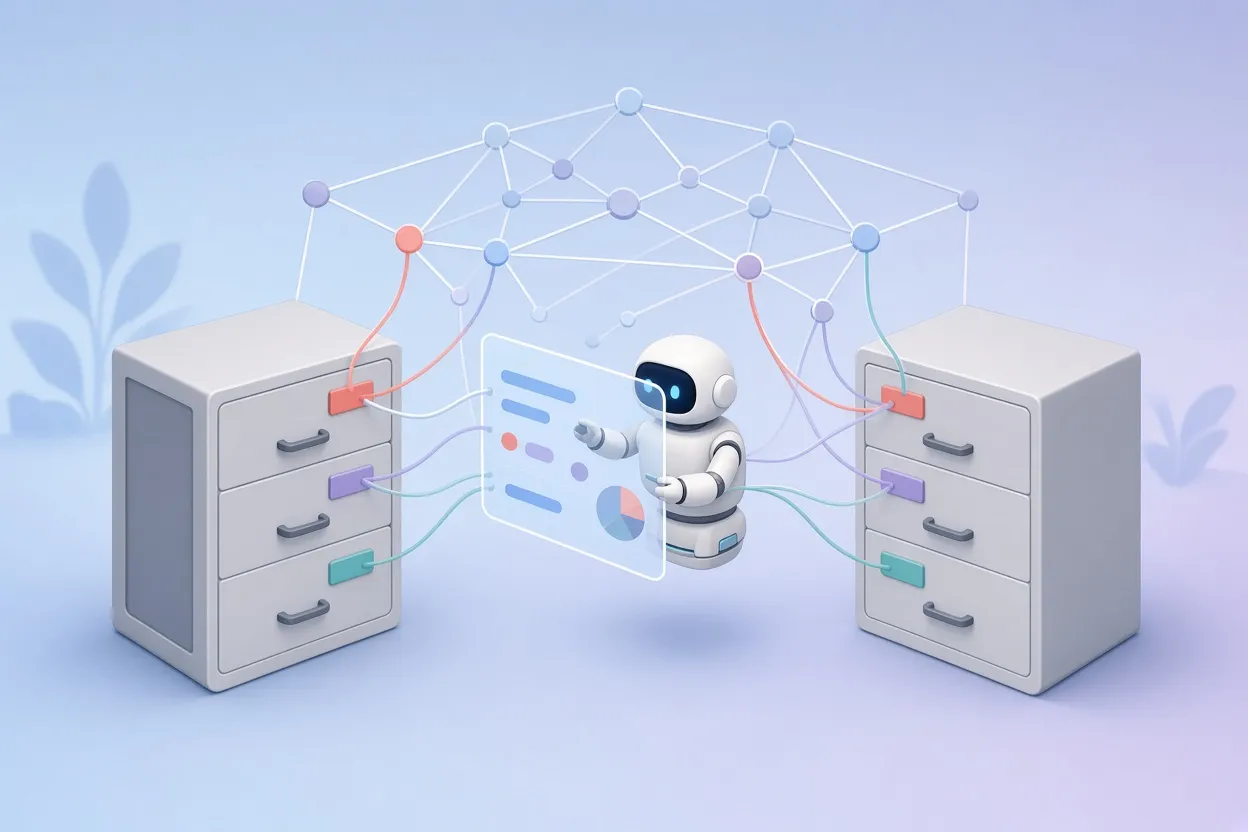
▲ 知识图谱统一不同数据模式
驱动这项工作的问题是数千张关系表之间的模式蔓延。以手机计费为例,一张表可能把订阅等级叫作"plan",另一张表叫作"tier"。人能看出两者是一回事,自主智能体往往看不出来。NVIDIA Knowledge Foundations提供的库能从这类数据集构建知识图谱,并把命名统一到单一本体中,让智能体用一套一致的词汇查询,并检索到正确的关系事实。
本体与GraphRAG
这两个概念是互补而非竞争关系。本体提供定义好的术语、领域词汇和关系标签,这些会被映射到知识图谱上。GraphRAG则是遍历该图谱的检索技术,取回相互关联的实体节点而非扁平的文本块。两者目标一致:把模型的推理锚定在经过验证的关系结构上,而不是未经验证的最近邻查找上。
Kumo:面向表格的基础模型
第二个结构化数据组件是NVIDIA Kumo,这是一系列覆盖关系、表格、预测和异常检测任务的结构化模型。对比对象是传统的表格机器学习技术栈:数据科学团队要用XGBoost或LightGBM为每个预测任务单独搭建一条流水线,包括手工特征工程、ETL作业,以及在分类和回归模型之间做基准测试。
Kumo模型把大语言模型式的泛化能力带到了表格中的数字上:单一架构就能处理流失预测、欺诈分析和异常检测,无需为每个任务定制流水线。英伟达称,企业合作伙伴正在广泛采用这些模型,因为它们免去了逐任务的开销。这些模型还弥补了语言模型的一个已知弱点:语言模型不擅长原始数值运算,也难以在塞满多个标签页的工作簿中找到某个数值。在Agent Knowledge Foundation内部,Kumo与NeMo Retriever的本体和表格组件并列,构成结构化数据路径,而解析和嵌入组件则处理非结构化内容。
执行框架工程:同样的权重,不同的结果
执行框架工程指的是改进模型周围的程序,而不是模型本身。常见的改动在纸面上并不起眼:调整系统提示词、修改调用之间的中间件逻辑、完善工具定义和模式。英伟达的主张是,这些改动的工程成本远低于后训练,却可能带来超出预期的收益。
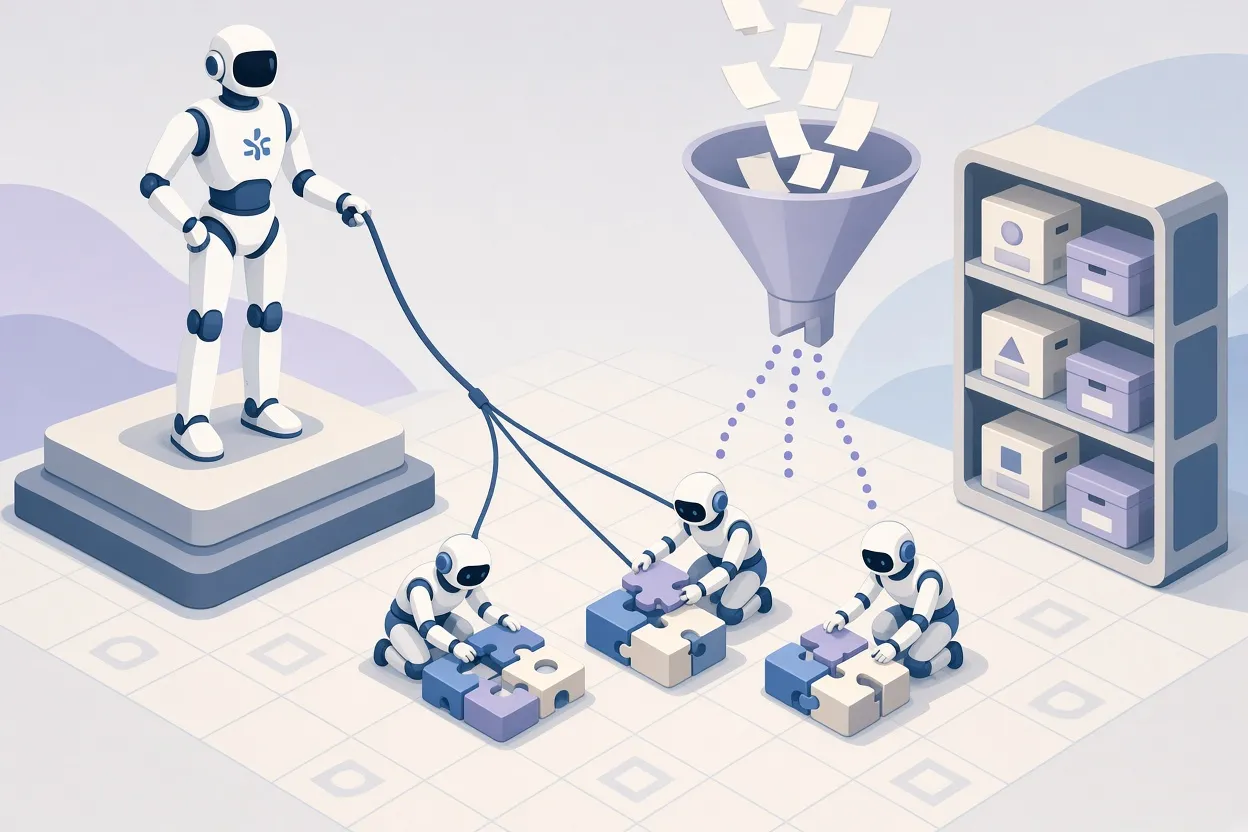
▲ 执行框架中的监督、记忆与上下文控制
ARC-AGI-3研究就是展示案例。研究人员保持Claude Opus 5不变,只在英伟达AVO执行框架上下功夫:加入高级上下文管理、让子智能体不偏离轨道的监督智能体,以及持久化的记忆处理。公开集得分从30%升到了100%。与之相关的另一门学问是上下文工程,它决定何时在任务之间共享上下文,何时另起全新的上下文以避免上一项作业带来的偏差或污染。英伟达把执行框架工程和上下文工程一起视为生产级智能体架构的核心。
这并不意味着后训练被否定。主题演讲中一张题为"把专有数据变成主权智能"的幻灯片显示,开放模型Nemotron 3 Ultra在用专有数据后训练后,准确率比GPT-3.5高出30个百分点,旁边还列有企业案例研究。英伟达建议的实际顺序是:先把执行框架的改动用尽,因为它更便宜;然后在领域数据足以支撑时再做后训练。在英伟达看来,开发者经常低估仅靠执行框架能带来多大的改变。
演示为何会出错,英伟达如何应对
智能体是概率性的:相同的输入在下一次运行时可能给出不同的输出。到了生产规模,它们还会遇到限流、速率限制和延迟突增,这些不只是让智能体变慢,还会损害其准确性和推理能力。按这一说法,如果某位开发者的智能体从未在演示中出过错,那他多半还没部署过真正的智能体。应对之策是一套工具和政策:
- 从第一天起就做遥测。 NeMo Relay是一个开源库,记录智能体的每一步,包括追踪记录、跨度和决策轨迹,并与OpenTelemetry兼容。它支持Harbor等评估框架,以及人类可读的Agent Trace Interchange Format(A-TIF)。在一段Hermes会话的样例追踪中,聊天补全消耗4,400到4,545个token、耗时9.7秒,一次文件读取耗时694毫秒。追踪记录既服务于治理,也可作为下一轮迭代的训练数据。
- 强制使用沙箱。 在英伟达内部,在OpenShell中运行智能体被描述为没有商量余地。OpenShell用网关、沙箱、执行框架和策略代理把模型推理、工具执行、知识检索和遥测上报包裹起来。
- 评估库。 两个新的NeMo库Eval Author和Compass消费遥测数据来诊断失败模式并合成评估数据集。一个参考蓝图在原生集成NeMo Relay的Hermes上运行智能体,并把追踪记录输入这两个工具。
邮件测试说明了这个闭环。一个被要求起草邮件的智能体直接把邮件发了出去,因为发送工具被启用,却没有加上"仅限草稿"的约束。让用户在提示词里写明确的否定指令并不可靠,所以修复方法是从追踪记录生成测试,并把护栏固化进执行框架,使智能体无法触发未经授权的外部操作。
用技能和路由器控制成本
另外两项技术针对效率。技能是为某项重复性工作保存下来的书面流程,这样模型就不必每次重新推导同样的多步逻辑。有些执行框架能检测重复模式并自动转化为技能;另一些则让开发者自行声明。技能可以组合成插件,用于更长的工作流。
路由器把每项任务发送给规模合适的模型。NeMo Switchyard负责跨异构模型的路由、级联和上下文编排,底层由NeMo Relay提供追踪、NVIDIA Dynamo提供推理。策略从"以大语言模型为评判"到基于置信度的级联不一而足:后者先用小而快的模型,只有当置信度分数低于阈值时才升级到Astra、Mythos或Fable等重量级模型。其中的告诫是:不要因为手里有前沿模型这把锤子,就把所有问题都当成钉子。
未来走向
El Hallak自己的开发技术栈混合使用OpenClaw、Hermes、Claude Code、Codex和LangChain Deep Agents Code,通常由编码助手编写评估套件,而目标智能体在开放框架中运行。本地执行被描述为正在复兴,开发者在家中的DGX Spark工作站上运行Hermes和其他智能体。Blender是展示案例:智能体通过工具调用执行3D建模命令,这样即便不会操作Blender密集界面的人,也能通过描述来生成素材。
对构建智能体的团队而言,结论很具体。在为微调付费之前,先重新审视系统提示词、中间件和工具模式,并考虑加入监督智能体和记忆管理;ARC-AGI-3的结果表明提升空间可能很大。从一开始就在沙箱中运行智能体,并在概念验证阶段而非上线之后就接入遥测。把结构化数据当作独立问题处理,使用本体和表格模型,而不是把一切都硬塞进向量库。最后,把重复性工作交给技能,把常规任务路由到较小的模型,前沿模型留给真正需要的场景。


