NVIDIA가 GTC Berlin 2026에서 공개한 NVIDIA Agent Toolkit의 핵심 메시지는 단순합니다. agent의 성능은 모델만으로 정해지지 않는다는 것입니다. NVIDIA가 2026년 8월 21일 개발자 블로그에 올린 연구에 따르면, Claude Opus 5 모델을 전혀 바꾸지 않고 모델을 감싸는 실행 틀인 NVIDIA AVO harness만 손본 결과 ARC-AGI-3 공개 세트 점수가 30%에서 100%로 올랐습니다. NVIDIA의 소프트웨어 제품 관리 부문 부사장이 이 사례를 중심으로 Agent Toolkit의 설계 의도, 기존 RAG와 다른 Agent Knowledge Foundation의 구조, 표 데이터를 다루는 Kumo 모델의 쓰임을 설명했습니다.
agent를 다섯 부분으로 나누는 이유
NVIDIA CEO Jensen Huang은 기조연설에서 agent(스스로 도구를 쓰며 작업을 수행하는 AI 프로그램)를 다섯 부분으로 나눴습니다. 소프트웨어 제품 관리 부사장은 이 틀을 그대로 받아 각 부분의 역할을 설명했습니다.
| 구성 요소 | 비유 | 역할 |
|---|---|---|
| 모델 | 두뇌 | 하나의 LLM일 수도, 여러 모델이 연결된 시스템일 수도 있음 |
| harness | 몸(외골격) | 모델이 token만 내뱉는 데 그치지 않고 환경 속에서 행동하게 하는 실행 틀 |
| sandbox | 격리된 작업 공간 | OpenShell로 구현되며, agent가 할 수 있는 일을 통제 |
| 지식 | 회사 고유의 기억 | 구조화·비구조화 자산을 agent가 읽을 수 있는 데이터로 변환 |
| 도구 | 손 | CUDA-X 같은 전문 라이브러리를 자연어 지시로 실행 |
이 가운데 harness가 왜 중요한지는 한 문장으로 요약됩니다. harness와 도구가 없으면 LLM은 글자를 생성할 뿐 실제 행동을 할 수 없다는 것입니다. 부사장은 자신이 예전에는 CUDA 저수준 라이브러리를 직접 다루지 못했지만, 지금은 자연어 prompt로 agent가 CUDA-X 도구를 대신 호출하게 한다고 말했습니다. 모델을 둘러싼 틀이 모델의 쓸모를 결정한다는 뜻으로 읽힙니다.
Agent Toolkit은 LangChain의 경쟁자가 아닙니다
LangChain, CrewAI, Agno 같은 기존 agent framework와의 관계에 대해 부사장은 경쟁 관계가 아니라고 선을 그었습니다. NVIDIA의 전략은 파트너와 함께 시장에 나가는 생태계 방식이며, Agent Toolkit은 완결된 응용 프로그램이 아니라 부품을 모아 둔 도구 상자라는 설명입니다. 실제로 NVIDIA는 LangChain 팀과 직접 협업해 Deep Agents harness를 자사 참조 구현에 넣었고, Nous Research의 Hermes agent와 OpenClaw 팀과도 함께 일한다고 밝혔습니다. 목표는 파트너 framework에 안전 계층, 전문 모델, 하드웨어 가속을 보태는 것입니다.
구체적인 산출물은 blueprint입니다. blueprint는 복제해서 고쳐 쓸 수 있는 공개 참조 agent로, 선택된 모델, 실행 harness, 작업별 도구, OpenShell 안의 실행 환경을 한 묶음으로 담습니다. Blender로 3D 설계를 하는 agent부터 LangChain으로 만든 기업 업무 흐름까지 영역별로 준비되며, skill과 MCP(Model Context Protocol, agent가 외부 도구와 연결되는 표준) 통합이 포함됩니다. 공개된 예시로는 agent 최적화용 NeMoClaw와 LangChain Deep Agents Code용 NeMoClaw가 있습니다.
Agent Knowledge Foundation은 RAG와 무엇이 다른가
부사장은 2022년 11월 ChatGPT 출시 직후 hallucination(사실이 아닌 내용을 그럴듯하게 생성하는 현상) 문제가 불거지면서 RAG(Retrieval-Augmented Generation, 외부 자료를 검색해 답변의 근거로 삼는 방법)가 필요해졌다고 돌아봤습니다. 초기 RAG는 vector embedding(문서를 숫자 벡터로 바꿔 유사도로 검색하는 기술)으로 LLM을 근거에 묶어 두는 데 성공했지만, 기업이 다루는 데이터 형태는 그보다 훨씬 복잡하다는 것이 문제입니다.
Agent Knowledge Foundation은 이 간극을 두 방향에서 메웁니다.
- 비구조화 문서 쪽에서는 embedding과 reranking(검색 결과를 다시 정렬해 정확도를 높이는 단계) 모델에 계속 투자합니다. 검색 품질이 높아지면 agent가 정답에 닿기까지 필요한 검색 횟수가 줄어듭니다.
- 구조화 데이터 쪽에서는 knowledge graph(개체와 관계를 그물처럼 연결한 지식 구조), ontology(용어와 관계의 정의 체계), schema를 더해 명사와 동사로 이루어진 사업 논리를 표현합니다.
공개된 구성도를 보면 비구조화 데이터는 NeMo Retriever의 Parse와 Embed를 거치고, 구조화 데이터는 NeMo Retriever Ontology, Tabular, Kumo를 거쳐 Milvus vector 저장소와 GraphRAG로 들어간 뒤 NeMo Retriever Rerank로 정리됩니다.
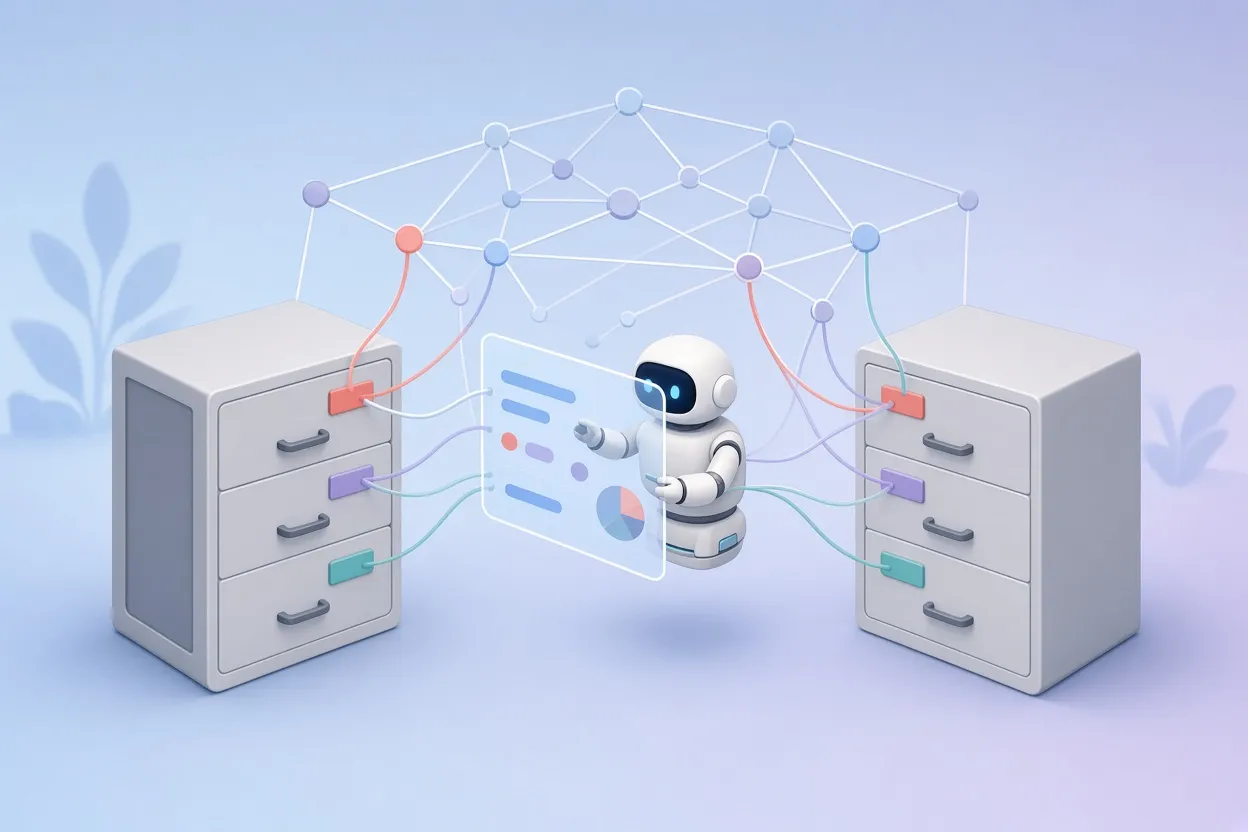
▲ ontology로 통일된 기업 데이터
왜 ontology가 필요한지는 휴대전화 요금 예시로 설명됩니다. 한 표에서는 가입 등급을 'plan'이라 부르고 다른 표에서는 'tier'라고 부릅니다. 사람은 둘이 같은 뜻임을 바로 알지만 agent는 혼란을 겪습니다. 기업 데이터베이스는 수천 개의 표에 걸쳐 이런 이름 차이가 흔한데, NVIDIA Knowledge Foundations 라이브러리는 이를 하나의 ontology와 knowledge graph로 통일해 agent가 올바른 관계 정보를 찾게 합니다.
GraphRAG와의 관계도 정리됐습니다. ontology는 knowledge graph 위에 얹히는 용어와 관계 이름의 정의이고, GraphRAG는 그 graph를 검색해 서로 연결된 개체를 가져오는 방법입니다. 둘은 경쟁 관계가 아니라 보완 관계이며, 공통 목표는 LLM의 추론을 검증되지 않은 vector 유사도가 아니라 검증된 관계 구조에 묶어 두는 것입니다.
Kumo 모델이 쓰이는 자리
지식 기반의 구조화 데이터 쪽에 들어가는 Kumo 모델은 표 데이터 예측에 foundation model 방식을 가져온 것입니다. 지금까지 데이터 과학자는 예측 과제마다 XGBoost나 LightGBM으로 별도 pipeline을 만들었습니다. feature engineering(모델이 쓸 입력 변수를 사람이 설계하는 작업), ETL 데이터 pipeline, 분류와 회귀 모델을 따로 비교하는 benchmark 작업이 과제마다 반복됐습니다.
Kumo 구조화 모델은 관계형, 표, 예측, 이상 탐지 네 범주를 하나의 일반화된 접근으로 처리합니다. LLM이 언어에서 보여 준 일반화 능력을 기업의 숫자 데이터에 적용해, 고객 이탈 분석, 사기 탐지, 이상 탐지를 같은 구조로 다룬다는 설명입니다. 부사장은 LLM이 원래 숫자 처리와 여러 탭이 있는 spreadsheet 탐색에 약하다는 점을 들며, 이 약점을 메우는 역할을 Kumo가 맡는다고 짚었습니다. 과제별 모델링 부담이 사라지면서 기업 파트너의 도입이 넓게 일어나고 있다고도 전했습니다.
같은 모델로 30%에서 100%로
NVIDIA는 모델 post-training(이미 학습된 모델을 기업 데이터로 추가 학습하는 과정)의 효과도 함께 제시했습니다. 기조연설의 사례에서 고유 데이터로 추가 학습한 Nemotron 3 Ultra는 GPT 3.5보다 정확도 점수가 30점 높아져, 전문 영역에서는 범용 frontier 모델을 넘어섰습니다.
그러나 부사장이 더 강조한 것은 harness engineering입니다. 모델 가중치를 건드리지 않고 모델을 감싸는 소프트웨어 구조를 손보는 작업으로, 대표적으로 system prompt, 중간 middleware 논리, 도구 정의와 schema 세 가지를 조정합니다. post-training보다 공학적 부담이 훨씬 적은데도 효과는 큽니다.
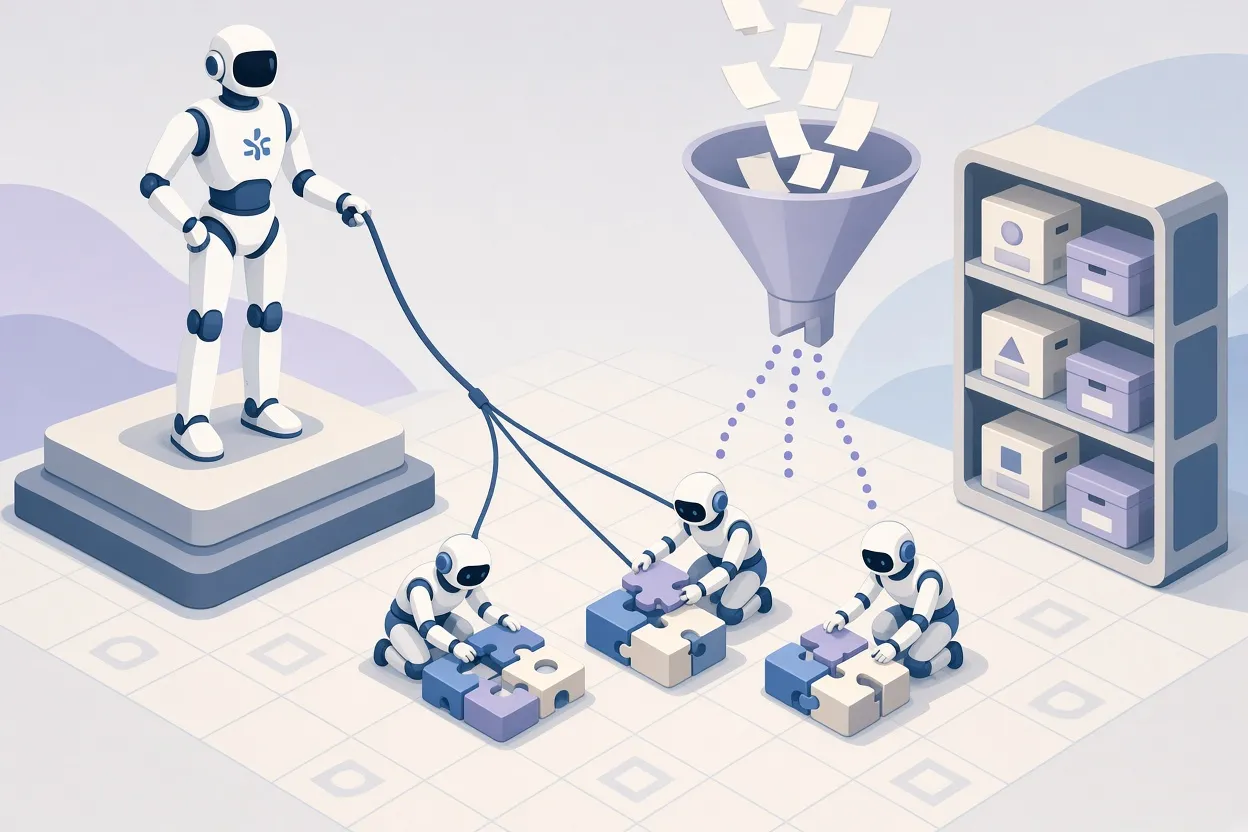
▲ harness 설계의 세 요소
2026년 8월 21일 공개된 NVIDIA 연구가 그 증거입니다. 고정된 Claude Opus 5에 NVIDIA AVO harness를 적용해 ARC-AGI-3 공개 세트 점수를 30%에서 100%로 끌어올렸습니다. 효과를 낸 요소는 다음 세 가지였습니다.
- 고급 context 관리: 작업 간에 context를 공유할지 새로 시작할지를 가려 편향과 prompt 오염을 막습니다.
- 감독 agent 계층: 상위 agent가 하위 agent의 진행을 추적해 궤도를 벗어나지 않게 합니다.
- 지속적인 memory 처리: 작업 상태를 유지하면서 context 크기를 통제합니다.
부사장은 개발자들이 harness engineering 하나만으로 얻을 수 있는 효과를 자주 과소평가한다고 지적했습니다. harness engineering과 context engineering이 현대 기업용 agent 개발의 핵심 분야라는 것이 그의 판단입니다. 비싼 추가 학습을 검토하기 전에 harness부터 점검하라는 뜻으로 읽힙니다.
데모는 왜 운영에서 깨지는가
개발자 컴퓨터에서는 잘 돌던 agent가 고객 앞에서 깨지는 일은 피할 수 없다고 부사장은 말했습니다. 자기 agent가 한 번도 깨진 적 없다고 말하는 개발자는 실제 agent를 만들어 본 적이 없을 것이라는 농담도 덧붙였습니다. 이유는 agent가 확률적 시스템이기 때문입니다. 같은 입력에도 매번 다른 출력이 나올 수 있고, 운영 규모에서는 throttling, rate limit, 서버 지연이 겹칩니다. 중요한 점은 지연이 단순히 느려지는 데 그치지 않고 작업 정확도와 추론 품질까지 떨어뜨린다는 것입니다.
따라서 telemetry 수집은 운영 단계가 아니라 시제품 단계부터 시작해야 합니다. NVIDIA가 만든 오픈소스 NeMo Relay는 agent 실행의 모든 단계를 기록합니다. 기록 예시를 보면 한 세션 안에서 turn, 모델 호출(4,400~4,545 token, 9.7초), 파일 읽기(694ms)가 단계별로 남습니다. 기록은 OpenTelemetry 호환이며 Harbor 같은 평가 framework와 사람이 읽을 수 있는 Agent Trace Interchange Format(A-TIF)을 지원합니다. 기록의 용도는 두 가지입니다. 기업 통제와 규정 준수를 뒷받침하고, 운영 중 남긴 흔적을 다음 학습 데이터로 바꾸는 것입니다.
안전 쪽에서는 OpenShell이 핵심입니다. NVIDIA 내부에서는 agent를 OpenShell 안에서 돌리는 것이 타협 불가능한 원칙이라고 부사장은 밝혔습니다. OpenShell은 gateway, sandbox, harness, policy proxy를 한 울타리 안에 두고 모델 추론, 도구 실행, 지식 검색, telemetry 보고를 통제합니다.
평가 도구로는 새 NeMo 라이브러리인 Eval Author와 Compass가 소개됐습니다. Hermes처럼 NeMo Relay를 harness에 기본 통합한 플랫폼에서 agent가 남긴 기록을 Compass와 Eval Author로 보내 실패 양상을 진단하는 흐름입니다. 예시로 든 실패는 이메일 초안을 쓰라고 했더니 agent가 곧바로 발송해 버린 경우입니다. 발송 도구가 켜져 있었고 초안만 작성하라는 제약이 도구 호출에 없었기 때문입니다. 부사장은 prompt에 '보내지 말라'고 적는 방식은 운영에서 믿을 수 없으며, 보호 장치는 harness 안에 심어야 한다고 강조했습니다. 실행 기록을 분석해 평가 데이터셋을 만들고 자동 테스트로 이런 행동을 막는 것이 목표입니다.
skill과 router로 비용과 지연 줄이기
성능과 비용을 함께 잡는 방법으로 두 가지가 제시됐습니다. 첫째는 skill입니다. 반복되는 추론 단계를 저장된 절차로 묶어 두면 LLM이 같은 문제를 매번 처음부터 풀 필요가 없어집니다. 어떤 harness는 반복 패턴을 자동으로 찾아 skill로 만들고, 어떤 harness는 개발자가 직접 선언합니다. skill을 모아 plugin으로 묶으면 복잡한 다단계 업무도 모듈로 다룰 수 있습니다.
둘째는 router입니다. 부사장은 망치를 들면 모든 문제가 못으로 보인다는 비유로, 단순한 일에 거대 frontier 모델을 쓰는 습관을 경계했습니다. NeMo Switchyard는 여러 모델 사이의 routing, 요청 cascading, context 조율을 맡습니다. 방식은 LLM을 심판으로 쓰는 단순한 것부터, 작은 모델로 시작해 확신도가 기준에 못 미칠 때만 Astra, Mythos, Fable 같은 큰 모델로 올리는 확신도 기반 cascade까지 있습니다.
부사장 개인의 작업 환경도 참고가 됩니다. 그는 OpenClaw, Hermes, Claude Code, Codex, LangChain Deep Agents Code를 역할별로 나눠 쓰며, 예를 들어 Codex나 Claude Code로 평가 테스트를 작성하고 대상 agent는 개방형 framework 안에서 돌립니다. NVIDIA DGX Spark 같은 장비로 집에서 로컬 모델과 Hermes를 돌리는 개발자가 늘고 있다며 로컬 AI의 부흥도 언급했습니다. Blender처럼 배우기 어려운 3D 소프트웨어를 자연어 agent가 도구 호출로 대신 조작하는 사례는, 전문가가 아닌 사람도 3D 자산을 만들 수 있게 한다는 점에서 인상적입니다.
정리: 모델보다 먼저 점검할 것
NVIDIA가 Agent Toolkit으로 보여 준 방향은 모델 경쟁이 아니라 모델을 둘러싼 틀의 경쟁입니다. 같은 Claude Opus 5가 harness에 따라 30%와 100%라는 전혀 다른 점수를 낸 사례는, agent의 품질이 모델 선택 못지않게 context 관리, 감독 구조, memory 처리, 도구 정의에 달려 있음을 보여 줍니다. 지식 쪽에서는 vector 검색만으로는 부족하며 ontology와 knowledge graph, 그리고 표 데이터를 위한 Kumo 모델이 함께 필요하다는 것이 NVIDIA의 판단입니다.
agent를 만들거나 도입하려는 독자라면 다음 순서로 점검해 볼 만합니다.
- 추가 학습을 검토하기 전에 system prompt, middleware, 도구 schema부터 손봅니다.
- 시제품 단계부터 NeMo Relay 같은 도구로 실행 기록을 남기고, OpenTelemetry와 A-TIF 같은 개방 표준을 따릅니다.
- agent는 반드시 OpenShell 같은 sandbox 안에서 돌리고, '초안만 작성' 같은 제약은 prompt가 아니라 harness에 심습니다.
- 기업 데이터가 수천 개의 표에 흩어져 있다면 ontology로 용어를 통일하고, 예측 과제는 Kumo 같은 구조화 모델로 pipeline을 줄일 수 있는지 살핍니다.
- 반복 작업은 skill로 묶고, router로 작은 모델부터 시도해 비용을 아낍니다.
처음부터 모든 것을 직접 만들기보다 공개 blueprint를 복제해 고치는 편이 안전 기본값과 MCP 통합을 그대로 얻을 수 있어 효율적일 것으로 보입니다.


