어느 기업이나 같은 frontier 모델을 쓸 수 있고, open-weight 모델도 3~6개월 차이로 따라붙는 지금, agent의 성능 차이는 어디에서 날까요. Oracle의 한 AI 엔지니어는 그 답을 모델이 아니라 agent가 무엇을 알고, 무엇을 기억하고, 무엇을 볼 수 있으며, 어떻게 나아지는지를 정하는 층, 즉 intelligence plane(지능 평면)에서 찾습니다. 같은 모델과 같은 데이터를 가진 조직이라도 지식과 memory를 구조화하고 쌓아 가는 방식이 다르면 결과가 달라진다는 주장입니다. 이 글에서는 그 설계론을 2차 대전 Midway 해전의 암호 해독 사례와 함께 풀고, control plane 다음에 무엇을 쌓아야 하는지 실무자 관점에서 정리합니다.
같은 정보를 보고 다른 답을 낸 두 팀
1942년 5월, 미국 해군은 일본 해군의 통신을 가로채 다음 공격 목표를 알아내려 했습니다. 똑같이 가로챈 메시지를 두 팀이 분석했습니다. 워싱턴의 OP-20-G와 진주만의 Station HYPO입니다.
Station HYPO는 지하실에서 몇 달치 손으로 쓴 메시지 기록을 종이로 차곡차곡 모아 두고 있었습니다. 이 팀은 반복해서 나타나는 지명 부호 'AF'가 Midway섬이라고 보고, 이를 확인하기 위한 실험을 설계했습니다. Midway 기지에 담수 증류 설비가 고장 났다는 메시지를 암호화하지 않은 채 보내게 한 것입니다. 얼마 뒤 가로챈 일본군 통신에 'AF'가 식수 부족이라는 내용이 담기면서 AF가 Midway라는 사실이 확정되었습니다.
반면 워싱턴은 중앙집중식 통제 방식으로 접근해 목표가 남태평양이나 알류샨 열도, 미국 서해안일 것이며 시점은 6월 중순이라고 잘못 추론했습니다. Station HYPO는 축적된 맥락과 기록, 실험을 바탕으로 6월 4일 Midway를 짚어 냈고, Nimitz 제독은 이를 근거로 항공모함을 배치해 승리했습니다.
이 사례가 AI agent에 주는 교훈은 분명합니다. 같은 기반 모델과 같은 조직 데이터에 접근할 수 있다는 것 자체는 경쟁력이 되지 않습니다. 차이는 조직이 지식과 절차적 기억을 어떻게 구조화하고 보존하고 종합하느냐에서 나옵니다. 정보가 곧 지능은 아니라는 말입니다.
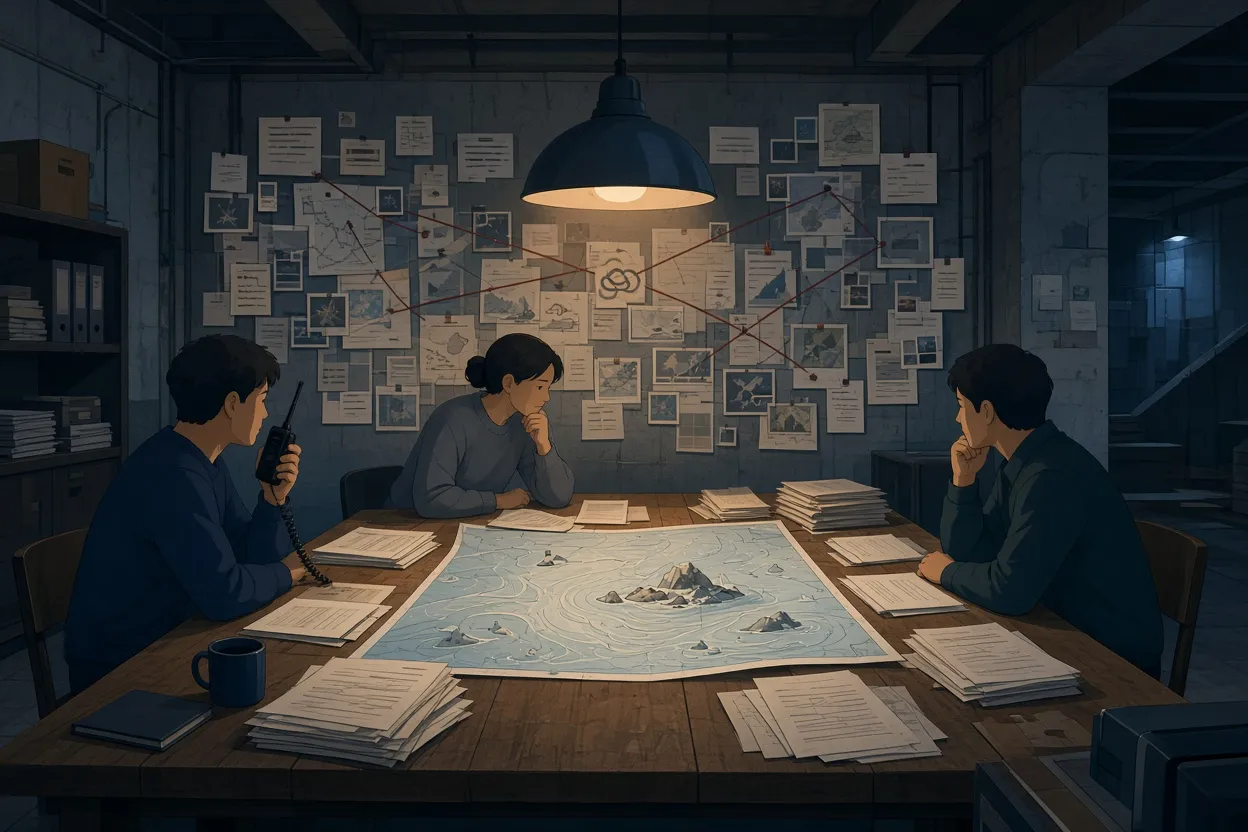
▲ 축적된 기록에서 나온 판단
control plane은 '해도 되는 일'만 정합니다
이 설계론은 agent 개발이 네 단계로 진화해 왔다고 봅니다.
| 단계 | 시기 | 초점 |
|---|---|---|
| 1단계 | 2023년 | prompt engineering, 단일 모델 호출 |
| 2단계 | 2024년 | RAG(검색으로 근거를 보강하는 방식)와 context engineering, 도구 호출 |
| 3단계 | 2025년 | control plane과 agent 거버넌스 |
| 4단계 | 2026년 이후 | 알고, 기억하고, 학습하는 agent, 즉 intelligence plane |
control plane(제어 평면)은 agent가 무엇을 해도 되는지를 중앙에서 정하는 거버넌스 층입니다. agent의 신원을 확인하고, 허용된 호출을 관리하고, 컴퓨팅 비용과 지출을 감시하고, 감사 기록을 남깁니다. 연구 agent, 트레이딩 보조 agent, 운영 agent가 모두 이 층을 거쳐 API나 MCP 서버 같은 외부 도구, LLM과 SLM 같은 모델, 테이블과 문서 같은 기업 데이터에 접근합니다. 구성 요소로는 신원과 접근, 정책과 guardrail(안전 장치), 도구 권한, kill switch를 포함한 수명 주기 관리, 감사 추적이 있습니다.
문제는 control plane이 agent가 무엇을 아는지는 정하지 못한다는 점입니다. 이 설계론은 이를 세 개의 식으로 정리합니다.
- agent = 모델 + harness(모델을 감싸는 실행 환경)
- control = 거버넌스 + 보안
- intelligence는 control에 knowledge, memory, learning을 더한 값을 곱한 것
control이 0이면 기업에서 쓸 수 없는 시스템이 되지만, control만 있고 intelligence가 없으면 보안은 갖췄으되 회사의 업무 논리를 전혀 모르는 agent가 됩니다. 지능은 통제를 곱해 키우는 승수라는 발상입니다. 이 구분이 완전히 새로운 것은 아닙니다. 네트워킹 분야에서는 2003년 SIGCOMM 논문이 설정을 담당하는 관리 평면, 경로를 계산하는 제어 평면, 패킷을 옮기는 데이터 평면과 별도로 네트워크 전체 상태를 모델링하는 knowledge plane을 제안한 바 있습니다.
intelligence plane이 정하는 네 가지
intelligence plane은 agent 시스템에 대해 다음 네 가지를 결정합니다. 은행 업무를 예로 들면 이해가 쉽습니다.
| 역할 | 뜻 | 은행 예시 |
|---|---|---|
| 무엇을 아는가 | 도메인 지식과 의미 체계 | 거래 상대방(counterparty)은 모회사와 산하 법인을 모두 포함한다는 정의 |
| 무엇을 기억하는가 | 과거 상호작용의 memory | 분석가가 지난주에 고친 계산 오류를 기억해 반복하지 않음 |
| 무엇을 볼 수 있는가 | 데이터 접근 거버넌스 | Desk A 담당 분석가는 Desk B의 포지션을 볼 수 없음 |
| 어떻게 나아지는가 | 지속 학습 | 승인된 사람의 피드백으로 검색 reranker(검색 결과 재정렬 모델)를 갱신 |
이 층이 control plane과 다른 점은 stack을 가로지르는 방향입니다. agent stack은 인프라, memory core, 보안과 거버넌스, 도구, memory manager, 추론, orchestration, gateway, 애플리케이션의 아홉 층으로 그려집니다. control plane은 거버넌스, orchestration, 도구 층을 수평으로 지나가지만, intelligence plane은 아홉 층 전부를 수직으로 관통합니다. gateway에서는 최종 사용자의 신원을 데이터 권한에 연결하고, orchestration에서는 권한을 지킨 context 조립을 담당하는 식입니다. 모든 질의는 사용자 신원을 명시적으로 지닌 채 stack을 통과해야 하며, 검색, memory 쓰기, 도구 실행이 모두 행과 열 단위 권한을 따라야 합니다.
여기서 memory의 기본 구조를 짚어 둘 필요가 있습니다. agent memory는 agent가 여러 대화 차례, 세션, agent에 걸쳐 정보를 보존(retain)하고, 재사용(reuse)하고, 다듬고(refine), 회상(recall)하는 장치로 정의됩니다. 한 세션 안에서 쓰이는 단기 memory에는 context window에 해당하는 working memory와 반복 질의를 처리하는 semantic cache가 있고, 세션을 넘어 유지되는 장기 memory는 사실과 지식을 담는 semantic memory, 과거 사건을 기록하는 episodic memory, 작업 흐름과 행동을 정하는 procedural memory로 나뉩니다. 구현 형태로는 entity memory, knowledge base, persona memory, 대화 이력과 요약, toolbox와 workflow 정의가 각각 대응합니다.
열 단계 모두가 학습된 모델로 바뀝니다
이 설계론이 꼽는 변곡점은 자연어 생성이 아니라 시스템 수준의 구조화된 결정을 위해 만들어진 decision model(결정 모델)의 등장입니다. 70~100밀리초 안에 형식이 정해진 결정을 돌려주며 범용 frontier LLM보다 20~100배 빠른 모델이 예로 제시됩니다. 이런 모델은 딱딱하게 하드코딩된 연결 코드를 학습된 결정 경계로 바꾸게 합니다.
과거의 검색 pipeline은 열 단계 가운데 두 단계만 학습된 모델을 썼고, 라우팅, 입력 검증, 캐싱, guardrail은 정적 규칙에 의존했습니다. 현대 agent pipeline은 라우터 분류기, 입력 guard 분류기, semantic cache 검증기, embedder와 reranker, 질의 planner, 추론 LLM, decision model, memory manager, 출력 검사 judge, 데이터베이스 안 추론 엔진까지 열 단계 전부를 특화 모델이 맡는 방향으로 갑니다. 모든 모듈이 기업 context를 이해하고 같은 신원과 권한 의미를 일관되게 적용하게 하려는 것입니다.
숫자로 본 차이: governed agent와 naive agent
Fieldbooks라는 기업용 benchmark 플랫폼에서 intelligence plane을 갖춘 governed analyst와 그렇지 않은 naive analyst를 같은 포트폴리오 위험 질문으로 비교한 결과가 제시됩니다. 질문은 한 기업 그룹에 대한 순 익스포저를 묻는, 법인 계층 구조를 풀어야 답할 수 있는 종류였습니다.
| 항목 | governed analyst | naive analyst |
|---|---|---|
| 정답 정확도 | 97% | 33% |
| 총 token | 32,999 | 234,267 |
| 추론 비용 | $0.0362 | $0.4567 |
| 평균 응답 시간 | 10.6초 | 42.8초 |
| context 크기 | 3,425 token | 18,277 token |
governed agent는 29번의 질의 가운데 4번은 정확 일치 cache, 5번은 semantic cache로 처리했습니다. semantic 층과 ontology(업무 개념과 관계를 명시적으로 정의한 체계) 층이 복잡한 신용 모회사 구조와 Desk NAV 같은 금융 지표를 정확히 풀어낸 덕분에, 키워드 검색에서 발생한 약 5%의 오차도 피했습니다. 금융처럼 규제가 강한 영역에서는 키워드 검색의 모호함에서 비롯된 5% 오차도 용납되지 않는다는 것이 이 비교의 요지입니다. 이 수치는 특정 benchmark 환경에서 나온 한 사례의 결과이므로 모든 업무에 같은 폭으로 적용된다고 보기는 어렵지만, 정확도와 비용이 함께 좋아지는 방향성은 참고할 만합니다.
▲ 두 agent의 비용 차이
Oracle이 제시하는 구현 요소
이 설계론은 intelligence plane이 control plane과 data plane 위에 놓이는 참조 아키텍처를 제시하고, Oracle의 제품을 agent memory, Deep Data Security, 프라이빗 추론 컨테이너, ontology와 semantic, 지속 학습과 감사라는 다섯 기둥에 대응시킵니다.
agent memory와 context card
Python 라이브러리 oracleagentmemory는 pip로 설치할 수 있으며, 사용자와 agent, memory, thread라는 단순한 primitive로 memory 공학을 추상화합니다. 도구 호출과 수정 내역이 섞인 긴 다중 턴 대화를 주제, 요약, 관련 정보, 관련 메시지 같은 구조화된 section으로 압축한 context card를 만들어 prompt에 주입합니다. 이 패키지는 LongMemEval benchmark에서 GPT-5를 high reasoning 설정으로 결합해 500문항 가운데 472문항을 맞혀 94.4%를 기록했습니다.
memory 기록은 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법) 데이터로도 쓰입니다. workflow 기록은 다단계 작업을 한 번에 처리하는 소형 planner와 도구 호출 모델을, memory 단위 기록은 새 context를 보존할지 잊을지 민감 정보로 표시할지를 밀리초 안에 분류하는 decision model을, 분석가의 수정과 피드백은 reranker와 답변 모델을, 추출된 entity memory는 전용 entity 추출 모델을 학습시킵니다.
데이터베이스 안의 권한 집행
Deep Data Security는 애플리케이션 수준 필터 대신 데이터베이스 안에서 보안을 집행합니다. 최종 사용자가 agent에게 질문하면 그 사용자의 OAuth2 token이 agent harness를 거쳐 데이터베이스 층까지 전달되고, SQL 실행 시점에 셀, 행, 열 단위 정책이 평가되어 권한 없는 레코드는 검색 전에 결과에서 빠집니다. Desk A만 허가된 분석가가 거래 상대방 익스포저를 물으면 Desk B 행과 마진 열이 제거되는 반면, 두 desk 모두 허가된 분석가는 전체를 조회할 수 있습니다. memory도 같은 보안 context 아래 데이터베이스에 저장되므로 회상된 memory card 역시 동일한 권한을 따릅니다. 개발자가 agent 신원을 서로 다른 외부 제공자에 흩어 두는 대신 데이터베이스까지 곧바로 전달해야 한다는 지적이 여기에 붙습니다.
프라이빗 추론과 지속 학습
금융처럼 엄격한 프라이버시 경계가 필요한 산업을 위해 Private AI Services Container가 제공됩니다. vLLM이나 llama.cpp 기반 LLM 추론, embedding, reranking, 텍스트 분류 모델을 OpenAI 호환 REST endpoint 뒤에 묶어 온프레미스나 망 분리 환경에서 돌릴 수 있고, Oracle AI Database는 DBMS_VECTOR_CHAIN이나 UTL_TO_GENERATE_TEXT 같은 함수로 SQL 안에서 이 모델을 직접 호출합니다. 관리형 클라우드를 쓰는 팀을 위해서는 OCI Generative AI가 전용 AI cluster에서 모델 fine-tuning과 hosting을 제공합니다.
오픈소스 지속 학습 시스템 Memoriaz는 작은 open-weight 모델에게 memory plane 관리를 가르칩니다. 대시보드에는 memory routing, memory embedding, memory reranking이라는 세 가지 fine-tuning 구성 요소가 있고, 대화 기록으로 fine-tuning한 Qwen 기반 decision model이 LLM 출력이나 대화 스트림을 대화 memory와 workflow memory 가운데 어디로 보낼지 분류합니다. 이 모델은 소비자용 Apple silicon GPU에서 밀리초 단위로 동작하며, 대시보드에서 routing 85.6%, reranking 98.2% 같은 정확도와 loss 곡선, epoch별 정확도를 확인한 뒤 배포합니다. 비정형 context를 계속 frontier LLM에 보내는 것보다 지연과 비용을 크게 줄일 수 있다는 것이 핵심입니다.
지속 학습은 세 단계로 나뉩니다. 데이터베이스 안에서 memory를 다루는 truth space, KV 상태를 prompt caching하는 latent space, LoRA/QLoRA로 fine-tuning하는 weight space입니다. 수집된 memory 기록은 분류로 걸러지고, fine-tuning과 gate benchmark 평가를 거쳐 ONNX runtime으로 운영 데이터베이스에 다시 배포됩니다.
no-code agent 제작과 schema 보강
Private Agent Factory는 입력, prompt, 모델, 출력 블록을 끌어다 연결하는 시각적 canvas에서 거버넌스가 적용된 agent를 만들게 합니다. AI schema enrichment 도구는 기업 데이터베이스 테이블을 검사해 열 설명과 의미 주석을 schema 메타데이터에 자동으로 써 넣습니다. Oracle AI Database는 관계형 테이블 위의 SQL property graph와 RDF knowledge graph를 결합해 모회사와 자회사의 LEI 소유 구조 같은 기업 ontology를 만들고, 순 익스포저 계산 같은 업무 정의를 semantic 층에서 통일해 모든 agent와 모델이 같은 수치를 내게 합니다. 금융에서는 컴플라이언스 오류가 $1억 규모의 규제 벌금으로 이어질 수 있는 만큼, 명시적 ontology로 hallucination(사실과 다른 내용을 그럴듯하게 생성하는 현상)을 막는 일이 필수라는 설명입니다.
지금 할 일 네 가지
이 설계론은 orchestration과 도구 guardrail에만 집중하는 팀이 더 중요한 차별점인 memory와 지능 구조를 놓치고 있다고 경고합니다. 수직으로 관통하는 intelligence plane이 없으면 다중 agent pipeline은 기본적인 실수를 반복하고 조직의 지식을 쌓지 못한다는 것입니다. 또 memory를 외부의 블랙박스에 맡기지 말고 조직이 완전히 소유해야 경쟁력이 지켜진다고 강조합니다. 모델 scaling은 여전히 유효하지만 더 이상 agent 설계를 이끄는 유일한 힘은 아니라는 판단도 함께 제시됩니다.
실무 팀이 당장 시작할 수 있는 일은 네 가지로 정리됩니다.
- memory를 정식 데이터로 다룹니다. 원본 업무 레코드와 같은 데이터베이스에, 같은 컴플라이언스와 보존 규칙 아래 저장합니다.
- 업무 entity, 지표, ontology를 먼저 정의합니다. agent가 schema 의미를 추측하게 두는 것은 중요 업무에서 위험합니다.
- 권한을 데이터베이스 층으로 내립니다. 검색과 memory cache가 행과 열 단위 접근 규칙을 자연스럽게 물려받게 합니다.
- 실행 기록을 지금부터 남깁니다. 사용자 상호작용, 작업 순서, 사람의 수정 내역이 나중의 fine-tuning 데이터가 됩니다.
여기에 control plane의 책임(신원, 지출 한도, kill switch, 감사 기록)과 intelligence plane의 책임(도메인 지식, episodic context, 영속 memory)을 분리해 설계하고, 정확 일치 cache와 semantic cache를 함께 두며, 규칙 기반 guard를 특화 소형 모델로 바꿔 가는 접근이 더해집니다. 모델이 평준화된 환경에서 agent가 무엇을 알고 기억하고 볼 수 있는지를 설계하는 층을 조직이 직접 소유하는 것, 그것이 이 설계론이 말하는 경쟁력의 출처입니다.


