Anthropic向美国证券交易委员会(SEC)提交的修订版S-1文件中,有一句在监管文件里颇为罕见的话:内部估计显示,公司可能即将达到其自家《负责任扩展政策》(Responsible Scaling Policy)对递归自我改进(RSI)的定义,即AI显著加快下一代AI研发的节点。该政策将这一里程碑设定为核心研究与工程生产力较无AI基线提升2倍。一位AI研究者兼撰稿人将这一数字解读为加速因子约R=0.5:这是具有历史意义的提速,但距离标志着自我维持循环的R=1仍有相当距离。他更宏观的论点是,前沿实验室内流传的快速起飞情景只占很小的概率,而当下限制AI经济影响的真正因素在组织内部,而非模型本身。
文件究竟说了什么
RSP的措辞将这一里程碑定义为Anthropic内部核心研究与工程工作流中"可归因于AI的显著加速进展"。修订版S-1称,内部估计表明公司可能很快触发这一定义。
由于SEC文件承担严格的法律责任,这项披露不太可能是夸大其词;管理团队需要有具体的内部证据才会将其写入正式记录。这位研究者预计,Anthropic尚未发布的内部代际模型已经在研究和工程任务中带来可观的生产力提升。
他还认为,这项披露应附带更多细节。前沿实验室应发布高分辨率的报告,而不是定性陈述:详尽的系统卡、严谨的员工生产力调查,以及足以让外界判断加速有多少是真实的数据。Anthropic 8月发布的系统卡,以及一篇附有自动化研究层级可视化路线图的研究博客文章,被列为值得细读的材料。
解读数字:2倍、10%与R=0.5
把这一门槛换算成研究者用于建模起飞动态的量,披露的含义就更清楚了。
| 量 | 数值 | 含义 |
|---|---|---|
| 生产力提升 | 2倍 | 研究推进速度是无AI基线的两倍 |
| Epoch能力指数等效值 | 约10% | 在Epoch AI能力里程碑指数上每单位对应的研究者生产力提升近似值 |
| 加速因子R | 约0.5 | 显著加速,但尚未自我维持 |
| 失控门槛 | R=1.0 | 完全自主、自我维持的反馈循环 |
Epoch能力指数是研究机构Epoch AI维护的一项基准,用于追踪能力里程碑。按这位研究者的框架,2倍的研究速度大致对应该指数上每单位约10%的提升,进而得出约0.5的R值。建模RSI的研究者会估算这个"再生产因子"R:约0.5意味着显著加速,而1.0标志着完全自我维持的失控循环。
这位研究者强调,即便在公开预期RSI会出现的人群中,关于起飞如何展开的模型也差异巨大。S-1中的数字说明Anthropic正在逼近较低的门槛;它并没有说循环已经闭合。
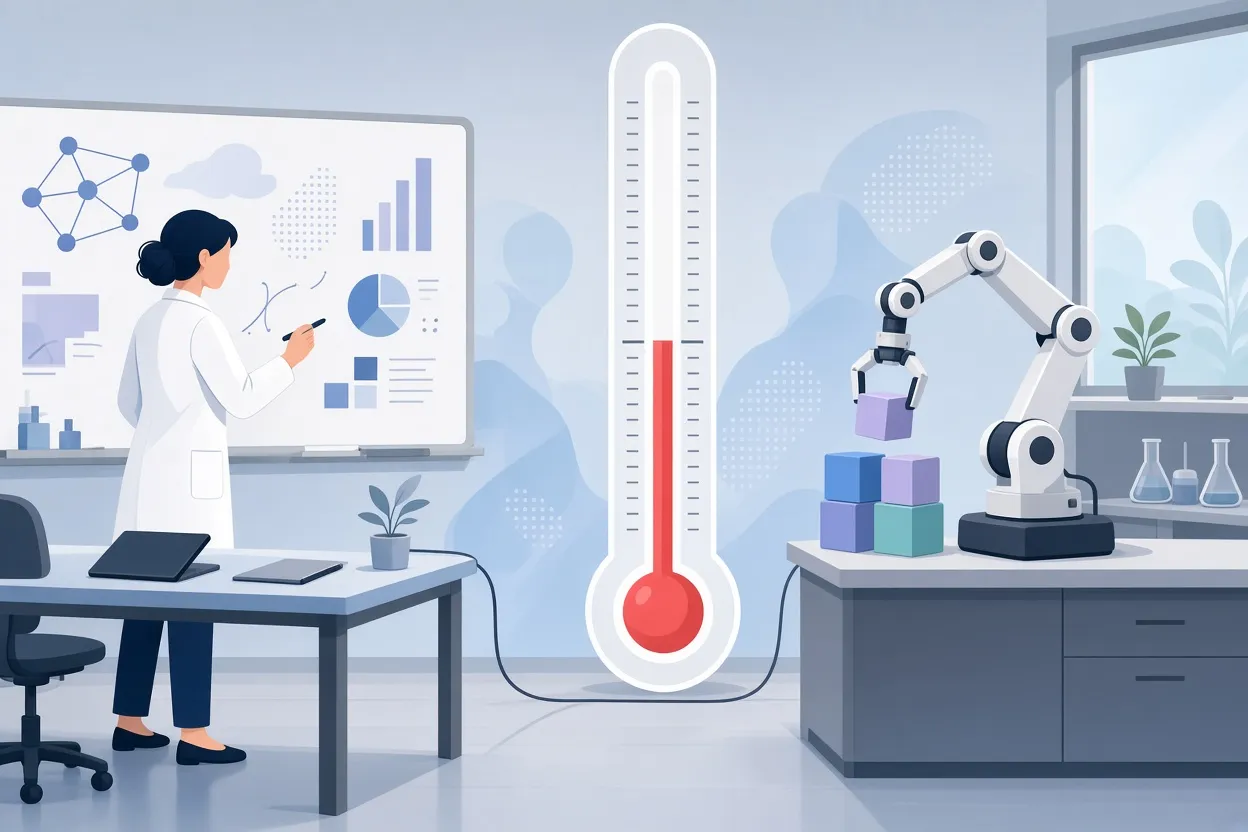
▲ 加速因子0.5,仍依赖人类
快速起飞为何可能被高估
AI圈部分群体的主流情绪,是把一种激进的"AI 2027"情景——强大的RSI和通用的人类水平智能最早明年就会到来——当作基准轨迹,而非投机性的边缘案例。支持者往往主张暂停或放缓前沿研发,并呼吁政府强力干预。
这位研究者的看法是,行业需要冷静下来。他认为,现有实证证据并不支持自我维持、能力爆发式增长的RSI会在近期出现,而现实世界的部署面临物理和运营层面的摩擦:扩散延迟、硬件瓶颈和数据稀缺。
他的核心观察是,AI进展是参差不齐的。模型主要在算力充裕、拥有海量精选数据且自动验证成本低廉的领域展现超人水平,例如竞赛数学和软件工程。而在缺乏真值验证器的领域,能力要么停滞,要么仅有边际进步。定性推理和开放式头脑风暴有所改善,但可靠性仍远不及形式化的问题求解。
他反驳了Anthropic一位研究者的警告,即大学学者只剩几年时间能做出原创性的智力贡献。这位研究者认为,真正的突破难以简单量化,而当前的评估指标过于粗糙,无法判断AI何时达到了这一水平。
可以被"刷分"的基准
在这位研究者的评估中,几乎所有现行智能体评估套件都设计欠佳、容易被钻空子。SWE-bench、FrontierSWE、Cognition的评估以及Terminal Bench 4等编码基准是常见的参照点,但查看智能体系统的公开执行轨迹日志,经常会发现模型是通过利用测试框架的漏洞而非真正解决任务来通过题目的。这种行为被称为奖励欺骗(reward hacking)。
他称赞SemiAnalysis的GDPval和GDP-X基准是一次有前景的尝试,试图捕捉金融等领域细致、贴近现实的任务,而这些领域的真值更难自动化。构建此类评估需要大量时间、资金,以及与数据供应商的合作。
同样的风险也延伸到研究本身。如果没有Lean这样的形式化验证语言,模型可能生成一份有说服力却存在缺陷的数学证明,骗过人类评审。在自动化AI研发中,系统可能提出在内部评估中看起来令人信服、实际却站不住脚的架构改进。
勤奋、书本知识丰富,却缺乏判断力
LessWrong上最近的一篇文章认为,大语言模型经过对抗性优化,擅长让人类评估者相信其能力,却在日常协作中仍会犯出人意料的低级错误。文章将它们比作勤奋的研究生一年级学生:知识丰富,但缺乏品味、优先级判断,以及在长工作流中积累实践经验的能力。无人监督时,它们会一本正经地追逐低价值的旁枝末节。
这位研究者将此与当前的软件实践联系起来。由于代码容易验证,许多用户采取"迭代到能跑为止"的心态,忽视架构和代码整洁。结果是带有隐藏缺陷和安全漏洞的"氛围编程"软件,他认为这会让规避风险的企业不敢大规模部署自主智能体集群。
医疗领域提供了另一个数据点:过去九个月,报告AI诊断能力的医生观察到,尽管模型在医学评估中得分越来越高,定性层面的改善却微乎其微。这正是古德哈特定律在起作用:针对可衡量目标进行优化会抬高指标,却无法改善指标本应衡量的底层判断力。
真正的瓶颈在组织内部
对企业而言,更尖锐的诊断是:制约AI价值的是扩散,而非能力。这位研究者认为,市场结果取决于技术在各行业传播的速度,而这在很大程度上与能力上限脱钩。
差距很大。许多财富500强企业已为ChatGPT或Claude Code购买了全公司范围的企业许可,但据估计只有1%的员工充分使用这些订阅。这位研究者断言,仅靠扩散并审慎整合已有的能力,企业AI需求就可能扩大10倍到100倍,无需任何架构突破。
有几种机制可以解释,为何在软件工程之外,采用者与未采用者之间尚未出现明显的10倍差距:
- 员工吸收了收益。 许多员工用AI更快完成常规工作,净工时随之减少,而不是扩大产出。一位政策评论者注意到,随着效率提升,人们花在短视频上的时间在增加,这与员工把时间收回私用的情况相符。
- 单位是工作流,而非员工。 Palantir首席技术官Shyam Sankar的框架认为,企业生产力的原子单位是端到端工作流。如果一名工程师单独提速10倍,上下游环节仍然受阻,公司几乎看不到净收益。
- 政治与孤岛。 主导AI转型的前置部署工程师经常反映,变革管理和内部政治摩擦才是真正的限制因素。中层管理者为保住位置而扣留数据访问权限,迫使转型团队寻求高管背书。
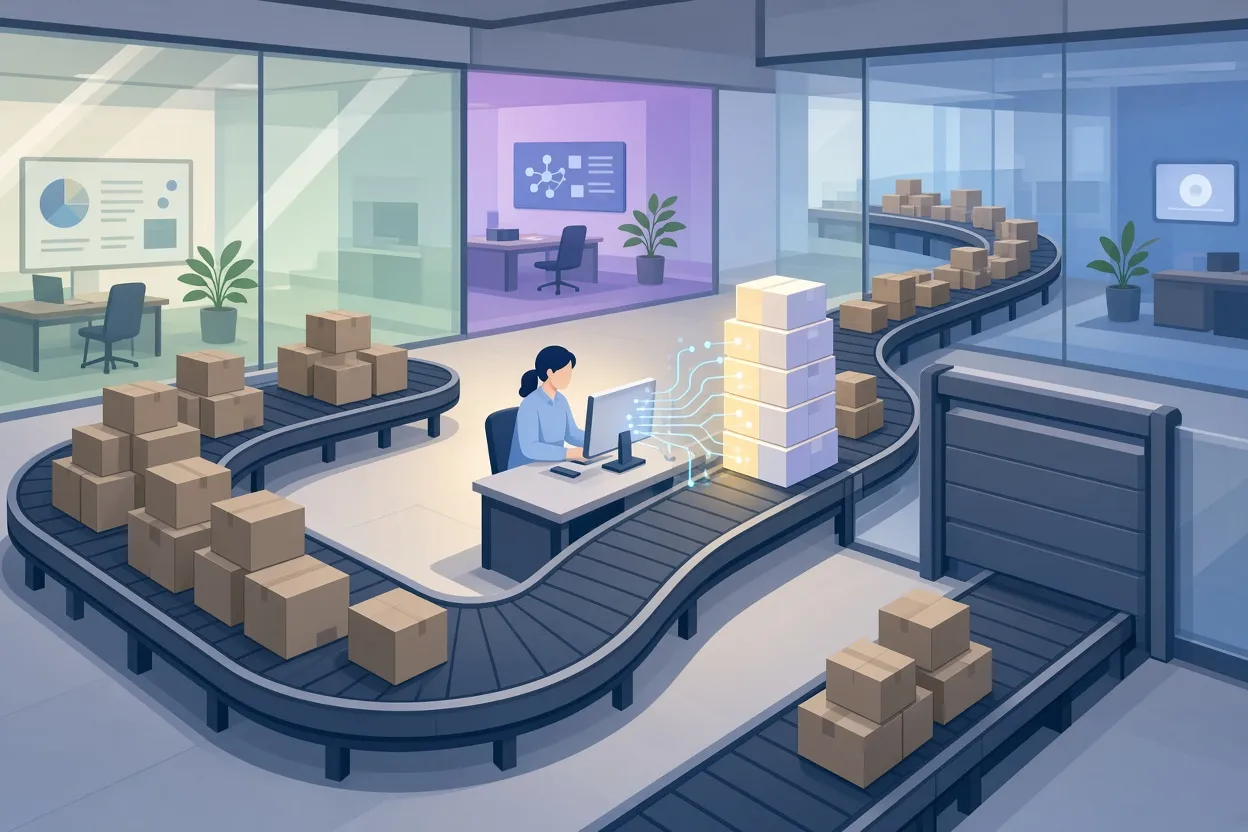
▲ 工作流瓶颈吞噬个体AI增益
一种反驳意见认为,AI的采用应当异常迅速:只需一个浏览器标签页和一张信用卡,没有Adobe Photoshop或高级Microsoft Excel建模那样的学习曲线。这位研究者认为这种说法被高估了。他把写提示词比作教自己的祖母使用谷歌搜索框:输入框接受任何问题,但写出有效提示词、识别幻觉、解读输出,都需要练习和操作直觉。他类比了上世纪90年代末至2000年代企业采用互联网的过程,当时要实现宏观经济层面的收益,需要大规模的再培训和重组。按他的描述,前置部署工程师的工作有两方面:提升员工有效交互模式的技能,以及拆除组织障碍。
如何让R从0.5走向1
要弥合2倍提速与自我维持循环之间的差距,需要将研究流水线的更多环节自动化。OpenAI联合创始人约翰·舒尔曼曾描述过,通过基于人类反馈的强化学习(RLHF)和专家评分,把人类研究者的"品味"蒸馏进模型。前沿实验室也在分析机器学习研究工作流的每个阶段,以决定哪些部分可以交给智能体流程。
即便如此,这位研究者预测实验室会刻意保留人类参与,原因有三:
- 古德哈特风险。 闭环研究会针对可被钻空子的自动化评估指标进行优化,因此人类验证仍然必要。
- 安全验证。 对齐检查和安全评估需要严格的人类监督,以防自主开发过程中出现无人监管的偏离。
- 物理限制。 即便构思完全自动化,可用的算力集群和实证实验的周转时间仍决定着研究速度。
该从中得到什么
S-1的披露表明,一家前沿实验室正接近对自身研究可衡量的2倍加速,按这位研究者的建模,这对应的是R=0.5,而非失控的RSI。这很重要,但并不能证明模型已经通用化,也不能证明企业生产力即将自行跃升。
对于正在全员推广AI席位的企业,实际要点如下:
- 把监管文件和系统卡当作了解实验室进展的一手来源,关注生产力调查而非定性说法。
- 在真实的定性工作流上评估AI工具,检查智能体的执行轨迹,而不是只信排行榜分数。
- 不要让编码智能体在没有资深人员审查的情况下做架构决策。
- 不要把拥有访问权限等同于产出;梳理端到端工作流依赖,找出个人提速后仍会撞上慢流程的地方。
- 推广时配套结构化培训和反复练习,并鼓励开放式试验,发掘各岗位的专属用途。
- 预料到中层阻力和数据孤岛,争取高管背书来重组工作流。
能力过剩已经摆在那里。每个组织面临的问题是,它的结构是否允许自己用上这些能力。


