OpenAI已将其主单体代码仓库(monorepo)的后端替换为Pando,这是一套自研的、与Git兼容的存储系统,专为成千上万个AI编程智能体全天候推送、合并和拉取代码的场景而设计。根据该公司于2026年11月2日发布的题为《Scaling Git at OpenAI: Building agentic-scale source control while investing in the Git ecosystem》的白皮书,随着提交量攀升——预计到2026年第四季度将比2024年第一季度增长2,442%——旧系统已开始失效。白皮书称,Pando将推送延迟中位数降低了近5倍,把合并基础设施的可靠性提升至99.99%,如今每天提供的Git数据接近1PB。
更值得关注的是OpenAI如何走到这一步。团队没有在一个无法扩展的设计上继续堆服务器,而是抛弃了两条大多数工程师视为版本控制系统不可动摇的假设。下文将说明旧架构为何崩溃、Pando的不同之处,以及这一思路对所有即将被AI智能体高强度冲击的基础设施运维者意味着什么。
当智能体永不下班
Git诞生于二十多年前,最初是为了帮助Linux内核开发者通过电子邮件交换补丁。这种模式很适合人类团队:工程师大致按线性方式工作,有上班时间,也会休息。OpenAI的代码生成模型Codex改变了这种工作负载的"物理规律"。成群的自主智能体并行、持续地运行,没有工作时段的概念。它们不断创建分支、密集推送提交、频繁合并,并通过CI/CD流水线和研究实验触发源源不断的克隆与拉取流量。
白皮书中的一张图表显示,OpenAI单体仓库中每季度落到master分支的提交量,自2024年第一季度的基线起呈指数曲线增长,到2026年第四季度达到2,442%的增幅。原有基础设施不堪重负:拉取变慢、推送停滞、合并失败。另一张追踪37个工作日内合并基础设施每日成功率的图表显示,该比率多次跌破90%,导致全公司的开发流程陷入停顿。
为什么标准方案行不通
在动手打造新系统之前,OpenAI对两种运行分布式Git后端的常规方案进行了建模。两者在高并发下都失败了,而失败的原因颇具启发性。
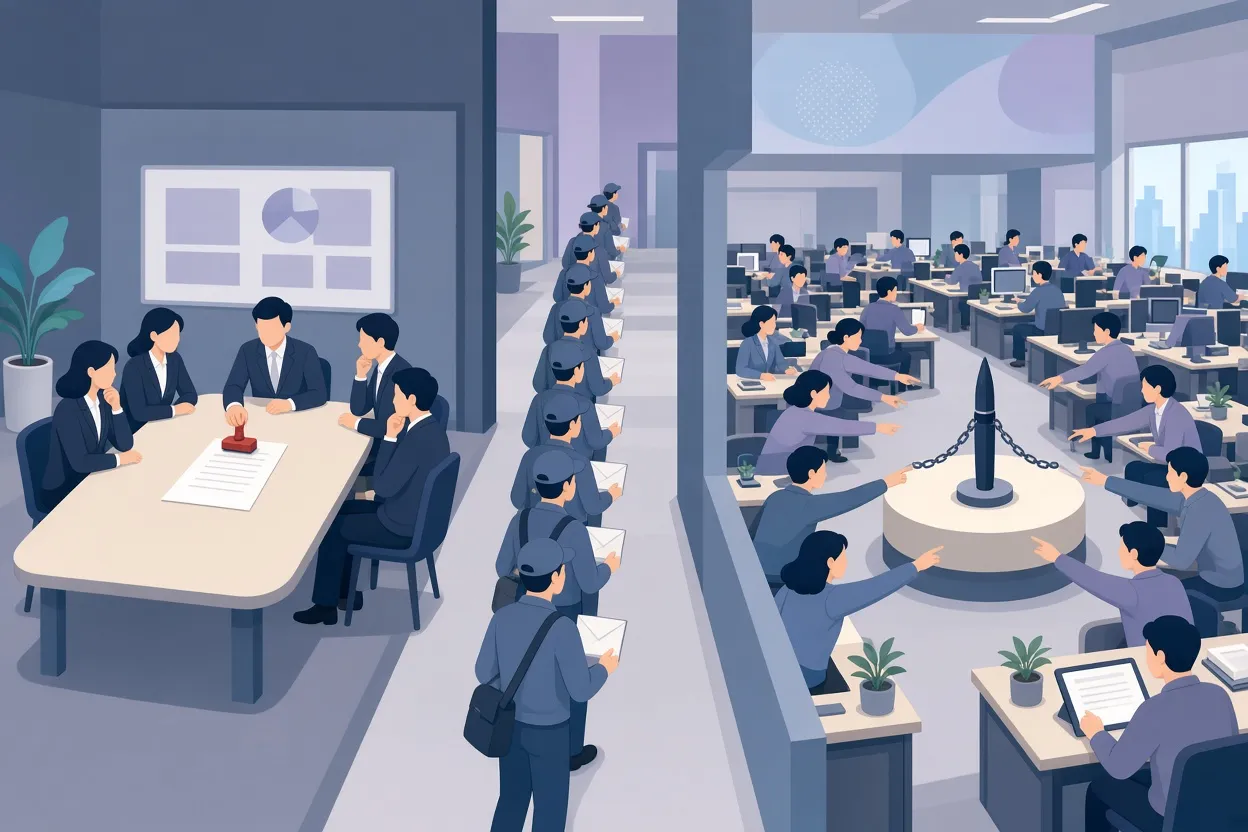
三阶段提交:委员会
第一种方案是三阶段提交(3PC),这是一种共识协议:传入的packfile(Git压缩打包的对象集合)会并行复制到每个副本,但每次更新只有在多数副本步调一致地达成一致后才能提交。效果就像一个公司委员会,必须审阅并盖章同一份文件才算定稿,而后续所有请求都在走廊里排队等候。写操作因此变成严格串行。更糟的是,3PC无法水平扩展:增加副本意味着更多节点需要参与共识,协调轮次随之拉长,延迟不降反升。
预写日志:唯一的一支笔
第二种方案是基于中央Blob存储的共享预写日志(WAL)。在这里,packfile并行上传到共享存储,引用更新则通过原子比较并交换(CAS)操作记录在一个中央清单中——只有在没有其他人抢先修改清单时才会成功。这幅画面就像许多动作飞快的写手共用一支笔在同一本账簿上签名。如果另一个智能体早几毫秒提交,CAS就会失败,写入方必须拉取最新清单、重新验证自己的更新,然后重试。在智能体负载下,对清单的争用会引发重试风暴和排队延迟。WAL设计并没有消除瓶颈,只是把瓶颈挪了个地方。
一场差距悬殊的模拟
OpenAI发布了一个交互式模拟,对比三种设计在1,000个并发写入者下的表现。白皮书将其定位为教学模型而非生产基准,但差距依然惊人:
| 架构 | 完成1,000个写入者耗时 | 推送到拉取的平均延迟 |
|---|---|---|
| 三阶段提交 | 56.52秒 | 4.63秒 |
| 对象存储WAL | 96.26秒 | 6.38秒 |
| Pando | 7.71秒 | 0.47秒 |
Pando抛弃的两条假设
在断定标准的分布式系统模式不足以解决问题后,团队对Git后端设计的两块基石提出了质疑。
假设一:仓库级一致性
传统Git服务器保证每次拉取都能看到覆盖所有引用的、全局统一的某一时间点快照。Pando放弃了这一保证,转而采用因果一致性,只对单个引用施加严格可串行化。通俗地说,对任何单一分支的更新都会被排进一条清晰的时间线,但系统不再协调互不相关的分支之间的顺序。
OpenAI认为这恰恰反映了工程师的真实工作方式。一个正在向UI功能分支反复推送改动的人,并不关心50个毫不相干的数据库迁移分支之间微秒级的先后顺序。他们关心的是自己的分支包含自己的提交,以及将要合并进去的主干是准确的。白皮书称之为"局部真相",以区别于代价高昂、需要全局协调的真相。两名开发者可以同时看到"alpha分支为v1、beta分支为v2"和"alpha分支为v2、beta分支为v1",而完整性丝毫不受损。推送冲突只在两个客户端同时向完全相同的引用推送时才会发生,而且由于不存在全局推送锁,互不相关的分支写入可以完全并行。
对大多数资深开发者来说,放弃全局一致性听起来令人不安,而白皮书的立场是,这种不安并无必要,因为真实的工作流并不依赖跨分支的快照顺序。
假设二:为每个客户端定制packfile
在标准的Git推送中,服务器就像一个把整手牌全部亮出来的扑克玩家:它通告每一个分支及其当前提交,当服务器拥有数百万个分支时,这份列表可能超过100MiB。客户端检查这份列表,精确计算出服务器缺少哪些对象,然后构建一个高度压缩的packfile。这种设计源自带宽稀缺的年代,因此不惜消耗CPU和磁盘I/O来把字节数压到最低。在服务器端,为每个客户端动态重新打包或计算定制增量会消耗巨量资源,而且由于每个packfile都只对应某个客户端某一瞬间的状态,没有任何东西可以缓存或复用。每次拉取都从零开始。
Pando则把牌捂得很紧。它只通告一个指定的主干分支(例如main),客户端以该主干基线为参照计算自己要上传的packfile。代价在于,一个向自己分支反复推送提交的客户端,可能会重复发送尚未进入主干的中间提交,从而多耗一些上传带宽。OpenAI的生产数据表明这一代价很小:单体仓库中推送packfile的中位数不到20KB,第99百分位不到3MB。作为交换,服务器永远不需要重新打包。
写路径与读路径
由于packfile是基于共享基线而非某个客户端的独特状态构建的,它们不再是一次性产物。Pando的写路径接收这个约20KB的文件,将其写入不可变的Blob存储,更新元数据,然后结束。整个过程不进行任何重新打包计算,这使推送摄入变成一次O(1)的元数据写入——也就是说,其成本不会随仓库规模或负载增长。
读取的方式也不同。当客户端拉取某个分支时,Pando返回的是一组packfile URL列表,而不是计算一个增量包。这些流量经由Express流转——这是一个部署在OpenAI各运营区域的内部区域边缘缓存层,同时缓存Blob存储和元数据。OpenAI称缓存命中率超过99%,这让普通的云虚拟机在克隆和拉取时能够跑满10Gbps网络链路,而中央服务器几乎不消耗CPU。
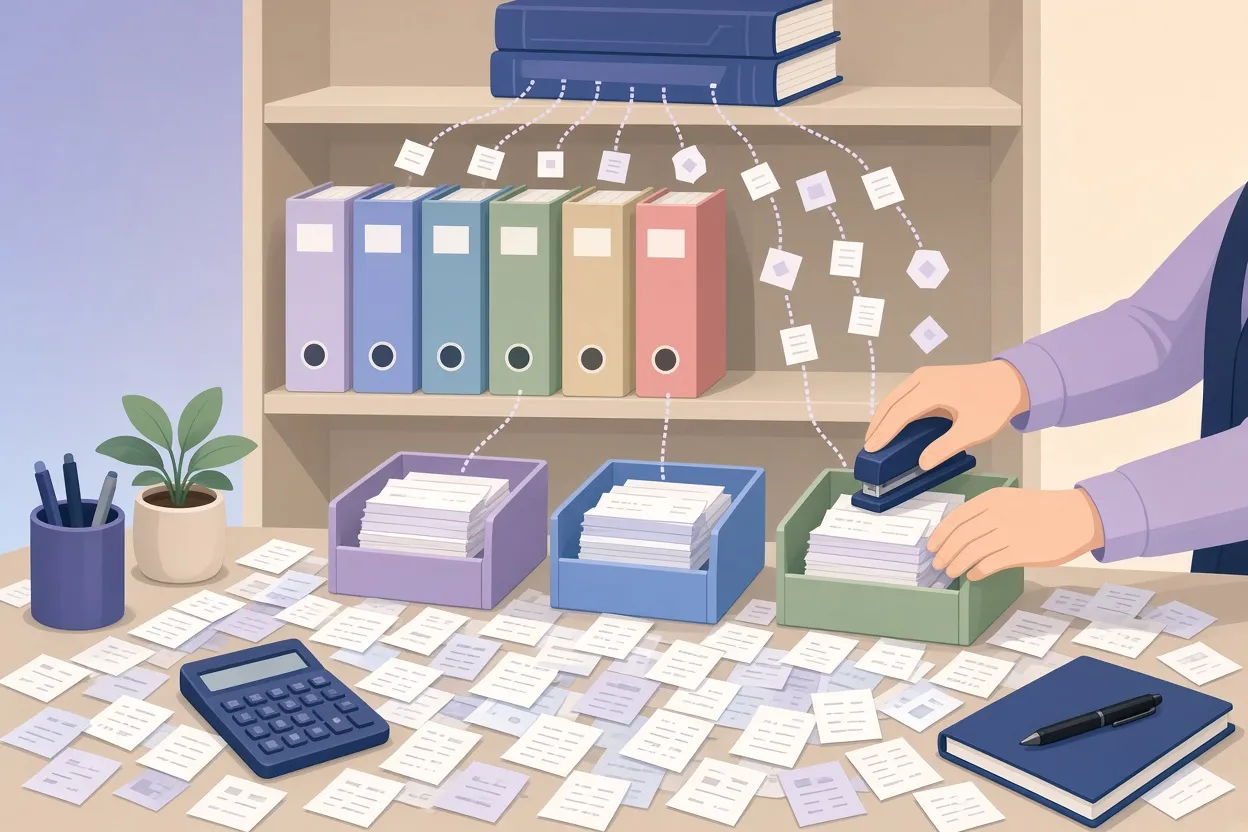
▲ Pando从L0到L4的分层压实
压实:别让收据堆成山
把每次推送都存成一个独立的小型不可变文件,会招来"小文件膨胀"。一名离开两周后回来的工程师,可能要面对数万次独立的packfile下载——白皮书用5万这个数字来说明。Pando用一套以LSM树为蓝本的后台压实(compaction)机制来解决这一问题;LSM树是数据库中常见的存储结构,会随时间把小规模写入合并成更大的有序文件。
用记账来打比方,各层级的运作方式是这样的:
- 第0层(L0):每次20KB的推送就像会计桌上的一张零散收据
- 第1层(L1):后台服务把成批收据装订成周报
- 第2层(L2):周报归入月度文件夹
- 第4层(L4):所有内容最终汇入年度总账
一个需要追赶进度的客户端只需少量近期的L0收据、几个L2文件夹和L4总账,而不是数千个零散文件。因此元数据读取按对数规模扩展,记作O(log delta):服务器只需查阅少量结构化索引,而不是扫描5万个文件,所以检索时间几乎不随数据量增长而上升。与传统Git服务器在重新打包后对旧packfile进行垃圾回收不同,Pando保留从L0到L4每一层的packfile,因而可以按所需粒度响应任何拉取,无需为按需重新压缩而停顿。压实以异步方式运行,不会给写入增加任何延迟。
由智能体构建,用数学验证,零停机部署
白皮书描述了一个不寻常的构建过程。Pando的核心架构由一名工程师设计,由多组使用Codex的智能体团队实现,并在10周内上线生产。它用Rust从零编写,没有任何遗留依赖,智能体的每项改动都通过定制的一致性测试套件与标准Git行为进行基准对照。
在正确性方面,OpenAI使用GPT-6 Astra智能体在Lean和TLA+中形式化了一套"Pando理论"——这两种规约语言将系统建模为数学状态机,并附带在每个状态下都必须成立的不变量。随后模型检查器模拟事件序列、延迟波动、并发推送和服务器故障,以证明这些不变量是否始终成立。在形式化证明之外,使用具备Daybreak能力的模型的智能体还借助确定性模拟测试框架持续对系统进行红队攻防,在上线前暴露竞态条件。让AI模型为分布式系统生成并检验形式化证明,看起来是超越"生成语法正确代码"的一步实质性进展。
切换本身采用了一个置于新旧两个后端之前的读写直通代理缓存:
- 推送时,代理把数据同时写入旧后端和Pando。
- 拉取时,代理先查Pando,命中则直接由Pando提供服务。
- 未命中时,代理从旧后端拉取、返回给开发者,并异步回填到Pando。
开发者使用Codex的自动化技能把本地环境和各项服务重新指向代理,无需手动编辑配置。在提交速率上涨约2,400%的情况下,这次迁移在数千名活跃工程师之间实现了零停机,堪比在施工队每天加盖2,000层的同时更换摩天大楼的地基。资深架构师可能会认出这种模式,它有"绞杀者模式"(Strangler Fig)之类的名字。
生产环境结果
| 指标 | OpenAI报告的结果 |
|---|---|
| 推送延迟中位数 | 降低近5倍,约减少80% |
| 合并基础设施成功率 | 切换后99.99%,此前多次跌破90% |
| 每日提供的Git数据 | 接近1PB |
| 峰值小时 | 超过57TB的packfile,其中超过99%来自本地磁盘缓存 |
| 服务器算力 | 寥寥几个CPU核心 |
把修复回馈给Git
Pando与开放的Git协议保持严格的线路兼容,而不是把开发者锁进专有工具。在这种规模下运行,暴露出了标准Git客户端在并发下载和中断传输清理过程中的一些隐蔽并发缺陷——这些边缘情况以人类节奏工作的团队似乎从未触及。OpenAI修复了它们,并把补丁贡献回上游。它还向上游提交了一项名为"explicit haves"的协议特性,允许服务器把分支顶端提交引用与packfile分开通告,使客户端能够针对主干历史进行推送和拉取(包括force-with-lease检查),而无需重新下载完整的树。
这意味着什么,以及该做什么
白皮书在结尾展望了大量智能体直接在共享仓库上协作的环境。在这种设想中,源代码控制不再是人类编辑的存档,而更接近一个实时的神经系统,智能体在其中持续地发明、测试、合并和演进软件。这样的未来是否会如描述般到来仍是一种预测,但其中的工程经验本身就站得住脚:
- 不要按人类的工作模式做设计。智能体流量是并行的、持续的、突发的。
- 高频写入要避免同步的多节点共识;增加节点只会更慢。
- 把单一的、受CAS保护的清单视为高并发下的咽喉要道。
- 追问客户端是否真的需要全局一致性,还是只需要按实体排序。
- 把客户端的增量计算锚定在一个静态的共享基线上;如果这能把服务器计算变成可缓存的不可变存储,多花几KB也值得。
- 采用异步分层压实,并保留每一层,而不是破坏性的垃圾回收。
- 在交付分布式系统之前,把Lean、TLA+等形式化方法与AI推理模型结合起来。
- 用读写直通代理来迁移关键基础设施,实现零停机。
对于运行Git服务器、CI系统或任何即将被编程智能体以机器速度冲击的共享存储的团队来说,切实可行的第一步是找出技术栈中那个"假设一次只有一个人"的部分,因为负载最先会在那里把系统压垮。


