OpenAI가 사내 monorepo(여러 프로젝트를 하나의 저장소에 담는 방식)를 떠받치던 Git 백엔드를 Pando라는 자체 시스템으로 통째로 바꿨습니다. 2026년 11월 2일 공개된 기술 백서 'Scaling Git at OpenAI'에 따르면, Codex 기반 coding agent 떼가 밤낮없이 branch를 만들고 push하면서 기존 인프라가 한계에 부딪혔고, 서버를 더 붙이는 대신 Git이 오랫동안 당연하게 여겨 온 전제 두 가지를 버리고 나서야 문제가 풀렸습니다. 전환 뒤 median push 지연은 약 80% 줄었고, merge 인프라 신뢰도는 99.99%로 올라갔으며, 하루에 거의 1PB에 이르는 Git 데이터를 소수의 CPU core로 처리하고 있습니다. 이 글은 백서가 설명한 붕괴의 원인, 실패한 대안, Pando의 설계, 전환 과정을 차례로 정리하고, agent 시대의 개발 기반시설이 어디부터 무너지는지 짚어 봅니다.
무엇이 무너졌나: commit 2,442% 증가와 90% 아래로 떨어진 신뢰도
출발점은 Codex였습니다. 사람 엔지니어는 근무 시간에 순차적으로 일하고 중간에 쉬지만, 자율 agent는 병렬로 쉬지 않고 움직입니다. agent가 개발 pipeline에 직접 들어오자 활성 branch, 자동 push, 연속 merge, 그리고 CI/CD와 연구 실험에서 쏟아지는 clone과 fetch 요청이 한꺼번에 불어났습니다.
백서는 2024년 1분기를 기준으로 monorepo의 master에 들어간 분기별 commit 수가 2026년 4분기에는 2,442% 늘어날 것으로 추정합니다. 기존 인프라는 이 부하 앞에서 fetch가 느려지고 push가 멈추고 merge가 자주 실패하는 식으로 무너졌습니다. 평일 37일치 데이터를 보면 merge 인프라의 일일 성공률이 여러 차례 90% 아래로 떨어졌고, 그때마다 회사 전체의 개발 흐름이 멈췄습니다.
Git은 20여 년 전 Linux kernel의 patch를 비동기 이메일로 주고받기 위해 만들어진 도구입니다. 사람 팀의 workflow에는 잘 맞지만, 수천 대의 기계가 매초 동시에 읽고 쓰는 규모는 애초에 상정하지 않았습니다.
서버를 더 붙여도 안 되는 이유: 3PC와 WAL의 실패
OpenAI는 먼저 분산 Git에서 흔히 쓰는 두 가지 구조를 검토했습니다.
Three-Phase Commit: 위원회 하나가 모든 결재를 맡는 구조
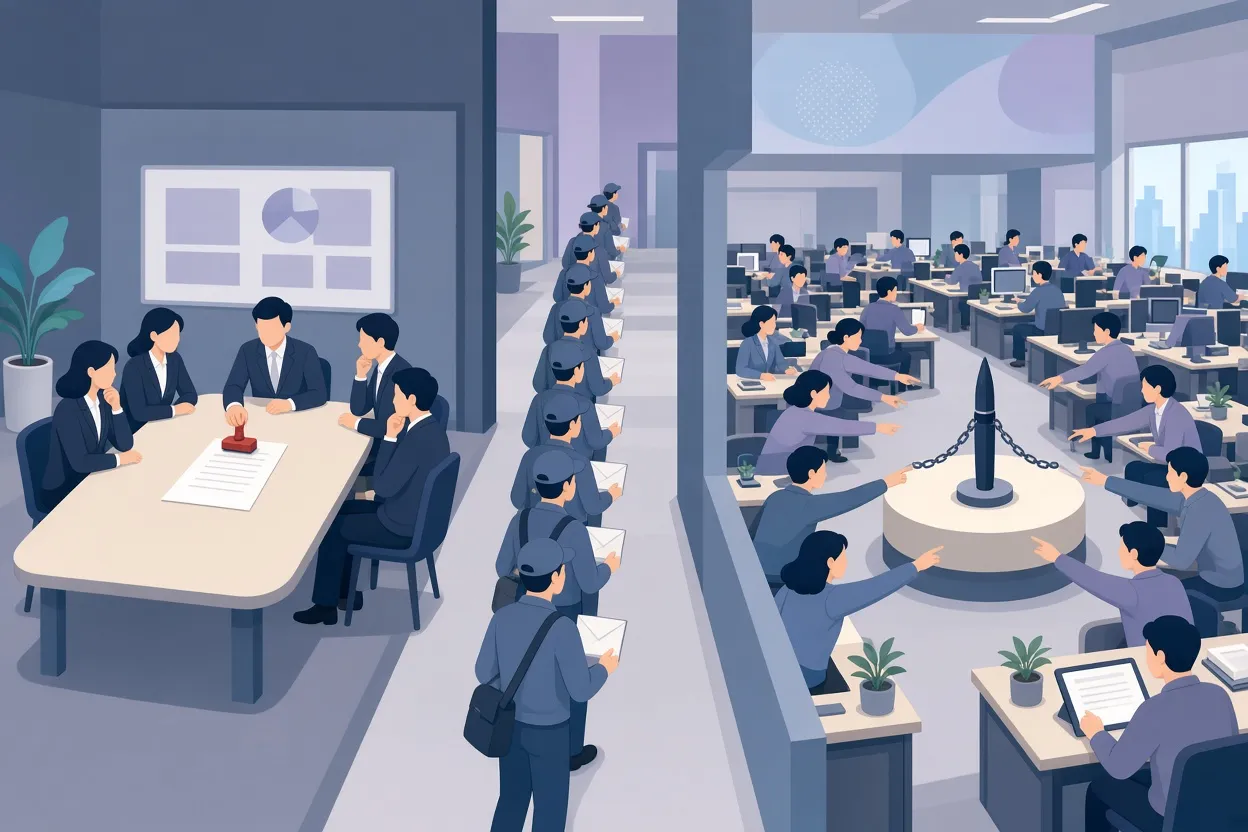
3PC(Three-Phase Commit, 여러 복제 노드가 단계적으로 합의해 갱신을 확정하는 protocol)에서는 들어온 packfile(Git 객체를 묶어 압축한 파일)이 모든 복제 노드에 병렬로 복사되지만, 갱신을 확정하려면 과반 노드가 엄격하게 보조를 맞춰 합의해야 합니다. 회의 탁자에 둘러앉은 위원 전원이 문서 하나를 검토하고 도장을 찍는 동안 다음 push들은 복도에서 줄을 서는 셈이어서, 쓰기 처리량이 한 번에 하나씩 처리되는 직렬 pipeline으로 묶입니다. 더 큰 문제는 노드를 늘려도 나아지지 않는다는 점입니다. 복제 노드가 늘면 합의에 참여해야 하는 노드도 늘어 지연이 오히려 나빠집니다. 수평 확장이 원리상 막혀 있는 구조입니다.
Write-Ahead Log: 펜 하나를 돌려 쓰는 장부
두 번째 대안은 중앙 blob storage(파일 덩어리를 저장하는 객체 저장소)와 공유 WAL(Write-Ahead Log, 변경을 먼저 기록해 두는 log)을 쓰는 구조입니다. packfile은 저장소에 병렬로 올리고, ref(branch 등 참조) 갱신은 공유 manifest에 기록하되 CAS(compare-and-swap, 예상 값과 같을 때만 바꾸는 원자적 연산)로 확정합니다. 글을 빨리 쓰는 사람이 수천 명이어도 공식 장부에 서명하는 펜은 하나뿐인 상황입니다. 누군가 몇 ms 먼저 서명하면 내 CAS는 즉시 실패하고, 최신 manifest를 다시 받아 내 갱신이 아직 유효한지 확인한 뒤 재시도해야 합니다. agent 부하에서는 이 재시도가 연쇄적으로 쌓여 대기 지연이 치솟습니다. WAL은 병목을 없애는 것이 아니라 옮겨 놓을 뿐이었습니다.
OpenAI가 공개한 시뮬레이션은 writer 1,000개가 동시에 push할 때 세 구조의 차이를 보여 줍니다. 다만 이 수치는 production 성능이 아니라 설명을 위한 합성 모델이라는 점을 감안해야 합니다.
| 구조 | 1,000개 쓰기 완료 시간 | 평균 push-to-fetch 지연 |
|---|---|---|
| Three-Phase Commit | 56.52초 | 4.63초 |
| Object-store WAL | 96.26초 | 6.38초 |
| Pando | 7.71초 | 0.47초 |
▲ 3PC와 WAL의 병목
버린 전제 1: 저장소 전체의 일관성 대신 branch별 순서
두 대안이 모두 실패하자 OpenAI는 Git 백엔드 설계의 전제 자체를 의심했습니다. 첫 번째로 버린 것은 저장소 전체 일관성입니다. 전통적인 Git 서버는 client가 fetch할 때 저장소의 모든 ref에 대해 같은 시점의 통일된 snapshot을 돌려준다고 보장합니다. 경험 많은 개발자일수록 이 보장을 포기한다는 말이 위험하게 들릴 것입니다.
Pando는 그 대신 causal consistency(인과적으로 연결된 작업의 순서만 보장하는 일관성 모델)를 채택하고, strict serializability(모든 작업을 단일 시간선 위에 순서대로 놓는 보장)를 개별 ref 단위로만 제공합니다. 백서는 이것이 실제 개발 방식과 정확히 맞아떨어진다고 설명합니다. UI feature branch에 push하는 엔지니어나 agent는 관련 없는 데이터베이스 migration branch 50개가 microsecond 단위로 어떤 순서로 바뀌는지 신경 쓰지 않습니다. 자기 branch에 방금 올린 commit이 들어 있고, merge 대상인 trunk branch가 정확하기만 하면 됩니다. OpenAI는 이를 비싸게 전역으로 맞춘 진실과 대비해 'localized truth'라고 부릅니다.
그 결과 개발자 1은 branch alpha를 v1, beta를 v2로 보고 개발자 2는 alpha를 v2, beta를 v1로 보는 상황이 동시에 생길 수 있지만, 시스템 무결성에는 문제가 없습니다. 전역 push 조정과 공유 commit lock이 사라지므로 관련 없는 branch의 쓰기는 완전히 병렬로 진행되고, push 충돌은 두 client가 정확히 같은 ref에 동시에 push할 때만 일어납니다.
버린 전제 2: client별 맞춤 packfile 대신 trunk 기준 고정
두 번째로 버린 것은 client마다 고유한 packfile을 동적으로 만드는 방식입니다. 기존 Git 서버는 push나 fetch 협상 때 자기가 가진 ref를 전부 공개합니다. branch가 수백만 개면 ref 광고만으로 100MiB를 넘길 수 있습니다. client는 그 목록을 보고 서버에 없는 객체만 골라 작게 압축한 맞춤 packfile을 만듭니다. 대역폭이 귀하던 시절에는 합리적인 설계였지만, 서버 쪽에서는 CPU와 disk I/O를 많이 쓰고, 그렇게 만든 packfile은 그 client의 그 순간 상태에만 맞으므로 다른 client를 위해 재사용하거나 cache할 수 없습니다. 다음 fetch가 오면 처음부터 다시 계산해야 합니다.
Pando는 패를 보여 주지 않는 포커 선수처럼 행동합니다. 수백만 개의 branch 대신 지정된 trunk branch(예: main) 하나만 광고하고, client는 그 trunk를 기준으로 packfile을 계산합니다. 자기 branch에 commit을 쌓아 가며 push하는 경우 trunk 밖에 있는 이전 commit을 다시 보내게 되어 업로드 용량이 조금 늘어나는 단점이 있습니다. 그러나 OpenAI monorepo의 production 데이터에서 이렇게 만든 push packfile의 median은 20KB 미만, 99번째 백분위도 3MB 미만이었습니다. 서버의 동적 repack을 없애는 대가로는 작은 비용으로 보입니다.
이 선택은 읽기와 쓰기 양쪽을 바꿉니다.
- 쓰기: packfile이 특정 client 상태에 묶인 일회용 파일이 아니므로, 서버는 받은 파일을 그대로 immutable blob storage에 쓰고 metadata를 갱신하면 끝입니다. push 수용이 O(1) metadata 쓰기가 됩니다.
- 읽기: fetch 요청에 delta를 계산해 주는 대신 packfile URL 목록을 돌려줍니다. client는 OpenAI의 각 운영 지역에 배치된 edge cache 계층 Express에서 파일을 직접 받습니다. Express는 blob storage와 metadata를 함께 cache하며 hit rate가 99%를 넘고, 일반 클라우드 VM이 10Gbps 네트워크 링크를 포화시키는 동안 중앙 서버의 CPU 부하는 거의 없습니다.
▲ 다단계 compaction의 구조
작은 파일 더미를 정리하는 방법: 다단계 background compaction
push마다 20KB짜리 파일을 하나씩 남기면 수백만 번의 자동 commit 뒤에는 작은 파일이 넘쳐납니다. 2주 휴가에서 돌아온 개발자가 5만 개의 packfile을 따로따로 내려받아야 한다면 로컬 머신이 감당하지 못합니다.
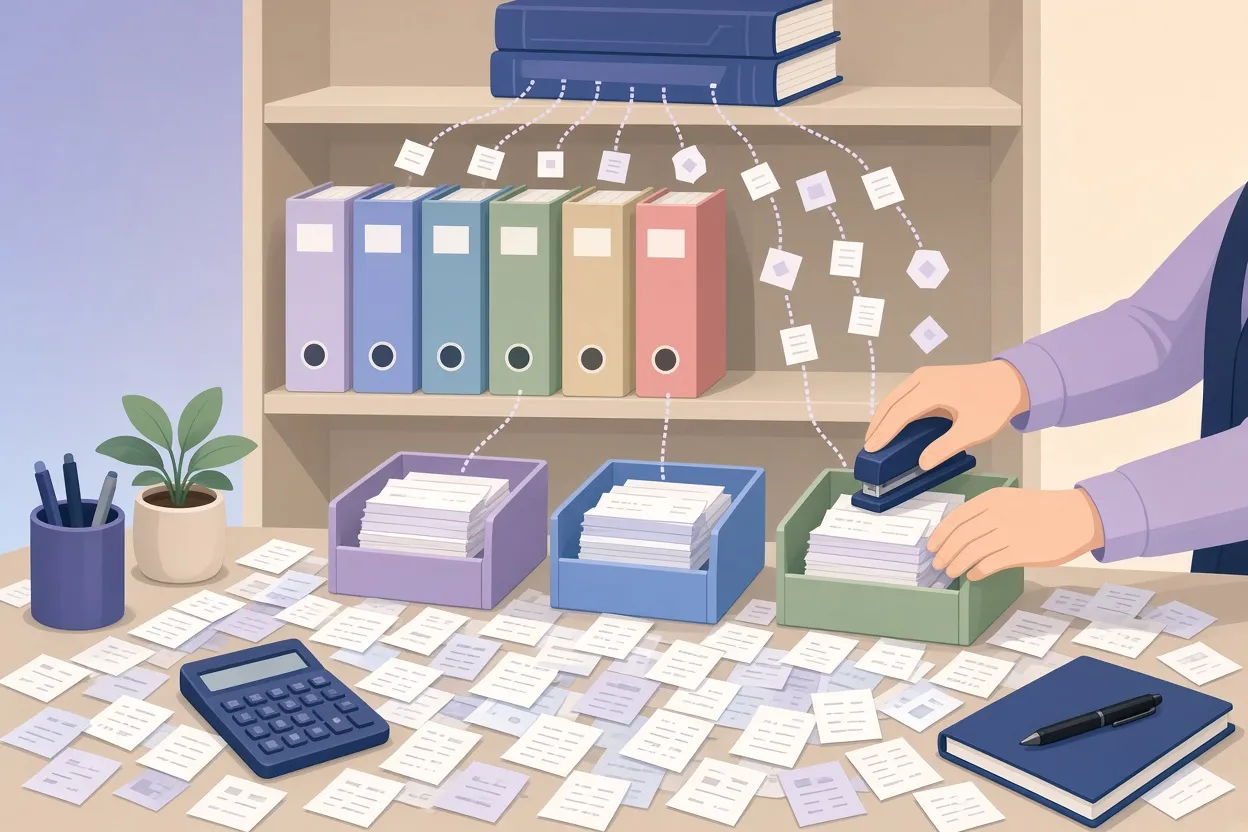
OpenAI는 LSM-tree(쓰기를 작은 단위로 받고 background에서 합쳐 가는 저장 구조)와 비슷한 다단계 compaction으로 이를 해결했습니다. 백서는 이를 회계 장부에 비유합니다.
| 단계 | 비유 | 내용 |
|---|---|---|
| L0 | 책상 위의 낱장 영수증 | push마다 생기는 약 20KB packfile |
| L1 | 주간 요약 | background 서비스가 L0 묶음을 합친 파일 |
| L2 | 월간 바인더 | L1을 다시 합친 파일 |
| L4 | 연간 장부 | 최종 통합 archive |
history를 조회할 때는 최근 L0 몇 개, 최근 L2 몇 개, 그리고 L4 장부만 보면 됩니다. 5만 개 파일을 훑는 대신 구조화된 index 몇 개만 확인하므로 metadata 읽기와 데이터 검색이 O(log delta)로 늘어나고, 전체 데이터가 기하급수적으로 불어나도 검색 시간은 거의 늘지 않습니다. 기존 Git 서버가 repack 뒤 오래된 packfile을 garbage collection으로 버리는 것과 달리 Pando는 L0부터 L4까지 모든 단계의 packfile을 영구 보존합니다. 어떤 client 요청이든 필요한 크기 단위의 파일을 즉시 내줄 수 있어, 중앙 서버가 실시간 repack이나 재압축을 위해 멈출 일이 없습니다.
만들고, 증명하고, 멈춤 없이 바꾼 과정
commit이 2,400%씩 늘어나는 가운데 저장소의 기반을 교체하는 일은 매일 2,000층씩 올라가는 고층 건물의 기초를 갈아 끼우는 것에 비유됩니다. 백서가 밝힌 과정은 다음과 같습니다.
- 설계와 구현: 핵심 architecture는 엔지니어 한 명이 설계했고, Codex를 쓰는 agent 팀이 구현해 10주 만에 production에 올렸습니다. legacy 의존성 없이 Rust로 새로 작성했고, 맞춤 conformance test suite로 agent의 변경이 표준 Git 동작과 일치하는지 대조했습니다.
- 형식 검증: GPT-6 Astra agent가 Lean과 TLA+로 'theory of Pando'를 형식화했습니다. 두 언어는 Python이나 C++ 같은 범용 언어와 달리 시스템을 수학적 상태 기계로 모델링하고 모든 상태에서 지켜야 할 invariant를 정의합니다. model checker가 가능한 모든 사건 순서, 네트워크 지연 변화, 동시 push, 서버 장애를 체계적으로 시뮬레이션해 invariant가 유지되는지 증명했습니다.
- red-team: Daybreak 급 모델과 deterministic simulation testing harness로 agent가 24시간 공격해 production 전에 race condition을 찾아냈습니다.
- 무중단 전환: 읽기와 쓰기 모두를 통과시키는 proxy cache를 앞단에 두었습니다. push는 legacy 백엔드와 Pando 양쪽에 동시에 쓰고, fetch는 Pando를 먼저 확인해 있으면 바로 내주고 없으면 legacy에서 가져와 응답한 뒤 비동기로 Pando에 채워 넣습니다. 개발자 개개인의 환경과 checkout은 Codex의 자동화 skill이 설정 파일을 손대지 않고 proxy를 가리키도록 바꿨습니다. 수천 명의 엔지니어가 쓰는 시스템이 downtime 없이 넘어갔습니다.
production 결과는 다음과 같습니다.
- median push 지연 약 80% 감소(거의 5배 단축)
- merge 인프라 일일 성공률 99.99%로 안정화
- 하루 거의 1PB의 Git 데이터 제공, 피크 1시간에 57TB 이상
- 전송 byte의 99% 이상이 로컬 disk cache에서 제공, CPU core는 소수만 사용
Pando는 표준 Git 프로토콜과의 호환을 엄격히 유지했기 때문에 기존 Git client를 그대로 씁니다. 그 과정에서 사람 팀의 규모에서는 드러나지 않던 Git client의 동시 다운로드 및 중단된 전송 정리 관련 concurrency 버그가 발견됐고, OpenAI는 수정 patch를 오픈소스 Git 프로젝트에 upstream으로 기여했습니다. 또 서버가 tip commit의 ref를 packfile과 분리해 광고하는 'explicit haves' 협상 기능을 제안해 upstream에 올렸습니다. 이 기능 덕분에 client는 전체 tree를 다시 받지 않고도 force-with-lease 같은 명령을 trunk history 기준으로 더 안전하고 빠르게 쓸 수 있습니다.
정리: agent 시대의 인프라는 어디부터 무너지나
이 사례를 읽는 한 가지 방법은, 처음 무너지는 곳이 하드웨어 용량이 아니라 '전역 합의'가 필요한 지점이라는 해석입니다. 3PC의 위원회, WAL의 펜 하나, 저장소 전체 snapshot, client별 맞춤 packfile은 모두 요청 하나를 처리하기 위해 시스템 전체 상태를 알아야 하는 구조이고, agent 부하는 바로 그 지점을 집중적으로 두드립니다. OpenAI의 답은 결정을 ref 단위로 쪼개고, 계산을 client로 옮기고, 결과물을 cache 가능한 불변 파일로 만드는 것이었습니다.
agent를 개발 workflow에 들이는 팀이라면 백서에서 다음 점검 항목을 가져올 수 있습니다.
- 사람의 근무 패턴을 전제로 한 용량 계획을 버립니다. agent는 쉬지 않고 병렬로 움직입니다.
- 쓰기 경로에서 다중 노드 동기식 합의나 단일 manifest의 CAS처럼 직렬화되는 지점을 찾습니다. 노드를 늘려도 풀리지 않는 병목이 여기서 나옵니다.
- client가 정말 전역 순차 일관성을 필요로 하는지, entity나 key 단위의 causal consistency로 충분한지 따져 봅니다.
- delta 계산을 동적 협상 대신 고정된 공통 기준점에 묶고, 약간의 중복 전송을 감수해 서버 계산을 정적 cache로 바꿉니다.
- 고빈도 쓰기 조각은 LSM-tree식 background compaction으로 정리하고, 단계별 파일을 보존해 다양한 크기의 요청에 즉시 응답합니다.
- 분산 시스템을 새로 만들 때 Lean이나 TLA+ 같은 형식 명세 언어와 추론 모델을 함께 써서 배포 전에 invariant를 검증합니다.
- 저장소 교체 같은 고위험 migration은 읽기와 쓰기 모두를 통과시키는 proxy cache로 무중단 전환하고, 개발자 환경 변경은 agent skill로 자동화합니다.
백서의 결론은 더 먼 곳을 가리킵니다. 많은 수의 agent가 공유 저장소에서 직접 협업하는 자율 환경에 Pando를 쓰겠다는 것입니다. AI가 대부분의 코드를 쓰고 인프라를 형식적으로 검증하는 세계에서 source control은 사람의 오타를 추적하는 보관 도구가 아니라, agent 떼가 실시간으로 발명하고 시험하고 merge하고 진화시키는 고속 신경망에 가까워집니다. 느린 progress bar를 기다리는 동안에도 그 기다림을 없애는 설계가 이미 진행되고 있다는 점이, 이 백서가 전하는 가장 분명한 신호로 보입니다.


