OpenAIは、主要モノレポのバックエンドを、自社開発のGit互換ストレージシステム「Pando」に置き換えました。数千のAIコーディングエージェントが昼夜を問わずコードをpush、マージ、fetchし続ける世界を想定して設計されたシステムです。同社が2026年11月2日に公開したホワイトペーパー「Scaling Git at OpenAI: Building agentic-scale source control while investing in the Git ecosystem」によると、従来のシステムは、コミット量が2024年第1四半期比で2026年第4四半期に2,442%増に達するとの予測のもとで、すでに破綻し始めていました。Pandoによってpush遅延の中央値は5倍近く短縮され、マージ基盤の信頼性は99.99%に向上し、現在は1日あたり1ペタバイト近くのGitデータを配信していると、同ペーパーは報告しています。
さらに興味深いのは、OpenAIがどうやってそこに至ったかです。スケールしない設計にサーバーを追加するのではなく、チームはバージョン管理システムにおいて多くのエンジニアが不可侵と考える二つの前提を捨てました。以下では、旧構成がなぜ壊れたのか、Pandoは何が違うのか、そしてこのアプローチがAIエージェントの負荷にまもなくさらされるインフラを運用するすべての人にとって何を意味しうるのかを解説します。
エージェントは帰宅しない
Gitは20年以上前に、Linuxカーネル開発者がメールでパッチをやり取りするのを助けるために作られました。このモデルは人間のチームにはよく合っていました。エンジニアはおおむね直線的に、勤務時間中に作業し、休憩も取ります。OpenAIのコード生成モデルであるCodexは、このワークロードの物理法則を変えました。自律エージェントの群れが並列に、継続的に、営業時間という概念なしに動きます。ブランチを作り、矢継ぎ早にコミットをpushし、絶えずマージし、CI/CDパイプラインや研究実験からのcloneとfetchのトラフィックをひっきりなしに発生させます。
ペーパーに掲載されたグラフは、OpenAIのモノレポでmasterに取り込まれた四半期ごとのコミット数が、2024年第1四半期を基準に指数関数的な曲線を描いて増え、2026年第4四半期には2,442%という数字に達する様子を示しています。既存インフラは耐えきれませんでした。fetchは遅くなり、pushは止まり、マージは失敗しました。37営業日にわたる日次のマージ基盤成功率を追った別のグラフでは、成功率が何度も90%を下回っており、そのたびに全社の開発ワークフローが止まりました。
定石が通用しなかった理由
新しいものを作る前に、OpenAIは分散Gitバックエンドを運用する従来型の方式を二つモデル化しました。どちらも高い並行性のもとでは失敗し、その理由は示唆に富むものでした。
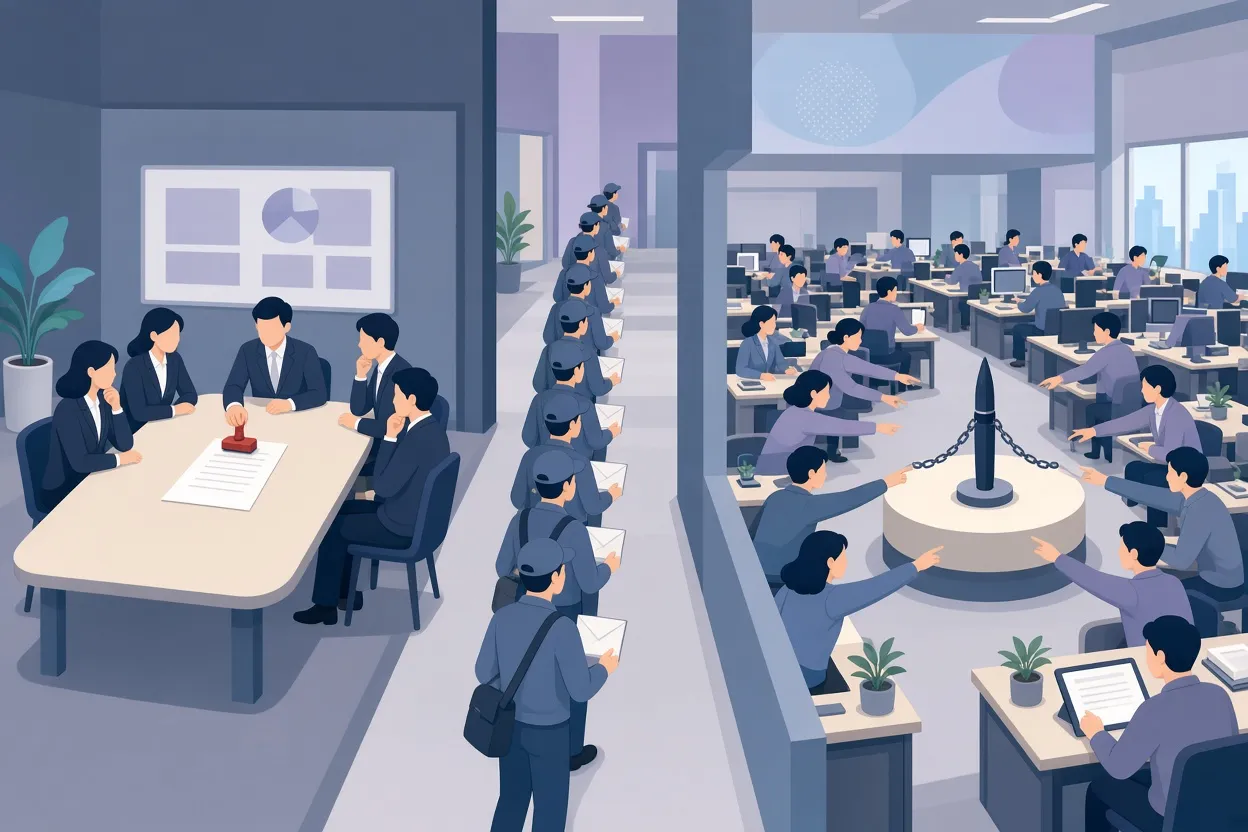
▲ 3PCとWALそれぞれのボトルネック
3フェーズコミット: 委員会方式
一つ目の選択肢は3フェーズコミット(3PC)です。これは合意プロトコルの一種で、受信したパックファイル(Gitがオブジェクトを圧縮してまとめたもの)をすべてのレプリカに並列にコピーしますが、各更新は過半数のレプリカが足並みをそろえて合意して初めてコミットできます。その様子は、何かが確定する前に一枚の書類を審査して判を押さなければならない企業の委員会に似ています。その間、後続の要求はすべて廊下で待たされます。書き込みは厳密に逐次処理になります。さらに悪いことに、3PCは水平にスケールできません。レプリカを追加すると合意に加わるノードが増え、調整のラウンドが長引いて、遅延は改善するどころか悪化します。
Write-Ahead Log: 一本のペン
二つ目の選択肢は、中央のblobストレージを土台にした共有Write-Ahead Log(WAL)です。ここではパックファイルを共有ストレージに並列でアップロードし、参照の更新はアトミックなcompare-and-swap(CAS)操作で中央のマニフェストに記録します。CASは、他の誰もマニフェストを先に変更していない場合にだけ成功します。これは、大勢の素早い書き手が一本のペンを共有して一冊の台帳に署名する光景です。別のエージェントが数ミリ秒早くコミットすればCASは失敗し、書き手は最新のマニフェストを取得して自分の更新を再検証し、やり直さなければなりません。エージェント規模の負荷では、マニフェストをめぐる競合がリトライの嵐と待ち行列の遅延を生みます。WAL設計はボトルネックを取り除くのではなく、場所を移すだけです。
差を示すシミュレーション
OpenAIは、1,000の同時書き込みクライアントのもとで三つの設計を比較する対話型シミュレーションを公開しています。ペーパーはこれを本番ベンチマークではなく教育用モデルと位置づけていますが、差は歴然としています。
| アーキテクチャ | 1,000クライアントの完了時間 | pushからfetchまでの平均遅延 |
|---|---|---|
| 3フェーズコミット | 56.52秒 | 4.63秒 |
| オブジェクトストアWAL | 96.26秒 | 6.38秒 |
| Pando | 7.71秒 | 0.47秒 |
Pandoが捨てた二つの前提
標準的な分散システムのパターンでは不十分だと結論づけたチームは、Gitバックエンド設計の二つの土台を疑いました。
前提その1: リポジトリ全体の一貫性
従来のGitサーバーは、すべてのfetchが全参照にわたって大域的に統一されたある時点のスナップショットを見ることを保証します。Pandoはこの保証を捨て、因果一貫性を採用し、厳密な直列化可能性は個々の参照にだけ適用します。平たく言えば、単一のブランチへの更新は一本のきれいな時系列に並べられますが、無関係なブランチ同士の順序はもう調整しません。
OpenAIは、これがエンジニアの実際の働き方を映していると主張します。UI機能ブランチに反復的な変更をpushしている人は、無関係な50本のデータベース移行ブランチのマイクロ秒単位の順序など気にしません。気にするのは、自分のブランチに自分のコミットが含まれていることと、マージ先のトランクが正確であることです。ペーパーはこれを、高価で大域的に調整された真実に対する「局所化された真実」と呼んでいます。二人の開発者が同時に、一方はブランチalphaをv1、betaをv2として、もう一方はalphaをv2、betaをv1として見ることがあっても、整合性はまったく損なわれません。pushの競合は、二つのクライアントがまったく同じ参照に同時にpushした場合にだけ起こり、大域的なpushロックがないため、無関係なブランチへの書き込みは完全に並列に進みます。
大域的な一貫性を捨てると聞けば、経験豊富な開発者の多くは不安を覚えるでしょう。ペーパーの立場は、実際のワークフローはブランチをまたぐスナップショットの順序に依存していないため、その不安は的外れだというものです。
前提その2: クライアントごとに専用のパックファイル
標準的なGitのpushでは、サーバーは手札をすべて見せるポーカープレイヤーのように振る舞います。すべてのブランチとその現在のコミットを広告するのです。サーバーに数百万のブランチがあれば、このリストは100MiBを超えることもあります。クライアントはリストを調べ、サーバーに欠けているオブジェクトを正確に計算し、密に圧縮したパックファイルを作ります。この設計は帯域が貴重だった時代のもので、バイト数を最小化するためにCPUとディスクI/Oを費やします。サーバー側では、クライアントごとに動的に再パックしたり専用のデルタを計算したりするのに膨大なリソースを消費し、しかも各パックファイルは一つのクライアントのその瞬間の状態に固有のものなので、何もキャッシュも再利用もできません。すべてのfetchがゼロから始まります。
Pandoは手札を伏せます。広告するのはmainのような指定されたトランクブランチだけで、クライアントはそのトランクを基準にアップロード用パックファイルを計算します。トレードオフとして、自分のブランチに繰り返しコミットをpushするクライアントは、まだトランクに入っていない中間コミットを再送することがあり、その分アップロード帯域が余分にかかります。OpenAIの本番データによれば、このコストは小さいものです。モノレポにおけるpushパックファイルの中央値は20KB未満、99パーセンタイルでも3MB未満です。その代わり、サーバーは再パックを一切行いません。
書き込み経路と読み取り経路
パックファイルがクライアント固有の状態ではなく共有の基準に対して作られるため、もはや一回限りの成果物ではありません。Pandoの書き込み経路は、約20KBのファイルを受け取り、不変のblobストレージに書き込み、メタデータを更新して終わりです。再パックの計算は発生せず、pushの取り込みはO(1)のメタデータ書き込みになります。つまり、そのコストはリポジトリの規模や負荷に応じて増えません。
読み取りも異なります。クライアントがブランチをfetchすると、Pandoはデルタのバンドルを計算する代わりに、パックファイルのURL一覧を返します。このトラフィックは、OpenAIの運用リージョンにまたがって配備された社内のリージョナルエッジキャッシュ層「Express」を経由します。Expressはblobストレージとメタデータの両方をキャッシュします。OpenAIはキャッシュヒット率が99%を超えると報告しており、そのおかげで標準的なクラウド仮想マシンがcloneやfetchの際に10Gbpsのネットワークリンクを使い切りながら、中央サーバーのCPUはほとんど消費しません。
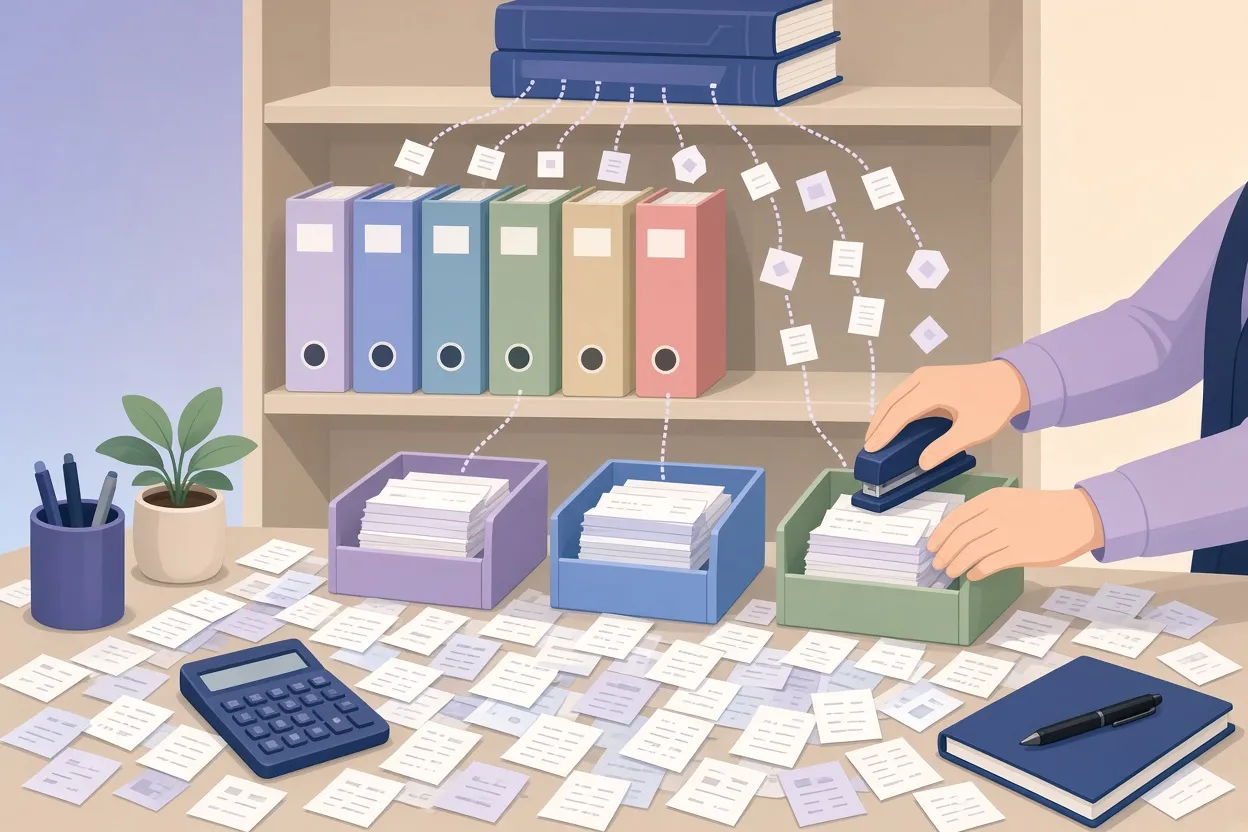
▲ PandoのL0からL4までの階層型コンパクション
コンパクション: 領収書を溜めない
すべてのpushを個別の小さな不変ファイルとして保存すると、「小さなファイルの肥大化」を招きます。2週間の休暇から戻ったエンジニアは、数万件に及ぶ個別のパックファイルのダウンロードに直面しかねません。ペーパーは例として50,000件という数字を挙げています。Pandoはこれを、LSMツリーを手本にしたバックグラウンドのコンパクション方式で解決します。LSMツリーはデータベースで一般的なストレージ構造で、小さな書き込みを時間とともに大きなソート済みファイルにまとめていきます。
各階層の働きは、簿記のたとえで理解できます。
- レベル0(L0): 20KBのpush一つひとつが、会計士の机に置かれたばらばらの領収書
- レベル1(L1): バックグラウンドのサービスが領収書の束を週ごとのまとめにホチキス留めする
- レベル2(L2): 週ごとのまとめが月ごとのフォルダーに繰り入れられる
- レベル4(L4): すべてが最終的に年間台帳に収まる
遅れを取り戻すクライアントが必要とするのは、直近のL0の領収書を数枚、L2のフォルダーを数冊、そしてL4の台帳だけで、数千のばらばらのファイルではありません。そのためメタデータの読み取りは対数的にスケールし、O(log delta)と表されます。サーバーは50,000件のファイルを走査する代わりに少数の構造化されたインデックスを参照するので、データ量が増えても取得時間はほとんど伸びません。再パック後に古いパックファイルをガベージコレクションする従来のGitサーバーと違い、PandoはL0からL4までのすべての階層のパックファイルを保持するため、必要な粒度であらゆるfetchに応えられ、オンデマンドの再圧縮で待たせることがありません。コンパクションは非同期に実行されるので、書き込みに遅延を加えません。
エージェントが構築し、数学で証明し、無停止で展開
ペーパーは異例の構築プロセスを記しています。Pandoの中核アーキテクチャは一人のエンジニアが設計し、Codexを使うエージェントのチームが実装して、10週間で本番に投入されました。レガシーな依存関係を持たずRustでゼロから書かれ、エージェントによる変更は独自の適合性テストスイートで標準的なGitの挙動と照らし合わせてベンチマークされました。
正しさの検証には、OpenAIはGPT-6 Astraのエージェントを使って「Pandoの理論」をLeanとTLA+で形式化しました。これらは、システムをあらゆる状態で成り立つべき不変条件を持つ数学的な状態機械としてモデル化する仕様記述言語です。モデル検査器がイベントの系列、遅延の変動、同時push、サーバー障害をシミュレートし、不変条件が保たれるかを証明しました。証明と並行して、Daybreak対応モデルを使うエージェントが決定論的シミュレーションテストのハーネスでシステムを継続的にレッドチーミングし、リリース前に競合状態をあぶり出しました。分散システムの形式的証明をAIモデルが生成し検査することは、構文的に正しいコードを生成する段階から意味のある一歩を踏み出したものと見られます。
切り替え自体には、両方のバックエンドの手前に置いたリードスルーかつライトスルーのプロキシキャッシュを使いました。
- pushの際、プロキシはデータをレガシーバックエンドとPandoの両方に書き込む
- fetchの際、プロキシはまずPandoを確認し、ヒットすればそこから返す
- ミスした場合、プロキシはレガシーバックエンドから取得して開発者に返し、非同期でPandoにバックフィルする
開発者はCodexの自動化スキルを使い、設定を手作業で編集することなくローカル環境やサービスの向き先をプロキシに付け替えました。移行は、コミット率がおよそ2,400%増えている最中に、数千人の現役エンジニアを抱えながら無停止で行われました。これは、作業員が1日に2,000階ずつ増築している最中に超高層ビルの基礎を入れ替えるような離れ業です。経験を積んだアーキテクトなら、Strangler Figといった名前で知られるパターンだと気づくかもしれません。
本番環境での成果
| 指標 | OpenAIが報告した結果 |
|---|---|
| push遅延の中央値 | 5倍近く低下、約80%の短縮 |
| マージ基盤の成功率 | 切り替え後は99.99%、切り替え前は90%を下回ることも |
| 1日に配信するGitデータ | 1ペタバイト近く |
| ピーク時の1時間 | 57TB超のパック、99%超がローカルディスクキャッシュから |
| サーバーの計算資源 | わずかなCPUコア数 |
修正をGitに還元
Pandoは、開発者を独自ツールに囲い込むのではなく、オープンなGitプロトコルとの厳密なワイヤ互換性を保っています。この規模で運用したことで、標準的なGitクライアントに潜む、同時ダウンロード時や中断された転送の後始末における微妙な並行性バグが露わになりました。人間のペースで動くチームでは、どうやら一度も踏んだことのないエッジケースです。OpenAIはこれらを修正し、アップストリームに貢献しました。さらに「explicit haves」というプロトコル機能もアップストリームに取り込まれました。これはサーバーが先端コミットの参照をパックファイルとは別に広告できるようにするもので、クライアントはツリー全体を再ダウンロードすることなく、force-with-leaseのチェックを含め、トランクの履歴に対してpushとfetchを行えます。
この話の意味と、やるべきこと
ペーパーは最後に、多数のエージェントが共有リポジトリ上で直接協働する環境を展望しています。その見立てでは、ソース管理は人間の編集を保管するアーカイブであることをやめ、エージェントがソフトウェアを継続的に発明し、テストし、マージし、進化させるリアルタイムの神経系に近いものになります。その未来が描かれたとおりに訪れるかどうかは予測の域を出ませんが、エンジニアリング上の教訓はそれ自体で成り立ちます。
- 人間の作業パターンに合わせて設計しない。エージェントのトラフィックは並列で、絶え間なく、突発的
- 高頻度の書き込みに同期的な複数ノード合意を使わない。ノードを増やすほど遅くなる
- CASで保護された単一のマニフェストは、高い並行性のもとでは詰まりどころになると心得る
- クライアントに本当に大域的な一貫性が必要なのか、エンティティごとの順序だけで足りるのかを問う
- クライアントのデルタ計算を静的な共有基準に固定し、サーバーの計算をキャッシュ可能な不変ストレージに変えられるなら数キロバイトの余分は受け入れる
- 非同期の階層型コンパクションを使い、破壊的なガベージコレクションではなくすべての階層を保持する
- 分散システムをリリースする前に、LeanやTLA+といった形式手法をAI推論モデルと組み合わせる
- リードスルーかつライトスルーのプロキシを使って、重要インフラを無停止で移行する
Gitサーバー、CIシステム、あるいはコーディングエージェントがまもなく機械の速度で叩くことになる共有ストアを運用するチームにとって、実践的な第一歩は、スタックの中で「一度に一人の人間」を前提にしている部分を探すことです。負荷が最初に壊すのは、そこだからです。


