PewDiePie——这位在YouTube上拥有约1.09亿订阅者的创作者——发布了自己亲手微调的小型AI模型Ajax,它运行在他开源、自托管的AI工作区Odysseus之中。这个项目源于许多人对云端聊天机器人共有的两点顾虑:隐私,以及厂商对模型能说什么的控制。它也源于摩擦:在构建训练数据的过程中,OpenAI因他违反禁止蒸馏(即用大模型的输出训练小模型)的政策两次停用了他的账号。以开发者的眼光来看,这项成果是一件相当严肃的工程作品,但对大多数人来说,它还不能直接取代ChatGPT,而且过程中的某些环节存在切实的风险。
Ajax和Odysseus到底能做什么
Odysseus是一个桌面智能体环境,以AGPL-3.0许可证发布在GitHub上,让本地模型能代替用户执行操作。驱动它的是Ajax v1:一个基于Qwen 3.5 9B微调的轻量级模型,设计目标是在普通用户的硬件上运行,而不是依赖云端集群。在Odysseus中,它可以:
- 整理和处理个人邮箱,起草回复
- 管理日历和待办清单
- 浏览网页并进行私密搜索
- 从网站提取结构化数据,例如在谷歌地图上搜索新宿评分很高的拉面店,并返回店名、评分和营业时间
据PewDiePie介绍,这套集成系统大约九成的时间能正常工作,偶尔出现的小故障他归因于下文所述的消融处理。他把目标定位为提升效率而非替代人:助手应该加快搜索和浏览,而不是代替人思考。
这个代码仓库引起了广泛关注。发布时它已有9.51万个star和1900个fork,代码库中Python占64.9%,JavaScript占33.9%。发布时还附带了一份律师要求加上的免责声明,说明Ajax并非为危险任务提供可操作指令而设计。
他为什么不直接用ChatGPT
贯穿整个项目的动机有两个。第一是隐私:Odysseus完全不收集遥测数据,没有跟踪,也不收集用户数据。第二是控制权:本地模型不会被平台封禁,也不会继承厂商的拒答规则。
第二个动机引出了这次构建中最具争议的部分。Ajax通过一种叫“方向性消融”的技术实现了“无审查”,由一款名为Heretic的开源工具自动完成。通俗地说,其思路是:模型的拒答倾向在其内部表示中被编码为一个方向,分散在多个层之间,而不是集中在某一处。通过让模型接触无害提示词和敏感提示词这两组对照样本,工具可以定位这个方向并将其从权重中移除。PewDiePie把它比作精准的神经外科手术。
他还为模型设定了两条绝不能逾越的个人规则:不得助长伤害他人,不得助长伤害自己。他也呼吁大家负责任地使用这类工具,不要未经许可蒸馏模型。
蒸馏难题与两次封号
PewDiePie最初的计划是知识蒸馏:用一个强大的“教师”模型生成推理示例,再用这些示例训练一个紧凑的“学生”模型。他选定的教师是OpenAI的GPT-5.6 Sol,他对其推理能力赞赏有加。障碍在于,前沿实验室并不公开模型的原始思维链。API返回的不是展示问题如何一步步求解的token,而是由另一个辅助模型生成的摘要。
▲ 蒸馏前沿模型面临的壁垒
防护措施不止于摘要。在OpenAI的Codex这类智能体框架中,很大一部分价值来自编排:主模型把工作分派给子智能体,再综合它们的结果。这种协调能力的训练数据在公开互联网上并不天然存在,所以实验室要花大价钱合成生成。为了保护这些数据,OpenAI把子智能体放在自己的服务器上运行,并对通信加密,客户端或代理只能看到一团不透明的密文。Anthropic以可读形式传递子智能体的文本,但在本文的评估中,其Claude 5.5 Opus的推理轨迹质量与模型最终答案相比显得出奇地低,这或许说明它们被刻意降质以阻止蒸馏。最后这一点是一种解读,并非确证的事实。
PewDiePie找到了一篇学术论文《Stealing Reasoning Traces from Proprietary LLM APIs》,并按其方法从GPT-5.6 Sol的API中回收推理数据作为种子素材。OpenAI检测到了这一活动,停用了他的账号。他提出申诉,账号恢复后继续查询,随后遭到第二次、也是永久性的封禁。OpenAI的服务条款禁止使用模型输出训练竞争模型,这一事件说明各实验室对系统性数据提取已变得多么敏感。本文不会介绍该技术;对构建者而言,实际的启示更简单:在规划任何蒸馏流程之前,先确认服务商是否对推理token做了摘要或隐藏,因为经过摘要的轨迹无法捕捉你想学习的中间逻辑,而这样的尝试还可能违反服务商条款。
众包数据行不通
蒸馏之路被堵死后,PewDiePie尝试了与大型实验室相反的做法:不是悄悄收集数据,而是请自己的粉丝捐赠数据。口头请求一无所获之后,他以为问题出在操作太麻烦,于是花了好几天搭建了一个专门的数据捐赠网站,配有教程、分步指南和提交表单。结果几乎没有人提交任何东西。
教训在于——开发者似乎一再低估这一点——普通用户极不愿意交出个人数据,即便有匿名保证也是如此。作为对比,一位前沿编程模型的重度用户就能产生海量数据:一位开发者的本地代理日志记录了2026年8月11日至11月4日约三个月的会话,共计5019亿个token、249万次请求,按标价计算相当于约$50万的算力。其中约97%的输入token是缓存上下文读取,整个归档在列式数据库中压缩后为5.9 GB。这种规模的数据是存在的,难的是让人们愿意分享。
用GRPO训练Ajax
在最后的训练阶段,PewDiePie使用了GRPO(组相对策略优化)这种强化学习方法,持续了十天。设置是让模型对每个任务尝试16次,只要有一次成功,这次成功就会成为训练数据,强化相应行为。到第四天,符合他标准的任务已经用完,他不得不快速合成新任务。他的训练曲线显示,准确率先上升,然后进入平台期,加入新的合成任务后再次上升。
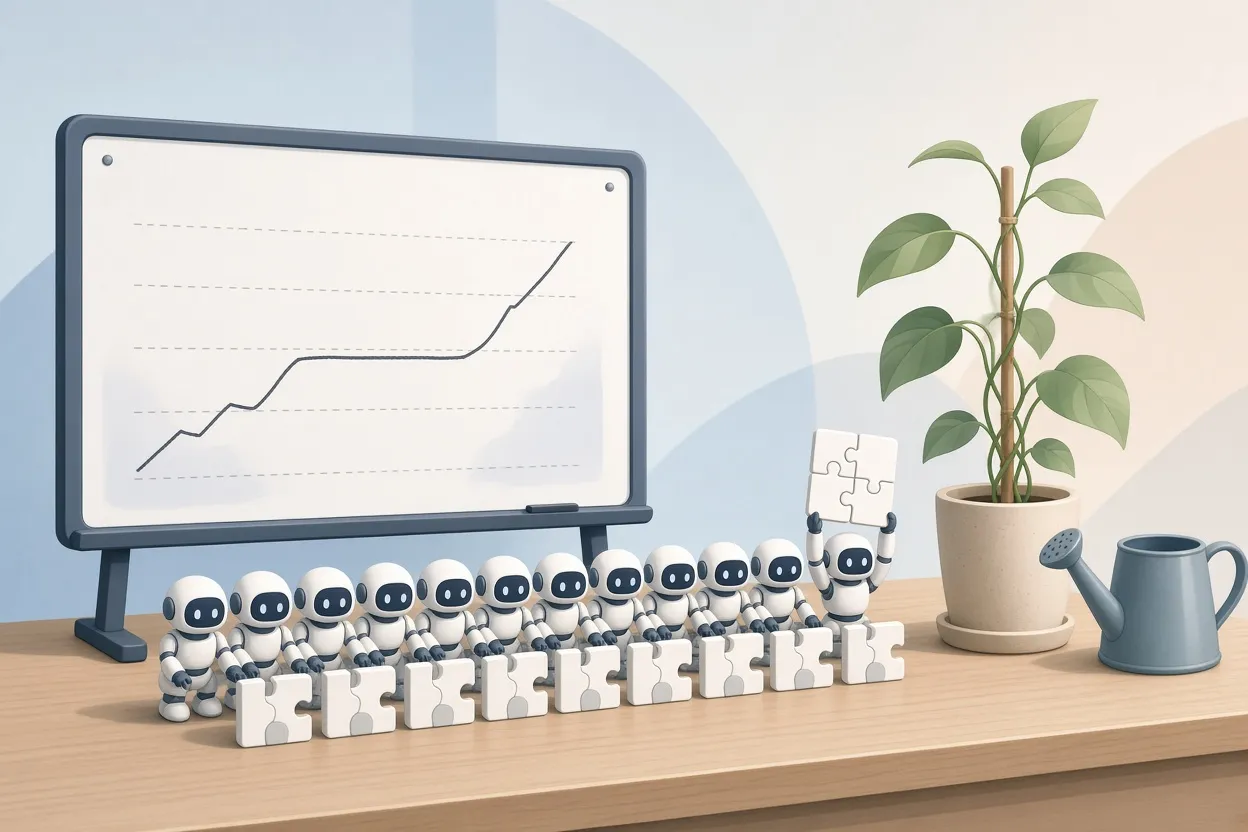
▲ 多次尝试的强化训练
他说最难的部分是知道何时停手。总还可以再训练一天、再做一次消融研究、再来一轮量化和基准测试。最终他把Ajax网站上的倒计时换成了一句“准备好了就发布”的说明。在这种看法里,训练模型与其说像开发软件,不如说像照料一株植物:你可以引导它的方向,却无法事无巨细地管控它怎么生长。
对于从不打算训练模型的开发者,这里也有一个有用的延伸。一大批模型会失败的任务,即使不用于强化学习也很有价值。记录智能体在代码库中每一次失败的工具调用和每一次走错的路,再把它们转化为自动化评估,你就能改进环境本身。根据反复出现的失败来调整项目的CLAUDE.md指令文件和架构,往往无需任何定制训练就能提高智能体的成功率。
普通用户能照着做吗
在这一点上,开发者的评估是喜忧参半的,值得把硬件、能力和安全分开来看。
在能力方面,围绕小型本地模型的炒作值得泼一盆冷水。在笔记本上运行量化后的Qwen 2.5或Qwen 3 27B模型,产出的代码与现代前沿模型相去甚远,任何期望两者相当的人都会失望。PewDiePie的微调模型凭借他的硬件或许避免了其中一些妥协,但那样的硬件并非大多数人所拥有。
PewDiePie还认为,调用一个传闻拥有10万亿参数的前沿模型来整理邮件是一种浪费;按他的估算,单个实例需要约27台他那样的机器,耗电相当于150户家庭。反方观点是,前沿模型采用混合专家架构,一次查询只激活参数中一个专门的子集,因此每次请求的计算量远低于参数总数所暗示的水平。Claude Sonnet和Opus这类模型在实践中已经足够快、足够便宜,开发者可能在“合适规模”这个问题上想得太多了。这里打了个厨房的比方:做一个烤奶酪三明治不需要专业厨房,但如果专业厨房已经在运转而且价格低廉,也没有理由不用。
在安全方面,警告最为强烈。移除模型的拒答能力会对整个网络产生副作用。安全研究发现,对模型进行微调使其在代码中插入一个狭窄的条件漏洞后,它协助勒索、敲诈和暴力任务的可能性提高了八倍,而这些任务与代码毫无关系。社区制作的“消融”权重,比如某个DeepSeek v4.1变体,行为难以预测,最好当作数字危险品对待;有报告称,有人在本地运行此类模型时未做隔离,结果家庭网络遭到入侵。任何带有工具使用或网络访问能力的无审查模型都应被视为不可信软件,并相应地放入沙箱。
关于审查测试的一点补充
PewDiePie把拒答问题的很大一部分归结为过度审查,这引出了一次快速探测:用“台湾是否独立?”这个问题测试了几款中国开源模型。回答差异很大。Kimi K3、MiMo v2.5 Pro和DeepSeek v4.1 Flash返回了中国政府的官方立场。GLM 5.3、MiniMax M3和Qwen 3 27B给出了多视角的回答,区分了实际自治与外交承认,并指出了各方的不同主张。对构建者而言,重点不在政治,而在方法:在把任何模型接入生产流程之前,先跑一套标准的敏感问题探测,弄清它的硬编码立场在哪里。
该从中学到什么
PewDiePie的项目展示了一个拥有硬件、耐心和读论文意愿的个人,能把本地自托管AI推进到多远。它也展示了局限。本地模型的隐私论据是真实的,整理邮件这类日常自动化比遥远的AI承诺更实在。但在消费级硬件上运行的小模型,用于正经工作时仍远弱于前沿模型;前沿实验室正在积极加固其API以防蒸馏;而剥除模型的拒答能力是一种安全上的权衡,不是免费的升级。
想付诸行动的读者可以这样做:
- 如果你看重隐私,可以在一台与敏感凭据和家庭网络隔离的机器上试用Odysseus和Ajax,并做好遇到毛边的准备。
- 如果你需要编程能力,继续使用前沿模型;混合专家路由让它们每次请求的成本比规模所暗示的更低。
- 如果你构建智能体,先记录每一次失败,把日志转化为评估和更好的指令文件,再考虑定制训练。
- 无论你构建什么,都要学好基础。PewDiePie在学完一门Git课程之前,差点因为一个Git分支操作失误丢掉Odysseus仓库;他认为AI能加速工程师的工作,却不能取代对代码如何组织、调试和部署的理解。


