YouTube登録者数約1億900万人を抱えるクリエイターのPewDiePieが、自らファインチューニングした小型AIモデル「Ajax」を公開しました。Ajaxは、同氏がオープンソースで公開するセルフホスト型AIワークスペース「Odysseus」の中で動作します。このプロジェクトは、クラウド型チャットボットに対して多くの人が抱く二つの懸念、すなわちプライバシーと、モデルの発言内容をベンダーが制御していることから生まれました。もう一つのきっかけは摩擦でした。学習データを構築する過程で、大規模モデルの出力を使って小型モデルを学習させる「蒸留」を禁じるポリシーに違反したとして、OpenAIが同氏のアカウントを2度停止したのです。開発者の目で見ると、その成果は本格的なエンジニアリングと言えるものですが、大半の人にとってまだChatGPTをそのまま置き換えられるものではなく、プロセスの一部には現実的なリスクも伴います。
AjaxとOdysseusは実際に何をするのか
Odysseusは、GitHubでAGPL-3.0ライセンスのもと公開されているデスクトップ向けエージェント環境で、ローカルモデルがユーザーの代わりに作業を行えるようにします。それを動かすのがAjax v1です。Qwen 3.5 9Bをベースにした軽量なファインチューニングモデルで、クラウドのクラスタではなく一般的なユーザーのハードウェアで動くよう設計されています。Odysseusの中で、Ajaxは次のことができます。
- 個人のメール受信箱を仕分け・処理し、返信の下書きを作る
- カレンダーとToDoリストを管理する
- ウェブを閲覧し、プライベートな検索を実行する
- サイトから構造化データを取り出す。たとえばGoogleマップで新宿の高評価ラーメン店を検索し、店名、評価、営業時間を返す
PewDiePieによると、統合システムは約90%の確率で動作し、ときおり起きる不具合は後述するアブレーション処理が原因だとしています。目標は置き換えではなく効率化だと同氏は位置づけています。アシスタントは検索と閲覧を速めるものであって、人の思考を肩代わりするものではないというわけです。
リポジトリは大きな注目を集めています。公開時点でスター数は9万5,100、フォーク数は1,900で、コードベースの64.9%がPython、33.9%がJavaScriptです。また公開にあたっては、弁護士の求めによる免責事項が添えられ、Ajaxは危険な作業の実行可能な手順を提供するよう設計されたものではないと明記されています。
なぜChatGPTをそのまま使わなかったのか
プロジェクトには二つの動機が貫かれています。第一はプライバシーです。Odysseusはテレメトリも、トラッキングも、ユーザーデータも一切収集しないよう作られています。第二は制御です。ローカルモデルはプラットフォームから追い出されることがなく、ベンダーの拒否ルールを引き継ぐこともありません。
この第二の動機が、今回の構築で最も物議を醸す部分につながりました。Ajaxは「方向性アブレーション」と呼ばれる手法で「無検閲化」されており、その処理はHereticというオープンソースツールで自動化されています。平たく言えば、モデルが拒否する傾向は内部表現の中で一つの「方向」として符号化されており、単一の箇所ではなく複数の層にまたがって存在するという考え方です。無害なプロンプトと機微なプロンプトの対照的なセットをモデルに与えることで、ツールはその方向を特定し、重みから取り除きます。PewDiePieはこれを標的を絞った脳神経外科手術にたとえています。
同氏はまた、モデルが決して手助けしてはならないものとして、他者への危害と自分自身への危害という二つの個人的なルールを定めました。さらに、こうしたツールを責任をもって扱うこと、そして許可なくモデルを蒸留しないことを人々に求めています。
蒸留の問題と2度のアカウント停止
PewDiePieの当初の計画は知識蒸留でした。強力な「教師」モデルで推論の例を生成し、それを使ってコンパクトな「生徒」モデルを学習させるという方法です。教師として選んだのはOpenAIのGPT-5.6 Solで、その推論能力を同氏は高く評価しています。障害となったのは、フロンティアラボがモデルの生の思考の連鎖(チェーン・オブ・ソート)を公開していないことです。問題がどう解かれたかを示す段階的なトークンの代わりに、APIが返すのは二次モデルが生成した要約です。
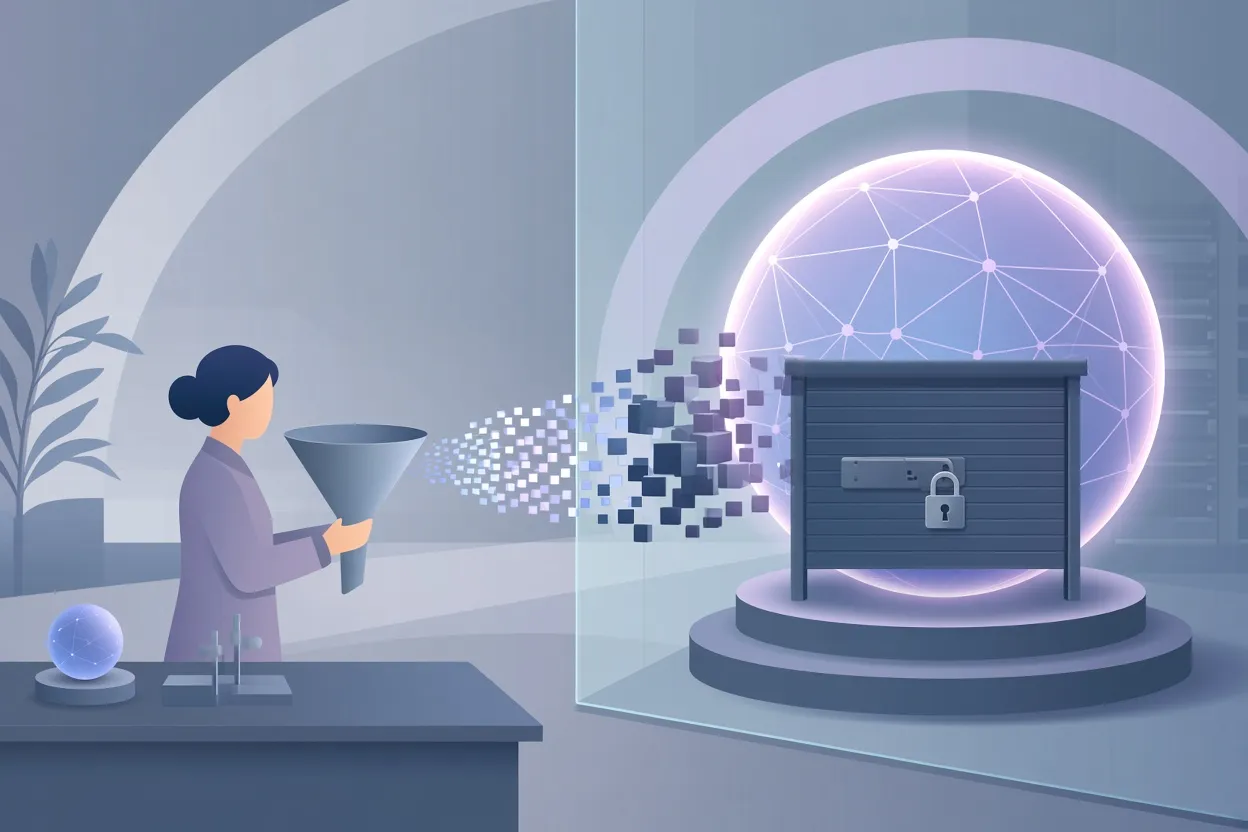
▲ フロンティアモデルの蒸留を阻む壁
防御策は要約にとどまりません。OpenAIのCodexのようなエージェントハーネスでは、価値の多くがオーケストレーションから生まれます。メインのモデルがサブエージェントに作業を委任し、その結果を統合するのです。この種の連携に関する学習データは公開インターネット上に自然には存在しないため、ラボは相当なコストをかけて合成的に生成しています。それを守るため、OpenAIはサブエージェントを自社サーバー上で動かし、通信を暗号化しています。クライアントやプロキシからは、暗号文の不透明な塊しか見えません。Anthropicはサブエージェントのテキストを読める形で渡していますが、Claude 5.5 Opusの推論トレースは、本稿の見立てでは、モデルの最終回答に比べて奇妙なほど品質が低く見えます。これは蒸留を思いとどまらせるために意図的に劣化させている可能性を示唆するかもしれません。ただし最後の点は解釈であり、確認された事実ではありません。
PewDiePieは「Stealing Reasoning Traces from Proprietary LLM APIs」という学術論文を見つけ、その手法を使ってGPT-5.6 SolのAPIから推論データをシード素材として復元しました。OpenAIはこの活動を検知し、同氏のアカウントを停止しました。異議申し立てで復旧した後、クエリを再開したところ、2度目となる永久停止を受けました。OpenAIの利用規約は、モデルの出力を競合モデルの学習に使うことを禁じており、この一件はラボが体系的な抽出に対していかに敏感になっているかを物語っています。本稿ではその技術は説明しません。開発者にとっての実践的な教訓はもっと単純です。蒸留のワークフローを計画する前に、プロバイダーが推論トークンを要約したり隠したりしていないかを確認してください。要約されたトレースには、学習しようとしている中間の論理が含まれておらず、その試み自体がプロバイダーの規約に違反する可能性があるからです。
データのクラウドソーシングはうまくいかなかった
蒸留が封じられたPewDiePieは、大手ラボとは正反対のことを試みました。データをひそかに収集するのではなく、自身のファンにデータの寄付を呼びかけたのです。口頭での呼びかけでは何も集まらなかったため、原因は手間にあると考え、チュートリアル、手順ガイド、送信フォームを備えた専用のデータ寄付サイトの構築に数日を費やしました。それでも、提出した人はほぼ皆無でした。
ここから得られる教訓は、開発者が繰り返し過小評価しているように見えるものです。一般ユーザーは、匿名性が保証されていても、個人データを渡すことに強い抵抗を示すのです。比較のために挙げると、フロンティアのコーディングモデルのヘビーユーザー一人だけでも膨大な量を生み出せます。ある開発者のローカルプロキシのログには、2026年8月11日から11月4日までの約3カ月分のセッションとして、249万リクエストにわたる5,019億トークンが記録されており、定価換算でおよそ$50万相当の計算量に相当します。入力トークンの約97%はキャッシュされたコンテキストの読み取りで、アーカイブ全体は列指向データベースで5.9GBに圧縮されました。この規模のデータは存在しています。難しいのは、人々に共有してもらうことなのです。
GRPOによるAjaxの学習
最終段階の学習で、PewDiePieは強化学習手法のGRPO(Group Relative Policy Optimization)を10日間使いました。各タスクをモデルに16回試行させ、1回でも成功すれば、その成功例を学習データとして行動を強化する仕組みです。4日目には基準に合うタスクを使い果たし、新しいタスクを急いで合成しなければなりませんでした。学習曲線のグラフを見ると、精度は上昇した後に横ばいのプラトーに入り、新たな合成タスクを追加すると再び上昇しています。
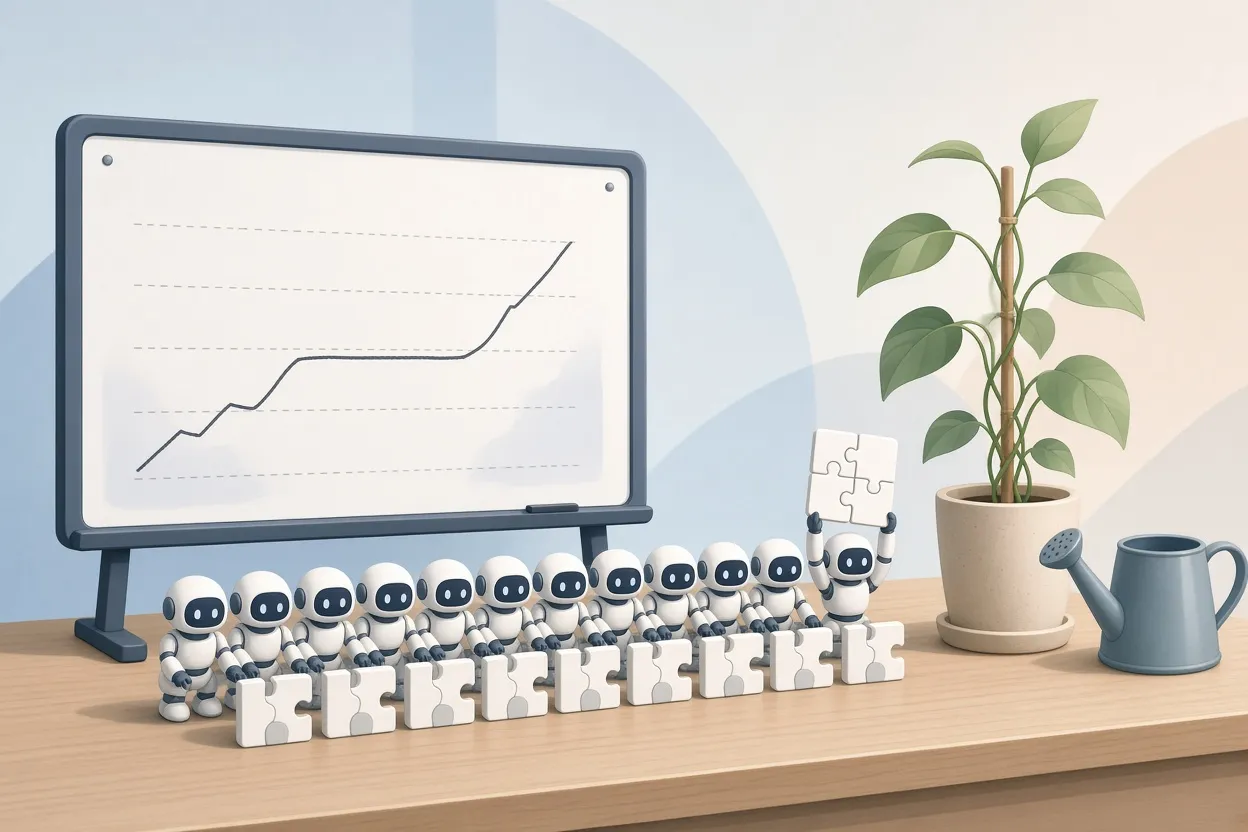
▲ 繰り返し試行による強化学習
最も難しかったのは、いつやめるかを判断することだったと同氏は語っています。常にもう1日の学習、もう一つのアブレーション研究、もう一巡の量子化とベンチマークが待っていました。最終的に、Ajaxのウェブサイトにあったカウントダウンタイマーを、準備ができたら出荷するという一文に置き換えました。この見方に立てば、モデルの学習はソフトウェアを作ることよりも植物を育てることに近いと言えます。方向を導くことはできても、何が育つかを細かく管理することはできないのです。
ここには、何も学習させるつもりのない開発者にも役立つ副産物があります。モデルが失敗するタスクを大量に集めたセットは、強化学習をしなくても価値があります。エージェントがコードベースで失敗したツール呼び出しや誤った判断をすべて記録し、それを自動評価に変換すれば、環境そのものを改善できます。繰り返し起きる失敗をもとにプロジェクトのCLAUDE.md指示ファイルとアーキテクチャを調整すれば、独自の学習なしでエージェントの成功率が上がることが少なくありません。
一般ユーザーは同じことができるのか
ここでの開発者としての評価は賛否が入り混じっており、ハードウェア、能力、安全性を分けて考える価値があります。
| 要素 | PewDiePieの環境 | 一般的なユーザー |
|---|---|---|
| ハードウェア | ハイエンドのマルチGPUワークステーション | ノートPC、多くはMacBook |
| モデル | 9Bモデルの独自ファインチューニング | 既製の量子化モデル |
| 報告された信頼性 | アシスタント作業で約90% | 未計測 |
能力については、小型ローカルモデルをめぐる熱狂には反論の余地があります。量子化したQwen 2.5やQwen 3 27Bをノートパソコンで動かして生成したコードは、現代のフロンティアモデルに遠く及ばず、同等を期待すると失望するでしょう。PewDiePieのファインチューニングはハードウェアのおかげでそうした妥協を一部回避できているかもしれませんが、そのハードウェアは大半の人が持っているものではありません。
PewDiePieはまた、パラメータ数10兆ともうわさされるフロンティアモデルをメールの仕分けに呼び出すのは無駄だと主張しています。同氏の試算では、1インスタンスに自身のマシン約27台分と、家庭150軒分の電力が必要になるといいます。これに対する反論は、フロンティアモデルはMixture-of-Expertsアーキテクチャを採用しており、クエリごとにパラメータの特化した一部だけが活性化されるため、リクエストあたりの計算量は額面の数字が示すよりはるかに少ないというものです。Claude SonnetやOpusのようなモデルは実際には十分に速く安価で、開発者は「適切なサイズ」の問題を考えすぎているのかもしれません。たとえとして挙げられるのがキッチンです。グリルドチーズサンドにプロ仕様の厨房は要りませんが、すでに稼働していて安いなら、使わない理由はありません。
安全性については、警告が最も強いものになります。モデルから拒否する能力を取り除くと、ネットワーク全体に副作用が及びます。安全性研究では、コードに狭い条件付きの脆弱性を仕込むようモデルをファインチューニングしたところ、コードとは無関係な脅迫、恐喝、暴力的なタスクを手助けする確率が8倍になったことが分かっています。DeepSeek v4.1の派生版のようなコミュニティ製の「obliterated(抹消済み)」重みは予測不能な振る舞いをし、デジタル上の危険物として扱うのが賢明です。こうしたモデルを隔離せずにローカルで動かした結果、家庭内ネットワークが侵害されたという報告もあります。ツール利用やネットワークアクセスを持つ無検閲モデルは、信頼できないソフトウェアとして扱い、それに応じてサンドボックス化すべきです。
検閲テストについての補足
PewDiePieは拒否問題の多くを過剰な検閲と捉えており、これを受けて中国のオープンモデル数種に「台湾は独立しているか」と問う簡単な検証を行いました。回答は大きく分かれました。Kimi K3、MiMo v2.5 Pro、DeepSeek v4.1 Flashは中国政府の公式見解を返しました。GLM 5.3、MiniMax M3、Qwen 3 27Bは、実質的な自治と外交上の承認を区別し、相対立する主張があることに触れる多角的な回答を返しました。開発者にとっての要点は政治ではなく方法論です。どのモデルであれ本番パイプラインに組み込む前に、標準的な機微プロンプトのセットを実行し、ハードコードされた立場がどこにあるかを把握しておくことです。
ここから何を学ぶか
PewDiePieのプロジェクトは、ハードウェアと忍耐力、そして研究論文を読む意欲を持つ個人が、ローカルのセルフホスト型AIをどこまで推し進められるかを示しています。同時に、その限界も示しています。ローカルモデルのプライバシー上の利点は本物であり、メール仕分けのような日常的な自動化は、AIをめぐる遠い約束よりも手触りのある成果です。しかし、民生用ハードウェア上の小型モデルは本格的な作業ではフロンティアモデルよりはるかに弱いままで、フロンティアラボは蒸留に対してAPIの防御を積極的に固めており、モデルから拒否機能を取り除くことは安全性とのトレードオフであって、無償のアップグレードではありません。
行動に移したい読者へのポイントは次のとおりです。
- プライバシーを重視するなら、機微な認証情報や家庭内ネットワークから隔離したマシンでOdysseusとAjaxを試し、粗削りな部分は覚悟しておく
- コーディングの能力を求めるなら、引き続きフロンティアモデルを使う。Mixture-of-Expertsのルーティングにより、規模から想像するよりリクエストあたりのコストは安い
- エージェントを構築しているなら、独自学習を検討する前に、すべての失敗を記録し、ログを評価とより良い指示ファイルに変換する
- 何を作るにせよ、基礎を学ぶ。PewDiePieはGitの講座を修了する前に、ブランチ操作のミスでOdysseusのリポジトリを失いかけた。AIはエンジニアを加速させるが、コードがどう構造化され、デバッグされ、デプロイされるかの理解に取って代わるものではない、というのが同氏の主張である


