Coder 是一家约 210 人的公司,主营远程开发环境,其在商业 AI 工具和 API 上的支出正逼近每年约 $500万。公司的应对之道并非全面用本地模型取代云端模型,而是按工作负载类型划出一条界线:开发者的交互式对话继续使用前沿云端模型,自动化后台机器人则通过内部网关路由到一个小型本地集群,并以云端模型作为后备。这一做法把一个文档检查机器人的成本从每月约 $1,750 降到了不足 $11,同时也暴露出几台桌面大小的 AI 盒子能力的上限。
为什么给每人发一台本地机器行不通
这场实验始于英伟达和戴尔与 Coder 联合赞助的一个会议展台。两家公司提供了一台 Dell Pro Max GB10(DGX Spark 级别的机器),配备 128 GB 统一内存。这台设备零售价约为 $8,000,不过价格会随内存配置和市场状况波动。展台上,Coder 的平台和开放模型直接跑在这台盒子上,数据不出机器,立刻引来员工们的需求:他们也想在自己桌上放一台。
早期的采用过程呈现出一种公司后来称为“本地 AI 死亡循环”的模式:
公司内部用租车来打比方:如果保时捷和旅行车的个人花费相同,所有人都会选保时捷。由此得出的结论是,给 200 多名员工每人购买一台 $8,000 的机器,只会造出一堆闲置硬件,而云端账单照样攀升。
通过网关路由到一个“虚拟模型”
Coder 没有放弃本地推理,而是改变了 AI 流量进入公司的方式。Claude.ai 和 ChatGPT 这类直接对话工具仍然直连各自的服务商。但编码工具、编码智能体和自动化工作流必须经过一个内部 AI 网关,由它负责安全过滤、访问控制、集中审计和模型路由。工程师、搭建自动化流程的财务人员,以及做功能原型的产品经理,用的都是这个网关之后的工具。
在模型下拉菜单里,团队在 Anthropic 和 OpenAI 的选项旁边加了一项,标为“Solstice (Austin Office)”。Solstice 是一个带故障转移逻辑的虚拟模型:
- 当请求指定 Solstice 时,网关会检查位于奥斯汀的本地集群是否在线、是否还有空闲的并发槽位。
- 如果有,请求就在本地运行,token 边际成本为零。
- 如果集群离线、断电或排队积压,请求会改道至云端的 Claude 3.5 Sonnet。
公司给出的类比是屋顶太阳能:光伏板以零可变成本覆盖白天的基线需求,高峰或停电时则由电网接管。即便有了这个零摩擦的选项,人类工程师在可以自由选择时,仍然倾向于直接选纯粹的前沿云端模型。
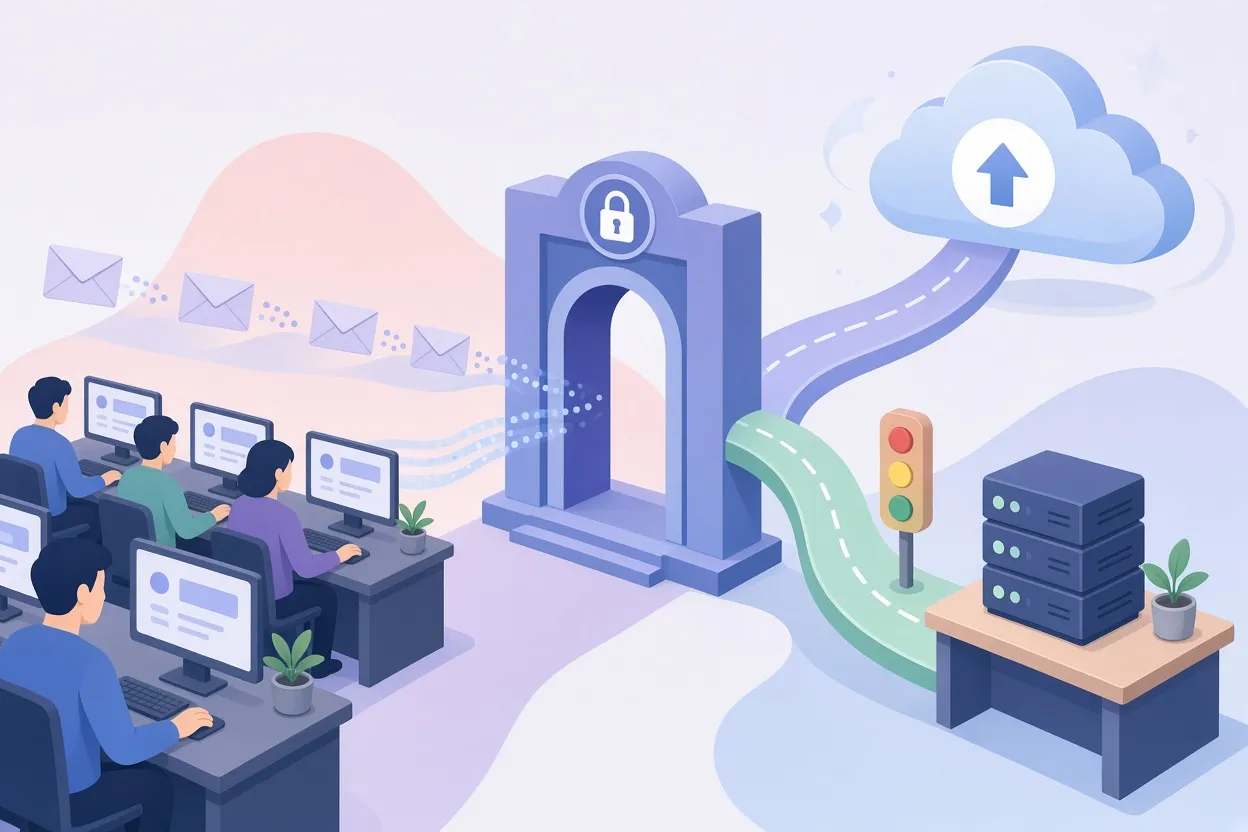
▲ 网关在本地集群与云端之间的路由
先从机器人入手,因为机器人没有偏好
突破口在于把目标从人转向自动化工作流。Coder 发现,无界面的自动化任务约占其编码 AI 支出的 20%,即每年约 $270万 中的大约 $54万;人类直接使用则占其余 80%,约 $220万。
团队选出了四个机器人:
- doc-check:扫描每个拉取请求,找出应随代码一同修改的文档。
- 代码审查:启动多个专门的智能体,检查拉取请求中的安全问题和架构契合度。
- 安全分诊:过滤数量不断增长的开源安全报告,包括欺诈性或 AI 生成的提交。
- 模块评分卡:评估提交到市场的集成模块的质量。
机器人是阻力最小的切入点,因为它们没有面向用户的模型选择器,平台工程团队可以完全掌控模型选择。平台工程师同时控制着提示词输入和程序化输出,这使得这些任务比开发者从零开始构建应用可预测得多。
doc-check 的数字
doc-check 由 Coder 的一名工程师开发,最初每个拉取请求都交给 Claude Opus 处理。每天 50 到 100 个拉取请求,每个都要跨多个文件发起多次工具调用,账单达到每月约 $1,750。迁移到本地集群并以 Sonnet 作为后备后,成本降到每月不足 $11,其中几乎全是电费。
| 项目 | 迁移前 | 迁移后 |
|---|---|---|
| 模型 | Claude Opus(云端) | 本地 LLM 集群,Claude Sonnet 后备 |
| 月成本 | 约 $1,750 | 不足 $11 |
| 年电费 | 不适用 | 每节点约 $160 |
| 按约 $8,000 零售价计算的硬件回本周期 | 不适用 | 约 4 到 4.5 个月 |
第一台机器是免费拿到的,但即便按全额零售价计算,仅这一个工作流省下的钱也能在四个多月内覆盖硬件成本。这个机器人的价值不止于成本:它会在合并前标出需要更新的具体章节,例如用户指南和 CLI 参考,技术写作团队因此不再需要频繁追着开发者要上下文。
让更小的模型胜任工作
迁移过程并不顺利。起初质量骤降,因为更小的开放权重模型无法像 Claude Opus 那样从简短提示词中推断意图。解决办法是回到两三年前风格的提示词工程:明确的执行顺序、强制的工具定义和清晰的格式规则。一项关键改动是强制模型先真正搜索一遍文档,再得出“无需更新”的结论。
评估方法与提示词同样重要。团队起初花了数周搭建一套自动化基准:由一个更强的 LLM 为最近 100 次历史 doc-check 运行打分。每次迭代耗时约 7 小时,通过率在 60.4% 和 85.4% 之间来回波动,始终无法收敛。团队随后改为人工打分:调整提示词,在一个专用 Slack 频道里观察机器人做出的决定,然后逐条手动判断。9 月 10 日到 9 月 12 日之间,团队以这种方式发布了数版提示词修订,手动评估了连续约 80 次运行,随后把 doc-check 永久切换到本地推理。公司的自我评估坦率承认,自动化评测框架可能本身就搭得不好,但对这个范围很窄的问题而言,人工循环明显更快。
扩展集群,区分同步与异步
硬件是逐步增加的,而非一次性上整机架:三台小型机箱叠放在办公室角落,靠一台台扇散热,另外还有几台寄给了在家运行服务器机架的远程工程师。把这些紧凑的机器组成集群,团队就能把算力和内存汇聚起来运行更大的模型。
一个名为 solstice-1 的路由层在集群内分配工作:
| 工作负载 | 目标 | 示例模型 |
|---|---|---|
| 异步、不紧急(doc-check、评分卡) | 单 GPU 上较慢、较小的模型 | Qwen 3.8 |
| 同步的开发者交互、更高层级的自动化 | 跨多 GPU 的更快、更大的模型 | DeepSeek V4 |
| 本地节点饱和时的溢出 | 云端后备 | Claude Sonnet |
具体模型被视为可互换的。新的开放模型层出不穷,所以团队认为真正持久的是路由逻辑,而不是当月流行的模型。
闲置硬件与 56 小时的 issue 审计
每周的利用率数据暴露了本地部署经济性上的问题:工作日白天出现短暂峰值,周末几乎空空如也。用云端 API 时,未使用的容量就是省下的钱;而硬件一旦买下,闲置时间就是无法收回的资本。开发者没有把本地选项用于同步对话,因为它明显更慢、能力更弱,平台团队也正因如此刻意不在内部推广它。
为了填补空档,团队转向夜间批处理任务。某天晚上,一个智能体被指示检查 coder/coder GitHub 仓库中的每一个开放 issue,为那些已在代码库中修复的问题起草关闭提案,并明确要求它不得自行关闭任何 issue。最初几次尝试让 DeepSeek 陷入了困惑,需要一个结构略强、分步迭代的提示词,任务才能稳定运行。
结果如下:
- 审计在一个周末跑了 56 小时,覆盖 756 个开放 issue,期间派生子智能体会话调查工单并交叉比对拉取请求。
- 它标记了约 100 个 issue 为已过时。
- 人工核查排名前 30 的提案,29 个正确,1 个误报。
- 禁止自动关闭,以免让社区贡献者感到沮丧。
这次运行并非零成本。路由器之前被配置为把本地队列积压视为故障,于是排队的提示词溢出到了 Claude Sonnet,产生了约 $130 的费用。据估算,同样的任务完全在 Claude Sonnet 上运行大约要 $1,100,因此净节省仍然可观,但教训是:对批处理任务要关闭激进的后备计时器,让它们老老实实在本地队列里排队等待。
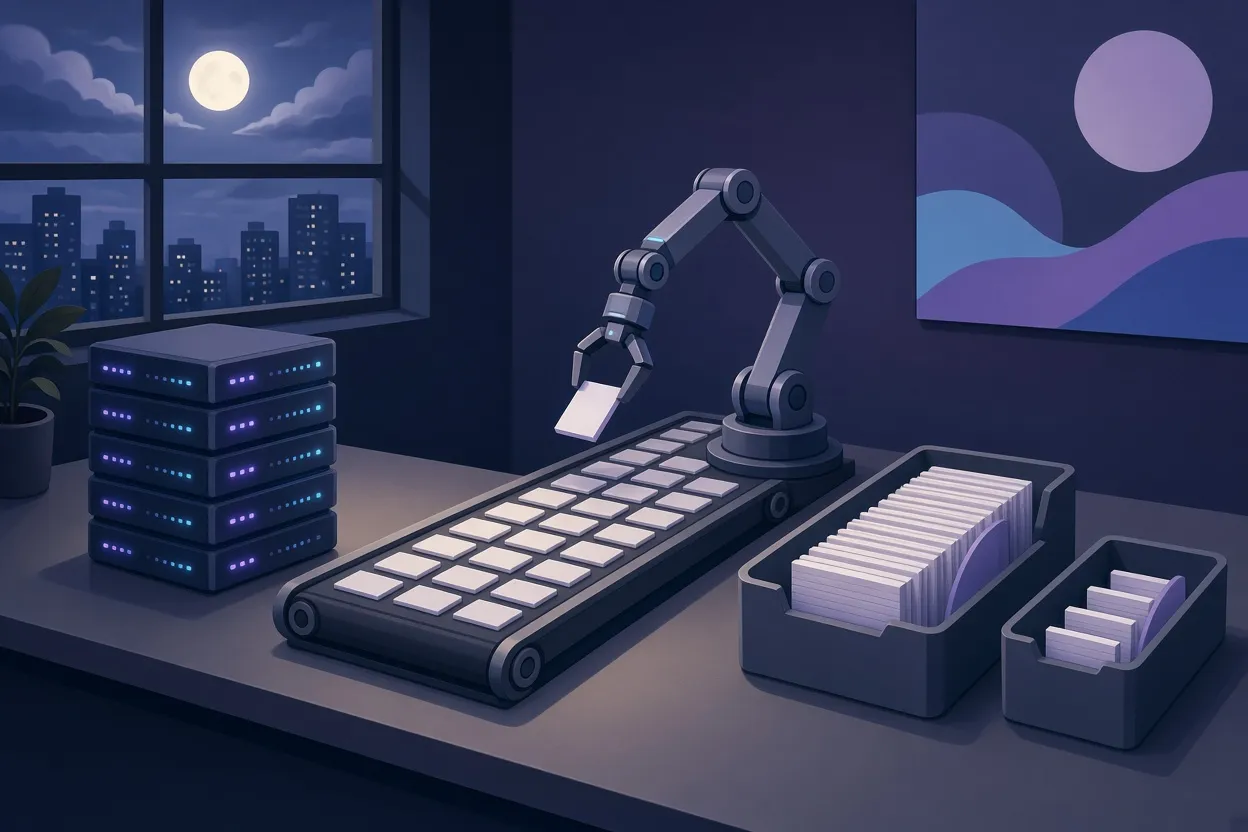
▲ 闲置本地硬件上的夜间批量分诊
几台盒子做不到的事
公司对上限说得很明白。两套 GB10 系统,大约 $2万 的硬件,远不足以抵消 $500万 的 AI 预算,因为这笔支出大部分来自实时交互式的开发者会话,而当前的本地模型在这类场景下比旗舰云端 API 更慢、更不聪明。要加快同步对话,需要的是高得多的统一内存带宽,而不只是更大的容量,这也是 Coder 已经预订了包括新款 Mac Studio 在内的更高端硬件、准备升级奥斯汀设施的原因。
还有几点影响着整体策略:
- 要快速见效,政策胜过基础设施。 据估算,仅仅是要求内部用量最大的重度用户节制消耗,就能把整体 AI 支出削减约 30%,远超复杂技术基础设施单独带来的效果。
- 不要用人头数去平均支出。 少数重度用户和程序化工作流会扭曲平均值。
- 基准测试不等于生产环境。 量化得分和排行榜数字往往无法预测一个模型能否完成真实的多步骤工作流。
- 对更小的模型要更少信任,而不是更多。 本地模型的内置防护比前沿模型少,所以智能体任务的安全必须来自基础设施:智能体工作负载运行在 Kubernetes Pod 内由 Terraform 管理的工作区中,配有受限的网络策略和 gVisor 微虚拟机隔离,让不受信任的执行远离开发者的笔记本电脑。
- 先分类,再推理。 网关上的轻量级分类器可以在任何 token 到达模型之前拦下工资记录等敏感材料,还能判断一个查询是否根本不需要 LLM。
- 托管的开放权重模型是一条中间路线。 Coder 已经在用云端托管的开放模型测试其智能体工具对不同后端的兼容性,而 AWS Bedrock 等服务上托管的开放权重模型成本远低于专有 API,因此是颇具吸引力的路由目标。
网关本身分为三层:Coder AI Gateway 负责身份验证、用户归属、团队预算和审计日志;Bifrost 是一个开源的自托管网关,负责路由规则和端点切换;另有一个定制的遥测垫片,把实时的硬件温度、显存占用和队列深度喂给 Bifrost,使流量跟随实际容量流动。
路线图上的下一步包括:把客户通话记录分析等敏感工作流迁移到本地模型;用本地模型处理轻量级的智能体编排和 Slack 机器人触发;用仓库审计和基于脱敏交互日志构建的离线强化学习流水线填满非高峰时段的容量。对 Coder 而言,降低成本是次要的,首要动机是亲手摸透这套架构,以便为企业客户提供建议。
从 Coder 的经验中能学到什么
本地部署 AI 的主要风险不在于正常运行时间或购买价格,而在于采用率:昂贵的机器因为没人把工作路由过去而闲置。如果你在考虑本地模型,切实可行的操作顺序如下:
- 先把所有程序化 AI 流量放到网关之后,这样之后添加预算、过滤和路由时无需触碰单个工具。
- 购买任何东西之前,先审计账单中的重度用户和机器人;一项预算政策省下的钱可能比硬件更多。
- 从文档检查、代码审查和 issue 分诊等已被验证的异步任务开始,这些场景速度不那么重要,单 token 成本才是关键。
- 为更小的模型重写提示词,给出明确的分步指令,并手动评估 50 到 100 条真实输出,而不是搭建一套耗时数小时的基准评测框架。
- 保留云端后备以应对峰值,但要调好参数,让批处理任务在本地排队,而不是悄悄花掉云端的钱。
- 在基础设施层面给每个智能体加上沙箱,凡是触及公开仓库或敏感数据的操作都保留人工核验。
从这些证据看,本地推理在重复性的后台工作上能很快收回成本,而在交互式编码上仍然难以替代前沿模型。把这两者当作两个不同的问题来处理,正是这套策略奏效的原因。


