직원 약 210명 규모의 개발 플랫폼 기업 Coder는 상용 AI 도구와 API 비용이 연 $500만에 이를 추세였습니다. 이 회사가 직접 겪은 로컬 LLM 운영 경험의 결론은 분명합니다. 모든 prompt에 최상위 모델이 필요하지는 않지만, 모델 선택을 사람에게 맡기면 로컬 모델은 쓰이지 않는다는 것입니다. 그래서 Coder는 사람이 아니라 자동화 bot이 쓰는 작업부터 로컬 모델로 옮겼고, 한 작업의 월 비용이 $1,750에서 $11 미만으로 떨어졌습니다. 다만 $500만 예산의 대부분을 차지하는 실시간 개발자 chat은 아직 로컬 모델이 대체하지 못한다는 점도 함께 짚었습니다.
시작은 $8,000짜리 상자 하나
Coder는 소프트웨어 엔지니어, 데이터 과학자, 자율 agent를 위한 원격 개발 환경을 만드는 회사입니다. 지난 1년 사이 회사 규모가 두 배로 커졌고, 엄격한 규제에 묶인 조직이 아니어서 엔지니어링부터 재무까지 모든 부서가 상용 AI 도구를 폭넓게 써 왔습니다. 그 결과 내부 계산으로 연 $500만의 AI 비용이 예상됐습니다.
이 금액을 직원 수로 나누면 1인당 비용이 부풀려 보이지만, 실제로는 소수의 heavy user와 자동화된 프로그램 작업이 지출을 크게 끌어올리고 있었다고 합니다. 회사 전체 AI 비용을 볼 때 사람 수로 단순히 나누지 말라는 조언이 여기서 나옵니다.
로컬 모델 실험의 계기는 하드웨어였습니다. NVIDIA와 Dell이 Coder와 함께 행사 부스를 후원하면서 Dell Pro Max GB10(DGX Spark) 데모 장비를 제공했습니다. 통합 메모리 128GB로 규모가 있는 open-weight 모델(가중치가 공개된 모델)을 돌릴 수 있고, 소매가는 약 $8,000입니다. 메모리 구성과 시장 상황에 따라 가격 변동이 크다는 단서가 붙습니다. 이 장비에서 데이터가 외부로 나가지 않는 격리된 개발 환경과 로컬 추론을 함께 시연하자, 직원들이 자기 책상에도 이런 상자를 놓을 수 없느냐고 잇달아 물었습니다.
로컬 AI 죽음의 고리
추가 장비를 들였지만 곧 '로컬 AI 죽음의 고리'라고 부르는 실패 패턴에 빠졌습니다. 네 단계로 반복됩니다.
- 엔지니어가 자기 장비에 Ollama나 vLLM을 설치합니다.
- Qwen 2.5 72B 같은 인기 open-weight 모델을 올립니다.
- 실제 업무에 써 봅니다.
- 클라우드 frontier 모델보다 느리거나 추론이 떨어진다고 느끼고 클라우드 API로 돌아갑니다.
이 행동을 렌터카에 비유합니다. 본인 부담이 똑같다면 Porsche와 평범한 왜건 중에 모두 Porsche를 고른다는 것입니다. 회사가 비용을 대는 한 엔지니어는 거의 항상 가장 높은 등급의 클라우드 모델을 고릅니다. 구조적인 장치 없이 200명 넘는 직원에게 $8,000짜리 장비를 사 주면 장비는 먼지만 쌓이고 클라우드 비용은 그대로일 것이라는 판단이 섰습니다.
gateway와 가상 모델 Solstice
Coder는 AI 사용 경로를 두 갈래로 나눴습니다. Claude.ai나 ChatGPT 같은 직접 chat은 그대로 클라우드 제공사에 연결합니다. 대신 코딩 도구, 코딩 agent, 자동화 workflow의 요청은 모두 내부 AI Gateway(모든 AI 요청이 거쳐 가는 중계 계층)를 통과하도록 의무화했습니다. 이 gateway가 보안 필터링, 접근 제어, 중앙 감사, 모델 라우팅을 맡습니다. 엔지니어뿐 아니라 내부 자동화를 만드는 재무 담당자, 기능을 prototype하는 product manager도 이 경로를 씁니다.
그리고 모델 선택 목록에 Anthropic과 OpenAI 모델 옆에 'Solstice (Austin Office)'라는 항목을 추가했습니다. Solstice는 실제 모델이 아니라 라우팅 규칙을 가진 가상 모델입니다.
| 상황 | 처리 경로 | 비용 |
|---|---|---|
| Austin 본사의 로컬 cluster가 정상이고 동시 처리 여유가 있음 | 로컬 LLM cluster | token당 한계 비용 $0 |
| cluster가 꺼져 있거나 정전, 또는 요청이 밀려 있음 | Anthropic의 Claude 3.5 Sonnet | token당 과금 |
주택 태양광에 빗댄 설명이 이해하기 쉽습니다. 낮의 기본 전력은 태양광이 추가 비용 없이 감당하고, 소비가 몰리거나 해가 없을 때는 전력망에서 끌어 쓰는 방식입니다. 그런데 이렇게 마찰 없는 하이브리드 모델을 만들어도 사람 엔지니어는 여전히 순수 frontier 모델을 골랐습니다.
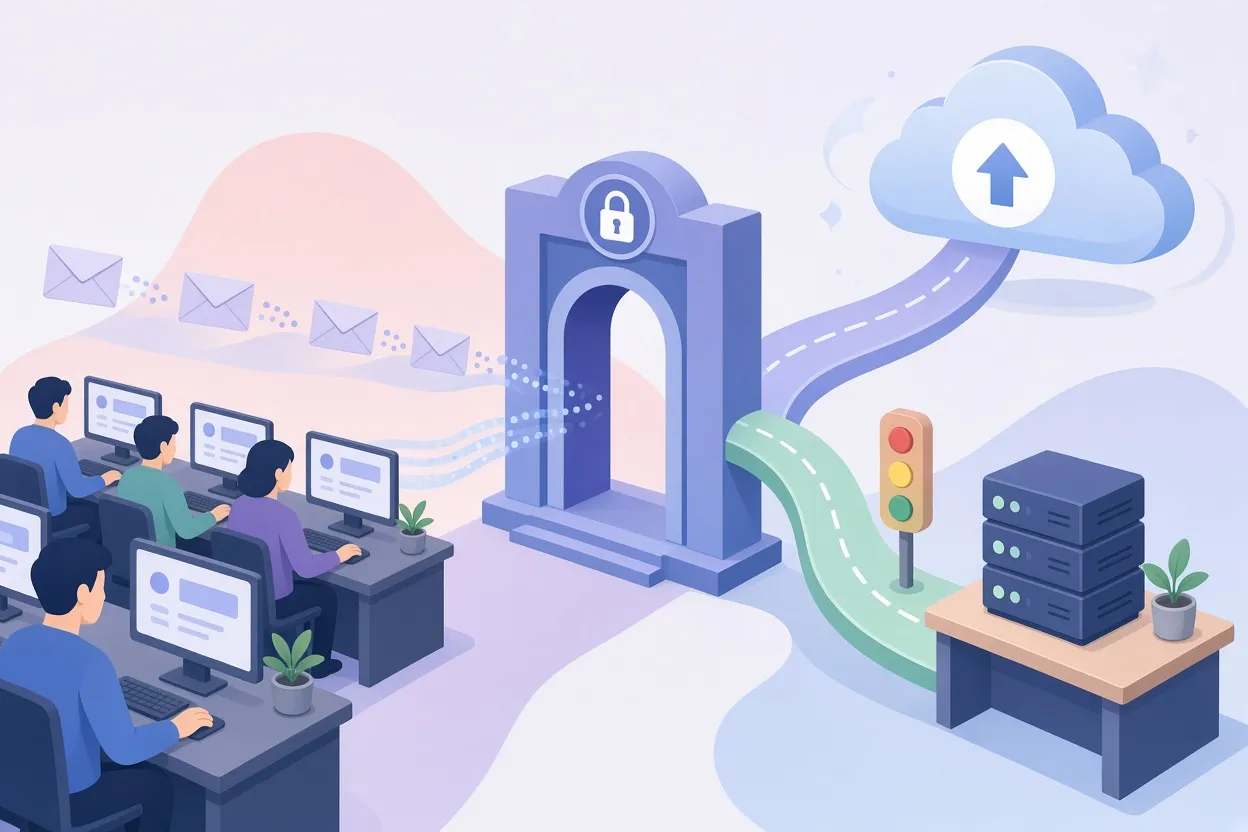
▲ 로컬 우선 라우팅 구조
사람 대신 bot부터
그래서 첫 적용 대상을 모델 취향이 없는 자동화 'robot'으로 바꿨습니다. Coder의 코딩 관련 AI 비용은 연 약 $270만인데, 이 가운데 80%(약 $220만)가 사람의 직접 사용이고 20%(약 $54만)가 headless 자동화 작업이었습니다. 자동화 작업은 네 가지입니다.
- doc check: pull request를 검사해 관련 문서가 함께 갱신됐는지 확인
- code review: 여러 전문 agent를 띄워 보안 취약점과 아키텍처 정합성을 점검
- security triage: 쏟아지는 오픈소스 보안 제보에서 허위나 AI 생성 스팸을 걸러 엔지니어 시간 보호
- module scorecard: integration marketplace에 제출된 모듈의 품질을 LLM으로 평가
bot을 먼저 고른 이유는 명확합니다. bot에는 사용자용 모델 선택 메뉴가 없어 플랫폼 엔지니어링 팀이 모델을 전적으로 통제할 수 있고, prompt 입력과 프로그램 출력이 모두 통제돼 사람이 처음부터 vibe coding하는 경우보다 훨씬 결정적입니다. 온프레미스 컴퓨팅을 세우는 가장 마찰 적은 입구였던 셈입니다.
doc-check: 월 $1,750에서 $11 미만으로
첫 성공 사례는 한 엔지니어가 만든 doc-check입니다. 개발자가 pull request를 올리면 자동으로 코드 변경을 읽고 사용자 가이드나 CLI 레퍼런스 같은 문서를 고쳐야 하는지 댓글로 알려 줍니다. 예를 들어 새 --dry-run 플래그를 문서에 빠뜨린 pull request를 잡아내는 식입니다. 이전에는 문서 없이 기능이 출시되는 일이 잦았고 technical writer가 개발자를 찾아다녀야 했는데, 이 부담이 크게 줄었습니다.
문제는 비용이었습니다. 처음에는 별생각 없이 모든 pull request를 Claude Opus로 돌렸는데, 하루 50~100건의 pull request마다 여러 파일에 걸친 tool call이 여러 번 발생해 월 $1,750이 나왔습니다. 로컬 cluster로 옮기고 Sonnet을 fallback으로 둔 뒤에는 월 $11 미만이 됐습니다. 이 금액은 대부분 전기료로, 장비 한 대가 연 약 $160의 전기를 씁니다. 첫 장비는 무상으로 받았지만 소매가 $8,000을 다 치렀더라도 이 작업 하나로 넉 달 남짓이면 회수된다는 계산입니다.
작은 모델에는 2~3년 전 방식의 prompt가 필요하다
전환은 순탄하지 않았습니다. 작은 모델은 짧은 prompt에서 의도를 추론하지 못해 기본 점검에서 계속 실패했고, 처음에는 겁이 날 정도였다고 합니다. 해법은 두 가지였습니다.
첫째, 평가 방식을 바꿨습니다. 처음에는 더 똑똑한 LLM이 최근 100건의 doc-check 실행을 채점하는 자동 benchmark pipeline을 몇 주에 걸쳐 만들었습니다. 그런데 한 번 돌리는 데 약 7시간이 걸렸고 통과율은 60.4%에서 85.4% 사이를 오가며 일관성 없이 정체됐습니다. 결국 prompt를 고치고 bot의 판단을 직접 눈으로 확인하는 수동 채점으로 바꾸자 훨씬 빠르고 효과적이었습니다. 내부 Slack 채널로 실행 결과를 실시간으로 받아 약 80건을 연속으로 손으로 채점한 뒤 로컬 추론으로 완전히 전환했습니다. benchmark에 서툰 탓일 수도 있다는 단서를 달면서도, 이 문제에는 수동 채점이 훨씬 실용적이었다는 입장입니다.
둘째, prompt를 다시 썼습니다. 9월 10일부터 12일 사이 여러 pull request로 시스템 지시를 다듬었습니다. 문서가 필요 없다고 결론 내리기 전에 반드시 문서를 먼저 검색하게 강제하고, 단계별 절차를 항목으로 못 박았습니다. 명시적인 실행 순서, 필수 tool 정의, 명확한 형식 규칙처럼 2~3년 전에 쓰던 prompt 기법이 작은 모델에는 다시 필요하다는 교훈입니다.
하드웨어는 조금씩, 라우팅은 두 층으로
doc-check가 자리 잡은 뒤에도 데이터센터 rack을 한 번에 들이지 않고 조금씩 늘렸습니다. 초기 구성은 사무실 구석에 소형 AI 박스 세 대를 쌓고 탁상용 선풍기로 식히는 수준이었고, 원격 근무 엔지니어 몇 명에게는 장비를 보내 집의 서버 rack에서 dogfooding하게 했습니다. 소형 장비 여러 대를 cluster로 묶어 더 큰 모델을 돌리면서 자본 위험은 낮추고 clustering과 발열에 대한 운영 경험을 쌓았습니다.
세 대를 고르게 쓰기 위해 solstice-1이라는 다층 라우팅을 만들었습니다.
| 작업 성격 | 배정 모델 | 예 |
|---|---|---|
| 비동기, 시간에 민감하지 않은 작업 | GPU 한 장에서 도는 느리고 작은 모델 (예: Qwen 3.8) | doc-check, module scorecard |
| 동기 개발자 상호작용, 상위 자동화 | 여러 GPU에 분산된 더 빠르고 큰 모델 (예: DeepSeek V4) | 실시간 요청 |
| 로컬 노드 과부하 | 클라우드의 Claude Sonnet | 넘치는 요청 |
여기서 강조하는 점은 특정 모델 이름이 아니라 라우팅 논리입니다. 새 open 모델이 계속 나오므로 Qwen이나 DeepSeek 같은 선택은 금방 바뀌고, 유연한 구조가 훨씬 오래 간다는 것입니다.
▲ 주말 야간 issue 일괄 점검
주말에 놀던 장비로 756개 issue 점검
주간 사용량을 보니 평일 낮에 잠깐 치솟고 주말에는 거의 비어 있었습니다. 클라우드는 안 쓰면 돈이 절약되지만 온프레미스 장비는 안 쓰면 투자금이 회수되지 않으므로, 경제 논리가 정반대입니다. 그런데 동기 chat에서는 로컬 모델이 눈에 띄게 느리고 덜 똑똑하게 느껴져 엔지니어가 자발적으로 쓰지 않았고, 플랫폼 팀도 품질이 못 미친다는 걸 알기에 내부 홍보를 꺼렸습니다.
그래서 사람에게 강요하는 대신 야간과 주말의 무거운 배치 작업으로 눈을 돌렸습니다. 밤늦게 agent에 내린 지시는 이렇습니다. Coder의 오픈소스 저장소 coder/coder에 열린 모든 issue를 살펴보고, 이미 코드베이스에서 해결된 issue를 닫자는 제안서를 만들되 직접 닫지는 말라는 것입니다. 이 저장소에는 팀 여력 부족으로 중복 bug 제보나 다른 pull request로 이미 고쳐진 기능 요청이 쌓여 있었고, 수백 건을 여러 단계로 조사하는 작업을 클라우드 모델로 돌리면 비용이 너무 크고 위험했습니다.
처음에는 DeepSeek이 혼란에 빠져 조금 더 구조화된 반복형 prompt로 바꿔야 했습니다. 적절한 반복 scaffolding과 오류 수정 지시를 주면 요즘 로컬 모델도 복잡한 다단계 지시를 처리할 수 있다는 것이 경험담입니다. 결과는 다음과 같습니다.
- 756개 open issue를 56시간 동안 중단 없이 처리하고, 비어 있던 주말 용량을 채움
- agent가 issue별로 독립된 sub-agent 세션을 띄워 코드베이스와 pull request를 교차 확인
- 약 100개 issue를 닫을 수 있는 오래된 issue로 식별
- 커뮤니티 반발을 막기 위해 자동 닫기는 금지하고 상위 30개 제안을 직접 검증한 결과 29개가 정확, 오탐 1개
비용에는 예상 밖의 교훈이 있었습니다. 라우터의 fallback 설정이 지나치게 공격적이어서 로컬 노드의 대기열을 장애로 오판했고, 밀린 prompt가 클라우드로 넘어가 Claude Sonnet에 $130이 청구됐습니다. 전부 Sonnet으로 돌렸다면 약 $1,100이었을 것이므로 절감 폭은 여전히 컸지만, 배치 작업에서는 fallback 타이머를 느슨하게 해 로컬에서 기다리게 해야 한다는 점을 배웠습니다. 며칠짜리 agent 작업은 끝날 때까지 결과 품질을 볼 수 없어 불안이 크다는 솔직한 토로도 있었습니다.
비용과 품질이 갈리는 지점
운영에서 얻은 교훈은 세 가지로 요약됩니다.
- 장비는 예측 가능하고 양이 많은 비동기 작업에 전담시키면 상쇄된 비용으로 금방 본전을 뽑습니다. doc-check는 4.5개월 안에 장비 값을 회수했습니다.
- 검증된 비동기 workflow부터 시작하고, 지연에 민감한 개발자 chat 대체는 나중으로 미룹니다.
- benchmark에 매달리지 않습니다. quantization 점수나 초당 token 수 같은 수치는 모델이 실제 production workflow를 끝까지 해내는지 알려 주지 못하는 경우가 많습니다.
한계도 분명합니다. GB10 두 대, 약 $2만의 장비로는 동기 chat이 대부분인 $500만 지출을 상쇄할 수 없습니다. 동기 chat의 응답 속도를 높이려면 메모리 용량(128GB냐 256GB냐)보다 통합 메모리 대역폭이 훨씬 높은 장비가 필요하다고 봅니다. Coder는 새 Mac Studio를 비롯한 고급 장비를 선주문해 쌓아 둔 개발 박스 수준의 Austin 데이터센터를 개선할 계획입니다.
더 눈여겨볼 대목은 기술보다 정책이 먼저라는 결론입니다. 내부의 상위 power user 몇 명에게 과도한 사용을 자제해 달라고 요청하는 것만으로 전체 AI 지출이 30% 줄어든다고 추정합니다. 엄격한 예산, 모델 라우팅, 로컬 LLM을 조합하면 OpenAI나 Anthropic 같은 특정 업체에 묶이는 위험도 줄어듭니다. 모든 요청이 하나의 gateway를 거치기 때문에 이런 비용 통제를 개별 앱을 고치지 않고 덧붙일 수 있다는 점이 구조의 장점입니다. 온프레미스 장비가 순수 클라우드 최적화보다 비용 효율이 가장 높은 길은 아니라고 인정하면서도, 기업 고객을 안내하기 위한 아키텍처 이해라는 본래 목적에서 매우 유익했다는 평가입니다.
보안과 governance: 작은 모델은 덜 믿고 sandbox로 막는다
보안이 중요한 agent 작업에 로컬 모델을 믿어도 되는지에 대한 Coder의 판단은 오히려 반대입니다. 작은 로컬 모델은 frontier 모델만큼 alignment와 guardrail을 갖추지 못했으므로 덜 믿어야 하고, 안전은 모델 행동이 아니라 인프라 격리에서 나와야 한다는 것입니다. Coder는 Terraform으로 선언한 가상 개발 workspace 안에서 agent를 돌리고, Kubernetes pod에 제한된 네트워크 정책과 gVisor microVM 같은 런타임 격리를 적용합니다. Daytona 같은 sandbox 플랫폼도 검토 중이며 Kubernetes의 Agent Sandbox SIG에도 참여합니다. 핵심 원칙은 신뢰할 수 없는 agent 실행을 개발자 노트북에서 떼어내 감시되는 인프라 안에 가두는 것입니다.
gateway 앞단의 가벼운 classifier도 중요하게 봅니다. 급여 정보 같은 기밀을 prompt에 붙여 넣으면 모델에 보내기 전에 차단하고, 요청이 정말 고급 LLM이 필요한지 아니면 단순한 프로그램 논리로 답할 수 있는지 가리는 용도입니다. 내부 compliance 팀과 기업 고객 모두 이런 입력 분류와 governance를 기업용 AI 인프라의 필수 요소로 본다고 합니다.
실제 라우팅 스택은 세 층입니다.
| 층 | 구성 요소 | 역할 |
|---|---|---|
| 1 | Coder AI Gateway | 개발자 인증, 사용자별 귀속, 팀 예산, 세션 감사 로그 |
| 2 | Bifrost (오픈소스 self-hosted AI gateway) | 다중 모델 라우팅 규칙과 endpoint 전환 |
| 3 | 자체 제작 telemetry shim | 장비 온도, 사용 중인 VRAM, 대기 중인 요청 수를 실시간으로 Bifrost에 전달 |
AWS Bedrock 같은 클라우드의 open-weight 모델도 agent 도구의 호환성 테스트에 자주 쓰며, 상용 API보다 훨씬 저렴해 자동 라우팅 후보로 매력적이라고 평가합니다. 특정 라우터 제품을 추천하기보다 개념과 pipeline 설계를 강조하는 이유는 개념이 구현보다 오래가기 때문입니다.
정리: 로컬 LLM을 검토하는 팀이 할 일
Coder의 경험이 보여 주는 역할 분담은 단순합니다. 입력과 출력을 통제할 수 있는 비동기 bot 작업과 야간 배치 작업은 로컬 모델이 맡고, 지연에 민감한 실시간 chat은 frontier 클라우드 모델이 맡습니다. 그리고 가장 큰 위험은 장비 가격이 아니라 아무도 쓰지 않는 장비입니다. 앞으로 Coder는 고객 통화 transcript 분석처럼 민감한 데이터가 외부로 나가지 않아야 하는 업무, code-review agent를 띄우거나 Slack bot을 호출하는 가벼운 orchestration, 저장소 감사와 정제된 로그로 만드는 강화학습 pipeline을 로컬로 더 옮기고, San Francisco·Austin·London 사무실과 개별 엔지니어 책상에 장비를 배치할 계획입니다.
같은 길을 검토하는 팀이라면 다음 순서가 현실적으로 보입니다.
- AI 비용을 사람 수로 나누지 말고 power user와 자동화 작업이 각각 얼마를 쓰는지 먼저 분해합니다. 정책만으로 줄일 여지가 크다면 거기서 시작합니다.
- 코딩 도구와 agent의 요청을 하나의 gateway로 모아 감사, 예산, 라우팅을 한곳에서 적용할 수 있게 만듭니다.
- 모델 선택 메뉴가 없는 bot 작업(문서 점검, code review, triage)부터 로컬 모델로 옮기고, 클라우드 fallback을 반드시 둡니다.
- 작은 모델에는 검색 순서와 단계를 명시한 prompt를 쓰고, 긴 자동 benchmark 대신 실제 production 출력 50~100건을 직접 채점합니다.
- 배치 작업에서는 fallback 타이머를 느슨하게 해 예상 밖의 클라우드 과금을 막고, agent가 저장소를 직접 바꾸지 못하게 한 뒤 사람이 검증합니다.
- 로컬 모델일수록 모델을 믿지 말고 네트워크 정책, 컨테이너 경계, microVM으로 격리합니다.
동기 chat까지 로컬로 바꾸는 일은 메모리 대역폭이 더 높은 장비와 함께 다음 단계로 남겨 두는 편이 현재로서는 합리적이라는 것이 이 사례가 주는 판단 기준입니다.


