リモート開発環境を手がける従業員約210人の企業Coderは、商用AIツールとAPIへの支出が年間約$500万に向かいつつありました。同社の対応は、クラウドモデルをローカルモデルに全面的に置き換えることではありませんでした。代わりに、ワークロードの種類で線を引いたのです。開発者との対話型チャットはフロンティア級のクラウドモデルに残し、自動化されたバックグラウンドのボットは社内ゲートウェイを通じてオンプレミスの小規模クラスターに振り分け、クラウドモデルをバックアップに据えました。この方法で、ドキュメントの更新漏れを確認するボットのコストは月約$1,750から$11未満に下がりましたが、同時に、デスクトップサイズのAIボックス数台でできることの限界も浮き彫りになりました。
ローカルマシンを配るだけではうまくいかなかった理由
実験の発端は、NVIDIAとDellがCoderと共同でカンファレンスのブースを出展し、128GBのユニファイドメモリを搭載したDell Pro Max GB10(DGX Spark級のマシン)を提供したことでした。この機種の小売価格はおよそ$8,000ですが、メモリ構成や市況によって変動します。ブースでは、データを一切外に出さずにこのマシン上でCoderのプラットフォームとオープンモデルを動かしたところ、自分の机にも1台欲しいという社員からの要望がすぐに寄せられました。
初期の導入は、社内で「ローカルAIの死のループ」と呼ばれるようになったパターンをたどりました。
- エンジニアがローカルマシンにOllamaやvLLMをインストールする。
- Qwen 2.5 72Bのような人気のオープンウェイトモデルを読み込む。
- 実際の日常業務で試す。
- フロンティア級クラウドモデルより応答が遅い、あるいは推論が弱いと感じて、クラウドに戻る。
社内で使われたたとえはレンタカーです。同じ自己負担でポルシェとステーションワゴンを選べるなら、誰もがポルシェを選びます。結論は、200人を超える社員に$8,000のマシンを購入しても、ハードウェアは遊んだままクラウドの請求額は上がり続ける、というものでした。
「仮想モデル」を使ったゲートウェイ経由のルーティング
Coderはローカル推論を諦める代わりに、AIトラフィックが社内に入る経路を変えました。Claude.aiやChatGPTのような直接のチャットツールは引き続き各プロバイダーに直接接続します。一方、コーディングツール、コーディングエージェント、自動化ワークフローは、セキュリティフィルタリング、アクセス制御、一元的な監査、モデルルーティングを担う社内のAI Gatewayを必ず経由しなければなりません。エンジニアも、自動化を構築する財務担当者も、機能のプロトタイプを作るプロダクトマネージャーも、すべてこのゲートウェイの背後にあるツールを使います。
モデル選択のドロップダウンには、AnthropicとOpenAIの選択肢の隣に「Solstice (Austin Office)」という項目が追加されました。Solsticeはフェイルオーバーのロジックを備えた仮想モデルです。
- リクエストがSolsticeを指定すると、ゲートウェイはオースティンのオンプレミスクラスターがオンラインで、同時実行の空き枠があるかを確認します。
- 空きがあれば、リクエストはトークンあたりの限界コストゼロでローカル実行されます。
- クラスターがオフライン、電源断、あるいは処理待ちで詰まっている場合、リクエストはクラウドのClaude 3.5 Sonnetに迂回します。
ここで示されたたとえは屋上の太陽光発電です。パネルが日中のベースライン需要を変動費なしでまかない、ピーク時や停電時には送電網が引き継ぎます。こうした摩擦のない選択肢があっても、人間のエンジニアは選べるなら純粋なフロンティア級クラウドモデルを選ぶ傾向が続きました。
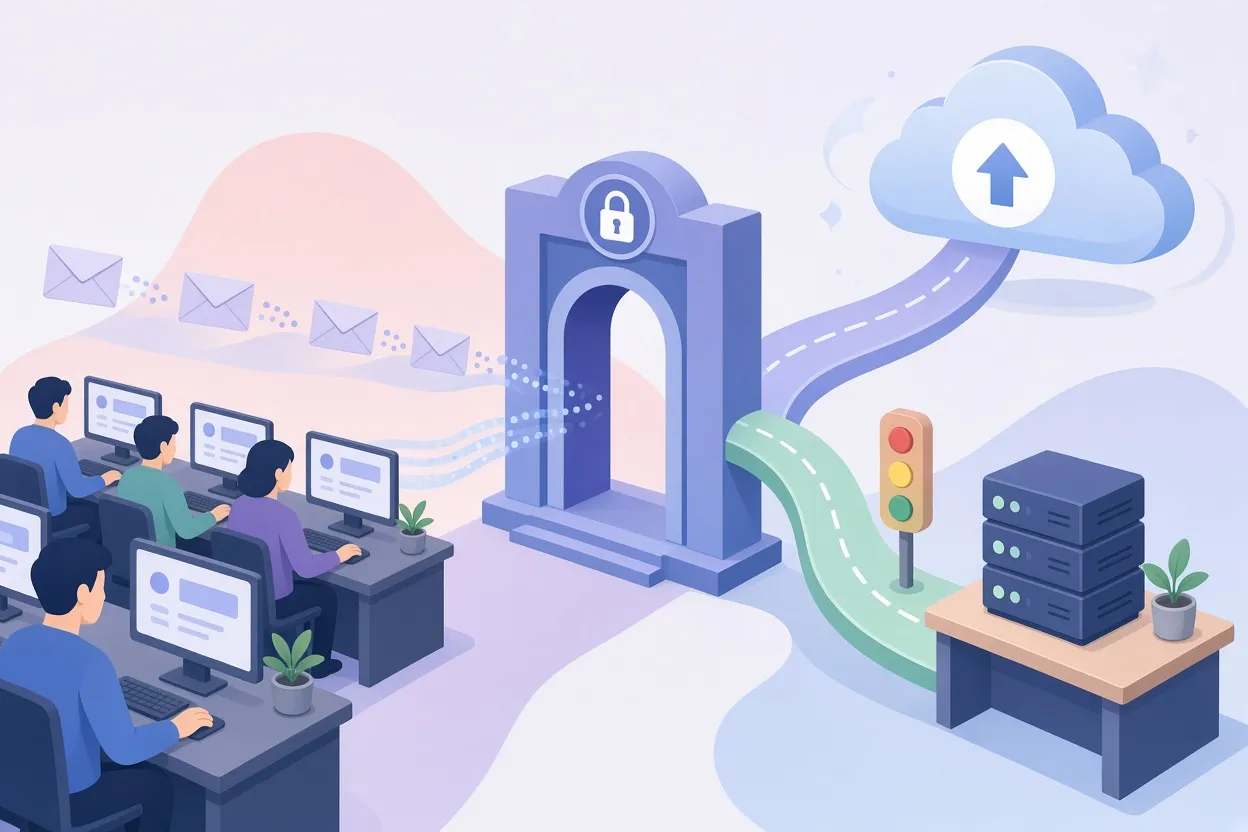
▲ ローカルクラスターとクラウドを振り分けるゲートウェイ
まずはボットから、ボットには好みがないので
突破口は、人ではなく自動化ワークフローを対象にしたことから開けました。Coderの調べでは、ヘッドレスの自動処理がコーディングAI支出の約20%、年間約$270万のうちおよそ$54万を占め、残りの80%にあたる約$220万は人間による直接利用でした。
4つのボットが選ばれました。
- doc-check:すべてのプルリクエストを走査し、コードの変更に合わせて更新すべきドキュメントを探します。
- コードレビュー:複数の専門エージェントを立ち上げ、プルリクエストのセキュリティ上の問題やアーキテクチャとの整合性を確認します。
- セキュリティトリアージ:増え続けるオープンソースのセキュリティ報告を選別します。不正なものやAI生成の投稿も含まれます。
- モジュールスコアカード:マーケットプレイスに投稿されたインテグレーションの品質を評価します。
ボットが最も摩擦の少ない入り口だったのは、ユーザー向けのモデル選択がなく、プラットフォームエンジニアリングチームがモデルの選択を完全に握れるからです。プラットフォームエンジニアはプロンプトの入力もプログラムによる出力も制御できるため、こうしたジョブは、開発者がゼロからアプリを作る場合よりはるかに予測しやすくなります。
doc-checkの数字
doc-checkはCoderのエンジニアが構築したもので、当初はすべてのプルリクエストをClaude Opusで処理していました。1日50から100件のプルリクエストがあり、それぞれが多数のファイルにわたって複数のツール呼び出しを行うため、請求額は月約$1,750に達していました。Sonnetをフォールバックとするローカルクラスターに移行した後、コストは月$11未満に下がり、そのほぼすべてが電気代です。
| 項目 | 移行前 | 移行後 |
|---|---|---|
| モデル | Claude Opus(クラウド) | ローカルLLMクラスター、Claude Sonnetにフォールバック |
| 月額コスト | 約$1,750 | $11未満 |
| 年間電気代 | 該当なし | ノードあたり約$160 |
| 小売価格約$8,000でのハードウェア回収期間 | 該当なし | 約4から4.5カ月 |
最初の1台は無償でしたが、仮に小売価格の満額を払ったとしても、このワークフロー1つの節約額で4カ月あまりでハードウェア代を回収できます。このボットの価値はコストにとどまりません。マージ前にユーザーガイドやCLIリファレンスなど更新が必要な箇所を具体的に指摘するため、テクニカルライティングチームが開発者を追いかけて背景を聞き出す必要が減りました。
小さなモデルに仕事をさせるには
移行は順調ではありませんでした。小さなオープンウェイトモデルはClaude Opusのように短いプロンプトから意図を推し量れず、当初は品質が急落したのです。対策は、2、3年前を思わせるスタイルのプロンプトエンジニアリングでした。明示的な実行手順、必須のツール定義、明確な書式ルールです。重要な変更の1つは、更新すべきドキュメントはないと結論づける前に、モデルに実際にドキュメントを検索させることでした。
評価方法はプロンプトと同じくらい重要でした。チームはまず数週間かけて、より強力なLLMが直近100件のdoc-check実行履歴を採点する自動ベンチマークを構築しました。しかし1回の反復に約7時間かかり、合格率は60.4%と85.4%の間を行き来して収束しませんでした。そこでチームは手動採点に切り替えました。プロンプトを調整し、専用のSlackチャンネルに届くボットの判断を見て、手作業で評価する方法です。9月10日から9月12日の間に、この方法で複数のプロンプト改訂を投入し、連続する約80回の実行を手で採点したうえで、doc-checkを恒久的にローカル推論へ切り替えました。自己評価では、自動化した評価基盤の作りが悪かった可能性も率直に認めていますが、この狭い問題に対しては手動のループが明らかに速かったのです。
クラスターの拡張と同期・非同期の分離
ハードウェアはフルラックではなく段階的に増えました。オフィスの隅に小型フォームファクターのマシン3台を積み上げ、卓上扇風機で冷却し、さらに自宅にサーバーラックを持つリモートのエンジニアにも機器を送りました。小型マシンをクラスター化することで、より大きなモデル向けに計算資源とメモリをプールできます。
solstice-1と呼ばれるルーティング層が、クラスター全体に仕事を振り分けます。
| ワークロード | 振り分け先 | モデルの例 |
|---|---|---|
| 非同期で急がない処理(doc-check、スコアカード) | 単一GPU上の遅く小さなモデル | Qwen 3.8 |
| 開発者との同期的なやり取り、高度な自動化 | 複数GPUにまたがる速く大きなモデル | DeepSeek V4 |
| ローカルノードが飽和したときのあふれ分 | クラウドへのフォールバック | Claude Sonnet |
個々のモデルは交換可能なものとして扱われます。新しいオープンモデルは絶えず登場するため、チームが長持ちすると考えているのは、その月の流行モデルではなくルーティングのロジックです。
遊休ハードウェアと56時間のIssue監査
週次の稼働率データは、オンプレミスの経済性の問題を示していました。平日の日中に短いスパイクがあり、週末はほぼ空っぽです。クラウドAPIなら使わない容量は費用の節約になりますが、購入したハードウェアでは遊休時間は回収できない資本です。開発者が同期チャットにローカルの選択肢を採用しなかったのは、明らかに遅く能力も劣るからで、プラットフォームチームもその理由から社内での宣伝を意図的に控えていました。
この空白を埋めるため、チームは夜間のバッチ処理に目を向けました。ある晩、エージェントに対し、coder/coder GitHubリポジトリの未解決Issueをすべて調査し、コードベースで既に修正済みのものについてクローズの提案を下書きするよう指示しました。自分でクローズしてはならないと明示したうえでのことです。最初の試みではDeepSeekが混乱し、ジョブが安定して動くまでには、もう少し構造化した反復的なプロンプトが必要でした。
結果は次のとおりです。
- 監査は週末をまたいで56時間稼働し、756件の未解決Issueを対象に、チケットの調査とプルリクエストの照合を行うサブエージェントのセッションを生成しました。
- 約100件のIssueを廃止済みと判定しました。
- 上位30件の提案を手作業で確認したところ、29件が正しく、誤検知は1件でした。
- コミュニティの貢献者を苛立たせないよう、自動クローズは禁止されていました。
この実行は無料ではありませんでした。ルーターが、ローカルの処理待ち行列が詰まった状態を障害とみなす設定になっていたため、待機中のプロンプトがClaude Sonnetにあふれ出し、約$130の費用が発生したのです。同等の処理をすべてClaude Sonnetで行うと約$1,100と見積もられるため、差し引きの節約額は依然として大きいものの、教訓は、バッチジョブでは積極的なフォールバックのタイマーを無効にし、ローカルの待ち行列でただ待たせることです。
▲ 遊休ローカル機での夜間バッチトリアージ
数台のマシンではできないこと
同社は上限についても明確です。GB10を2台、ハードウェアにしておよそ$2万では、$500万のAI予算を相殺するには程遠いのです。支出の大半はリアルタイムの対話型開発者セッションから生じており、そこでは現在のローカルモデルは主力クラウドAPIより遅く、賢くないと感じられるからです。同期チャットを高速化するには、容量を増やすだけでなくユニファイドメモリ帯域幅を大幅に高める必要があり、そのためCoderは新型Mac Studioを含む上位ハードウェアを予約注文し、オースティンの環境を強化しようとしています。
より広い戦略を形作る論点がほかにもいくつかあります。
- 手早い成果ではポリシーがインフラに勝る。 社内で最も消費の多いパワーユーザーに利用を抑えるよう頼むだけで、AI支出全体を約30%削減できると見積もられており、複雑な技術インフラ単独よりはるかに大きい効果です。
- 支出を人数で割らない。 一握りのパワーユーザーとプログラムによるワークフローが平均値をゆがめます。
- ベンチマークは本番ではない。 量子化のスコアやリーダーボードの数字では、モデルが実際の多段階ワークフローを完遂できるかをしばしば予測できません。
- 小さなモデルほど信頼を下げる。 ローカルモデルはフロンティアモデルより組み込みの安全策が少ないため、エージェント型タスクのセキュリティはインフラ側で担保しなければなりません。エージェントのワークロードは、Kubernetesポッド内のTerraform管理ワークスペースで、制限されたネットワークポリシーとgVisorのマイクロVM分離のもとで動かし、信頼できない実行を開発者のノートPCから遠ざけています。
- 推論の前に分類する。 ゲートウェイの軽量な分類器で、トークンがモデルに届く前に給与記録のような機密情報を遮断でき、そもそもクエリにLLMが必要かどうかも判断できます。
- ホスト型のオープンウェイトモデルは中間の道。 Coderはすでに、エージェントツールをさまざまなバックエンドで試すためにクラウドホストのオープンモデルを使っており、AWS Bedrockのようなサービス上のオープンウェイトモデルはプロプライエタリなAPIより大幅に安いため、ルーティング先として魅力的です。
ゲートウェイ自体は3層構成です。認証、ユーザー帰属、チーム予算、監査ログを担うCoder AI Gateway、ルーティングルールとエンドポイント切り替えを担うオープンソースのセルフホスト型ゲートウェイBifrost、そしてハードウェアの温度、VRAM使用量、待ち行列の深さをリアルタイムでBifrostに送り込み、トラフィックを実際の処理能力に従わせる独自のテレメトリーシムです。
ロードマップの次の項目は、顧客との通話の文字起こし分析のような機密性の高いワークフローのローカルモデルへの移行、軽量なエージェントオーケストレーションやSlackボットのトリガーへのローカルモデル活用、そしてリポジトリ監査や、匿名化した対話ログを使ったオフラインの強化学習パイプラインによるオフピーク時間の活用です。Coderにとってコスト削減は二の次で、主な動機は、エンタープライズ顧客に助言できるようアーキテクチャを実地で理解することにあります。
Coderの経験から学べること
オンプレミスAIの最大のリスクは稼働率や購入価格ではなく、導入が進まないことです。誰も仕事を振り分けないために、高価なマシンが遊んでしまうのです。ローカルモデルを検討しているなら、実務的な手順は次のようになります。
- まずプログラムによるAIトラフィックをすべてゲートウェイの背後に置き、個々のツールに手を入れずに予算、フィルター、ルーティングを後から追加できるようにする。
- 何かを買う前に、請求額をパワーユーザーとボットの観点で監査する。予算ポリシーのほうがハードウェアより節約になるかもしれない。
- ドキュメント確認、コードレビュー、Issueトリアージのような、速度よりトークン単価が重要な実績ある非同期ジョブから始める。
- 小さなモデル向けに、明示的な段階的指示を含むプロンプトに書き直し、数時間かかるベンチマーク基盤を作るのではなく、実際の出力50から100件を手で採点する。
- スパイクに備えてクラウドのフォールバックは残しつつ、バッチジョブが静かにクラウド費用を使うのではなくローカルで待機するように調整する。
- すべてのエージェントをインフラレベルでサンドボックス化し、公開リポジトリや機密データに触れるものには人間の検証を残す。
この事例から見る限り、ローカル推論は反復的なバックグラウンド作業ではすぐに元が取れる一方、対話型コーディングではフロンティアモデルの代わりにはなりにくいままです。この2つを別の問題として扱ったことが、戦略を機能させた要因でした。


