OpenAI并没有为华尔街单独打造一个模型。据OpenAI金融服务负责人Joseph Kim介绍,ChatGPT for Financial Services于2026年9月10日发布,摩根士丹利和Evercore是设计合作伙伴,而该产品运行在与所有用户相同的旗舰模型之上。金融推理数据会流入公司的主预训练管线,产品本身大多是标准的ChatGPT基础组件,外层包裹着经授权的市场数据、机构专属模板,以及一套默认每个结果都由人工审核的工作流。这种做法背后的设计选择,很能说明OpenAI对垂直AI产品应当如何构建的思考。
为何没有专门的金融模型
OpenAI将自己定位为一家研究与部署公司,Kim表示这个顺序是有意为之:研究和能力评估在先,产品设计在后。在实践中,这意味着金融推理与分析数据会被"上游化",汇入公司所称的Big Run,也就是产出6 Astra和6.1 Astra系列等旗舰模型的预训练运行。
其结果是,金融能力并未被封闭在某一个企业产品之中。任何调用核心模型的第三方开发者都能获得同样的底层推理能力。用Kim的话说,金融团队本质上是在这些基础模型之上运作的一家内部创业公司,面对的技术难关与外部公司并无二致。
80/20论点,以及任何人都能复制的95%
团队的核心论点很简单。Codex这样的现成模型能提供一个可行金融产品所需的大约80%。但如果把这原始的80%直接交付给银行,产品就会失败。缺失的20%是专门的工作流、专有数据,以及针对金融从业者实际工作方式量身定制的用户界面。
Kim坦言,ChatGPT for Financial Services约95%由标准的ChatGPT插件架构和基础组件构成,这些如今对所有外部开发者都是开放的。训练层面的工作最令人兴奋,但产品在商业上的吸引力绝大部分来自平实的运行框架与集成工程。由此Kim作出一个预测:会有人通过在ChatGPT插件之上拿下这20%的垂直层,建立起一家$10亿规模的独立软件企业。这是预测,而非既成结果。
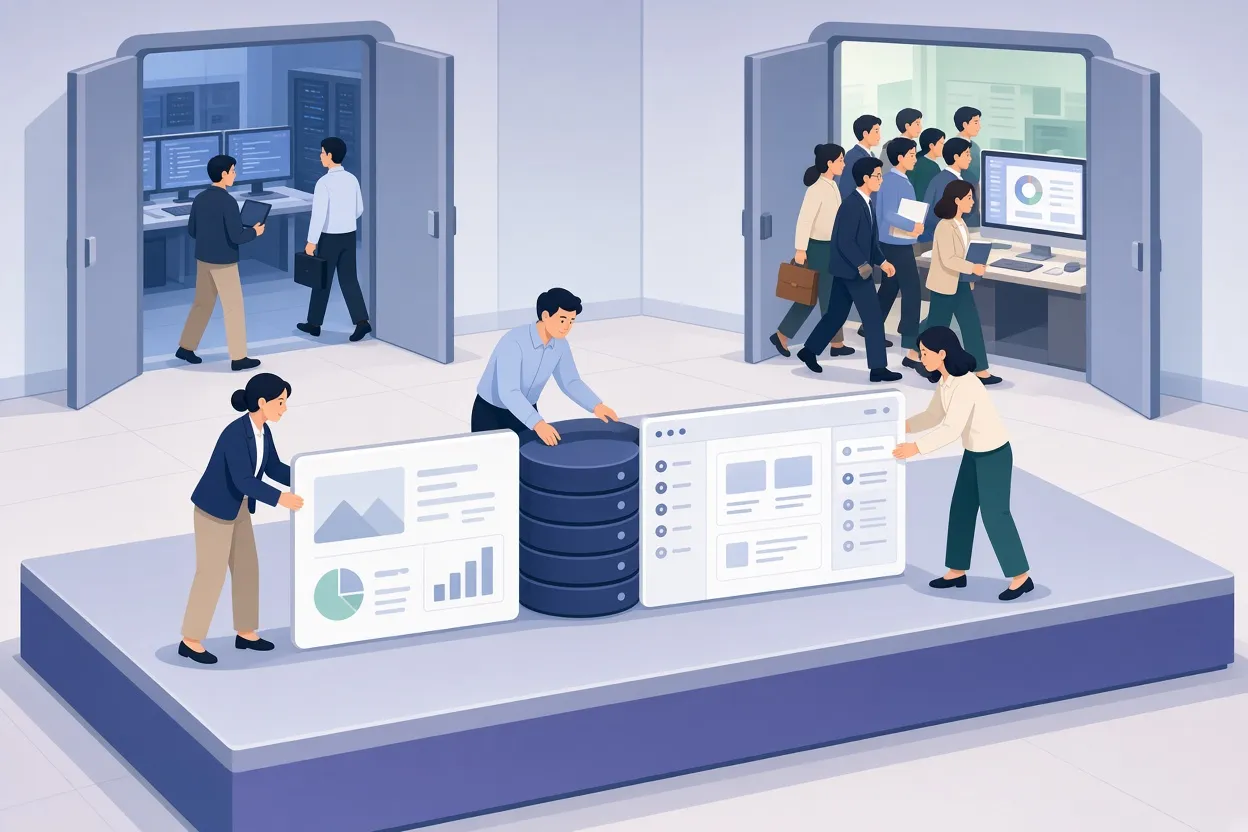
▲ 20%领域层与桌面应用带来的采用跃升
形态很重要:Codex的采用曲线
OpenAI内部一张追踪自2025年8月以来各部门Codex使用情况的图表,说明了产品层为何不可或缺。软件工程部门的采用率稳步线性上升。财务、招聘和法务团队则连续数月停留在接近0%的水平。2026年2月Codex桌面应用发布后,这些非技术团队的采用率几乎垂直跃升至约90%。
| 部门类别 | Codex桌面应用发布前 | 2026年2月之后 |
|---|---|---|
| 软件工程 | 自2025年8月起稳步线性增长 | 持续增长 |
| 财务、法务、招聘 | 接近0% | 约90% |
OpenAI从中得到的教训是,业务人员不会去使用原始的开发者环境或命令行工具。他们需要为自身工作专门构建的界面。
OpenAI为何自己托管市场数据
从第一性原理来看,捆绑金融数据集似乎是多余的。企业客户往往已经与数据供应商签有授权协议,而基于模型上下文协议(MCP,一种把AI模型连接到外部数据源和工具的开放标准)的第三方连接器也早已存在。
测试却给出了不同的答案。几家知名金融数据提供商的外部MCP连接器失败率超过40%。对企业级产品而言,这样的可靠性无法接受。OpenAI转而选择直接在自有基础设施上授权、索引并托管来自Daloopa、PitchBook、LSEG News、Crunchbase和S&P等供应商的数据集。产品界面将这些数据以插件选项的形式呈现,例如Company Filings、Financials & KPIs、SEC Filings、Earnings Calls & Transcripts、Investor Presentations和Market News & Trading。
直接索引大幅降低了延迟和失败率,Kim表示内置数据包成为企业用户最称赞的功能。在他看来,更广泛的启示是企业工具不能纯粹从理论出发来设计,必须适应商业现实、既有的授权安排和用户习惯。
面向"人在回路"的设计
产品的第一个版本是面向金融知识工作者的生产力工具,建立在一个基本假设之上:人始终在回路中。正如软件工程师使用编程助手那样,分析师可以用模型完成日常任务的30%到80%,同时保留对最终审计和验证的责任。
对于预计在2027年和2028年出现的更自主的智能体,团队正在设计智能体安全档案,仿照人们相互监督的既有方式。Kim以谷歌的工程实践为例:代码变更在部署前要经过可读性认证和同行检查把关。投资银行也有自己隐含的版本:初级分析师做基础工作,经理审核并改进,副总裁或董事总经理进行最终把关。由于这些层级本就是为了防止人为错误影响业务结果而设,把AI输出纳入同一套审核阶梯,便自然而然地提供了风险管理。
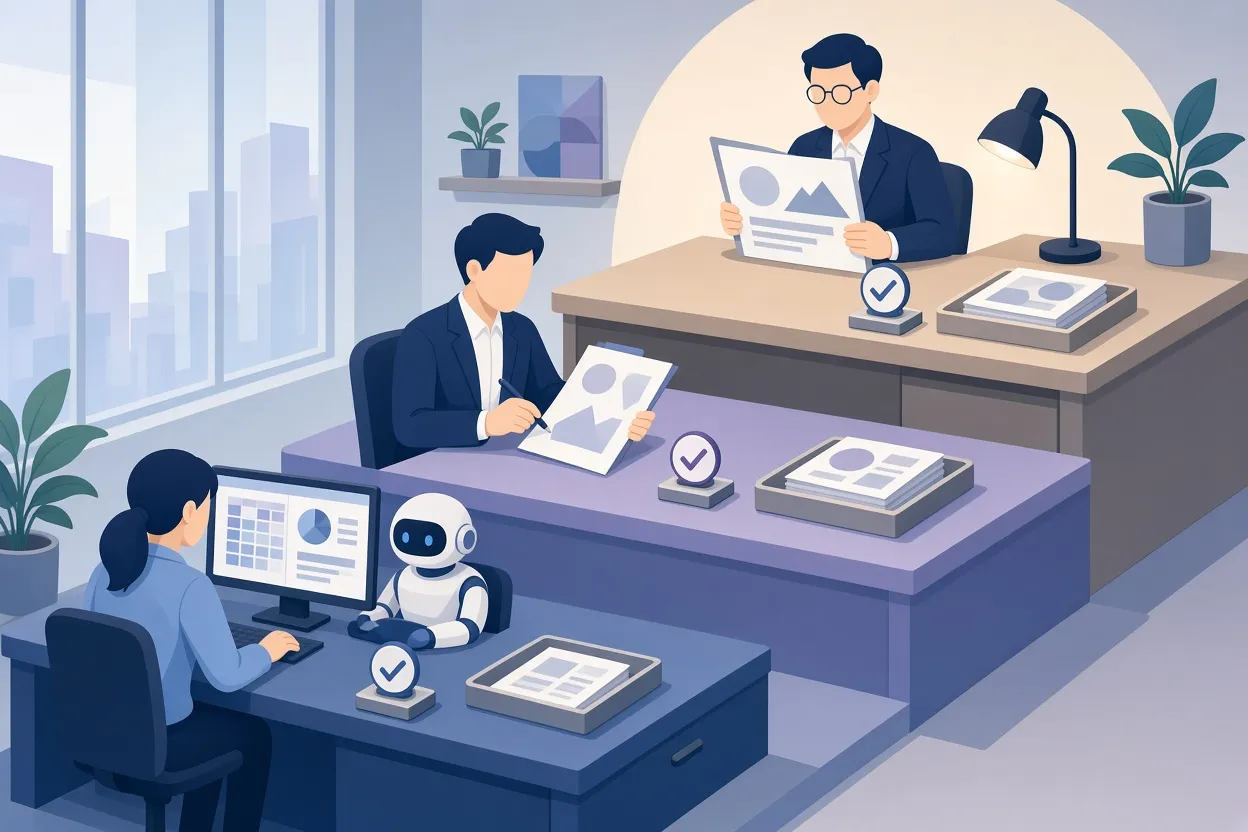
▲ AI输出经过银行审核阶梯
对"断送职业生涯的错误"的恐惧
初级分析师常常担心一个不断放大的错误可能断送职业生涯。Kim的看法是,错误并非都一样严重。真正危险的错误出现在事实性错误的数据改变了最终业务结论之时,而这类错误很少能逃过机构的安全网,因为高层领导只会看到经过多层审核的工作成果。他还认为,作为2022年和2023年最主要抱怨的事实性幻觉,随着模型精度和可靠性的提升已经大幅减少。
真正的差距:品味,而非事实
Kim认为,模型仍然做不好的是品味。一份幻灯片可以数字准确,却依然难看、排版糟糕或视觉上粗糙。如今金融领域AI工作成果的主要瓶颈正是这种主观质量,而不是基本的事实核查。
为弥补这一差距,团队回到了当初催生指令跟随语言模型的那项技术。2022年的InstructGPT使用了基于人类反馈的强化学习(RLHF):人类标注者将多个模型输出从最好到最差排序,再用这些成对比较训练奖励模型。近来机器学习的趋势强调带有硬性奖励函数的可验证环境,但Kim认为,在传授设计细微差别方面,成对的人类偏好仍是更优方法。
团队将这一方法直接应用于幻灯片生成,收集人们对并排展示的演示文稿的评分,以构建美学基准。人类能在几秒内判断两种版式哪个更好看,而自动评分模型往往过度分析单个像素的位置,得出错误结论。
软件工程的先例
Kim把金融建模视为与编程结构相似的工作。软件把编译、语法和单元测试等可验证规则,与关于整洁设计和可维护性的定性判断结合在一起。金融模型同样有可验证的部分,比如Excel求和能否算出来、引用是否断裂,也有对输入如何扰动输出的定性感觉,经验丰富的专业人士会凭直觉去检验。由于AI在整洁、结构良好的代码上已取得长足进步,团队有信心解决金融领域的类似问题。
评估也在朝同一方向演进。Cognition的FrontierCode基准不像SWE-bench那样只问一个补丁是否解决了问题,而是问在多个有效解法中,人类维护者是否真的会合并这个拉取请求,衡量的是代码卫生、风格和可合并性,而不是非此即彼的成功。
从初级分析师任务走向更模糊的目标
迄今为止,大多数AI金融应用都瞄准初级分析师的工作,原因有二:当前模型擅长明确、结构化的指令,比如按公司模板和精确的品牌风格制作幻灯片;而金融从业者讨厌重复、细节繁多的任务,比如多标签页的Excel模型,其中细小的公式错误会层层放大。
随着这些唾手可得的成果大体完成,2027年的路线图将沿着层级向上,走向经理和董事总经理的职责,包括投资论点。那里的目标要模糊得多,验证一个逆势的多年期论点可能需要三年或更长时间的真实市场反馈。Kim表示,要达到接近专家的推理水平,需要高质量的金融数据,再配合来自99.9分位从业者的反馈;OpenAI已将金融服务列为专门的战略研究重点。
基准为何比看上去更难
每一项评估都是对人类能力的不完美代理,Kim形容构建好的评估极其困难,而且被普遍低估。标准答案和评分函数的制作非常费力,薄弱的评估则会招来奖励投机。OpenAI自家的GDPval基准覆盖44种职业,但在通用知识任务上已经饱和,并且包含失效、无信息量的题目。
在Astra项目下进行GPT-6测试期间,金融基准分数不再反映真实进展,因为旧有评估已触及天花板。深入检查发现的是有缺陷的问题、错误的标准答案和含糊的提示词,而不是模型退步。Kim指出这里有一种常见偏差:研究人员对好成绩不加审视地接受,只有在分数令人失望时才去审查测试。OpenAI目前正在构建新一代投资银行评估,旨在与初级岗位的完全自动化相关联,并把金融品味的客观指标视为向量化从业者发出的公开征集。
这意味着什么,以及该做什么
浮现出来的图景是:一款垂直AI产品,由共享的基础模型、自行托管的数据、专门构建的界面,以及借鉴既有机构的审核工作流组成。OpenAI正在向企业推出ChatGPT for Financial Services,计划把相关功能带到ChatGPT Pro,并正在招聘前端和后端工程师、具有投资银行、股票研究和资产管理背景的产品经理,以及直接训练基础模型的领域专家。
对读者而言,由此可以得到几条实用的启示:
- 在关键工作流中依赖任何第三方数据连接器之前,先测试其错误率和延迟,并考虑自行托管和索引关键数据集。
- 如果想让非技术团队真正用起来,就给他们专门的界面,而不是开发者工具。
- 把工程精力花在领域专属的20%上,比如模板、专有数据和工作流,而不是训练一个定制的基础模型。
- 把每一份AI输出都当作初级分析师的工作:在任何人据此行动之前,先走同一套审核阶梯。
- 对于主观质量,收集并排对比的人类偏好,而不是编写确定性规则,并把可验证检查与品味检查分开。
- 对强劲的基准结果要像对糟糕的结果一样严格审视。
对这些工作流感兴趣的金融从业者可以通过所在机构评估ChatGPT for Financial Services,有意参与构建的人则可以查看OpenAI的招聘页面。


