OpenAI가 2026년 9월 10일 내놓은 ChatGPT for Financial Services는 금융 전용 모델을 따로 만들지 않았습니다. OpenAI 금융 서비스 책임자 Joseph Kim이 밝힌 설계 원칙은 세 가지로 요약됩니다. 금융 추론 데이터는 별도 모델이 아니라 OpenAI의 핵심 flagship 모델을 만드는 학습 과정에 직접 넣고, 시장 데이터는 외부 연결에 기대지 않고 OpenAI 인프라에 직접 올리며, 결과물은 반드시 사람이 검토한다는 전제로 workflow를 짭니다. Morgan Stanley와 Evercore를 설계 파트너로 삼아 만든 이 제품의 안쪽 구조를 Kim의 설명을 따라 정리합니다.
금융 전용 모델을 만들지 않은 이유
Kim에 따르면 금융 추론과 분석 데이터는 모두 OpenAI가 'Big Run'이라고 부르는 기반 모델 사전 학습 pipeline의 상류(upstream) 단계에 직접 들어갑니다. 그 결과물이 GPT-6 Astra 계열(6 Astra, 6.1 Astra) 같은 핵심 flagship 모델이고, 금융 능력은 이 모델 안에 들어 있습니다. 금융용 가지치기 모델을 따로 두지 않기 때문에, 고도화된 금융 추론 능력이 OpenAI 제품 안에만 갇히지 않고 외부 개발자에게도 그대로 열립니다.
이 선택은 OpenAI가 스스로를 '연구와 배포(research and deployment) 회사'로 정의하는 것과 맞닿아 있습니다. 연구와 능력 평가가 먼저 오고 제품 설계가 뒤따르도록 조직의 순서를 일부러 짰다는 설명입니다. Kim 자신도 연구 조직에서 제품 조직으로 옮겨 왔고, ChatGPT for Financial Services를 만든 팀은 모델 평가, harness(모델을 실제 작업에 연결하는 실행 틀) 조정, 연구를 한 팀 안에서 함께 다뤘습니다.
모델이 80%, 나머지 20%가 제품을 가른다
Kim의 팀이 세운 핵심 가설은 이렇습니다. Codex 같은 기성 모델은 쓸 만한 금융 솔루션에 필요한 것의 약 80%를 이미 제공합니다. 그런데 이 80%를 날것 그대로 금융 현장에 내놓으면 제품은 실패합니다. 나머지 20%, 곧 회사별 workflow와 template, 자체 데이터, 사용자 인터페이스 보강이 성패를 가릅니다.
눈에 띄는 대목은 ChatGPT for Financial Services의 95%가 외부 개발자도 똑같이 쓸 수 있는 표준 ChatGPT plugin 구조와 primitive(기본 구성 요소)로 만들어졌다는 설명입니다. OpenAI 내부 팀도 기반 모델 위에서 움직이는 '사내 스타트업'처럼 외부 스타트업과 같은 기술적 난관을 겪었습니다. 학습 단계의 혁신이 가장 주목받지만, 실제 상업적 성과의 대부분은 harness와 통합 엔지니어링에서 나왔다는 것입니다. Kim은 이 20%를 ChatGPT plugin 위에 쌓는 것만으로 $10억 규모의 독립 소프트웨어 사업이 나올 것이라고 내다봅니다.
제품 형태(form factor)가 얼마나 중요한지는 OpenAI 내부 데이터가 보여 줍니다. 2025년 8월부터 부서별 Codex 사용 비중을 추적했는데, 소프트웨어 엔지니어링 부서는 꾸준히 선형으로 늘어난 반면 재무, 채용, 법무 팀은 몇 달 동안 0% 근처에 머물렀습니다. 2026년 2월 Codex desktop app이 나오자 비기술 부서의 채택률이 거의 0%에서 약 90%로 수직 상승했습니다. 같은 모델이라도 개발자용 환경이 아니라 전용 앱으로 건네야 비기술 직군이 쓴다는 뜻으로 읽힙니다.
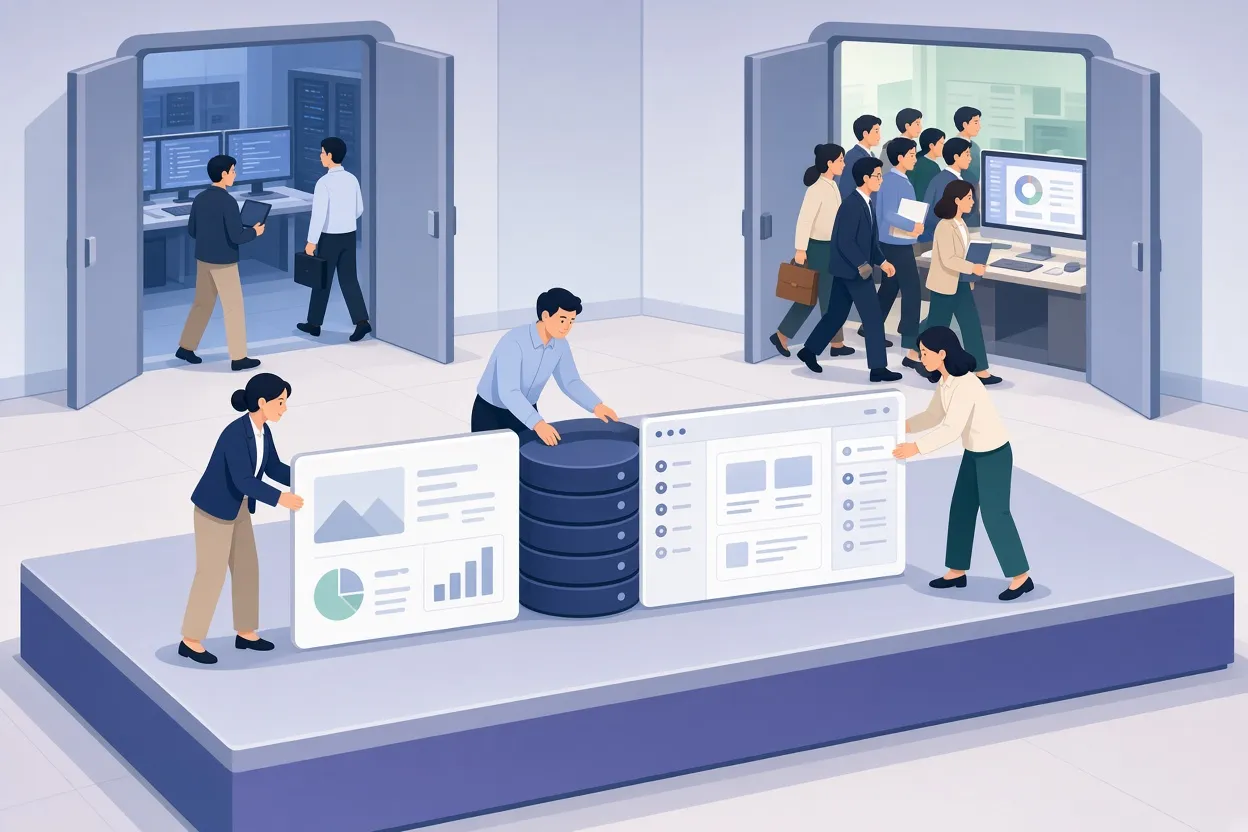
▲ 20% 특화 층과 전용 앱의 효과
외부 MCP 연결 대신 데이터를 직접 호스팅한 이유
첫 원칙(first principles)에서 출발하면 금융 데이터를 제품에 묶어 제공하는 일은 불필요해 보입니다. 기업 고객은 이미 데이터 라이선스를 갖고 있고, MCP(Model Context Protocol, AI 모델을 외부 데이터와 도구에 연결하는 표준) 기반의 제3자 connector도 이미 나와 있기 때문입니다. 그러나 실제로 평가해 보니 주요 금융 데이터 제공사의 외부 MCP connector는 오류율이 40%를 넘었습니다.
OpenAI는 Daloopa, PitchBook, LSEG News, Crunchbase, S&P 같은 파트너의 데이터를 직접 라이선스하고 색인해 OpenAI 인프라에서 호스팅하는 쪽을 택했습니다. 직접 색인하자 지연 시간과 실패율이 크게 떨어졌고, 결과적으로 기업 사용자가 가장 높이 평가한 기능이 바로 이 내장 데이터였습니다. 제품 화면에는 Company Filings, SEC Filings, Earnings Calls & Transcripts, Investor Presentations, Financials & KPIs, Market News & Trading 같은 plugin이 나란히 놓여 있어, 사용자가 외부 링크를 따로 가져오지 않아도 분기 실적 발표 transcript와 재무제표를 바로 불러 쓸 수 있습니다.
Kim은 이 경험을 '기업용 도구는 첫 원칙만으로 설계할 수 없다'는 교훈으로 정리합니다. 상업적 현실, 기존 라이선스, 사용자 습관의 관성을 무시한 이론적 설계는 현장에서 자주 실패한다는 것입니다.
사람이 검토한다는 전제, 은행의 검토 사다리를 그대로
현재 제품은 금융 지식 노동자를 위한 생산성 도구이고, 사람이 항상 검토 과정에 개입한다(human in the loop)는 전제 위에 서 있습니다. 소프트웨어 엔지니어가 코딩 assistant를 쓰듯, 분석가는 모델로 하루치 작업 하나하나를 30~80% 정도 끝내고 최종 감사와 검증의 책임은 자신이 집니다.
이 전제는 안전 설계로 이어집니다. 투자은행에는 주니어 분석가가 기초 작업을 하고, associate가 검토해 보강하고, VP나 Managing Director가 최종 점검하는 암묵적 다단계 위계가 있습니다. 사람의 실수가 사업 결과에 닿지 못하게 막는 검토 체계가 이미 있으니, AI를 바로 이 감독 단계 안에 끼워 넣으면 위험 관리가 자연스럽게 이뤄집니다. Kim은 Google의 엔지니어링 관행도 예로 듭니다. readability 인증처럼 코드 변경이 배포되기 전에 엄격한 견제와 균형을 거치게 하는 절차를 agent에도 적용하자는 것입니다. 2027~2028년에 agent가 더 독립적으로 움직이게 되면 안전의 중요성은 더 커질 수밖에 없고, 팀은 사람 사이의 협업 방식을 본뜬 agent 보안 프로필을 설계하고 있습니다.
주니어 분석가가 흔히 품는 '실수 하나가 경력을 끝낸다'는 두려움에 대해서도 Kim은 대체로 잘못된 통념이라고 봅니다. 경력을 위협하는 실수는 사실과 다른 데이터가 최종 결론을 바꿀 때 생기는데, 그런 심각한 오류는 여러 검토 층을 거치면서 고위 임원에게 닿기 전에 걸러진다는 것입니다.
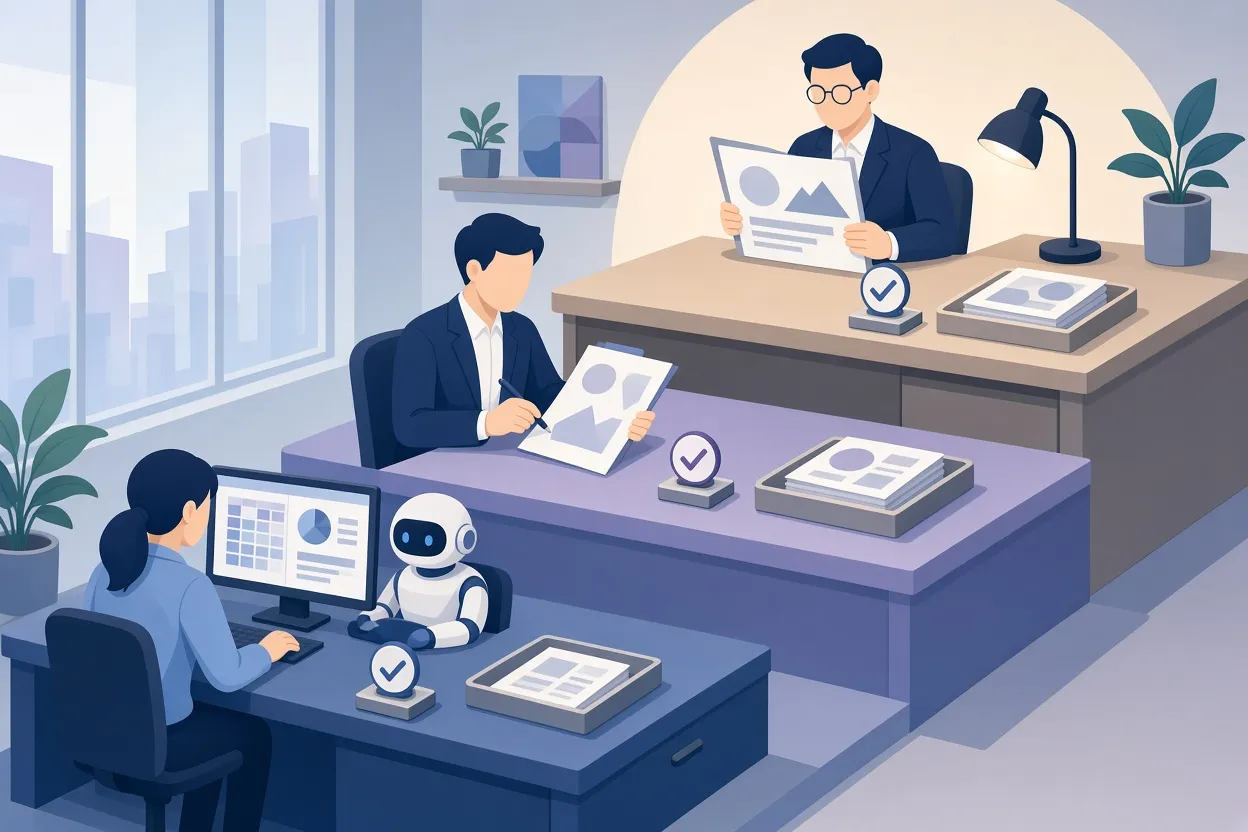
▲ 은행 검토 위계에 들어간 AI
남은 병목은 사실 오류가 아니라 '취향'
2022~2023년에 업계의 가장 큰 불만이었던 hallucination(모델이 사실이 아닌 내용을 그럴듯하게 지어내는 현상)은 사실 정확도와 신뢰성이 꾸준히 개선되면서 크게 줄었다는 것이 Kim의 진단입니다. 지금 금융 모델의 진짜 부족함은 기초 사실 확인이 아니라 사람의 취향과 주관적 판단입니다. 숫자는 정확한데 색 배합이 보기 싫고, 서식이 엉성하고, 정렬이 흐트러진 슬라이드가 대표적 사례입니다.
이 문제를 풀기 위해 팀은 2022년 InstructGPT 논문의 방식, 곧 RLHF(사람의 피드백으로 하는 강화학습)로 되돌아갔습니다. prompt 하나에 여러 출력을 뽑고, 평가자가 가장 좋은 것부터 나쁜 것까지 순위를 매기고, 그 쌍대 비교 신호로 reward model을 학습시키는 방법입니다. 최근 기계학습의 흐름은 검증 가능한 환경과 확정적인 보상 함수에 쏠려 있었지만, 디자인의 미묘한 차이를 가르치는 데는 여전히 사람의 쌍대 비교가 더 낫다는 판단입니다. 팀은 이 기법을 슬라이드 생성에 그대로 적용해, 두 장의 프레젠테이션을 나란히 놓고 사람의 평점을 모아 심미적 benchmark를 세웠습니다. 사람은 두 슬라이드 중 어느 쪽 배치가 나은지 몇 초 만에 직관적으로 가리는 반면, 자동 채점 모델은 픽셀 위치 하나하나를 과도하게 따지다 엉뚱한 결론에 이르곤 합니다.
Kim은 금융 모델링이 소프트웨어 엔지니어링과 닮았다고 설명합니다. 코딩에는 컴파일, 문법, 단위 테스트처럼 검증 가능한 규칙과 깔끔한 설계, 유지보수성 같은 취향이 섞여 있습니다. 금융 모델도 Excel 합계와 수식 참조처럼 검증 가능한 요소와, 입력을 흔들었을 때 출력이 어떻게 움직이는지 보는 '모델의 느낌' 같은 질적 요소가 함께 있습니다. 노련한 금융 전문가가 입력을 바꿔 보며 데이터 흐름을 직관적으로 점검하는 방식은 코드 품질을 보는 방식과 같습니다. 코드 생성에서 깔끔하고 잘 짜인 코드를 만들도록 가르치는 데 성공했으니 금융 모델링의 같은 문제도 풀 수 있다는 것이 자신감의 근거입니다.
평가 기준의 변화는 코딩 benchmark에서 먼저 나타났습니다. SWE-bench가 생성된 patch가 문제를 고쳤는지를 보는 반면, Cognition의 FrontierCode는 여러 유효한 해법 가운데 사람 maintainer가 실제로 merge할 만한 pull request인지, 곧 코드 위생과 스타일 준수까지 봅니다. 정답 여부에서 전문가 품질로 평가 기준이 옮겨 가는 흐름이고, 금융도 같은 길을 갈 것으로 보입니다.
benchmark가 포화되면 생기는 일
지금까지 금융 AI 응용은 대부분 주니어 분석가 workflow에 집중됐습니다. 현재 모델은 회사 template과 브랜드 스타일에 맞춰 슬라이드를 만드는 것처럼 명시적이고 구조화된 지시를 잘 따르고, 금융 전문가는 로고를 복사해 정확한 위치에 놓거나 여러 탭짜리 Excel 모델을 짜는 반복적이고 세부적인 일을 특히 싫어하기 때문입니다. 이런 손쉬운 과제가 상당 부분 정리되면서 개발의 무게는 associate와 Managing Director의 일로 올라가고 있습니다. 다만 위로 갈수록 목표가 흐릿해집니다. 시장 합의와 다른 투자 논지(thesis)를 세우는 일은 맞았는지 확인하는 데 3년 이상 실제 시장의 피드백이 필요할 수 있습니다.
여기서 평가(eval)의 어려움이 드러납니다. 모든 benchmark는 사람 능력의 불완전한 대리 지표일 뿐이고, 정답지와 채점 함수를 만드는 일은 고되며, 잘못 설계된 eval은 모델의 reward hacking(평가의 허점을 파고들어 점수만 올리는 행동)에 취약합니다. OpenAI의 GDPval은 44개 직업의 실제 업무를 재는 benchmark였지만 일반 지식 과제에서 포화됐고 망가진 문항도 있었습니다. GPT-6 Astra를 시험할 때도 금융 benchmark 점수가 모델의 실제 진전을 반영하지 못했는데, 정체된 결과를 깊이 들여다보니 잘못된 문제, 틀린 정답지, 모호한 prompt가 원인이었습니다. 연구자들은 점수가 좋으면 그냥 받아들이고 점수가 실망스러울 때만 eval의 결함을 파헤치는 확인 편향을 흔히 보인다는 지적도 덧붙입니다.
OpenAI는 주니어 금융 직무의 완전 자동화와 실제로 상관되는 새 세대의 투자은행 평가를 만들고 있습니다. 주관적인 금융 취향을 재는 객관적 지표는 아직 열린 문제로 남아 있고, 전문가 수준의 추론에 이르려면 고품질 금융 데이터와 함께 상위 0.1%(99.9 백분위) 실무자의 피드백이 필요하다고 봅니다. OpenAI는 이를 위해 금융 서비스를 전략적 연구 우선순위로 지정했습니다.
정리와 독자가 할 일
ChatGPT for Financial Services는 기업용으로 먼저 나왔고, 기능을 ChatGPT Pro 같은 소비자·prosumer 요금제로 넓히는 작업이 진행 중입니다. 고객 수요가 빠르게 늘어 OpenAI는 front-end와 back-end 엔지니어, 투자은행·equity research·자산운용 경험이 있는 product manager, 기반 모델을 직접 가르칠 분야 전문가(subject matter expert)를 뽑고 있습니다. 코드 생성 능력을 끌어올린 방법을 금융에서도 되풀이하겠다는 뜻입니다.
설계 원칙을 입장별로 정리하면 다음과 같습니다.
| 독자 | 가져갈 점 |
|---|---|
| 금융 AI 제품을 만드는 팀 | 자체 기반 모델 대신 회사별 template, 자체 데이터, UI 같은 20%에 집중, 외부 MCP connector는 오류율과 지연 시간을 자동 테스트한 뒤 채택, 핵심 데이터는 직접 색인·호스팅 |
| 비기술 직군에 AI를 도입하는 조직 | 개발자용 환경이 아니라 전용 앱 형태로 제공 |
| 금융 실무자 | 모든 결과물에 사람의 검토가 필요하다는 전제로 사용, 슬라이드 제작이나 표준 모델 template처럼 구조가 뚜렷한 작업부터 적용 |
| 평가를 만드는 연구자 | 수식 오류 같은 검증 가능 기준과 디자인 같은 취향 기준을 분리, 높은 점수도 낮은 점수만큼 의심 |
핵심은 분명합니다. 금융 AI의 다음 단계는 사실 정확도를 넘어 전문가의 취향과 판단을 담는 일이고, 그 길은 코딩 모델이 단위 테스트 통과에서 maintainer의 승인으로 옮겨 간 과정과 닮아 있습니다. 금융 기관이라면 기업용 ChatGPT for Financial Services를 검토해 볼 수 있고, 금융 AI를 직접 만드는 팀이라면 모델보다 workflow, 데이터, 검토 구조에 먼저 투자하는 편이 이 설계 원칙에 부합합니다.


