OpenAIはウォール街向けに別のモデルを作ったわけではありません。OpenAIで金融サービス部門を率いるジョセフ・キム氏によると、Morgan StanleyとEvercoreをデザインパートナーとして2026年9月10日に提供を始めた「ChatGPT for Financial Services」は、ほかの利用者と同じフラッグシップモデルの上で動いています。金融の推論データは同社の主要な事前学習パイプラインに流し込まれ、製品自体は、ライセンス取得済みの市場データ、企業ごとのテンプレート、そして人間がすべての結果を確認することを前提にしたワークフローで、標準的なChatGPTの仕組みを包んだものが大半です。この方針の背後にある設計上の判断は、OpenAIが垂直特化型AI製品をどう作るべきだと考えているかをよく物語っています。
金融専用モデルを作らない理由
OpenAIは自社を「研究とデプロイの会社」と位置づけており、キム氏によればこの順序は意図的なものです。まず研究と能力評価があり、製品設計はその後に続きます。実務上は、金融の推論・分析データが、同社が「Big Run」と呼ぶ事前学習ラン、つまり6 Astraや6.1 Astraシリーズといったフラッグシップモデルを生み出す学習ランに「上流で」組み込まれることを意味します。
その結果、金融の能力が一つのエンタープライズ製品の中に閉じ込められることはありません。コアモデルを呼び出すサードパーティー開発者も、同じ基盤の推論能力を手にします。金融チームはその上で、キム氏の言葉を借りれば実質的に社内スタートアップとして動いており、外部企業と同じ技術的ハードルに向き合っています。
80対20の仮説と、誰でも再現できる95%
チームの中核となる仮説は単純です。Codexのような既製のモデルは、実用に足る金融製品に必要なものの約80%を提供します。しかし、その生の80%をそのまま銀行に持ち込めば製品は失敗します。欠けている20%は、金融の専門職が実際にどう働いているかに合わせた専門的なワークフロー、独自データ、そしてユーザーインターフェースの作り込みです。
キム氏は、ChatGPT for Financial Servicesの約95%が標準的なChatGPTプラグインのアーキテクチャと、現在すべての外部開発者が利用できるプリミティブで構成されていると率直に認めています。最も注目を集めるのは学習レベルの取り組みですが、製品の商業的な牽引力の圧倒的大部分を生んだのは、地道なハーネスと統合のエンジニアリングでした。ここからキム氏は、ChatGPTプラグインの上にこの20%の垂直レイヤーを押さえることで、独立した$10億規模のソフトウェア事業が生まれるだろうと予測しています。これは結果ではなく、あくまで予測として示されたものです。
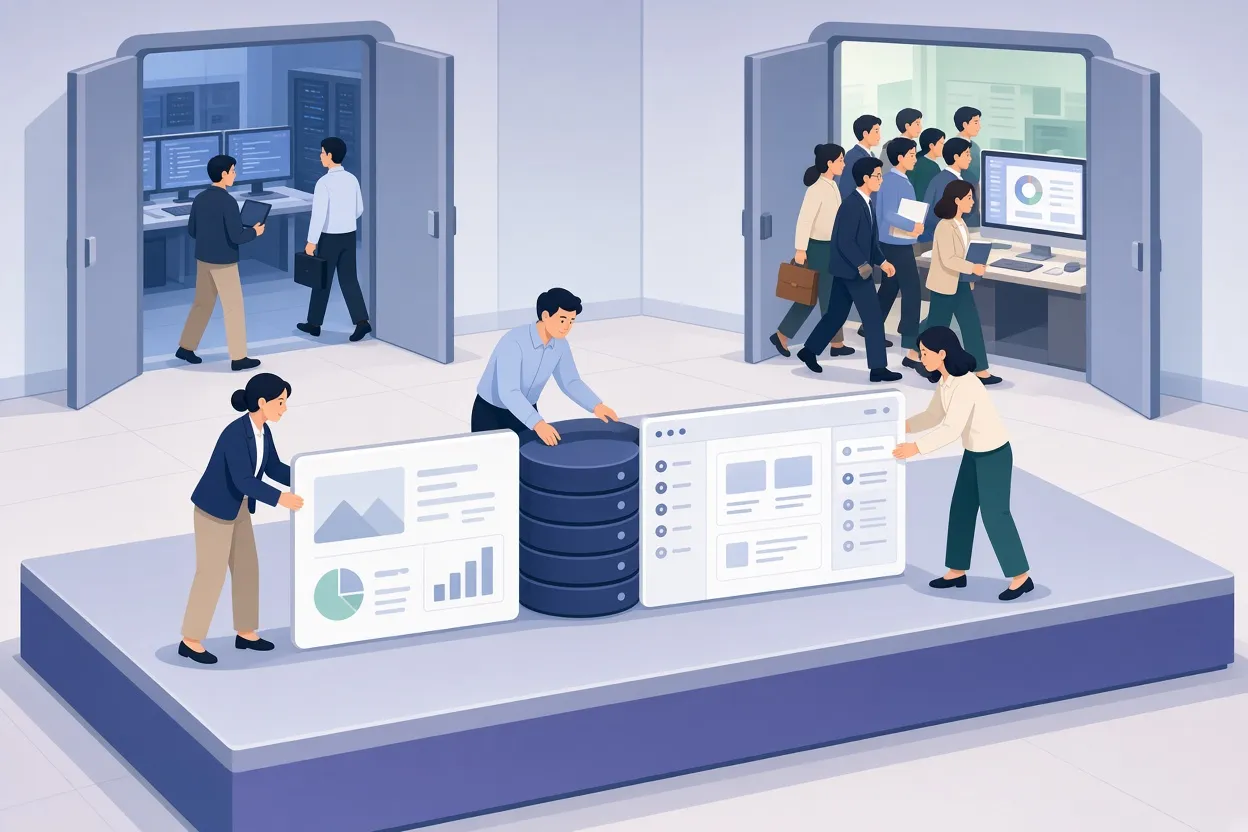
▲ 20%のドメイン層とデスクトップアプリによる普及の飛躍
フォームファクターが重要な理由:Codexの普及曲線
2025年8月以降の部門別Codex利用状況を追ったOpenAIの社内チャートは、製品レイヤーが省略できない理由を物語っています。ソフトウェアエンジニアリング部門の利用は着実に、直線的に伸びました。一方、財務、採用、法務のチームは何カ月も0%近くにとどまっていました。2026年2月にCodexのデスクトップアプリが出荷されると、これら非技術系チームの利用率はほぼ垂直に約90%まで跳ね上がりました。
| 部門グループ | Codexデスクトップアプリ以前 | 2026年2月以降 |
|---|---|---|
| ソフトウェアエンジニアリング | 2025年8月から着実に直線的に成長 | 成長が継続 |
| 財務、法務、採用 | 0%近く | 約90% |
OpenAIがここから得た教訓は、ビジネス職の専門家は生の開発環境やコマンドラインツールには手を出さない、ということです。自分の仕事のために作られた専用のインターフェースが必要なのです。
OpenAIが市場データを自前でホストする理由
第一原理から考えれば、金融データセットを同梱するのは冗長に見えました。エンタープライズ顧客の多くはすでにデータベンダーとライセンス契約を結んでおり、AIモデルを外部のデータソースやツールにつなぐオープン標準であるModel Context Protocol(MCP)を使ったサードパーティー製コネクターもすでに存在していたからです。
しかしテストは別の現実を示しました。著名な金融データプロバイダー数社向けの外部MCPコネクターは、40%を超える確率で失敗したのです。エンタープライズ製品としては受け入れられない信頼性でした。そこでOpenAIは、Daloopa、PitchBook、LSEG News、Crunchbase、S&Pなどのベンダーからデータセットのライセンスを取得し、自社インフラ上で直接インデックス化してホストする道を選びました。製品のインターフェースでは、これらがCompany Filings、Financials & KPIs、SEC Filings、Earnings Calls & Transcripts、Investor Presentations、Market News & Tradingといったプラグインの選択肢として提供されています。
直接インデックス化したことでレイテンシーと失敗率は大幅に下がり、キム氏によれば、組み込みのデータバンドルはエンタープライズ利用者が最も高く評価する機能になりました。キム氏の説明でより大きなポイントとなるのは、エンタープライズ向けツールは理論だけでは設計できないということです。商業上の現実、既存のライセンス契約、そして利用者の習慣に合わせる必要があります。
人間がループに入ることを前提にした設計
製品の第1版は金融分野のナレッジワーカー向けの生産性ツールで、「人間が常にループの中にいる」という一つの前提の上に成り立っています。ソフトウェアエンジニアがコーディングアシスタントを使うのと同じように、アナリストは日々の作業の30~80%をモデルで片付けつつ、最終的な監査と検証の責任は自分で持ち続けます。
2027年から2028年にかけて登場が見込まれる、より自律的なエージェントに向けては、人がすでに互いを監督している方法を映したエージェントのセキュリティプロファイルを設計しています。キム氏が引き合いに出すのはGoogleのエンジニアリング慣行で、そこでは可読性の認定と同僚によるチェックが、デプロイ前のコード変更の関門になっています。投資銀行にも暗黙のうちに同じ仕組みがあります。ジュニアアナリストが土台となる作業を行い、アソシエイトがそれをレビューして改善し、バイスプレジデントやマネージングディレクターが最終的に精査します。これらの階層は、人間のミスが事業上の結果に届くのを止めるためにすでに存在しているため、AIの成果物を同じ階段に組み込めば、自然なリスク管理になります。
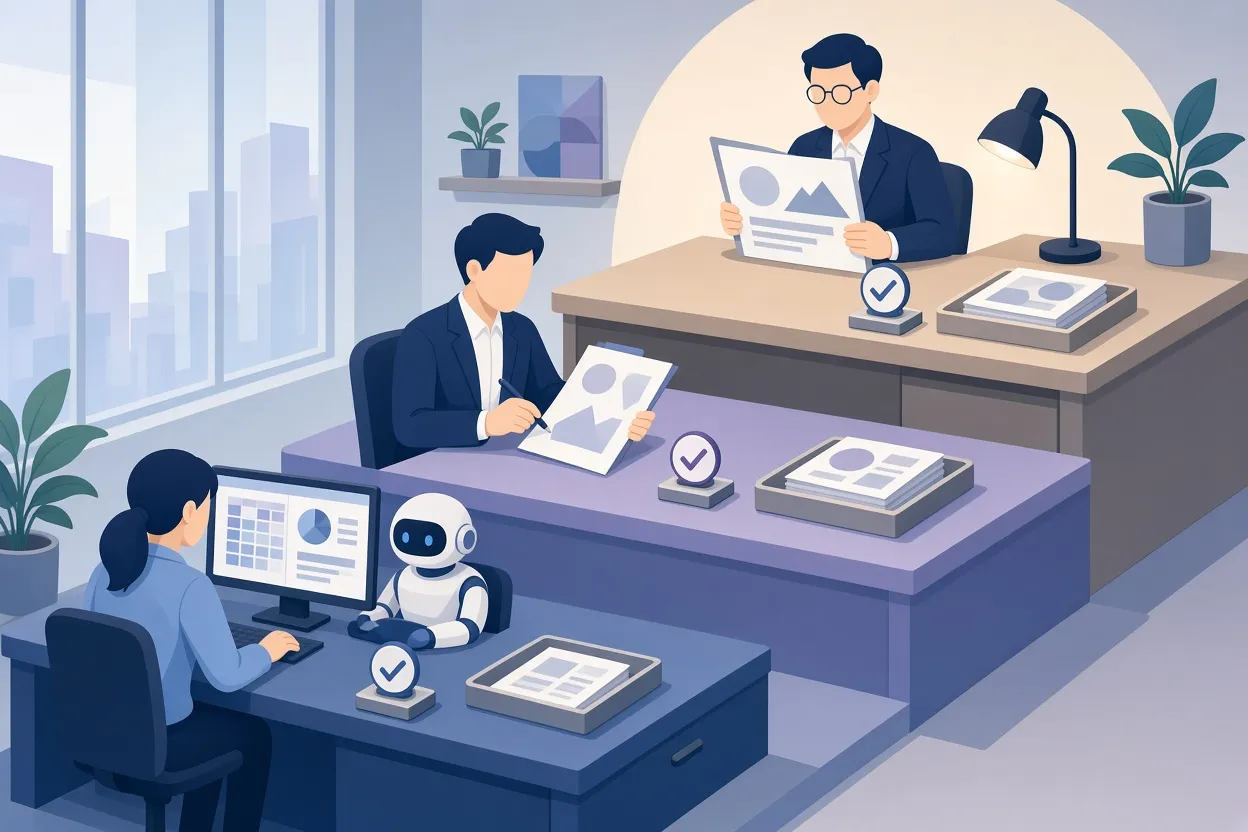
▲ 銀行のレビュー階層を通過するAIの成果物
キャリアを終わらせるミスへの恐れ
ジュニアアナリストは、一つのミスが積み重なってキャリアを終わらせるのではないかと、しばしば不安を抱きます。キム氏の見方では、すべてのミスが同じ重さを持つわけではありません。本当に危険なのは、事実として誤ったデータが最終的な事業判断を変えてしまう場合ですが、そうしたミスが組織の安全網をすり抜けることはまれです。シニアリーダーの目に触れるのは、何層ものレビューを通過した成果物だけだからです。また、2022年から2023年にかけて最大の不満だった事実のハルシネーションは、モデルの精度と信頼性の向上により劇的に減ったとも主張しています。
本当のギャップは事実ではなく「センス」
キム氏によれば、モデルがいまだに間違えるのはセンスの部分です。スライド資料は数字が正確でも、見た目が悪かったり、書式が整っていなかったり、視覚的に雑だったりすることがあります。基本的なファクトチェックではなく、こうした主観的な品質こそが、現在の金融分野におけるAI成果物の主なボトルネックになっています。
これを埋めるために、チームは指示に従う言語モデルをそもそも生み出した手法に立ち返りました。2022年のInstructGPTは人間のフィードバックによる強化学習(RLHF)を使い、人間のラベラーが複数のモデル出力を最良から最悪まで順位づけし、そのペアごとの比較で報酬モデルを学習させました。最近の機械学習のトレンドは厳密な報酬関数を持つ検証可能な環境を重視してきましたが、キム氏は、デザインのニュアンスを教えるにはペアごとの人間の選好が依然として優れた手法だと主張します。
チームはこれをスライド生成に直接適用し、並べて提示したプレゼンテーションに対する人間の評価を集めて、美的なベンチマークを作りました。人間は二つのレイアウトのどちらが見栄えがよいかを数秒で判断できますが、自動採点モデルは個々のピクセル配置を過剰に分析し、誤った結論に至りがちです。
ソフトウェアエンジニアリングという先例
キム氏は、財務モデリングは構造的にコーディングに似ていると捉えています。ソフトウェアは、コンパイル、構文、ユニットテストといった検証可能なルールと、きれいな設計や保守性に関する定性的な判断を組み合わせたものです。財務モデルにも、Excelの合計が計算できるか、参照が壊れていないかといった検証可能な要素があり、それに加えて、入力が出力をどう揺らすかという定性的な感覚があります。経験豊富な専門家はこれを直感的に検証します。AIはきれいで構造化されたコードで大きく進歩したため、金融の類似の課題も解決できるとチームは確信しています。
評価も同じ方向に動いています。CognitionのFrontierCodeベンチマークは、SWE-benchのようにパッチが問題を解決したかどうかではなく、複数の有効な解決策の中で人間のメンテナーが実際にそのプルリクエストをマージするかどうかを問い、二値の成否ではなく衛生面、スタイル、マージ可能性を測ります。
ジュニアアナリストの仕事から、より曖昧な目標へ
これまでのAI金融アプリケーションの大半はジュニアアナリストの仕事を対象にしており、理由は二つあります。現在のモデルは、企業テンプレートに正確なブランドスタイルでスライドを作るといった明示的で構造化された指示に強いこと、そして金融の専門職は、小さな数式ミスが連鎖する複数タブのExcelモデルのような、反復的で細部の多い作業を嫌うことです。
こうした取りやすい果実にはおおむね手が付いたため、2027年のロードマップは階層を上り、投資テーゼを含むアソシエイトやマネージングディレクターの責任領域に向かいます。そこでの目標ははるかに曖昧で、逆張りの複数年テーゼを検証するには3年以上の実際の市場からのフィードバックが必要になることもあります。キム氏は、専門家に近い推論に到達するには、高品質な金融データと、99.9パーセンタイルに位置する実務家からのフィードバックを組み合わせる必要があると述べており、OpenAIは金融サービスを専任の戦略的研究優先分野に指定しています。
ベンチマークが見かけより難しい理由
あらゆる評価は人間の能力の不完全な代理指標であり、キム氏は、良い評価を作ることは極めて難しく、広く過小評価されていると語ります。正解キーと採点関数の作成は骨が折れ、弱い評価は報酬ハッキングを招きます。OpenAI自身の44職種にわたるGDPvalベンチマークも、一般知識のタスクでは飽和し、壊れた項目や情報量のない項目を含んでいました。
AstraプロジェクトでのGPT-6のテスト中、従来の評価が天井に達していたため、金融ベンチマークのスコアは実際の進歩を反映しなくなりました。詳細に調べると、モデルの退行ではなく、欠陥のある問題、誤った正解キー、曖昧なプロンプトが見つかりました。キム氏はここによくある偏りを指摘します。研究者は良い数字は精査せずに受け入れ、スコアが期待外れのときだけテストを監査する、というものです。OpenAIは現在、ジュニア職の完全自動化と相関するよう設計した新世代の投資銀行向け評価を構築しており、金融のセンスに関する客観的な指標づくりは、定量系の実務家への公開の呼びかけと位置づけています。
この話が意味することと、読者がすべきこと
浮かび上がるのは、共有の基盤モデル、自社ホストのデータ、専用に作られたインターフェース、そして既存の組織から借りてきたレビューのワークフローで組み立てられた垂直特化型AI製品の姿です。OpenAIはChatGPT for Financial Servicesをエンタープライズ向けに展開中で、機能をChatGPT Proにも持ち込む計画です。また、フロントエンドとバックエンドのエンジニア、投資銀行・株式リサーチ・資産運用の経験を持つプロダクトマネージャー、そしてベースモデルを直接学習させる分野の専門家を採用しています。
読者にとっては、この話から次のような実践的な教訓が導けます。
- サードパーティーのデータコネクターは、重要なワークフローで頼る前にエラー率とレイテンシーをテストし、重要なデータセットは自前でホストしインデックス化することを検討する
- 非技術系チームに普及させたいなら、開発者向けツールではなく専用のインターフェースを用意する
- 独自のベースモデルを学習させるのではなく、テンプレート、独自データ、ワークフローといった分野固有の20%にエンジニアリングの労力を注ぐ
- すべてのAI成果物をジュニアアナリストの仕事として扱い、誰かが行動に移す前に同じレビューの階段を通す
- 主観的な品質については、決定論的なルールを書くのではなく、並べて比較した人間の選好を集め、検証可能なチェックとセンスのチェックを分ける
- 強いベンチマーク結果も、弱い結果と同じくらい厳しく精査する
こうしたワークフローに関心のある金融の専門職は、所属機関を通じてChatGPT for Financial Servicesを評価できます。開発側に関心がある人は、OpenAIの採用ページを見てみるとよいでしょう。


