如今,AI编程智能体写代码的速度已经超过任何团队逐行阅读的速度。这一差距正推动形式化验证,也就是用数学方法证明软件满足其需求的做法,走出小众领域。一家专注于该领域的企业在Linux内核中发现了长期潜藏的漏洞,其中一个在着手证明之前就已暴露:它是在团队写下代码应当做什么的过程中被发现的。该公司由此得出的结论是,随着AI接管软件的“怎么做”,人的工作正转向准确表述“做什么”。
先证明,而不是事后测试
设计桥梁的工程师不会开车过桥,看它会不会塌。他们会事先计算荷载、风切变和应力容限。软件走了另一条路:代码修改起来便宜又容易,于是“边做边试”的迭代循环成了常态。该公司CEO认为,如今软件故障的严重程度和造成的损失已经可以与桥梁垮塌相当,因此严谨的数学方法值得投入。
该公司创始人是伊利诺伊大学厄巴纳-香槟分校(UIUC)的计算机科学教授,他把核心思想归纳为三点:
- 规格说明定义系统必须完成什么。
- 代码决定系统怎样完成。
- 数学是一座桥梁,用来证明某个“怎样”满足既定的“什么”。
形式化规格说明的研究可以追溯到20世纪60年代,但和编程语言本身一样,至今没有哪一种规格说明语言获得全行业的共识。编写详尽的规格说明既慢又繁琐,也一直是障碍。最新的AI模型能把自然语言表达的意图快得多地转换成形式化规格说明,正在改变这一局面。该公司训练模型根据开发者的意图同时生成规格说明和代码,并预期未来由AI把代码、规格说明和证明打包交付,人主要负责核查结果。
编写规格说明在Linux内核中揭示了什么
2026年10月,该公司发布报告,介绍了一个Linux漏洞:用户身份映射在没有任何提示的情况下被错误处理。团队是在编写规格说明时发现它的。这项工作集中在内核从用户空间接收并解析不可信输入的边界。为了定义正确行为,团队汇集了旧论坛帖子、开发者邮件列表讨论、文档和源代码,并把它们整理成形式化规则。据该公司介绍,这一步几乎总能找出代码悄悄偏离开发者原本意图的地方。
开源社区相信“只要看的人足够多,所有漏洞都无所遁形”,为什么这个缺陷还是逃过了审查?该公司的假设是,设备驱动这类外围子系统虽然处理不可信输入,受到的审查却远少于调度器这类备受关注的核心代码。
团队没有简单地向大语言模型(LLM)输入提示词,而是采用了分阶段的流程:
- 工程师亲自检查代码和形式化需求。
- 用LLM把旧有的C代码移植到内存安全语言Rust。
- 团队运行差分模糊测试,即向原来的C版本和Rust移植版输入相同的随机数据,并标出任何行为差异。这很快暴露出行为分歧和逻辑漏洞。
- 在尝试对Rust版本进行形式化证明时,又发现了模糊测试遗漏的更深层边界情况缺陷。
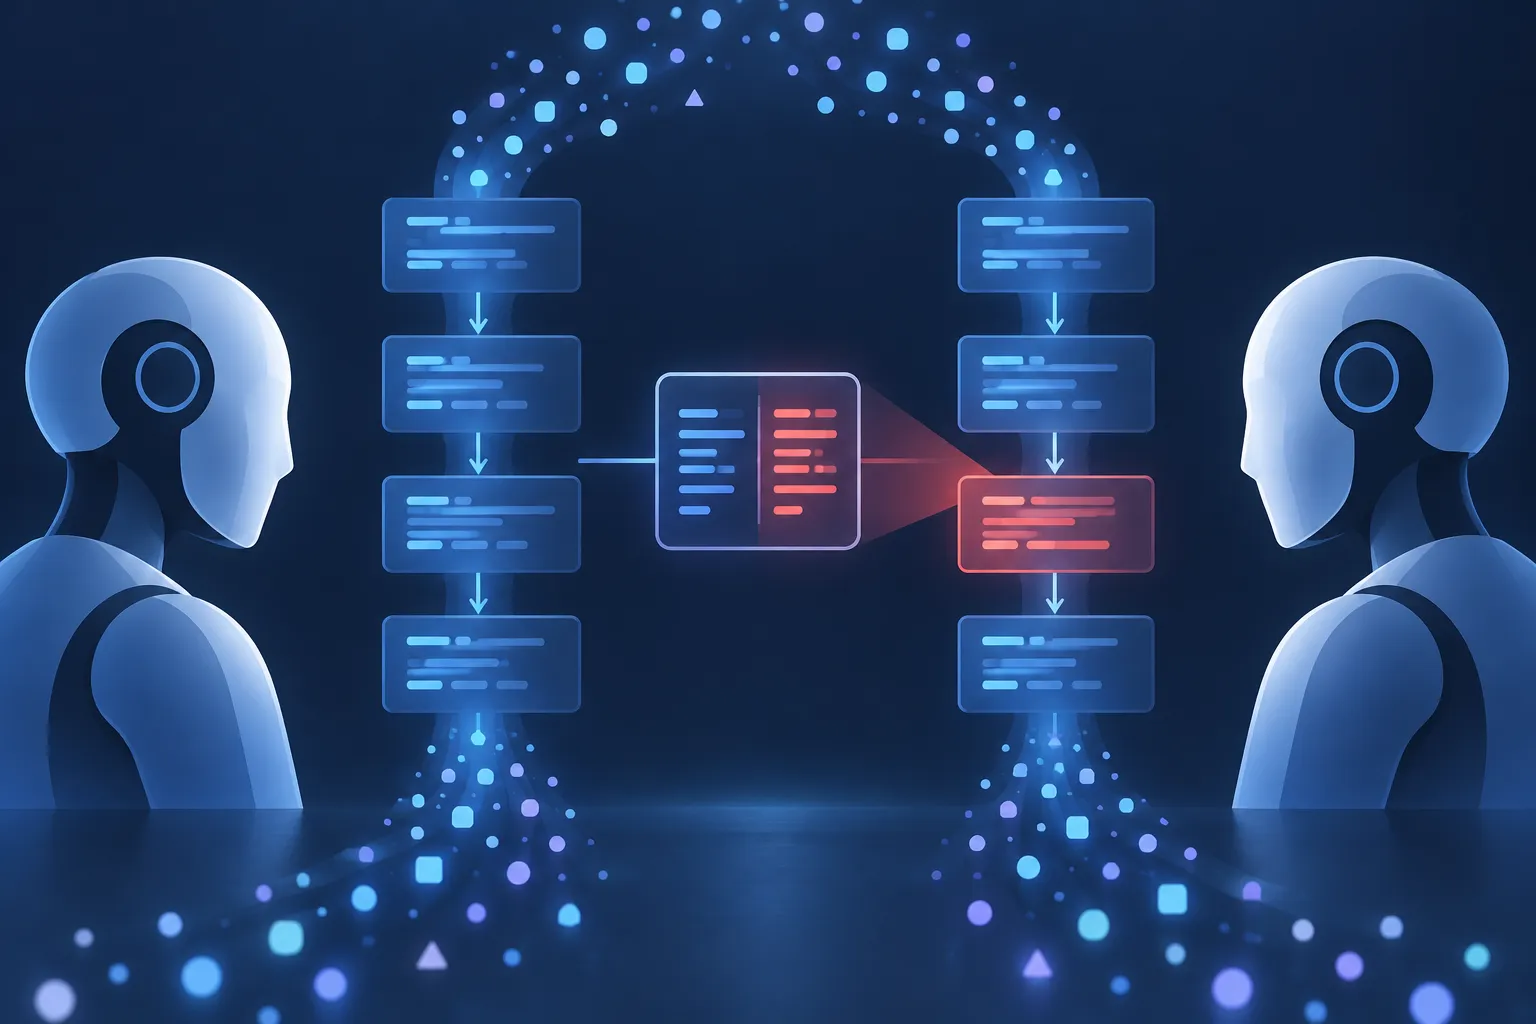
▲ 比较两个实现的差分模糊测试
工作按严格的两周时间盒推进。目标包括通过USB传输视频数据的USB Video Class(UVC)驱动,以及Android Binder IPC子系统,团队验证了80个或更多定理。未验证的部分并非无法证明,只是每轮冲刺按计划结束,团队随即转向下一个目标,并把方法整理成可复用的工具。所用配置也很简单,主要是一个标准付费套餐下的Claude Code实例。瓶颈在于工程师的时间,而不是token或算力。只要可能,LLM发现的技巧都会被转化为每次运行结果都相同的确定性测试工具。
内核维护者已经被大量低质量的AI生成补丁弄得疲惫不堪,他们明确表示不会接受或维护内核驱动的独立Lean或Rust代码。Lean是一种用来编写可由机器检查的数学证明的语言。因此,该公司把Lean和Rust模型留在内部,只向维护者提交高质量的C补丁。该公司最初直接推介形式化验证时遭到拒绝;在展示了可复现的漏洞和可直接合并的修复之后,维护者才开始欢迎合作。
任何开发者现在都能养成的验证习惯
要在AI辅助编程中加入验证,并不需要深厚的形式化方法专业知识。该公司的建议可按阶段整理如下:
| 阶段 | 做法 | 好处 |
|---|---|---|
| 生成代码之前 | 让Claude Opus 5.5这样的模型写出详细的多步骤计划,放在代码仓库里并逐行审阅 | 让你的意图与模型的计划对齐,审阅过的计划就成为准形式化的规格说明 |
| 移植代码时 | 让LLM搭建比较两个实现的差分模糊测试框架 | 精准定位移植错误和遗留漏洞 |
| 生成代码之后 | 让智能体为新代码编写Lean规格说明并证明其正确 | 迫使模型写明确切的不变量,从而暴露隐藏的逻辑缺陷 |
| 第三方边界处 | 为每个涉及未经验证的库的API写明前置条件和后置条件 | 为发现组件之间的误用提供依据 |
第一个习惯配有一句军中格言:慢即是稳,稳即是快。在模型的计划与你的要求一致之前,不要让它直接动手写代码。创始人把第三个习惯称为“代码审查加加”,因为大多数漏洞不是在证明定理时发现的,而是在形式化地写下程序应当实现什么时发现的。
验证何时开始带来回报
长期以来,形式化验证被视为会让工程工作量翻倍。该公司自己的估算如下:
| 方式 | 与不做验证相比的工作量 |
|---|---|
| 传统形式化验证 | 约2倍 |
| 在开发早期引入验证 | 约1.1至1.2倍 |
| 早期验证,再由LLM在形式化模型与可运行代码之间转换 | 约0.8倍,净节省 |
该公司举出亚马逊的Cedar作为企业成功案例:这是一个从Java和Kotlin改用Rust重新架构并经过形式化验证的身份与访问管理策略引擎,在具备形式化安全保证的同时运行速度快了三倍。在该公司看来,更重要的经验是,靠强制要求推广不了验证。工具必须自然融入开发者的日常工作流程,并立即带来价值。
智能体安全:验证监控器,而不是模型
证明神经网络的权重正确,或证明庞大的遗留操作系统栈正确,实际上都不可能。创始人的答案是运行时监控器,即监视运行中系统的轻量程序。监控器足够小,可以进行形式化验证。经过验证的监控器会在自主智能体周围划出安全包络,一旦智能体越界,就把它拉回安全范围或启动后备流程。即使智能体的推理本身未经验证,也仍能阻止灾难性行为。这一方法源自创始人2001年在NASA开始的研究。
该公司认为,这并不会限制智能体的创造力。经过验证的组件就像印有数学证明的Lego积木:无论智能体在上面搭建什么,底座都不会开裂。反过来,未经验证的AI生成代码依然容易被攻破。该公司警告,如果系统缺乏形式化验证,自动化攻击可能让单个攻击者也能侵入NASA这样的复杂基础设施。
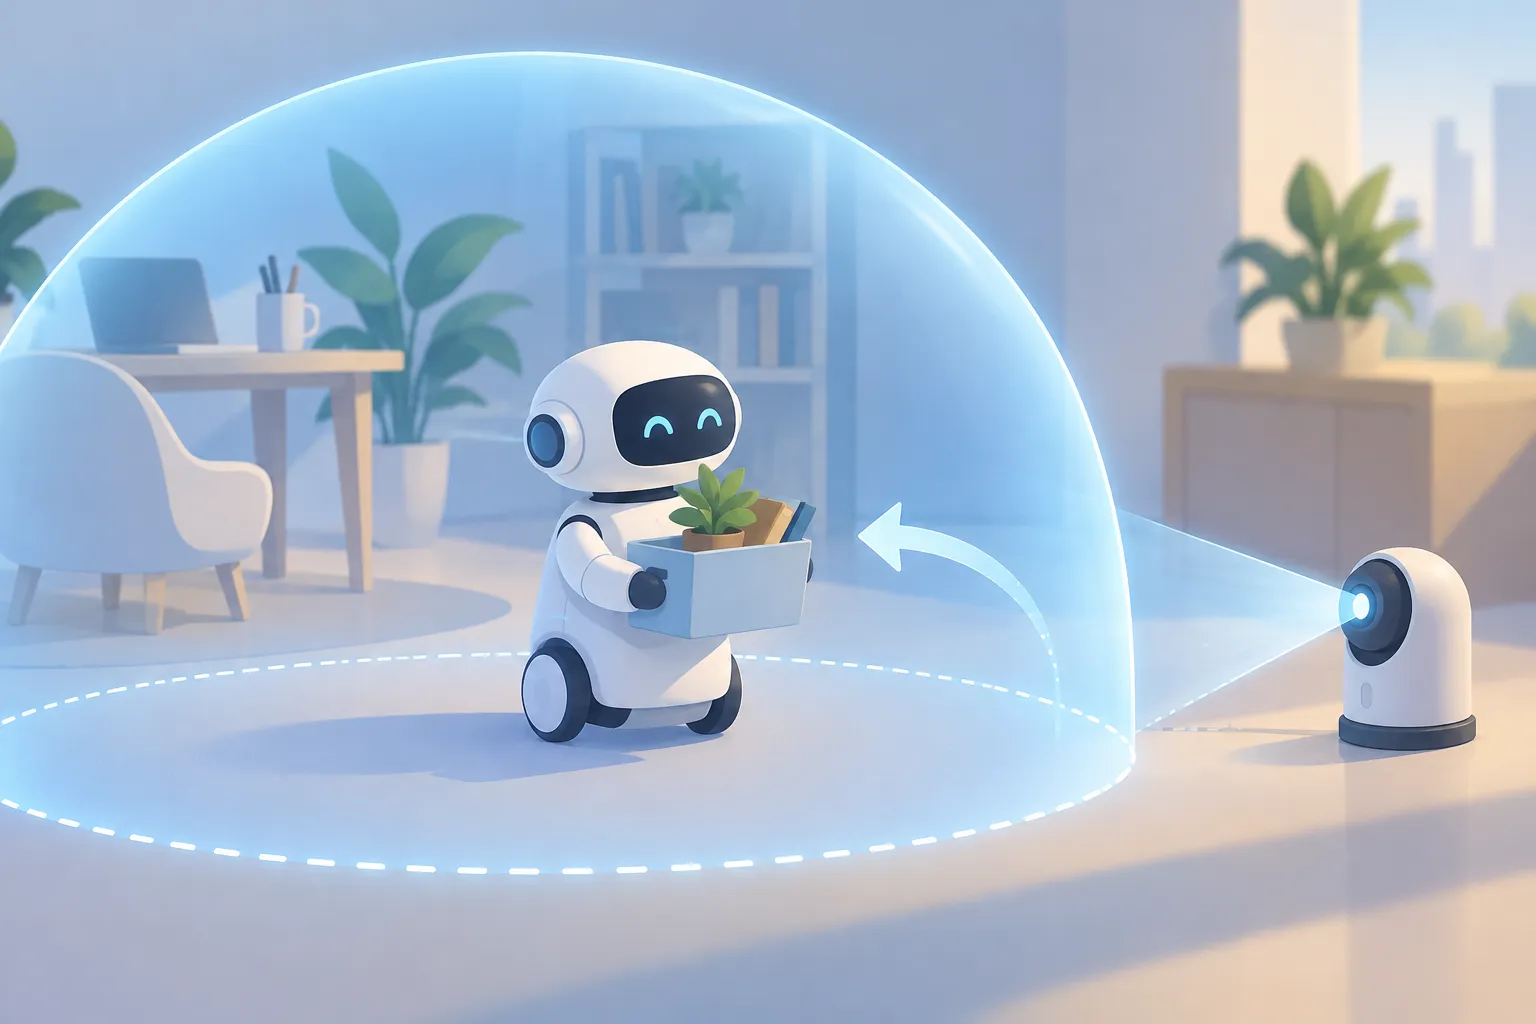
▲ 围绕AI智能体的验证安全包络
也有一些局限值得权衡。基于人类反馈的强化学习(RLHF)原本被设计为安全方法,最终却成为大幅提升能力、加速商业部署的突破。形式化验证也可能走上同样的路,只给智能体提供可靠的工具,却无法保证它们的意图。经过验证的沙箱和包管理器可以阻止智能体逃逸,却不能确保模型不去追求错误的目标。更坚固的护栏还可能带来虚假的安全感,促使机构把现实世界的权限交给仍不可信的模型。即使每一代模型的对齐失败越来越少,如果自主任务的时长大幅延长,日常工作可能看起来完美无缺,而罕见的失败却可能是重大事故。
结语:先写意图,再写代码
该公司CEO预测,两年内手写代码将基本成为过去;两到五年内,npm和Cargo等软件包生态将越来越多地要求提供形式化规格说明和Lean证明。他还预计,24个月内将出现覆盖Linux内核C代码的完整形式化模型,以及经证明行为完全一致的Rust翻译,不过上游维护者未必会立即采用。这些只是一家公司的预测,但验证工作的重心从编写代码转向定义意图,这一方向似乎值得现在就做准备。
用AI开发软件的开发者和团队可以这样做:
- 在写任何代码之前,先让模型给出设计计划,放在代码仓库中逐行审阅。
- 移植或重写某个实现时,加入差分模糊测试,用相同输入比较新旧版本。
- 对关键模块,让智能体编写Lean规格说明和证明,作为更深入的代码审查。
- 为每个涉及未经验证第三方库的API边界写明前置条件和后置条件。
- 在把智能体接入真实系统之前,不要只依赖模型,先部署能约束其允许行为的监控器和手动后备手段。