AI coding agent가 하루에 쏟아 내는 코드를 사람이 한 줄씩 읽고 검토하기는 이미 어렵습니다. 이 문제의 해법으로 formal verification(코드가 요구 사항을 지키는지 수학적으로 증명하는 방법)이 다시 주목받고 있습니다. 한 formal verification 전문 기업은 Linux kernel의 일부를 검증하다가 오랫동안 드러나지 않던 버그를 찾았는데, 그 가운데 한 버그는 증명 단계가 아니라 코드가 무엇을 해야 하는지 적는 명세(spec)를 쓰던 중에 드러났습니다. AI가 코드를 쓰는 시대에 사람이 맡을 일은 ’어떻게’보다 ’무엇을’을 정확히 적는 쪽으로 옮겨 가고 있다는 것이 이 회사의 판단입니다.
시험해 보는 대신 미리 증명하는 방식
다리를 설계하는 엔지니어는 차를 몰고 건너가 무너지는지 보지 않습니다. 하중, 바람, 응력을 먼저 계산합니다. 반면 소프트웨어는 고치기 쉽고 비용이 적게 들어서 ‘만들고 시험하고 고치는’ 방식이 자리 잡았습니다. 이 회사의 CEO는 이제 소프트웨어 장애가 다리 붕괴만큼 심각하고 큰 손실을 낳는 수준이 됐기 때문에 수학적인 방법이 필요하다고 봅니다.
UIUC 컴퓨터과학 교수인 이 회사의 창업자는 둘의 차이를 이렇게 정리합니다.
- 명세는 시스템이 ’무엇’을 해내야 하는지 정합니다.
- 코드는 그것을 ‘어떻게’ 해낼지 정합니다.
- 수학은 이 ’어떻게’가 그 ’무엇’을 만족하는지 증명하는 다리 역할을 합니다.
formal specification 연구는 1960년대부터 이어졌지만, 모두가 받아들인 하나의 명세 언어는 끝내 나오지 않았습니다. 명세를 빠짐없이 쓰는 일이 지루하고 손이 많이 간다는 점도 오랜 걸림돌이었습니다. 최근 AI 모델이 사람이 말로 적은 의도를 형식 명세로 옮기는 일을 훨씬 빠르게 해 주면서 이 장벽이 낮아지고 있습니다. 이 회사는 개발자의 의도를 받아 명세와 코드를 함께 만들어 내도록 모델을 훈련하고 있으며, 앞으로는 AI가 코드, 명세, 증명을 한 묶음으로 내놓고 사람은 주로 확인하는 역할을 맡게 될 것으로 봅니다.
Linux kernel에서 명세가 먼저 찾아낸 버그
이 회사가 2026년 10월에 공개한 보고서는 Linux kernel에서 사용자 신원 매핑이 아무 경고 없이 잘못 처리되는 버그를 다뤘습니다. 이 버그는 명세를 쓰는 도중에 드러났습니다. 작업은 kernel이 사용자에게서 신뢰할 수 없는 입력을 받아 처리하는 경계 부분에 집중했고, 올바른 동작을 정의하려고 오래된 포럼 글, 개발자 메일링 리스트의 논의, 문서, 소스 코드를 모아 수학적 규칙으로 정리했습니다. 이렇게 명세를 적다 보면 실제 코드가 개발자의 원래 의도에서 미묘하게 벗어난 곳이 거의 늘 드러난다고 합니다.
많은 사람이 코드를 보면 버그가 쉽게 드러난다는 오픈소스의 믿음과 달리 이 버그가 오래 남은 이유에 대해, 이 회사는 device driver(하드웨어 장치를 다루는 프로그램) 같은 주변 하위 시스템이 핵심 scheduler 코드보다 검토를 훨씬 덜 받는다는 가설을 내놓습니다. 신뢰할 수 없는 입력을 받는 곳인데도 눈길이 덜 간다는 것입니다.
이 회사는 LLM에 막연히 prompt를 넣는 대신 단계를 나눈 방법을 썼습니다.
- 사람이 코드와 형식 요구 사항을 직접 살핍니다.
- LLM으로 기존 C 코드를 메모리 안전성이 높은 Rust로 옮깁니다.
- 원래 C 구현과 Rust 구현에 같은 입력을 넣어 결과를 비교하는 differential fuzzing을 돌려 동작 차이와 논리 버그를 찾습니다.
- Rust 구현의 정확성을 formal proof로 증명하면서 fuzzing이 놓친 더 깊은 경계 사례의 결함을 찾습니다.
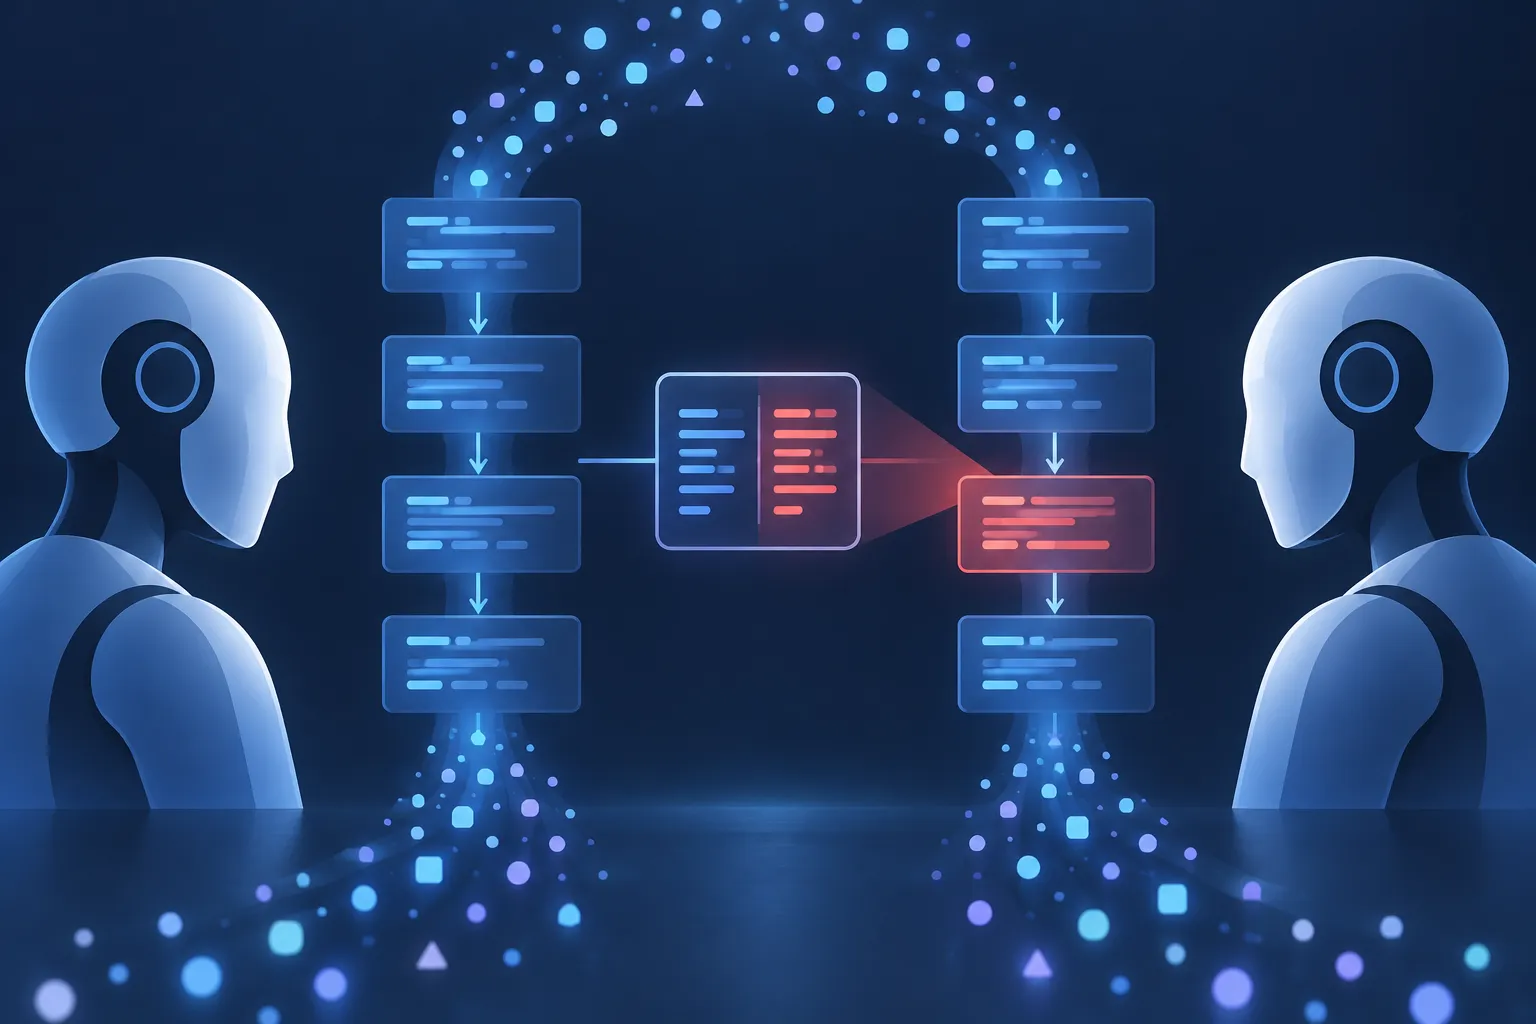
▲ 두 구현을 비교하는 검증
작업은 2주 단위로 끊어 진행했습니다. 대상은 USB로 영상 데이터를 주고받는 USB Video Class(UVC) driver와 Android Binder IPC 하위 시스템이었고, 80개 이상의 정리를 증명했습니다. 나머지 부분이 검증할 수 없어서 남은 것은 아니며, 정해진 2주가 끝나면 다음 대상으로 넘어가며 방법을 다듬고 도구로 묶는 방식이라는 설명입니다. 쓴 도구도 간소했습니다. 일반 유료 요금제의 Claude Code 하나가 중심이었고, 병목은 token이나 컴퓨팅 예산이 아니라 엔지니어의 시간이었습니다. LLM이 찾아낸 기법은 가능한 한 결과가 늘 같은 결정론적 시험 도구로 바꿔 둡니다.
Linux kernel 관리자들은 품질이 낮은 AI 생성 patch가 몰려드는 데 이미 지쳐 있고, kernel driver를 위한 Lean(수학 증명을 기계로 확인하는 정리 증명 언어)이나 Rust 코드를 따로 받아 관리하지 않겠다는 뜻도 분명히 했습니다. 그래서 이 회사는 Lean과 Rust 모델을 내부에 두고, 관리자에게는 믿을 만한 C patch만 보냅니다. 처음 formal verification 자체를 제안했을 때는 관리자들이 받아들이지 않았지만, 재현할 수 있는 버그와 바로 병합할 수 있는 patch를 내놓자 협업을 반기게 됐다고 합니다.
개발자가 지금 바로 쓸 수 있는 검증 습관
formal methods 전문 지식이 없는 개발자도 AI 코딩 작업에 검증을 붙일 수 있습니다. 이 회사가 권하는 방법은 다음과 같습니다.
| 시점 | 할 일 | 얻는 것 |
|---|---|---|
| 코드 생성 전 | Claude Opus 5.5 같은 모델에게 여러 단계의 설계 계획부터 쓰게 하고, 저장소 안 문서로 두어 한 줄씩 검토하고 고칩니다 | 개발자의 의도와 모델의 계획이 맞춰지고, 검토한 계획이 준(準) 명세가 됩니다 |
| 구현을 옮길 때 | 두 구현에 같은 무작위 입력을 넣는 differential fuzzing harness를 LLM에게 만들게 합니다 | 옮기는 과정의 오류와 기존 버그가 드러납니다 |
| 코드 생성 후 | agent에게 새 코드의 Lean 명세를 쓰고 정확성을 증명하게 합니다 | 코드가 지켜야 할 불변 조건을 설명하는 과정에서 숨은 논리 결함이 나옵니다 |
| 외부 라이브러리와 만날 때 | 검증되지 않은 라이브러리와 맞닿는 API 경계의 사전·사후 조건을 명세합니다 | 구성 요소 사이의 잘못된 사용을 잡을 근거가 생깁니다 |
첫 번째 습관에는 ’천천히 하는 것이 매끄럽고, 매끄러운 것이 빠르다’는 군대 격언이 붙습니다. 모델에게 곧바로 코드를 쓰게 하지 말고 계획을 먼저 맞추라는 뜻입니다. 세 번째 방법을 창업자는 ’code review plus plus’라고 부릅니다. 버그 대부분은 정리를 증명하는 단계보다 프로그램이 무엇을 이뤄야 하는지 형식으로 적는 단계에서 발견되기 때문입니다.
검증이 비용에서 이득으로 바뀌는 계산
formal verification은 오랫동안 개발 비용을 두 배로 늘리는 일로 여겨졌습니다. 이 회사의 계산은 다음과 같습니다.
- 예전 방식: 개발 노력의 약 2배
- 개발 초기에 검증을 넣을 때: 약 1.1~1.2배
- LLM으로 형식 검증과 실행 코드 사이를 옮길 때: 약 0.8배, 곧 검증이 오히려 노력을 줄임
성공 사례로는 Amazon이 Java와 Kotlin으로 만든 권한 정책 엔진 Cedar를 Rust로 다시 설계하고 formal verification을 거친 일이 꼽힙니다. 보안을 형식적으로 보장하면서 실행 속도도 세 배 빨라졌다는 설명입니다. 다만 이 회사는 검증을 의무로 밀어붙여서는 퍼지지 않으며, 개발자가 매일 쓰는 흐름에 자연스럽게 들어가 바로 가치를 주는 도구여야 한다고 강조합니다.
AI agent 안전: 모델 대신 감시 장치를 증명한다
신경망의 가중치나 거대한 기존 운영체제 스택의 정확성을 수학적으로 증명하는 일은 사실상 불가능합니다. 창업자가 대안으로 내놓는 것은 runtime monitor(실행 중인 시스템의 동작을 지켜보는 가벼운 감시 프로그램)입니다. 감시 장치는 작아서 형식 검증을 할 수 있고, 검증된 감시 장치가 agent 주위에 ’안전 범위(safety envelope)’를 둘러 범위를 벗어나면 안전한 상태로 되돌리거나 대체 절차를 실행합니다. agent의 추론 자체는 검증되지 않았더라도 치명적인 행동은 막을 수 있다는 구상이며, 창업자가 2001년 NASA에서 시작한 연구에 뿌리를 두고 있습니다.
이 회사는 검증이 agent의 창의성을 묶는 것이 아니라고 설명합니다. 증명이 찍힌 Lego 블록처럼 검증된 부품을 쓰면 agent가 무엇을 쌓든 바닥부터 무너지지는 않는다는 것입니다. 반대로 검증되지 않은 AI 생성 코드는 공격에 쉽게 뚫릴 수 있고, 공격 자동화가 퍼지면 혼자 움직이는 공격자도 NASA 같은 복잡한 기반 시설에 침투할 수 있다는 경고도 덧붙입니다.
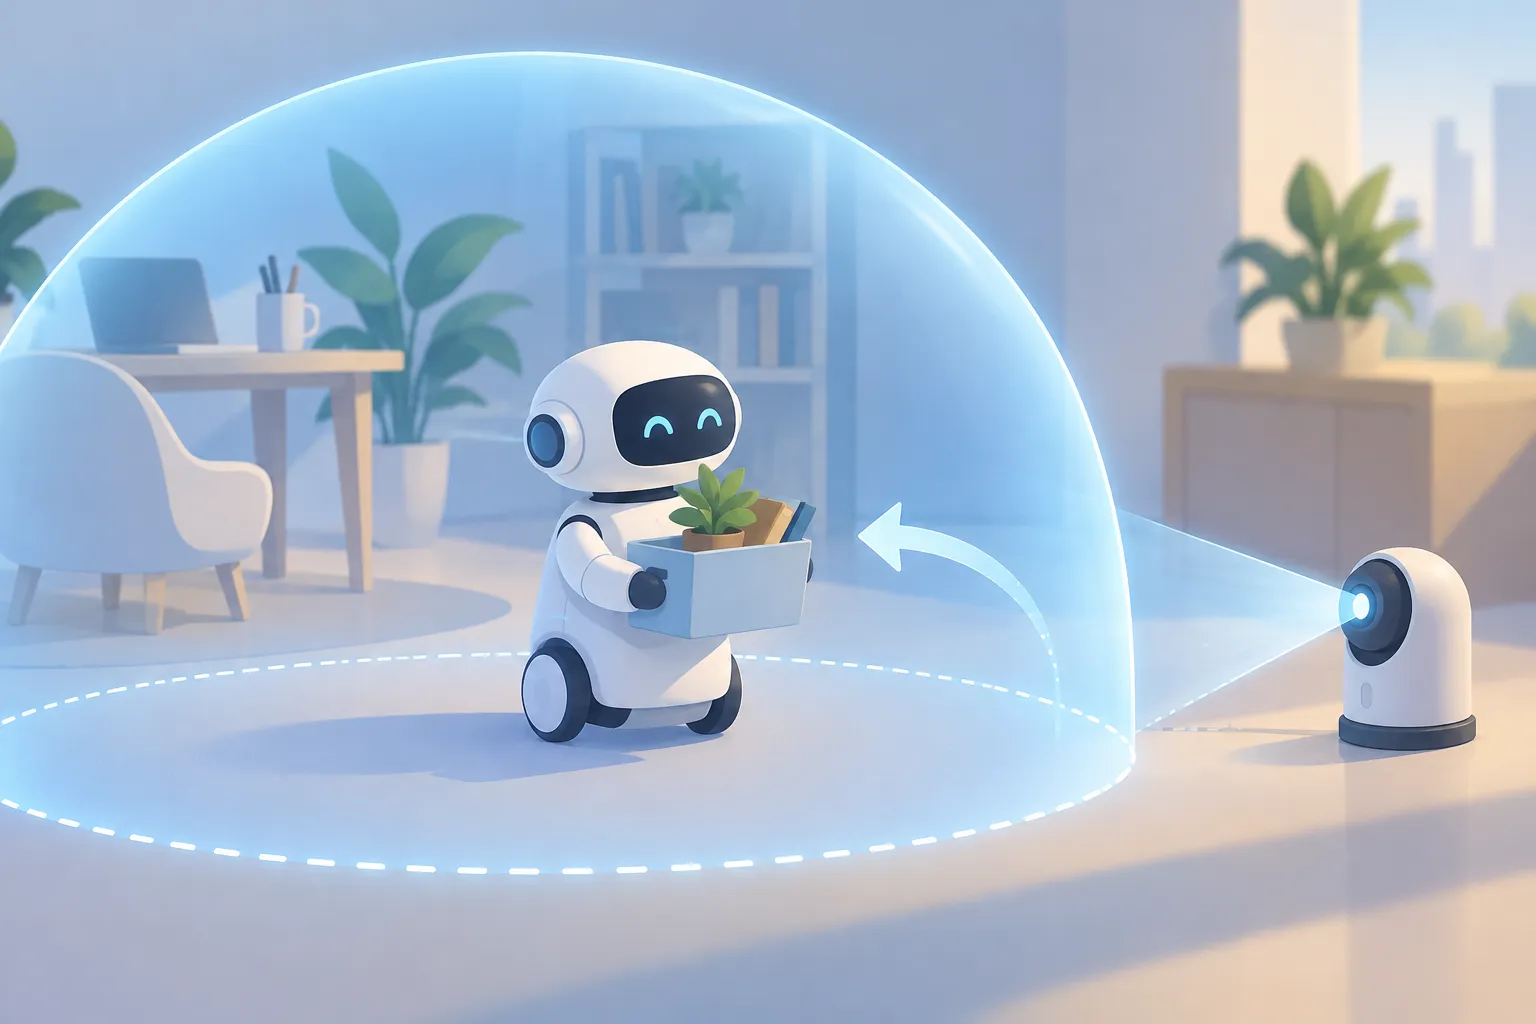
▲ agent를 감싸는 안전 범위
한계도 함께 봐야 합니다. RLHF(사람의 피드백으로 모델을 강화 학습하는 방법)가 안전 장치로 고안됐지만 결과적으로는 모델 능력을 크게 끌어올려 상용화를 앞당긴 것처럼, formal verification도 agent에게 믿을 만한 도구를 쥐여 주는 데 그칠 수 있다는 우려가 있습니다. 검증된 sandbox(격리된 실행 환경)와 package manager는 agent가 밖으로 빠져나가는 길을 막을 수 있지만, 모델이 엉뚱한 목표를 좇지 않는다는 보장은 되지 않습니다. 안전장치가 튼튼해 보일수록 아직 신뢰하지 못하는 모델에 현실 세계의 권한을 더 일찍 넘기게 될 수 있다는 점도 지적됩니다. 세대마다 정렬 실패의 빈도가 줄더라도 agent가 혼자 일하는 시간이 크게 늘어나면, 평소에는 완벽해 보이다가 드물게 큰 사고로 이어질 수 있다는 분석입니다.
정리: 코드보다 의도를 먼저 적는 습관
이 회사의 CEO는 2년 안에 사람이 직접 코드를 쓰는 일이 거의 사라지고, 2~5년 안에 npm과 Cargo 같은 공개 패키지 생태계가 형식 명세와 Lean 증명을 점점 더 요구하게 될 것으로 내다봅니다. 24개월 안에는 Linux의 C 코드를 수학적으로 다룬 모델과 동작이 같다고 증명된 Rust 번역이 나오리라는 예측도 내놓았습니다. 다만 Linux 관리자들이 이를 곧바로 받아들이지는 않을 수 있다고 덧붙였습니다. 모두 한 기업의 전망이지만, 검증의 무게가 코드 작성에서 의도 정의로 옮겨 간다는 방향은 AI로 코드를 쓰는 팀이라면 지금부터 염두에 둘 만해 보입니다.
AI로 코드를 만드는 개발자와 팀이 바로 해 볼 수 있는 일은 다음과 같습니다.
- 모델에게 코드보다 설계 계획을 먼저 받고, 저장소에 둔 계획 문서를 한 줄씩 검토합니다.
- C에서 Rust로 옮기는 것처럼 구현을 바꿀 때는 두 구현에 같은 입력을 넣어 비교하는 differential fuzzing을 붙입니다.
- 중요한 모듈은 agent에게 Lean 명세와 증명을 쓰게 해 코드 검토를 한 단계 더 깊게 합니다.
- 검증되지 않은 외부 라이브러리와 만나는 API 경계부터 사전·사후 조건을 적어 둡니다.
- agent를 실제 시스템에 연결할 때는 모델을 믿기보다 동작 범위를 지키는 감시 장치와 수동 대체 수단을 먼저 마련합니다.