AIのコーディングエージェントは、どのチームも1行ずつ読み切れない速さでコードを書くようになりました。この差を背景に、ソフトウェアが要件を満たすことを数学的に証明する手法、形式検証(フォーマル・ベリフィケーション)がニッチな分野から表舞台に出てきています。この分野を専門とするある企業は、Linuxカーネルで長く見過ごされてきたバグを見つけましたが、そのうちの1件は証明に取りかかる前に見つかりました。コードが何をすべきかを書き出している最中に見つかったのです。同社がここから引き出す教訓は、ソフトウェアの「どう作るか」をAIが担うようになるにつれて、人間の仕事は「何を実現するか」を正確に記述する方向へ移るということです。
後から試すのではなく、先に証明する
橋を設計するエンジニアは、車で渡って崩れるかどうかを確かめたりしません。荷重、風によるせん断力、応力の許容範囲を事前に計算します。ソフトウェアは別の道をたどりました。コードは安く簡単に書き換えられたため、作っては試す反復のサイクルが当たり前になったのです。同社のCEOは、ソフトウェアの障害がいまや橋の崩落と同じくらい深刻で大きな損失を生み得るようになったため、厳密な数学的手法に手間をかける価値があると主張します。
イリノイ大学アーバナ・シャンペーン校(UIUC)でコンピューターサイエンスを教える同社の創業者は、核となる考え方を3つに整理します。
- 仕様は、システムが何を達成すべきかを定めます。
- コードは、それをどう達成するかを決めます。
- 数学は、ある「どう」が定められた「何」を満たすことを証明する橋渡しです。
形式仕様の研究は1960年代にさかのぼりますが、プログラミング言語と同じように、業界全体が合意した単一の仕様記述言語はいまだに生まれていません。網羅的な仕様を書く作業が遅く退屈だったことも障壁でした。最近のAIモデルは、自然言語で書かれた意図をはるかに速く形式仕様に変換することで、この状況を変えつつあります。同社は開発者の意図を受け取って仕様とコードを同時に生成するようモデルを訓練しており、AIがコード、仕様、証明をひとまとめにして出力し、人間は主に結果を確認する未来を見込んでいます。
仕様を書くことでLinuxカーネルから見えてきたもの
同社は2026年10月、ユーザーIDのマッピングが警告なしに誤って処理されるLinuxのバグについての報告を公開しました。このバグは仕様を書く過程で見つかりました。作業の対象は、カーネルがユーザー空間から信頼できない入力を受け取って解析する境界部分です。正しい動作を定義するために、チームは古いフォーラムの投稿、開発者メーリングリストのスレッド、ドキュメント、ソースコードを集め、形式的なルールにまとめました。同社によれば、この工程ではほぼ必ず、コードが開発者の本来の意図から静かにずれている箇所が見つかるといいます。
十分な数の目があればどんなバグも見つかるというオープンソースの考え方があるのに、なぜこの欠陥はレビューをすり抜けたのでしょうか。同社の仮説は、デバイスドライバーのような周辺のサブシステムは、信頼できない入力を扱うにもかかわらず、スケジューラーのような注目度の高い中核コードに比べてはるかに精査が少ないというものです。
チームは大規模言語モデル(LLM)にプロンプトを投げるだけで済ませず、段階的な手順を踏みました。
- エンジニアがコードと形式的な要件を自分の目で確認しました。
- LLMで既存のCコードをメモリー安全な言語であるRustに移植しました。
- 元のC版とRust版に同じランダムな入力を与え、動作の違いを検出するディファレンシャルファジングを実行しました。これにより、動作の食い違いやロジックのバグがすぐに見つかりました。
- Rust版の形式的な証明を試みる過程で、ファジングが見逃していたより深いエッジケースの欠陥が見つかりました。
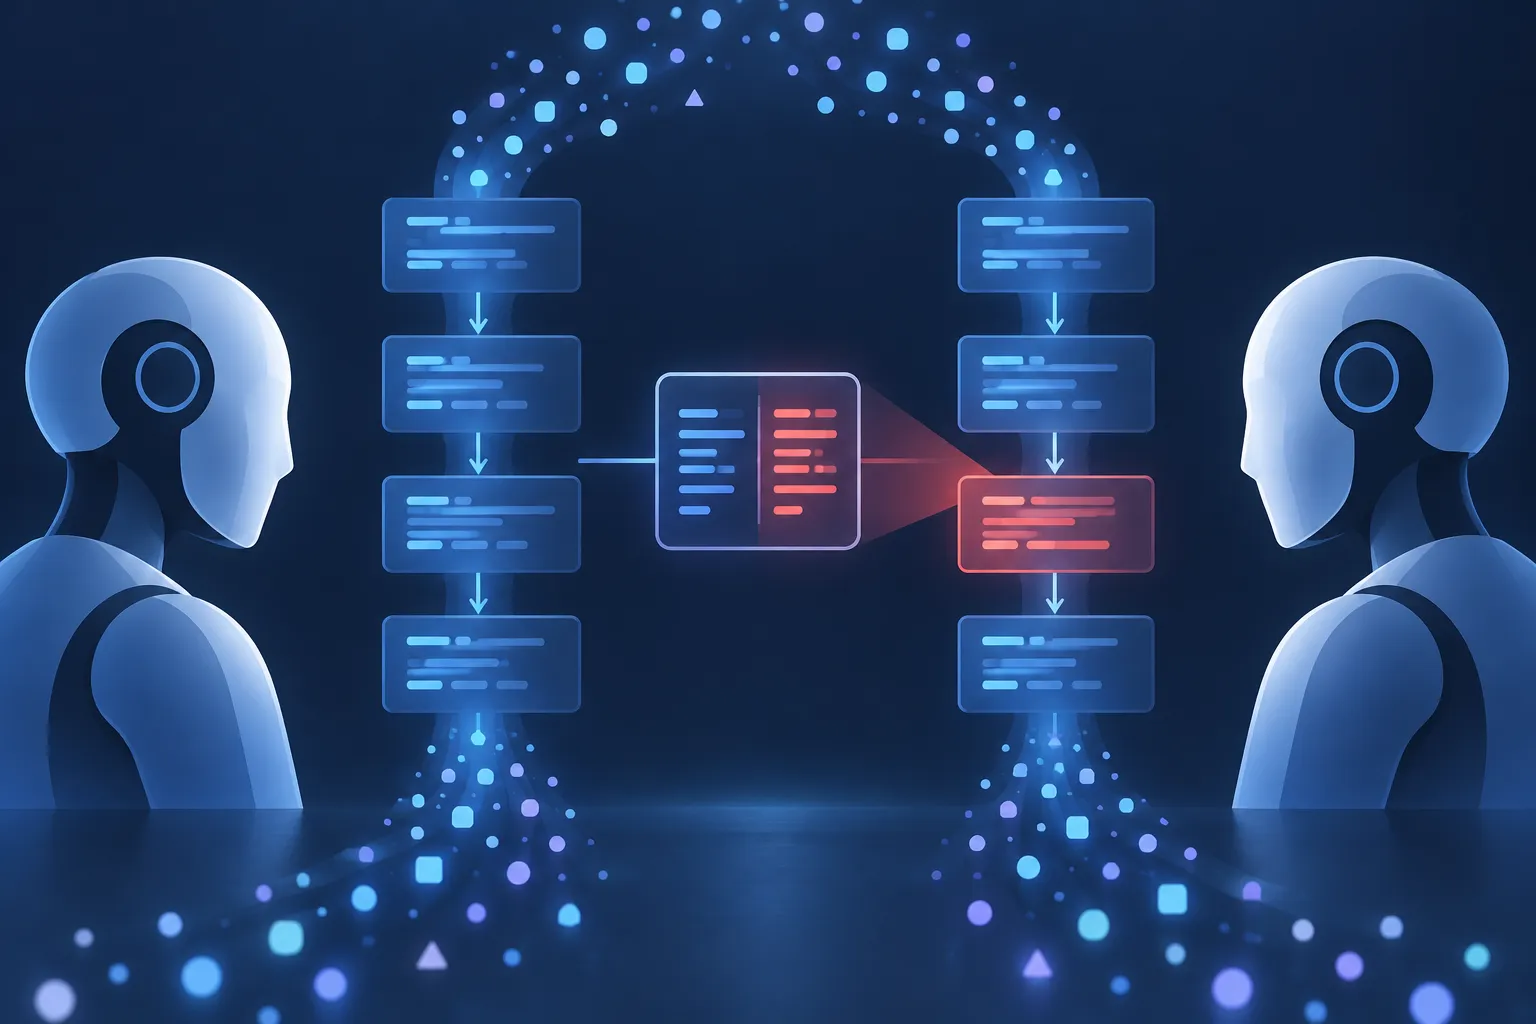
▲ 2つの実装を比べるディファレンシャルファジング
作業は2週間ずつの厳格なタイムボックスで進めました。対象には、USB経由で映像データをやり取りするUSB Video Class(UVC)ドライバーと、Android Binder IPCサブシステムが含まれ、チームは80以上の定理を検証しました。検証されずに残った部分は証明できなかったわけではありません。各スプリントが予定どおりに終わり、チームが次の対象に移って手法を再利用できるツールにまとめていったためです。体制は控えめで、主に標準的な有料プランのClaude Code 1つで進めました。ボトルネックはトークンや計算資源ではなく、エンジニアの時間でした。LLMが見つけた手法は、可能な限り毎回同じ結果を返す決定論的なテストツールに置き換えています。
カーネルのメンテナーは低品質なAI生成パッチの大量流入にすでに疲れており、カーネルドライバー向けにLeanやRustのコードを別に受け入れたり保守したりはしないとはっきり伝えています。Leanは、機械が検査できる数学的な証明を書くための言語です。そこで同社はLeanとRustのモデルを社内に置き、メンテナーには信頼性の高いCのパッチだけを送っています。形式検証そのものを最初に提案したときは断られましたが、再現できるバグとすぐにマージできる修正を示したことで、メンテナーは協力を歓迎するようになりました。
どの開発者もいますぐ取り入れられる検証の習慣
AIを使ったコーディングに検証を加えるのに、形式手法の深い専門知識は要りません。同社の助言を段階ごとに整理すると次のとおりです。
| 段階 | やること | 効果 |
|---|---|---|
| コード生成の前 | Claude Opus 5.5のようなモデルに多段階の詳細な計画を書かせ、リポジトリに置いて1行ずつレビューする | 自分の意図とモデルの計画がそろい、レビュー済みの計画が準形式的な仕様になる |
| コードを移植するとき | 2つの実装を比較するディファレンシャルファジングのハーネスをLLMに作らせる | 移植時の誤りや既存のバグを突き止められる |
| コード生成の後 | 新しいコードのLean仕様を書かせ、正しさを証明させる | 正確な不変条件をモデルに書かせることで、隠れたロジックの欠陥が表に出る |
| 外部ライブラリとの境界 | 検証されていないライブラリに触れるすべてのAPIについて事前条件と事後条件を記述する | コンポーネント間の誤用を検出する根拠ができる |
1つ目の習慣には「ゆっくりは滑らか、滑らかは速い」という軍隊の格言が添えられています。計画が自分の望みと一致するまで、モデルをいきなりコードに進ませないということです。創業者は3つ目の習慣を「コードレビュー・プラスプラス」と呼びます。バグの多くは定理を証明しているときではなく、プログラムが達成すべきことを形式的に書き出しているときに見つかるからです。
検証が元を取り始めるとき
形式検証は長い間、開発の手間を倍にするものと見なされてきました。同社自身の見積もりは次のとおりです。
| 方法 | 検証なしで開発する場合と比べた手間 |
|---|---|
| 従来の形式検証 | 約2倍 |
| 開発の初期から検証を組み込む | 約1.1~1.2倍 |
| 初期からの検証に加え、形式モデルと実行可能なコードの間の変換をLLMが担う | 約0.8倍で、差し引きで手間が減る |
同社は企業での成功例として、AmazonのCedarを挙げます。JavaとKotlinからRustで再設計され、形式検証を経たアクセス管理(IAM)のポリシーエンジンで、形式的なセキュリティ保証を備えながら3倍速く動作するといいます。同社の見方では、より大きな教訓は、義務づけでは検証は広まらないということです。ツールは開発者の日々の作業の流れに自然に組み込まれ、すぐに価値をもたらす必要があります。
エージェントの安全性はモデルではなく監視役を検証する
ニューラルネットワークの重みが正しいこと、あるいは巨大な既存のOSスタックが正しいことを証明するのは、実質的に不可能です。創業者の答えはランタイムモニター、つまり実行中のシステムを見張る軽量なプログラムです。モニターは形式検証できるほど小さく、検証済みのモニターは自律型エージェントの周囲に安全範囲(セーフティエンベロープ)を設け、エージェントが一線を越えると安全な範囲に引き戻すか、代替の手順を起動します。エージェントの推論そのものが検証されていなくても、致命的な行動は防げるという考え方です。この手法は、創業者が2001年にNASAで始めた研究から生まれました。
同社は、これがエージェントの創造性を制限するものではないと主張します。検証済みの部品は数学的な証明が刻印されたLegoブロックのようなもので、エージェントがその上に何を組み上げても土台は割れません。一方で、検証されていないAI生成コードは攻撃に弱いままで、システムに形式検証がなければ、攻撃の自動化によって単独の攻撃者でもNASAのような複雑なインフラに侵入できるようになり得ると同社は警告します。
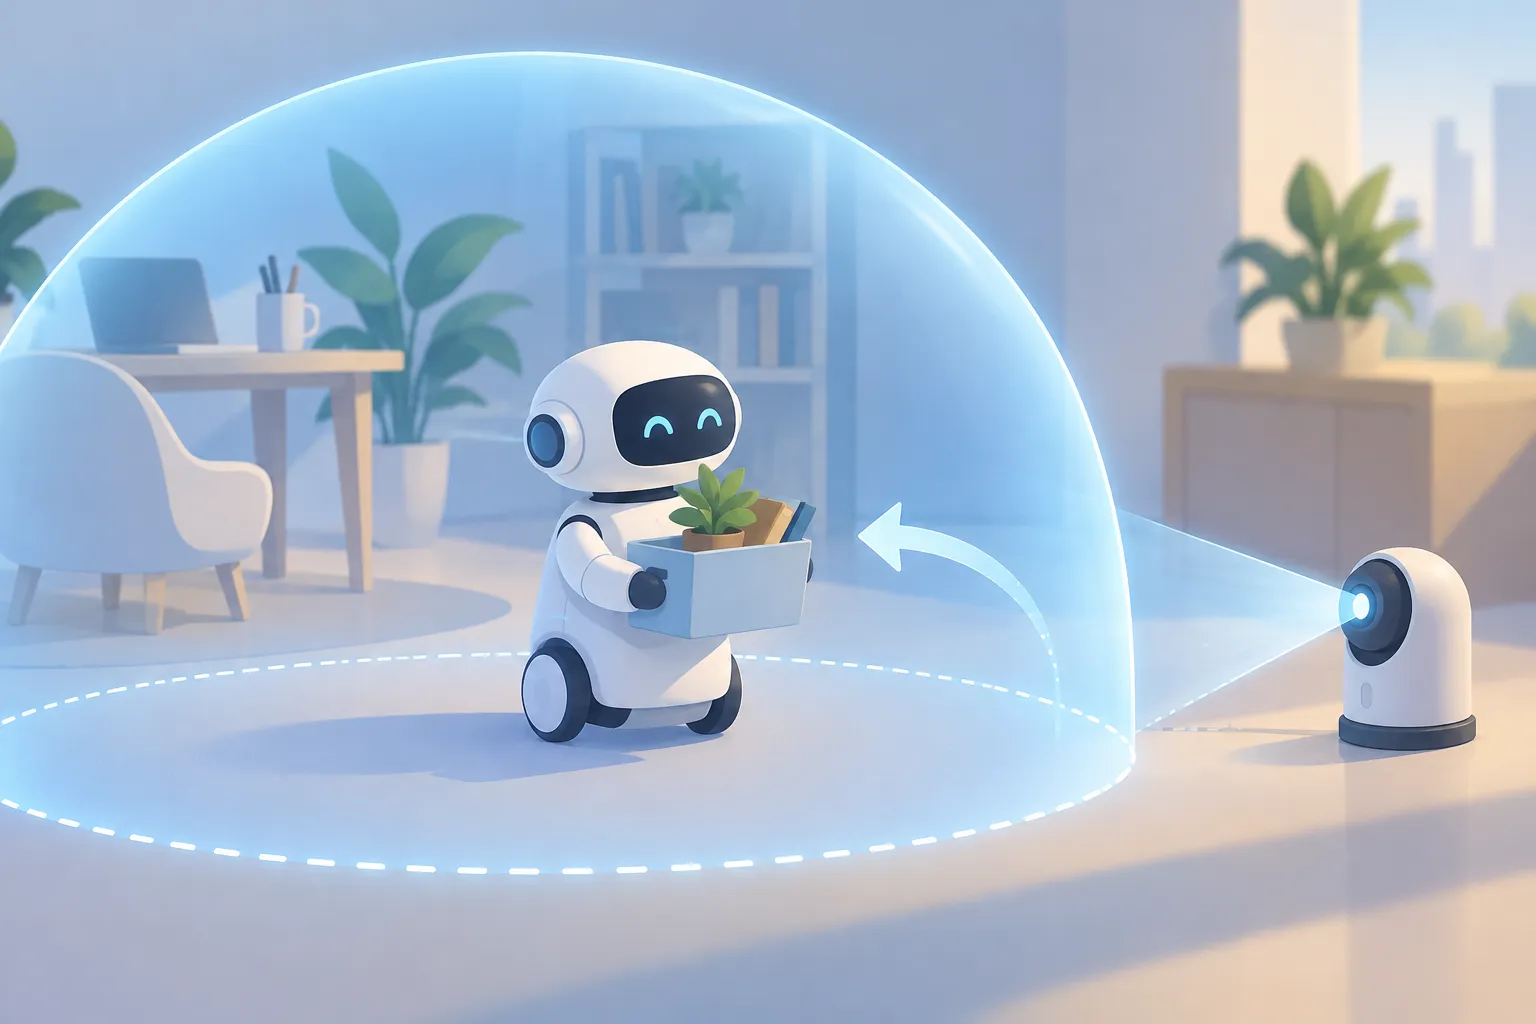
▲ AIエージェントを囲む検証済みの安全範囲
限界も検討しておくべきです。人間のフィードバックによる強化学習(RLHF)は安全のための手法として考案されましたが、結果としては商用展開を加速させる大きな能力向上につながりました。形式検証も同じ道をたどり、エージェントの意図を保証しないまま、信頼できる道具だけを与えることになるかもしれません。検証済みのサンドボックスやパッケージマネージャーはエージェントの脱出を防げますが、モデルが誤った目標を追わないことまでは保証できません。ガードレールが強固になるほど誤った安心感が生まれ、まだ信頼できないモデルに組織が現実世界の権限を渡してしまうおそれもあります。モデルの世代を重ねるごとにミスアラインメント(意図とのずれ)が減ったとしても、自律的に動く作業時間が大幅に長くなれば、ふだんの作業は完璧に見える一方で、まれに起きる失敗が大きなものになる可能性があります。
まとめ:コードを書く前に意図を書く
同社のCEOは、人がコードを手で書く仕事は2年以内にほぼ過去のものになり、2~5年以内にはnpmやCargoのようなパッケージのエコシステムが形式仕様とLeanの証明をますます求めるようになると予測します。また24か月以内に、LinuxカーネルのCコードを網羅する形式モデルと、同じ動作をすることが証明されたRustへの翻訳がそろうと見ていますが、上流のメンテナーがすぐに採用するとは限らないとも述べています。これらは1社の予測ですが、検証の重心がコードを書くことから意図を定めることへ移るという方向性には、いまから備えておく価値がありそうです。
AIでソフトウェアを作る開発者やチームができることは次のとおりです。
- コードより先にモデルから設計計画を受け取り、リポジトリに置いて1行ずつレビューします。
- 実装を移植したり書き直したりするときは、新旧の版に同じ入力を与えて比べるディファレンシャルファジングを加えます。
- 重要なモジュールでは、より踏み込んだコードレビューとして、Lean仕様と証明をエージェントに書かせます。
- 検証されていない外部ライブラリに触れるすべてのAPI境界について、事前条件と事後条件を書いておきます。
- エージェントを実際のシステムにつなぐ前に、モデルだけに頼るのではなく、許可された行動を守らせるモニターと手動の代替手段を用意します。