Cloudflare가 오픈소스로 공개한 security-audit skill을 Claude Code에 설치해, 6개월 넘게 개발하며 실제 유료 사용자를 받고 있는 회계·영수증 관리 SaaS를 점검한 결과가 공개됐습니다. 탐색 agent가 후보 26건을 찾아냈고, 이를 별도의 검증 agent가 실제로 공격해 본 뒤 21건을 진짜 취약점으로 확정했습니다. 그중에는 로그인만 하면 데이터베이스의 master key를 읽을 수 있는 치명적인 결함도 있었습니다. 이 글은 이 무료 skill 하나로 어떤 종류의 문제가 잡히는지, 그리고 감사 보고서를 티켓으로 바꿔 agent가 고치고 다시 감사해 검증하는 흐름을 정리하고, Anthropic의 Claude Code Security Review와는 쓰임새가 어떻게 다른지 짚습니다.
48시간에 27건, 공격 쪽에도 AI agent가 붙었습니다
2026년 10월 하순, 48시간 안에 27건이 넘는 주요 보안 사고가 터지면서 개발자 커뮤니티는 이 시기를 'Black October'라고 부르기 시작했습니다. 웹의 80%를 떠받치는 PHP에서 CVSS(취약점 심각도 점수) 9.2점짜리 결함이 나왔고, GitLab은 최고 등급인 10.0점, Signal은 9.3점을 받았습니다. Node.js 22, 24, 26 버전에서는 원격으로 서버를 장악할 수 있는 결함이 발견됐고, Java와 WordPress에서도 침해 보고가 이어졌습니다.
이 사고의 배경으로는 자동화된 공격용 AI agent 무리가 지목됩니다. UC Berkeley의 CyberGym benchmark(AI 모델의 공격 과제 수행 능력을 재는 평가)에서 각 모델이 기록한 성공률은 다음과 같습니다.
| 모델 | 개발사 | 성공률 |
|---|---|---|
| XeKFung-1.5 (Qwen) | Alibaba Security | 88.9% |
| Gemini 3.8 Flash Cyber | 86.3% | |
| GPT-5.5-Cyber | OpenAI | 85.6% |
| GLM-5.3 | Zhipu AI | 84.5% |
| DeepSeek-V4-Pro | DeepSeek | 83.3% |
| Claude Mythos Preview | Anthropic | 83.1% |
| GPT-5.5 | OpenAI | 81.8% |
| Grok 4.6 | xAI | 79.7% |
눈에 띄는 점은 open-weight 모델(가중치가 공개돼 누구나 내려받아 돌릴 수 있는 모델)인 XeKFung-1.5와 GLM-5.3이 최상위 frontier 모델과 비슷하거나 더 높은 성공률을 보인다는 것입니다. 똑똑한 공개 모델이 흔해질수록 대규모 자동 공격의 진입 장벽이 크게 낮아진다는 해석이 가능합니다. 그래서 새 기능을 내놓기 전에 취약점 수정과 키 교체부터 챙기는 '보안 우선' 자세로 바꿔야 한다는 주장이 나오고, Cloudflare의 security-audit-skill 저장소는 이런 흐름 속에서 GitHub star가 급격히 늘어 4만 8,500개에 이르렀습니다.
설치는 명령 한 줄, 실행은 슬래시 명령 하나
security-audit skill은 여러 단계로 진행되는 보안 감사 agent 도구로, 기계가 읽을 수 있는 형식의 발견 사항과 독립 검증 절차를 제공합니다. 설치는 Skills CLI로 합니다.
- 터미널에서
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit를 실행합니다. - 전역 설치와 프로젝트별 설치 중 고를 수 있고, symlink로 연결해 두면 이후 갱신이 편합니다.
- 어느 도구에 붙일지 묻는 단계에서 Claude Code를 고릅니다. 이 CLI는 Claude Code를 포함해 79개의 코딩 agent와 도구를 지원합니다.
- 설치 도중 Vercel Labs가 공개한 find-skills 유틸리티도 함께 설치할지 묻는데, 같이 설치해도 됩니다.
설치가 끝나면 Claude Code 세션(점검에 쓰인 버전은 v2.1.310, 모델은 Claude Opus 5.5)에서 "security audit this codebase"처럼 자연어로 말하거나 /security-audit 슬래시 명령을 입력해 감사를 시작합니다.
찾는 agent와 검증하는 agent를 분리합니다
감사가 시작되면 Claude Code는 백그라운드에서 역할이 다른 세 개의 '사냥꾼(hunter)' agent를 띄웁니다.
| agent | 맡는 영역 |
|---|---|
| Hunter h1 | 인증 없이 접근 가능한 공격 표면 |
| Hunter h2 | 사람이 아닌 기계 호출자(API, 서비스 간 호출) |
| Hunter h3 | tenant 격리(고객 간 데이터 분리) |
이들은 endpoint 설정 파일, idempotency(같은 요청을 여러 번 보내도 결과가 한 번만 반영되게 하는 처리) 로직, 라우팅을 살피고 Markdown 형식의 취약점 장부를 만듭니다. 첫 정찰에서 나온 후보는 26건이었습니다.
여기서 이 skill의 핵심 설계가 드러납니다. Cloudflare의 감사 harness는 문제를 발견한 agent가 그 문제를 평가하지 못하도록 강제합니다. 별도의 checker sub-agent가 임시 테스트 데이터베이스를 띄워 각 후보에 대해 실제 exploit(공격 재현)을 시도하고, 재현되지 않으면 오탐으로 걸러냅니다. 하나의 agent가 발견과 보고를 모두 맡으면 결과가 부풀려지거나 환각이 섞이기 쉽기 때문에, 서로 다른 agent가 적대적으로 교차 검증해야 한다는 것입니다.
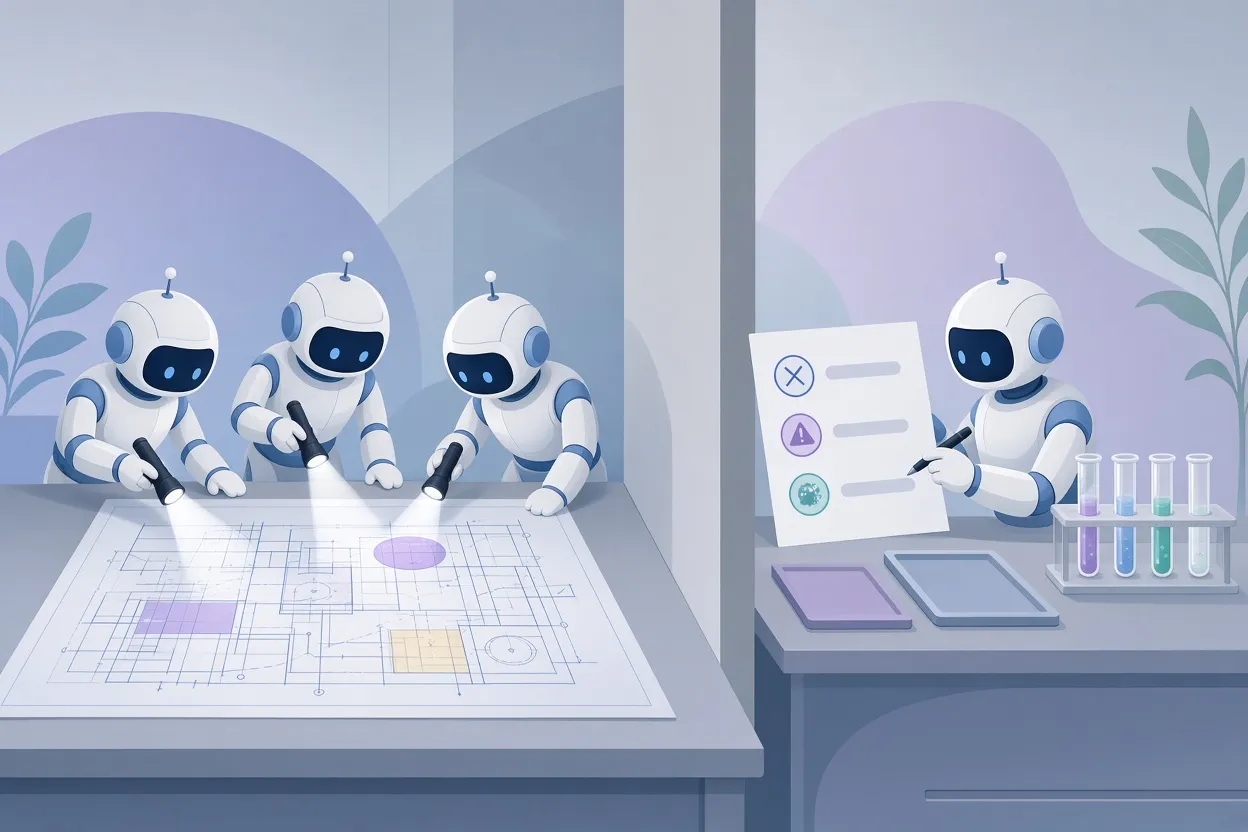
▲ 탐색 agent와 검증 agent의 분리
그 결과 26건 가운데 21건이 진짜 취약점으로 확인됐고, 3건은 문제가 아닌 것으로 기각됐으며, 2건은 관리자가 직접 봐야 하는 항목으로 남았습니다.
실서비스에서 실제로 확인된 취약점
| 유형 | 내용 |
|---|---|
| DB master key 노출 | 갓 가입해 로그인한 사용자가 app_settings에 저장된 service-role master key를 읽을 수 있음 |
| 무료 크레딧 장부 조작 | 인증 없이 누구나 free_credits_ledger를 보고 고칠 수 있었고, 여기에 고객 이메일 790건이 들어 있었음 |
| 작업 가로채기 | 다른 고객의 QuickBooks·Xero 회계 데이터 import 작업을 가져가 들여다볼 수 있는 tenant 격리 결함 |
| 결제 허점 | 환불이나 chargeback이 발생해도 충전해 준 크레딧이 회수되지 않음 |
6개월 동안 실제 사용자를 받으며 운영해 온 서비스에서 이런 결함이 한꺼번에 나왔다는 점은, 기능 개발에 시간을 쏟느라 보안을 뒤로 미루는 흔한 습관의 결과로 보입니다. 감사에서 데이터베이스 환경 변수나 master key에 대한 비인가 읽기가 발견되면, 코드 수정과 별개로 노출된 키와 API 자격 증명을 즉시 교체해야 합니다.
보고서를 티켓 18건으로 바꾸고 agent가 고칩니다
발견 사항은 REPORT.md 파일로 남습니다. 이 파일을 그대로 읽고 하나씩 고치는 대신, 터미널에서 Wayfinder skill(한 개발자가 공개한 skill)을 실행해 보고서를 파싱하고 각 취약점을 GitHub 프로젝트 Kanban board의 카드로 바꿨습니다. 실행 가능한 항목 18건이 'Ready' 열에 'Worst'부터 'High'까지 심각도 순으로 쌓였습니다.
그다음은 자체 구축한 multi-agent 개발 파이프라인 차례입니다. /super-board run과 함께 작업 저장소 URL을 넘기면 Builder agent가 수정을 구현하고, QA agent가 검증하며, Code Reviewer agent가 리뷰하는 식으로 역할이 나뉜 agent들이 여러 thread에서 협업해 패치와 단위 테스트를 만듭니다. 이 사례에서는 Claude API 사용 한도가 거의 소진된 상태여서 실제 실행은 OpenAI Codex headless와 GPT 모델이 맡았습니다. 감사는 Claude Code로, 수정은 Codex로 돌린 셈인데, 파이프라인이 특정 모델에 묶여 있지 않은 것으로 보입니다.
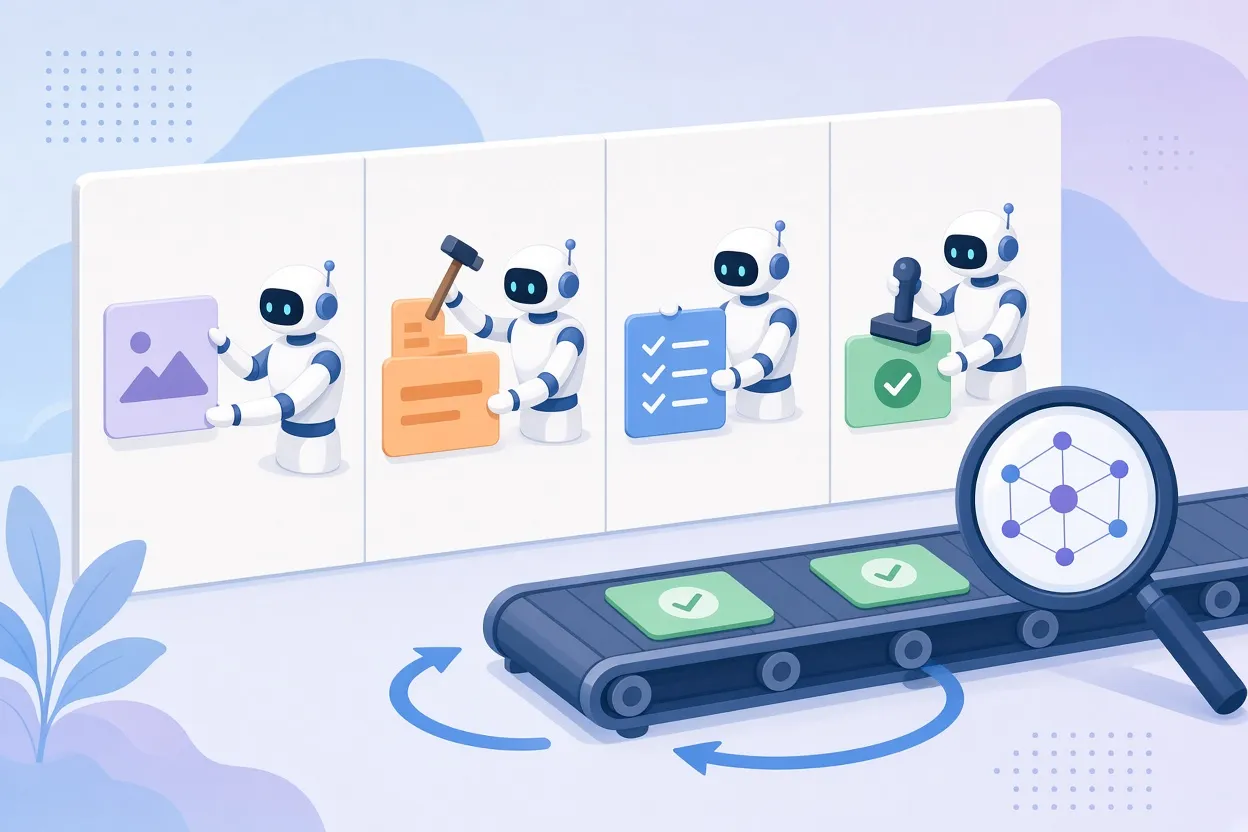
▲ 감사에서 재감사까지의 순환
agent들은 주요 티켓 16건과 관련 하위 티켓 2건을 모두 닫고 PR #1174로 병합했습니다. 서비스는 release 3.55.2로 production에 배포됐고, board의 'Ready', 'Building', 'QA', 'Review' 열에는 남은 작업이 없었습니다.
재감사로 '정말 고쳐졌는지' 확인합니다
패치가 문제를 실제로 해결했는지, 새 회귀 결함을 만들지는 않았는지는 다시 감사해 봐야 압니다. /security-audit Run a full security audit of this entire repo로 두 번째 감사를 돌리자 무결성 검사 19건이 실행됐고, 14건은 즉시 통과했으며 백그라운드 검증 3건도 성공적으로 끝났습니다. 치명 등급 취약점은 모두 해결됐고, 남은 것은 보기 전용 권한의 UI 검사와 관련된 낮은 등급의 경미한 결함 2건뿐이었습니다.
이 과정을 하나의 순환으로 정리하면 다음과 같습니다.
- 감사:
/security-audit로 전체 저장소를 점검하고 REPORT.md를 얻습니다. - 티켓화: 보고서를 파싱해 심각도 순의 티켓으로 바꿉니다.
- agent 실행: Builder, QA, Reviewer 역할의 agent가 수정과 테스트를 맡습니다.
- 병합·배포: PR로 합치고 release를 냅니다.
- 재감사: 같은 감사를 다시 돌려 해결 여부와 회귀를 확인합니다.
취약점 발견부터 티켓 생성, agent 패치, 재감사까지 자동화하면 수 주 걸리던 보안 수정 시간이 수 분 단위로 줄어든다는 것이 이 흐름이 내세우는 효과입니다. 다만 이는 한 서비스에서 얻은 결과이며, 감사 결과에 '관리자 직접 검토' 항목이 남듯 사람의 판단이 빠지는 구조는 아닙니다.
Claude Code Security Review와는 쓰는 자리가 다릅니다
Anthropic도 claude-code-security-review라는 보안 리뷰 도구를 내놓았기 때문에, 둘 중 무엇을 써야 하는지 헷갈릴 수 있습니다. 둘은 경쟁 관계라기보다 다른 층을 맡습니다.
| 구분 | Cloudflare security-audit skill | Anthropic claude-code-security-review |
|---|---|---|
| 점검 범위 | 저장소 전체의 구조와 데이터 접근 경로 | PR의 변경분(diff)과 그 주변 코드 |
| 검증 방식 | 격리된 sandbox에서 exploit 재현을 시도 | 입력 검증 누락, rate limit 부재 등 변경 코드의 문제를 지적 |
| 비용 | 계산 시간이 길고 token 소비가 큼 | 변경분만 보므로 가볍고 빠름 |
| 권장 주기 | 월 1회 또는 2주 sprint 종료 시 | 모든 PR마다 CI에서 자동 실행 |
Cloudflare 쪽은 전체 저장소를 깊이 훑고 실제 공격까지 시도하므로 비용이 커서, 모든 PR마다 돌리는 것은 현실적이지 않습니다. 반면 Anthropic 쪽은 diff 단위로 동작하도록 만들어져 GitHub Actions 같은 CI 흐름에 넣어 커밋마다 돌리기에 맞습니다. 그래서 둘을 함께 쓰는 것이 권장됩니다. PR 리뷰로 실시간 변경분을 감시하고, 전체 감사로 주기적인 건강 검진을 하는 구성입니다.
정리: 지금 바로 해 볼 일
Black October가 보여 준 것은 공격이 AI agent로 자동화되고 있다는 사실이고, Cloudflare의 skill이 보여 준 것은 방어 역시 agent로 자동화할 수 있다는 가능성입니다. 운영 중인 서비스가 있다면 다음 순서로 시작해 볼 수 있습니다.
npx skills add로 security-audit skill을 설치하고 Claude Code에서/security-audit를 한 번 돌려 현재 상태를 파악합니다.- 보고서에서 master key나 환경 변수 노출이 나오면 코드 수정 전에 키부터 교체합니다.
- 발견 사항을 티켓으로 쪼개 심각도 순으로 처리하고, 수정 후에는 반드시 같은 감사를 다시 돌려 확인합니다.
- 전체 감사는 월 1회나 sprint 끝에 일정으로 잡고, 매 PR에는 claude-code-security-review를 CI에 붙입니다.
발견한 agent와 검증한 agent를 분리하는 원칙은 자체 파이프라인을 만들 때도 그대로 가져갈 만합니다. 한 agent의 보고를 그대로 믿지 않고 다른 agent가 재현해 보게 하는 것, 그것이 이 사례에서 26건 가운데 오탐 3건을 걸러내고 21건의 진짜 문제에 집중하게 해 준 장치였습니다.


