Cloudflareが無料で公開するオープンソースのスキルを使うと、Claude Codeはリポジトリ全体を対象にしたセキュリティ監査ツールになります。本番稼働中の会計アプリケーションで試したところ、その実力が具体的に見えてきました。監査の対象は、6カ月にわたって活発に開発が続き、すでに有料ユーザーを抱えるSaaSのコードベースです。監査では26件の脆弱性候補が見つかり、独立した検証エージェントがそのうち21件を実際の脆弱性と確認しました。その中には、新規登録してサインインしただけのユーザーがデータベースのマスターサービスキーを読み取れるという重大な欠陥も含まれていました。検出結果は18件のチケットに変換され、マルチエージェントによる自動修正パイプライン、本番リリース、再監査へと流れ、再監査で残ったのは低深刻度の2件だけでした。
いま注目すべき理由
このテストが行われた時期、技術コミュニティは「ブラック・オクトーバー」と呼ぶ事態に直面していました。2026年10月下旬の48時間以内に、主要なソフトウェアスタックを襲った重大なセキュリティインシデントが27件を超えたのです。影響を受けた技術は、Webの土台を支えるものばかりです。
| 技術 | 報告された深刻度(CVSS) | 備考 |
|---|---|---|
| PHP | 9.2 | Webの80%を動かすソフトウェアに影響するランタイムの欠陥 |
| GitLab | 10.0 | 最高スコア、リモートから悪用可能な脆弱性 |
| Signal | 9.3 | セキュリティインシデント |
| Node.js 22、24、26 | 重大(Critical) | リモートからサーバーを乗っ取れる欠陥 |
| Java、WordPress | 記載なし | 侵害の報告 |
CVSS(共通脆弱性評価システム)は、欠陥の深刻度を最大10のスケールで評価する指標です。10.0は最悪の評価にあたります。
この急増の背景には、オープンウェイトと独自開発の両方のフロンティアモデルで動く、自動化された攻撃型AIエージェントの群れがあるとされています。AIモデルがサイバータスクをどれだけこなせるかを測るUC BerkeleyのCyberGymベンチマークを見ると、こうしたモデルの能力の高さがわかります。
| モデル | CyberGym成功率 |
|---|---|
| XeKFung-1.5(Qwen)、Alibaba Security | 88.9% |
| Gemini 3.8 Flash Cyber、Google | 86.3% |
| GPT-5.5-Cyber、OpenAI | 85.6% |
| GLM-5.3、Zhipu AI | 84.5% |
| DeepSeek-V4-Pro | 83.3% |
| Claude Mythos Preview、Anthropic | 83.1% |
| GPT-5.5、OpenAI | 81.8% |
| Grok 4.6、xAI | 79.7% |
注目すべきは、XeKFung-1.5やGLM-5.3といったオープンウェイトモデルが、トップクラスの独自モデルと同等かそれ以上のハッキング成功率に達している点です。これにより、大規模な自動攻撃のハードルは大きく下がったと見られます。実務上の結論はセキュリティ優先の姿勢、つまり新機能を出す前に脆弱性を修正し、露出したキーをローテーションすることです。GitHubで48.5kスターに達したCloudflareのsecurity-audit-skillリポジトリは、開発者が手に取るツールの一つになっています。
Cloudflareのスキルの仕組み
このスキルは、エージェントスキル用のパッケージマネージャーであるSkills CLIを通じて、グローバルまたはプロジェクト単位でインストールします。
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit
インストーラーはスコープ(プロジェクトかグローバルか)を尋ね、更新を簡単に保つためのシンボリックリンク方式を提案し、対応する79種類のコーディングエージェントのうちどれにスキルを追加するかを選ばせます。Claude Codeもその一つです。インストール中にCLIは、Vercel Labsが公開するfind-skillsユーティリティの追加も提案します。
Opus 5.5モデルで動くClaude Code v2.1.310のセッションでは、「security audit this codebase」という自然言語の依頼か、スラッシュコマンド/security-auditのどちらかで監査が始まります。
起動すると、Claude Codeはそれぞれ担当領域の異なる3つの「ハンター」エージェントをバックグラウンドで立ち上げます。
- ハンターh1:認可されていない攻撃面
- ハンターh2:マシンによる呼び出し、つまりスクリプトや連携機能など人間以外のクライアント
- ハンターh3:テナント分離、つまりある顧客のデータを別の顧客から隔てる壁
ハンターはエンドポイントの設定ファイルを読み、冪等性の処理(同じリクエストが繰り返されても効果が重複しないようにするロジック)を調べ、ルーティングを確認して、Markdown形式の脆弱性台帳を書き出します。
最も特徴的な設計上の判断は職務の分離です。Cloudflareのハーネスでは、検出結果を評価するエージェントが、それを発見したエージェントであってはならないと定めています。独立したチェッカーのサブエージェントが一時的なテスト用データベースを立ち上げ、候補ごとに実際の攻撃の実証を試みます。再現できた場合だけが検出結果として数えられます。その理由は、1つのエージェントに脆弱性の発見と報告の両方を任せると誤解を招く結果になりがちだからで、敵対的なクロスチェックが誤検出やハルシネーションを取り除きます。
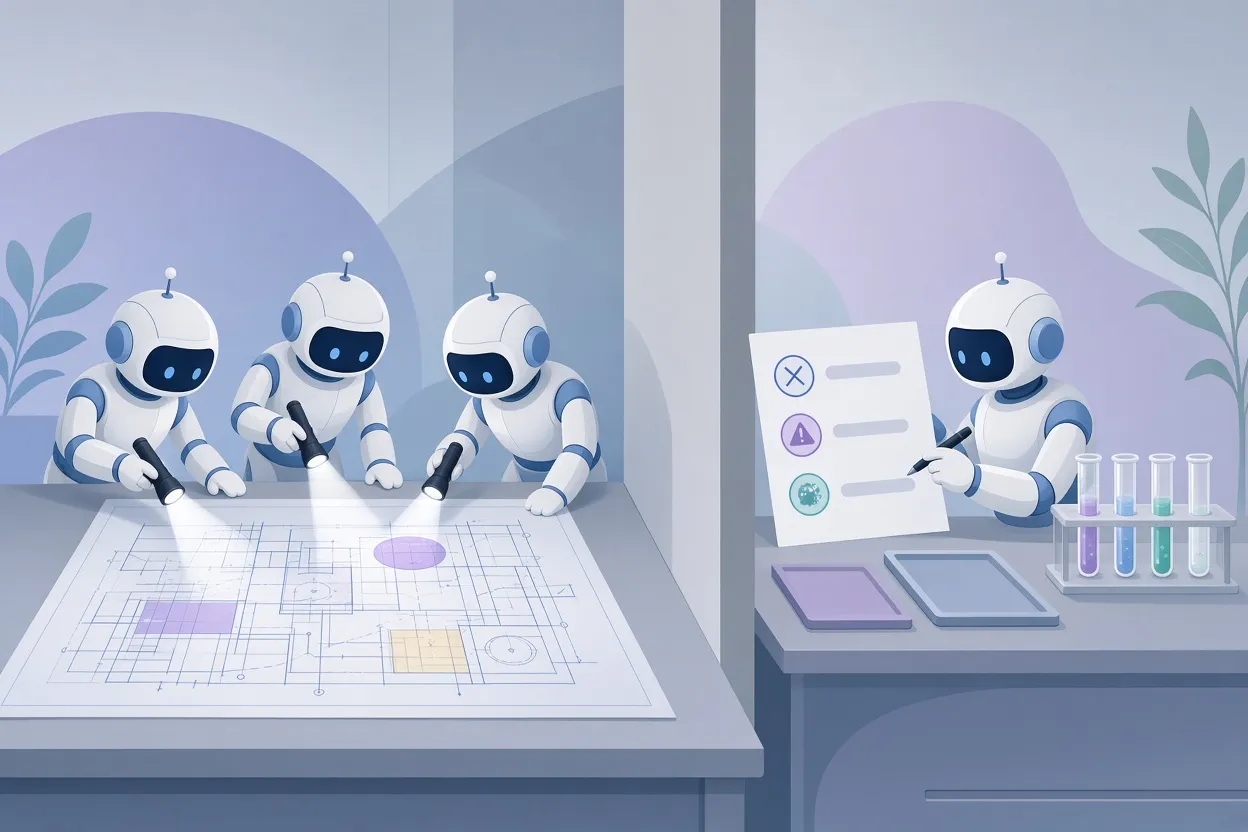
▲ ハンターエージェントと独立したチェッカーエージェント
稼働6カ月の本番アプリで見つかったもの
テスト対象は、QuickBooksとXeroからデータを取り込む会計・領収書管理SaaSで、6カ月かけて構築され、実際の有料ユーザーを抱えています。偵察パスで26件の候補が挙がり、検証後の内訳は次のとおりです。
| 結果 | 件数 |
|---|---|
| 実際の脆弱性と確認 | 21 |
| 問題なしとして却下 | 3 |
| 管理者による手動確認が必要 | 2 |
レポートの表で「Worst」から「High」までに分類された確認済みの検出結果には、いくつかの深刻な穴が含まれていました。
- マスターキーの露出:新規登録してサインインしたユーザーが、アプリケーションの設定テーブルに保存されたservice-roleのデータベースマスターキーを読み取れました。
- 無料クレジットの悪用:認証していない訪問者が、790件の顧客メールアドレスを含むプロモーション用無料クレジットの台帳を閲覧・改変できました。
- ジョブの乗っ取り:テナント分離の欠陥により、あるユーザーが別の顧客のQuickBooksやXeroのインポートジョブを自分のものとして取得し、中身を調べることができました。
- 課金の悪用:ユーザーの残高に追加されたチャージ分のクレジットが、返金やチャージバックの後も取り消されていませんでした。
これらはまさに、チームがユーザー向け機能に時間を費やしている間に積み重なっていく種類の欠陥です。ここから直接導かれる運用ルールが一つあります。監査でデータベースの環境変数やマスターキーが権限のない相手から読み取れたと判明したら、コード修正がどれだけ早く入るかにかかわらず、その認証情報を直ちにローテーションすることです。
レポートからチケット、修正のマージまで
監査レポートは、修正がリリースされて初めて役に立ちます。このスキルは結果をREPORT.mdファイルに書き出し、独立した開発者が作ったWayfinderというサードパーティ製の別のスキルがそのファイルを解析して、対応が必要な脆弱性を一つずつプロジェクトのGitHub Kanbanボードの追跡カードに変換します。今回は、構造化された18件のチケットが重要度順に「Ready」列に並びました。
その後、自社製の自動パイプラインがボードを引き継ぎました。当時Claude APIのレート制限が残り少なかったため、実行にはヘッドレスモードのOpenAI CodexとGPTモデルを主に使い、並列作業を進めました。専門化した役割がスレッドをまたいで協調します。
- ビルダーエージェントが各修正を実装
- QA検証エージェントがユニットテストを生成して実行
- コードレビュアーエージェントがマージ前に変更を確認
エージェントは主要チケット16件と関連サブチケット2件をすべて完了し、プルリクエスト#1174で全変更をマージして、リリース3.55.2を本番環境にデプロイしました。「Ready」「Building」「QA」「Review」の各列は空になりました。
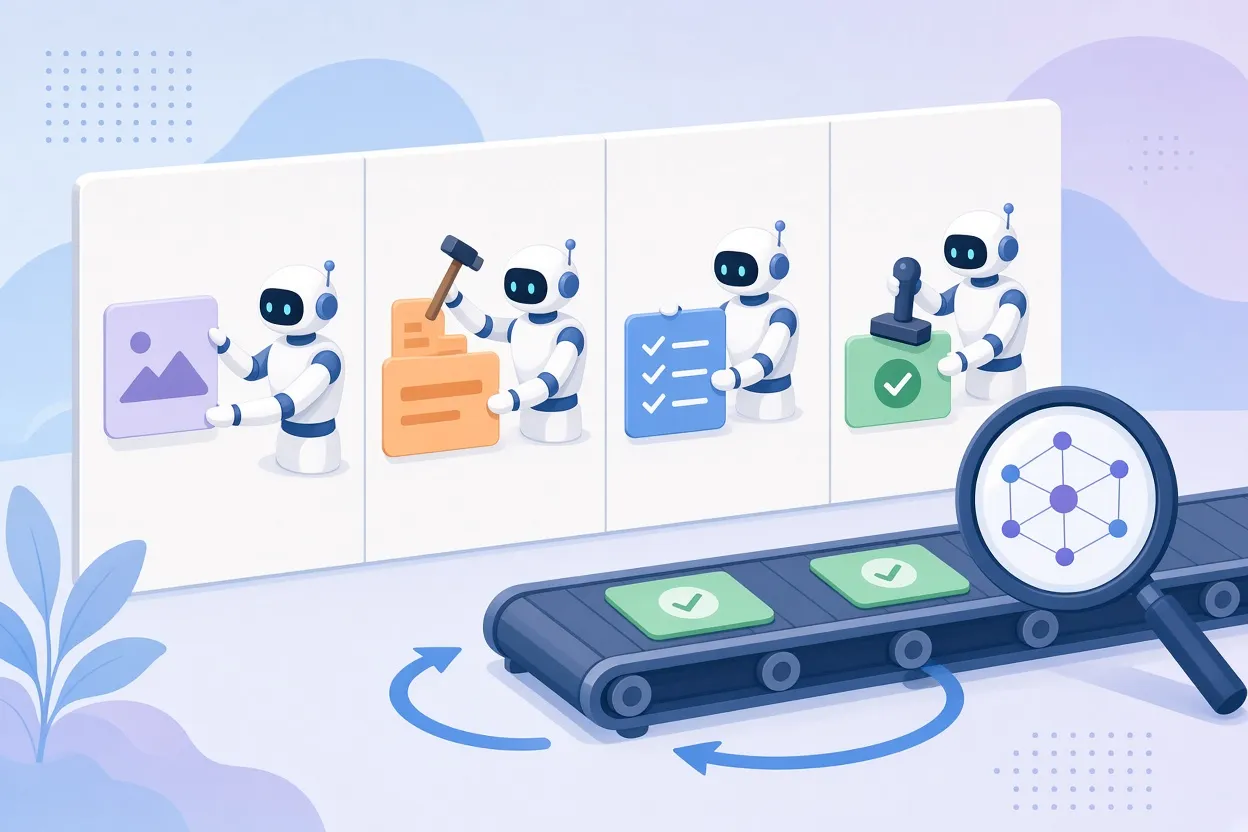
▲ 監査からチケット、修正、再監査へ戻るループ
最後のステップでループが閉じます。リポジトリ全体を監査するよう指示して/security-auditを再実行すると、19件の整合性チェックが行われ、14件が即座に合格し、3件のバックグラウンド検証テストもその後正常に完了しました。重大な深刻度の脆弱性はすべて解消されました。残ったのは低評価の軽微なバグ2件だけで、いずれもユーザーインターフェースの閲覧専用権限チェックに関するものです。
結果として生まれるライフサイクルは簡単に説明できます。監査、チケット発行、AIエージェントによる実行、マージとデプロイ、再監査、という流れです。これにより修正にかかる時間が数週間から数分に短縮されるという主張ですが、この数字は1つのアプリケーションでの1回の実行から得られたものなので、保証ではなく一例として受け止めてください。
Cloudflareの監査とAnthropicのclaude-code-security-reviewの違い
Anthropicもclaude-code-security-reviewという独自のツールを公開していますが、両者は代替関係にはありません。動作する層が異なります。
| Cloudflare security-audit-skill | Anthropic claude-code-security-review | |
|---|---|---|
| 対象範囲 | リポジトリ全体 | 1つのプルリクエストのコード差分とその周辺行 |
| 手法 | データアクセス経路のアーキテクチャ的なマッピング、隔離されたサンドボックスでの攻撃実証の試行 | 入力サニタイズの欠落やレート制限の不在などの問題について変更コードを検査 |
| コスト特性 | 長い計算時間、大量のトークン消費 | 軽量で、コミットごとのチェックに適する |
| 推奨頻度 | 月1回、または2週間スプリントの終了ごと | プルリクエストごとに、GitHub Actionsなどの継続的インテグレーション経由で |
リポジトリ全体の詳細な監査をプルリクエストのたびに走らせるのは、トークン消費量、APIコスト、実行時間を考えると現実的ではありません。一方で差分レビューだけでは、前述のテナント分離やキー露出のようなアーキテクチャ上の欠陥は、特定の変更行の中に存在しないため見過ごされてしまいます。推奨される構成は両方を使うことです。Anthropicのレビューを各プルリクエストの継続的なゲートとし、Cloudflareの監査を定期的で包括的なヘルスチェックとして運用します。
要点と次のステップ
無料のスキルと主流のコーディングエージェントだけで、本番アプリの21件の実際の脆弱性を発見・検証できました。その中にはデータベースのマスターキーの露出も含まれます。発見と検証を別々のエージェントが担い、使い捨てのデータベースで実際に攻撃を試みるという検証設計こそが、使えるレポートと当て推量のリストを分ける要素です。
Webアプリケーションを運用しているなら、妥当な計画は次のようになります。
npx skills addでCloudflareのスキルをインストールし、Claude Codeでリポジトリ全体に対して/security-auditを実行する- 監査で権限のないユーザーから読み取れると判明したキーや認証情報があれば、何よりも先にローテーションする
- Wayfinderを使うか手作業で、レポートをチケットに変換し、深刻度順に修正する
- デプロイ後に再監査して、修正が有効でリグレッションが入り込んでいないことを確認する
- Anthropicのclaude-code-security-reviewをプルリクエストのワークフローに追加し、Cloudflareの監査は月1回またはスプリントごとのスケジュールに組み込む
自動化された攻撃エージェントがこれほど高性能になった以上、機能開発とセキュリティ対策のバランスは変わりつつあるように見えます。こうしたツールは、そのバランスのセキュリティ側を担うコストを大幅に下げてくれます。


