이번 주 AI 업계에서 가장 실용적인 변화는 성능 경쟁보다 가격과 속도, 그리고 사용 방식에서 나왔습니다. Anthropic은 대량 작업용 소형 모델 Claude Haiku 5.5를 내놓았고, OpenAI는 28일 동안 매일 무언가를 내놓겠다는 연속 출시를 시작해 GPT-6와 Intelligent UI를 모든 사용자에게 풀었습니다. xAI의 Grok Bot은 작업에 따라 다른 회사 모델까지 골라 쓰는 방식으로 바뀌었습니다. 발표가 많은 만큼 무엇을 실제로 써 볼지, 어떤 조건을 확인해야 할지 중심으로 정리합니다.
Claude Haiku 5.5, 최고 성능보다 싼 대량 작업에 맞춘 모델
Claude Haiku 5.5는 Anthropic이 지금까지 내놓은 소형 모델 가운데 가장 빠르고 비용 효율이 높은 모델로 소개됐습니다. 겨냥하는 일은 최고 수준의 추론이 아니라 요약, 데이터 압축, 데이터베이스 조회, 분류처럼 같은 종류의 요청이 많이 반복되는 작업입니다. Anthropic은 소프트웨어 개발에서 Haiku 5.5를 Sonnet 5.5나 Opus 5.5 아래에서 일하는 sub-agent(큰 모델이 맡긴 하위 작업을 처리하는 보조 agent)로 쓰라고 권합니다.
성능 시험인 benchmark 결과를 보면 상위 모델을 넘어서지는 못합니다. 대신 이전 세대인 Haiku 4.5와 비교하면 차이가 큽니다.
| benchmark | Haiku 5.5 | Sonnet 5.5 | Haiku 4.5 |
|---|---|---|---|
| GDPval-AA v2.1(지식 업무) | 1620 | 1840 | 735 |
| AA-Briefcase v1.1(지식 업무) | 1578 | 1824 | 614 |
| OSWorld 2.1(컴퓨터 조작) | 72.4% | 83.9% | 15.7% |
같은 GDPval-AA v2.1에서 OpenAI의 GPT-6 Luna는 1437점이었습니다. Haiku 5.5는 그 밖에 Humanity’s Last Exam에서 도구 없이 45.9%, 도구를 쓰면 57.4%를 기록했고, agent 코딩 benchmark인 Terminal-Bench 4.0에서 39.2%, FrontierCode 1.1에서 46.4%를 받았습니다.
눈여겨볼 대목은 비용 대비 정확도입니다. Claude는 effort(모델이 답하기 전에 얼마나 오래 생각할지 정하는 설정)를 Low부터 Max까지 고를 수 있습니다. OSWorld 2.1에서 Haiku 5.5를 가장 높은 단계 바로 아래인 extra-high effort로 돌리면 정확도 67.6%에 시도당 $0.28이 들었습니다. Sonnet 5.5를 medium effort로 돌리면 정확도 66.0%에 시도당 $0.93이었습니다. 이 과제에서는 작은 모델을 오래 생각하게 하는 쪽이 큰 모델을 적당히 쓰는 쪽보다 3분의 1이 안 되는 비용으로 비슷한 결과를 냈습니다.
| 100만 token당 가격 | Haiku 5.5(10만 token 이하) | Haiku 5.5(10만 token 초과) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 입력 | $0.10 | $0.50 | $1.00 | $2.00 |
| 출력 | $0.50 | $2.50 | $5.00 | $10.00 |
token은 AI가 글을 나눠 처리하는 단위이고, 가격은 이 단위로 매깁니다. 캐시 읽기는 100만 token당 $0.01(10만 token 초과 시 $0.05), 캐시 쓰기는 $0.125(초과 시 $0.625)입니다. 독립 평가 사이트 Artificial Analysis의 순위에서 Haiku 5.5는 지능 지수로는 Kimi k3, GLM 5.3, Grok 4.7보다 아래에 있지만, 과제 하나를 처리하는 비용은 평균 $0.21 안팎으로 가장 낮은 편에 속했습니다. 과제마다 내는 추론·출력 token의 양은 많아 Sonnet 5.5 다음일 정도인데, token 단가가 워낙 낮아 전체 비용이 낮게 유지되는 구조입니다.
어디에 쓰면 이득인가
월 $20 이상의 유료 Claude 요금제로 웹 채팅을 쓰는 사람이라면 여전히 Sonnet이나 Opus를 고를 가능성이 큽니다. Haiku 5.5의 이점은 token 단가 차이가 그대로 쌓이는 곳에서 드러납니다. API로 돌리는 자동화, Claude Code, agent 도구 안에서 반복 작업을 맡기는 경우입니다. 큰 모델이 계획과 판단을 맡고, 코드 조회나 형식 정리 같은 빠른 하위 작업을 Haiku 5.5에 넘기는 구성이 제조사가 권하는 쓰임새입니다.
▲ 큰 모델과 소형 sub-agent의 분업
Claude에 들어온 Dashboards와 Motion
Anthropic은 업무 데이터를 시각 자료로 바꾸는 기능 두 개도 발표했습니다. Claude Dashboards는 Google BigQuery, Databricks, Snowflake, Salesforce 같은 데이터 웨어하우스와 CRM에 바로 연결해 실시간 대시보드를 만듭니다. 유료 요금제에서 beta로 쓸 수 있습니다. 함께 Claude Docs, Slides, Design은 beta를 마치고 Free를 포함한 모든 요금제에서 쓸 수 있게 됐습니다.
Claude Motion은 prompt와 아이디어를 움직이는 설명 영상과 모션 그래픽으로 바꿉니다. 공유 자전거 대여소의 출발 흐름을 38초짜리 애니메이션으로 만든 예가 공개됐습니다. 다만 지금은 Team과 Enterprise 요금제에서만 쓸 수 있고, 개인용 Pro(월 $17~20)와 Max(월 $100~200) 구독자는 쓸 수 없습니다. 새 기능을 먼저 쓰려고 Max에 월 $200을 내는 사용자보다 월 $20짜리 Team 좌석이 먼저 쓰는 셈이라 개인 사용자에게는 아쉬운 결정으로 보입니다. 이런 애니메이션은 지금까지도 JavaScript나 Remotion 같은 도구로 직접 만들 수 있었지만, Claude 안에서 바로 그려 낸다는 점에서 제작 과정이 훨씬 짧아질 수 있습니다.
OpenAI의 28일 연속 출시, 첫 주에 나온 것들
OpenAI는 10월 4일부터 28일 동안 매일 제품 개선이나 초기화(reset)를 하나씩 내놓겠다고 밝혔습니다. 첫 주에만 사용자가 체감할 변화가 여럿 나왔습니다.
GPT-6와 Intelligent UI
10월 7일 OpenAI는 GPT-6와 Intelligent UI를 모든 사용자에게 공개했습니다. ChatGPT에 GPT-6가 들어가면서 화면 디자인도 바뀌었습니다. Intelligent UI는 긴 글로 된 답 대신 그림, 누를 수 있는 버튼, 입력 양식, 대화형 차트를 답 안에 섞어 보여 줍니다.
- 7단 변속 자전거 조립 안내를 글 대신 부품을 펼쳐 보이는 분해도로 보여 주고 프레임, 바퀴, 브레이크만 골라 볼 수 있게 합니다.
- 일요일 양고기 구이 모임을 계획하면 손님 수에 맞춘 고기 무게 계산기, 재료 카드, 조리 일정표를 만듭니다.
- 이탈리아 결혼식 여행을 물으면 날짜별 옷차림, 이미지 카드, 짐 싸기 체크리스트를 냅니다.
- 식당 계산서를 다섯 명이 나누는 계산기 같은 작은 도구를 대화 안에서 바로 만듭니다.
생각하는 정도를 Instant로 두고 내연기관 원리를 물으면 흡입, 압축, 폭발, 배기 단계를 그림으로 거의 곧바로 보여 줍니다. OpenAI 내부의 agent 평가 그래프에서는 GPT-6가 더 높은 정확도를 내면서 응답 시간을 215초에서 109초로 줄인 것으로 나타났습니다.
속도, 승인, 회의 기록
- 10월 5일: GPT-6 Astra와 GPT-6.1 Sol의 기본 생성 속도가 구독 제품과 파트너 API 전반에서 약 50% 빨라졌습니다.
- 10월 6일: ChatGPT Work와 Codex에 Auto-review가 로그인한 모든 계정에 무료로 들어왔습니다. 권한 설정은 Ask for approval(승인 요청), Approve for me(대신 승인), Full access(전체 접근) 가운데 고릅니다. Approve for me를 고르면 별도의 검토 agent가 작업하는 agent의 행동을 지켜보고, 위험이 크거나 의도에서 벗어나는 행동일 때만 사용자에게 묻습니다. 긴 작업 중 매번 승인 단추를 눌러야 하는 피로를 줄이려는 기능입니다.
- Meetings plugin: macOS용 ChatGPT 데스크톱 앱에서 Pro와 Business 사용자에게 beta로 열렸습니다. Zoom, Google Meet, Slack 통화에서 시스템 소리와 마이크를 함께 받아 적고, 요약과 다음 할 일을 정리하며, 내용을 ChatGPT의 기억에 남겨 후속 메일이나 계획 수정에 씁니다.
- 개발자 API: 판단만 빠르게 내리는 Decisions API가 public beta로 나왔고, 다섯 단계였던 사용량 한도 등급이 Build, Launch, Grow 세 단계로 줄었습니다. 누적 API 사용액이 $500에 이르면 Grow 등급이 되어 상위 모델은 분당 4,000만 token, Luna는 분당 1억 8,000만 token까지 쓸 수 있습니다.
Ultrafast와 Instant Steering
10월 8일에는 GPT-6.1 Sol의 Ultrafast 모드가 Codex, ChatGPT Work, 개발자 API에 나왔습니다. 표준보다 최대 8배 빠르게 생성하지만 값도 크게 오릅니다.
| GPT-6.1 Sol 속도 | 표준 대비 속도 | 입력(100만 token) | 출력(100만 token) |
|---|---|---|---|
| Standard | 1배 | $2 | $10 |
| Fast | 2배 | $4 | $20 |
| Ultrafast | 최대 8배 | $12 | $60 |
Ultrafast는 표준의 6배 가격이고, ChatGPT에서 쓰려면 월 $500짜리 Pro 요금제가 필요합니다. 지연 시간이 곧 사용성인 실시간 서비스, 대화형 코딩, 컴퓨터 화면을 직접 조작하는 agent가 아니라면 비용을 정당화하기 어려워 보입니다.
ChatGPT Work의 Instant Steering은 생성이 진행되는 도중에 방향을 바꾸게 해 줍니다. 강아지 그림을 그리던 중 늑대로 바꾸는 요청을 넣고 Steer 단추를 누르면 기존 작업이 끝나기를 기다리지 않고 바로 새 방향으로 전환합니다. 결과물이 엇나가는 게 보이는 순간 고칠 수 있어 기다리는 시간과 연산 낭비를 줄입니다.
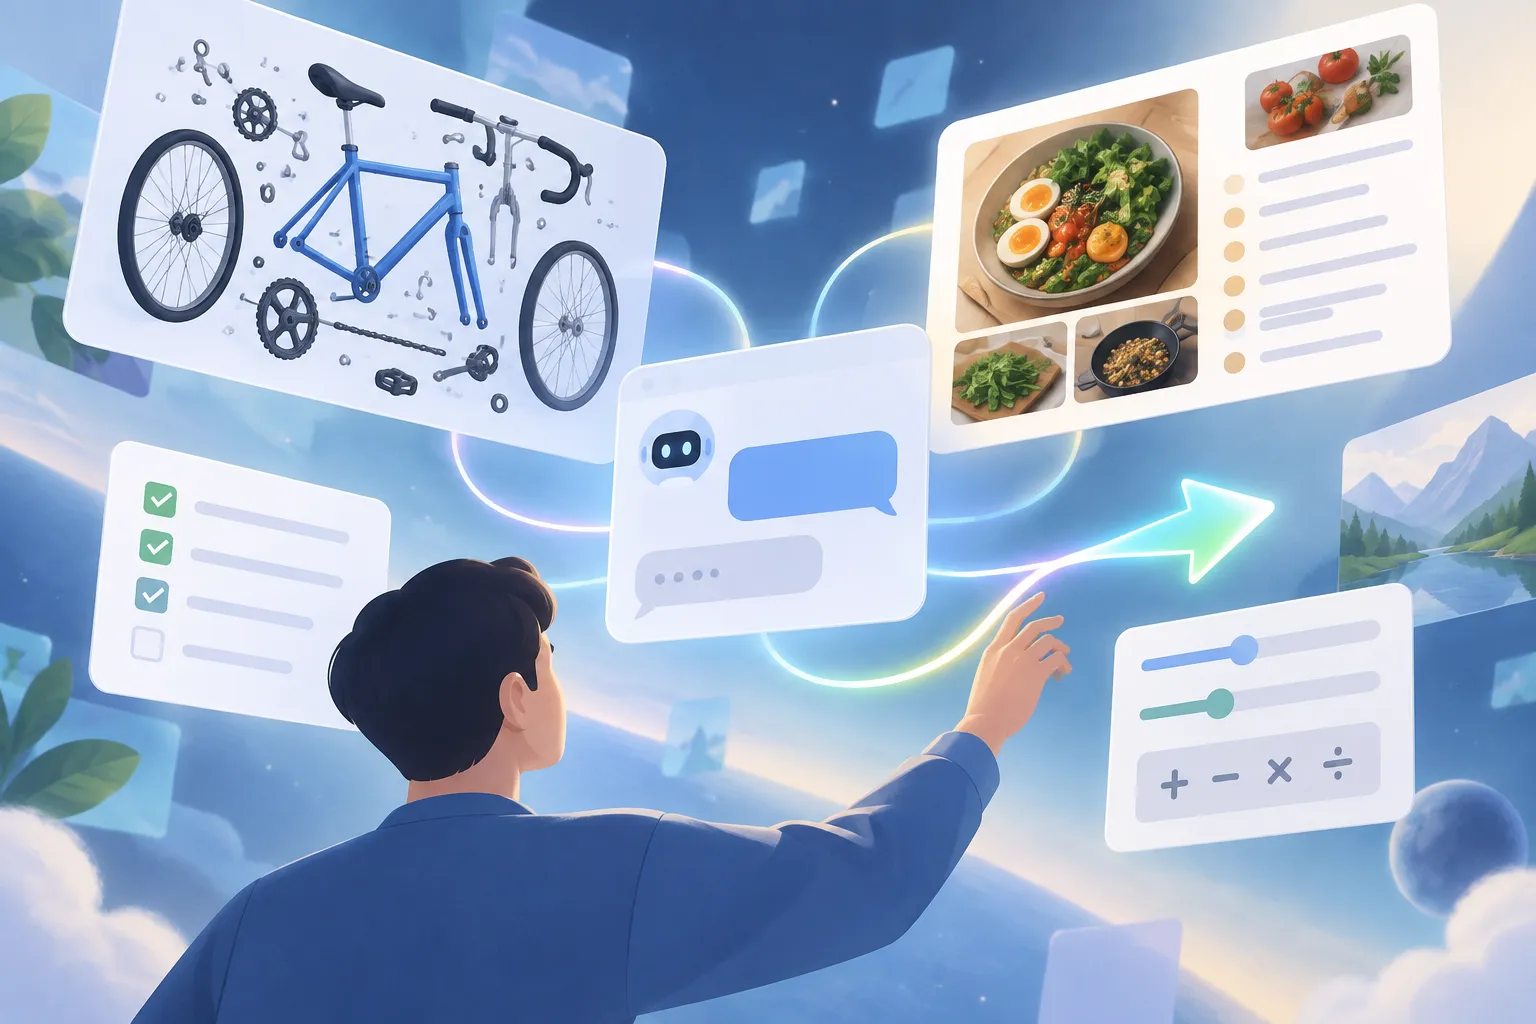
▲ 글 대신 화면으로 답하는 ChatGPT
Grok Bot, 다른 회사 모델까지 골라 쓰는 비서
xAI의 Grok Bot은 방향을 바꿨습니다. Elon Musk는 앞으로 Grok Bot이 작업마다 가장 알맞은 모델로 요청을 보내고, 여기에 Claude Opus 5.5, Midjourney, Suno 같은 다른 회사 모델도 포함된다고 밝혔습니다. 자사 모델만 쓰는 대신 외부 모델이 더 나은 결과를 낼 때는 그쪽을 부르는 구조입니다. 지금 benchmark 선두권을 Anthropic 모델이 차지하고 있다는 점에서 Claude Opus 5.5를 불러 쓸 수 있다는 것은 실질적인 장점으로 보입니다.
Grok Bot은 X의 게시물을 직접 검색하고 읽고 지켜볼 수도 있게 됐습니다. 특정 분야에서 뜨는 주제와 반응이 커지는 게시물을 찾고, 반응 데이터를 바탕으로 게시 일정을 제안합니다. 구조도 대화창 하나로 일하는 Dot이나 Muse와 다릅니다. Gmail에 연결해 답장 초안을 쓰는 Email Triage, 업계 소식과 논문을 계속 살피는 Research Bot 같은 전문 agent를 두고, Chief of Staff agent가 큰 지시를 받아 알맞은 agent에게 나눠 줍니다. 한 계정의 최근 게시물 75개를 분석해 반응이 가장 좋은 시간대와 다음 게시물 주제 초안을 뽑는 예도 공개됐습니다. 여러 단계의 관리 업무를 한 대화창에 몰아넣지 않고 역할별 agent에 나눠 맡기는 방식이 더 유연할 수 있습니다.
그 밖에 나온 소식
- Mistral Large 4: 가중치를 내려받아 쓸 수 있게 공개하는 open-weight 모델이며, 여러 전문가 망 가운데 일부만 골라 쓰는 mixture-of-experts 구조입니다. 전체 1조 parameter(모델이 학습한 값) 가운데 token마다 520억 개만 씁니다. 중국 연구소의 상위 open-weight 모델과 비슷한 수준이라고 Mistral AI는 밝혔습니다.
- Reflection Beam: 전체 5,010억, 활성 230억 parameter의 open-weight 모델로 25조 8,000억 token으로 사전 학습했다고 합니다. 아직 내려받을 수는 없습니다. 두 모델 모두 개인 컴퓨터가 아니라 자체 서버를 갖춘 기업용입니다.
- Google Playground: 만들고 싶은 게임을 글로 설명하면 2D·3D 게임을 만들어 주는 실험용 웹 서비스입니다. 미국의 만 18세 이상 사용자만 쓸 수 있습니다.
- Google AI Edge Foresight: macOS에서 기기 안 모델로 회의를 받아 적고 요약하는 앱으로, 소리와 기록이 컴퓨터 밖으로 나가지 않습니다.
- Gemini Agent: Google Cloud의 기업용 agent로, 몇 시간에서 며칠 걸리는 작업을 맥락을 잃지 않고 이어 가며 Google Workspace, Microsoft 365, Slack, Salesforce, Jira, GitHub와 연결됩니다.
- SynthID Detector: 이미지, 영상, 음성 파일에 숨은 디지털 워터마크를 찾는 공개 도구입니다. 워터마크가 들어간 생성물만 가려낼 수 있고 모든 AI 생성물을 찾아내지는 못합니다.
- Hark Pro: Figure 창업자 Brett Adcock이 내놓은 컴퓨터 조작 agent로, 생필품 재주문, 경비 영수증 제출, 구독 해지 같은 일을 화면을 직접 조작해 처리합니다.
- Meta Muse: Meta가 Raspberry Pi나 ESP32 보드에 Muse를 올리는 하드웨어 설계와 코드를 공개했습니다.
- Anthropic 이용 정책: 연구 목적 없이 Claude에게 지속적이고 극단적인 학대를 하는 행위를 금지했습니다. 일반적인 불만 표현이나 일부러 약점을 찾는 red teaming, 모델 시험은 대상이 아니라고 밝혔습니다.
- 노동 대체 전망: 노벨상 수상 경제학자 Daron Acemoglu는 앞으로 10년 동안 AI가 대체할 사람의 일은 약 5%에 그칠 것이라고 봤고, Microsoft AI의 Mustafa Suleyman이 이 글을 공유했습니다. 거의 모든 일이 곧 자동화될 것이라는 업계의 흔한 예상과는 거리가 있는 전망입니다.
정리, 이번 주에 해 볼 만한 일
이번 주 발표의 공통점은 같은 일을 더 싸게, 더 빠르게, 덜 귀찮게 하는 쪽으로 움직였다는 점입니다. 컴퓨터를 대신 조작하는 agent도 여러 회사에서 쏟아지고 있어 기능 차이는 점점 줄고, 결국 어느 회사 환경에 익숙한지가 선택을 가를 수 있습니다.
- API나 Claude Code로 반복 작업을 돌리고 있다면 분류, 요약, 조회 같은 하위 작업을 Claude Haiku 5.5로 옮겨 비용 차이를 확인해 볼 만합니다.
- ChatGPT에서는 계산, 일정, 원리 설명처럼 표나 그림이 나은 질문을 Instant로 물어 Intelligent UI가 내놓는 결과를 확인해 봅니다.
- ChatGPT Work나 Codex로 긴 작업을 맡긴다면 Auto-review의 Approve for me를 켜되, 위험한 행동은 여전히 확인을 거친다는 점을 알고 씁니다.
- Ultrafast는 지연 시간이 문제인 서비스에만 고려하고, 6배 가격과 월 $500 요금제 조건을 먼저 따져 봅니다.
- 회의 기록 도구를 고를 때는 클라우드로 넘어가는 Meetings plugin과 기기 안에서 처리하는 Google AI Edge Foresight 가운데 데이터가 어디에 남는지를 기준으로 고릅니다.