フロンティアモデルの上に製品を築いている多くのチームは、必要以上のコストを払いながら、モデルが本来出せる品質を引き出せていません。しかも、その原因はたいていモデルではありません。Anthropicの技術スタッフの一人によると、この差は小さく修正可能な設定上の選択から生まれます。旧世代モデル向けに書かれた指示を詰め込んだプロンプト、キャッシュを静かに壊すプロンプト構造、そして良い変更とたまたま当たった変更を区別できない評価セットです。プロンプトとキャッシュの整理は、性能を犠牲にせずにコストが下がるため「タダで得られる勝ち」と位置づけられています。Anthropic自身のベンチマークでは、キャッシュの修正だけで、スコアを落とさずに最大72.9%のコスト削減が得られています。
ほとんどのアプリケーションが到達していないフロンティア
大規模言語モデルを扱う際の古典的なメンタルモデルはトレードオフ曲線です。品質を上げればコストが上がり、安くすれば必ず質が下がる、というものです。評価チャート上では、モデルの各ティアがこの曲線上の異なる点に位置し、Opusクラスのモデルが高コスト・高品質の端に、SonnetとHaikuがその下に並びます。
ここでの主張は、実際のアプリケーションの多くはそもそもこの曲線上に乗っていないというものです。プロンプトやハーネスの問題のために曲線のずっと内側にあり、フロンティア価格を払いながら中位ティア相当の結果しか得ていません。アプリケーションをフロンティアまで押し戻すということは、同じ品質のままタスクあたりのコストを下げることを意味します。だからこそ、モデルのダウングレードを検討する前に、これらの修正に取り組む価値があるのです。
プロンプト負債:旧モデルを助けた習慣が今は足を引っ張る
プロンプトは、コードベースと同じように、モデル世代をまたいで技術的負債を溜め込みます。初期モデルの弱点を補うための指示がそのまま引き継がれ、フロンティアモデルの上では中立ではなくなり、コストや精度を削り始めます。
アンチパターンは3つのグループに分かれます。
| 分類 | 例 | フロンティアモデルへの影響 |
|---|---|---|
| コストを押し上げるもの | 検証の儀式(「作業を二重チェックせよ」「回答前に2回確認せよ」)、徹底性ブースター(「最大限に徹底せよ」)、手順やスクラッチパッドの足場、作業例の詰め込み、怠慢防止のツールブースター、死重のルール | 推論を改善せずに入力・出力トークンを膨らませる |
| 精度を壊すもの | 長いシステムプロンプトに散らばった矛盾するルール | 新しいモデルはあらゆる指示を両立させようとして混乱する。旧モデルは片側を単に無視していた |
| 完全に壊れるもの | 旧モデルの挙動に結びついた古い設定 | 意図どおりに動かなくなる |
その理由は、フロンティアモデルはすでに、いつ考えるべきかを自分で判断し、中間結果を自分で検証し、構造化されていないエッジケースを自力で処理するからです。明示的な段階的推論や必須のスクラッチパッドを強制すると、トークンが増えるうえ、出力を積極的に劣化させることさえあります。ただし一つ注意があります。こうした回避策が効かなくなる境界は厳密ではなく、実際に試して確かめる価値があるとされています。Claude Haikuのような小型モデルは、明示的な足場からまだ恩恵を受ける可能性があります。
Anthropicは、この負債を自動で見つける2つのClaude Codeコマンドを提供しています。/checkup prompt-audit はClaude Codeのプロジェクトメモリー、スキル、設定プロンプトを点検し、/claude-api prompt-audit はAnthropic APIを直接呼び出すアプリケーションのコードベースを走査します。どちらもモデル固有のヒューリスティクスを適用して死重を検出し、整理します。
Opus 4.8からOpus 5.5への移行を模した、カスタマーサポートチケット50件の合成ベンチマークが、その効果を示しています。旧来のプロンプトをそのままに新モデルへ移行しただけでは、改善はささやかでした。移行に加えてプロンプト監査を実行すると、精度が大きく跳ね上がり、コストもさらに下がりました。旧来のプロンプトのOpus 4.8から監査済みプロンプトのOpus 5.5までの道のり全体で、精度は約89.5%から約91.8%に上がり、チケットあたりのコストはほぼ半減しました。冗長な検証ループやブースターがトークン使用量を膨らませなくなったためです。
プロンプトキャッシュ:完全一致のプレフィックスかゼロか
2つ目のレバーはプロンプトキャッシュで、マルチターンのエージェントワークフローで最も効いてきます。各ターンはツール呼び出しのような少量の新しい内容を追加しつつ、大きな共有コンテキストを再送します。キャッシュ読み取りは基本入力トークンのおよそ10分の1の価格で課金され、キャッシュヒットは応答レイテンシーも大幅に削ります。正確な価格はモデルごとに異なるため、最新の価格表を確認する価値があります。
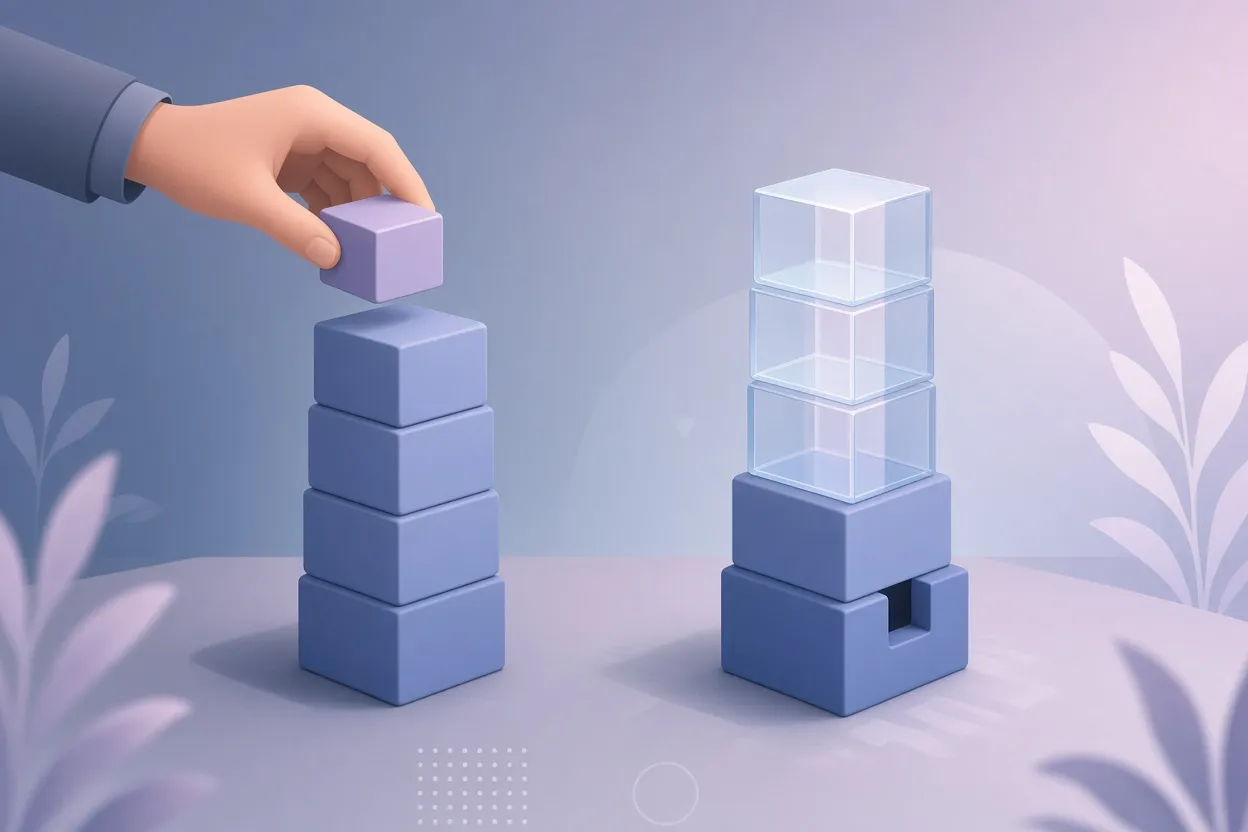
▲ プレフィックスキャッシュと早い位置の変更による破損
落とし穴は、キャッシュがプロンプトの先頭からの厳密なプレフィックス一致を使う点です。プロンプトの早い位置、たとえば4バイト目であっても1バイト変わるだけで、それ以降にキャッシュされたすべてが無効になります。大きな静的ブロックの前に動的な内容を置くと、その静的ブロックは一度も再利用されません。
推奨されるプレフィックスの順序は、最も静的なものから最も動的なものへ、次のとおりです。
- システム指示(グローバルにキャッシュ)
- ツールスキーマ(グローバルにキャッシュ)
- CLAUDE.mdまたはプロジェクトメモリー(プロジェクト単位でキャッシュ)
- セッション状態(セッション単位でキャッシュ)
- メッセージ(ターンごとに追加)
Claude Consoleには、問題を可視化するキャッシュ診断があります。キャッシュ読み取り比率、キャッシュ済みトークン総数、キャッシュミストークン、そしてミスが起きた理由の内訳(メッセージの変更、システムプロンプトの変更、ツールの変更、モデルの変更など)です。あるダッシュボードの例では、キャッシュ読み取り比率71.3%、キャッシュ読み取りトークン124億、キャッシュミストークン2万8,400が報告されていました。
Claude Codeのコマンド /claude-api cost-optimize は、APIの利用パターンを分析し、キャッシュの切れ目を検出し、プロンプトを再構成し、さらに推論エフォートのような設定に無駄な支出がないかも確認します。AnthropicのApplied AIチームが社内ベンチマークで実行した結果は次のとおりです。
| ベンチマーク | コスト変化 | スコア変化 |
|---|---|---|
| tau2-bench(小売) | -72.9% | +2.0ポイント |
| OfficeQA Pro | -71.7% | +0.1ポイント |
| LegalBench | -66.9% | -0.8ポイント |
| SWE-bench Verified | -14.3% | +1.1ポイント |
実際に登れる評価
プロンプト監査とキャッシュは一度きりの整理です。継続的な改善は、モデルが登っていけるシグナルを与える評価にかかっており、それは実験計画の基本に従うことを意味します。健全な評価は4つの性質を示すはずです。
- スコアがHaiku、Sonnet、Opusとモデルのティアに応じて単調に上がる
- 試行ごとに与える思考エフォートやアクショントークンを増やすほどスコアが上がる
- 満点までに余地があり、フロンティアモデルが何を上乗せするかを示せる
- 実行ごとのばらつきが小さく、スコア差がノイズではなく能力を反映する
曖昧なタスク定義と解けないエッジケースは、余地を圧縮しノイズを加える極めてよくある欠陥とされています。人気のある公開ベンチマークの多くにも、出来の悪い設問が含まれていると報告されています。飽和した、あるいは較正の狂った評価に対してヒルクライムを行うと、どのモデルも到達できない天井を目指してトークンを浪費します。テストセットのおよそ20%が矛盾していたり解けなかったりすれば、自動オプティマイザーはそれらのケースに予算を使い果たしてしまいます。
Claude Codeのコマンド /claude-api build-eval は、ガイド付きウィザードとして動作します。データの置き場所については意図的に中立で、あらゆるトレーシングプラットフォーム、テレメトリーデータベース、生のログファイルを読めます。開発者がどの問題を解決したいかを尋ね、サンプルトレースを点検し、評価ペアを段階的に構築し、グレーダーを整え、採点基準の曖昧さを検証し、テストセットの多様性を確認します。それでも人間によるレビューの工程は重要です。Claudeはトレースを走査して失敗のクラスターを浮かび上がらせるのが得意ですが、エンジニアは注釈付きの生データを自分で点検してから、ケースを正式なベンチマークに昇格させるべきです。何が本当に重要かについての人間の感覚が、良い評価設計の土台と位置づけられています。
タスクが主観的でプログラムによるチェックが不可能な場合には、いくつかの指針が当てはまります。
- 0から5や1から10のような連続的な評定尺度は、ノイズと採点の不一致を持ち込むため避けます。二値の合否基準か、独立した二値チェックのチェックリストを優先します。この指針はやや規範的すぎるとも認められており、ばらつきを厳密に制御できれば、よく較正された多段階尺度も機能し得ます。
- 生成されたWebページのような成果物には、絶対評価よりペアワイズ比較を優先します。生成UIでは、ClaudeがバリアントAとバリアントBを多数の試行で比較し、その結果をEloレーティングに集約します。
- ジャッジを検証します。同じルーブリックをSonnet、Opus、Haikuで走らせ、広く食い違えばルーブリックが壊れている兆候です。同一入力で反復実行してばらつきが小さいことを確かめます。ルーブリックが二値で明確になれば、より小さく安価なモデルをジャッジに使えます。
- 1つのモデルの失敗からではなく、実際の本番トラフィックと第一原理からサンプリングします。モデルの能力はでこぼこで、あるモデルが失敗するタスクが別のモデルには簡単なこともあるため、単一モデルファミリーの失敗モードだけから作った評価は転用できないかもしれません。
自分をだまさないヒルクライム
評価が健全になれば、フロンティアのClaudeモデルは、人間を介さずに失敗を読み取って変更を提案し、プロンプトやスキルのコードを自律的に反復改善できます。リスクは過学習です。たまたま画像タスクを含むベンチマークは、本番では一切不要なOCRツールをハーネスに追加させるかもしれません。ベンチマークのファイルが /app ディレクトリにあれば、「cd /app してpytestを実行」がハードコードされるかもしれません。特徴的な言い回しがプロンプトに焼き付いたり、オプティマイザーが失敗を一つずつ場当たり的に修正したり、公開リポジトリから参照解答を引っ張ってきたりすることもあります。社内ではスコアが見事に見えて、本番で崩れるのです。
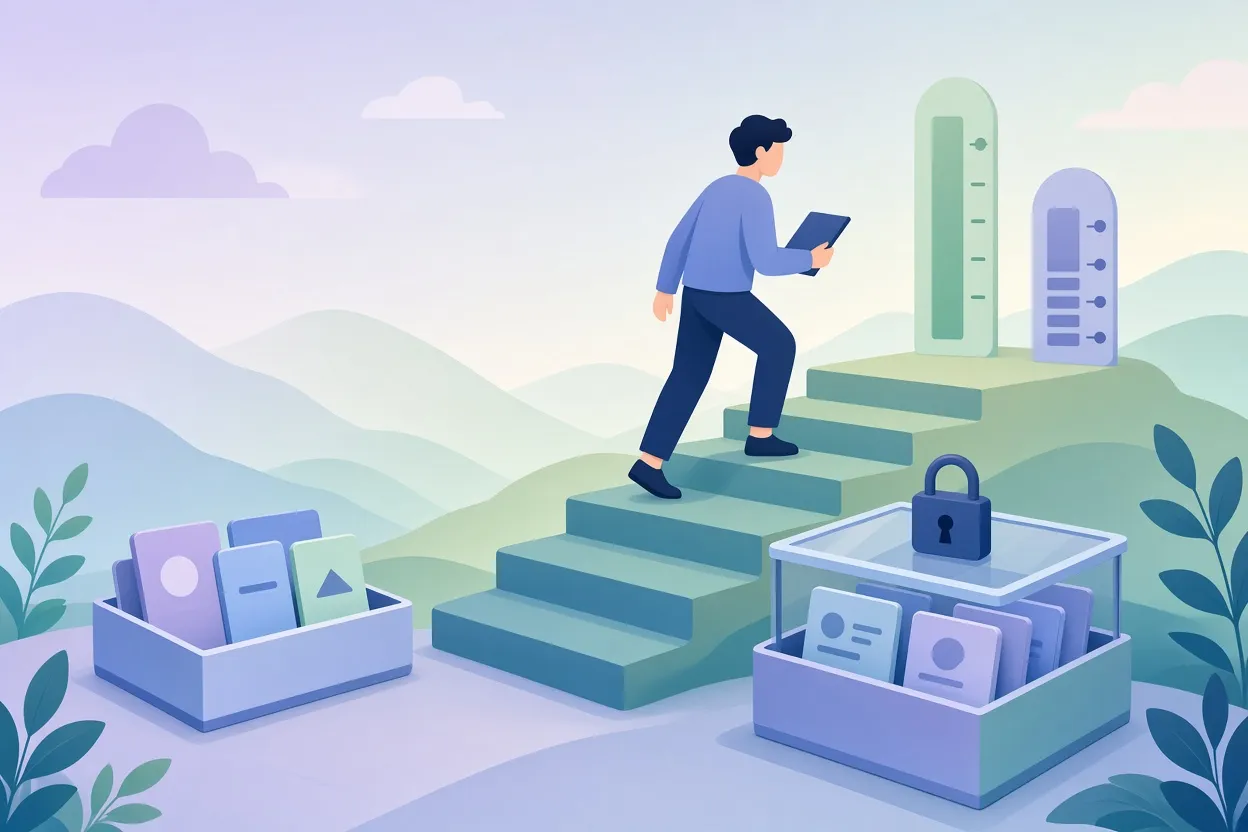
▲ 訓練分割でのヒルクライムと保持されたテストセット
/claude-api hillclimb コマンドは、そのループに防御策を組み込んでいます。評価を訓練セットとテストセットに分割します。アナライザーは訓練側の失敗だけを読み、仮説を立て、ラウンドごとに1つの差分を提案します。両方の分割を毎ラウンド採点します。訓練とテストの両方が改善すれば編集を採用し、両方が横ばいか、どちらかが悪化すれば差し戻します。訓練スコアが上がるのにテストスコアが横ばいなら、過学習の早期シグナルです。このコマンドは最初に支出予算も尋ね、数ラウンド進捗が停滞すると、残った失敗をクラスタリングして、問題がモデルの能力ではなく曖昧なプロンプトやグレーダーのバグにあるのではないかを確認します。このプロセスはヒューリスティクスであり収束が保証されるわけではないため、開発者は差分を監査するよう促されています。
Anthropic自身のClaude APIスキルを、ドキュメント由来の設問で評価したケーススタディが、実行の形を示しています。
| ラウンド | 合格率 | 加えた変更 |
|---|---|---|
| ベースライン | 66.1% | 不完全なコンテキストと微妙な不正確さ |
| 6 | 74.3% | 欠けていたドキュメントの節と型定義を追加 |
| 9 | 77.5% | さらなる追加 |
| 11 | 77.2% | 効果のなかったプロンプト調整 |
| 12 | 80.1% | スキルが実行可能コードを書く方法の指示 |
| 17 | 84.0% | グレーダーロジックの修正と新しいスキルプロンプト |
| 22 | 87.9% | 最終 |
ヒルクライムは、精度を維持したままコストを狙うこともできます。カスタマーサポートのベンチマークでは、高い思考エフォートのOpus 4.6というベースラインが、チケットあたり高いコストで74.4%を記録しました。低エフォートのOpus 5に切り替えると、精度が上がりコストもやや下がりました。低エフォートのSonnet 5はコストを大幅に削減し、精度はベースラインと同等に戻りました。さらに低エフォートのSonnet 5でプロンプトを調整すると、推論コストの90%削減を確保したまま、精度はベースラインを上回りました。
直感に反する教訓は、低エフォートのフロンティアモデルのほうが、高エフォートの中位モデルより安くて速いことが多いという点です。中位モデルは、より強いベースモデルなら必要としない大量の思考トークンを消費するからです。エフォート設定はトークンの下限を課しません。Claudeは問題の難しさに応じて思考量を調整するため、高エフォートでも単純な問い合わせでは安く済み、難しいコーディングタスクでは劇的に増えます。実践的な順序は、まず強いモデルを低エフォートで試すことです。精度、コスト、レイテンシーを同時に扱う場合は、一度に1つの目的を調整することが、探索を扱いやすく保つ方法として提案されています。
最初に登る対象としては、プロンプトのテキストとスキルの説明文が推奨されています。これらはモデルの挙動と密接に結びつき、素早く反復できる一方、ハーネスのコードは大きく交絡した差分を生みます。裏を返せば、プロンプトは最も過学習しやすい対象でもあり、だからこそ訓練・テスト分割が必須とされています。過学習は、モデルが評価されていることに気づくことよりも、実務でははるかによくある問題だとされています。
数日にわたるエージェントのためのハーネス
最後のテーマは先を見据えたものです。タスクの時間幅は、2024年のClaude 3 Opusでのおよそ4分のチャットタスクから、2025年のClaude 3.5および3.7 Sonnetでの人間換算30分から2時間の作業、そして2026年のClaude Opus 4シリーズとOpus 5モデルでの数時間から数日にわたる非同期実行へと伸びています。24時間を超えると、ネットワーク切断やコンテナのクラッシュは日常的になり、同期的な設計では進捗が失われます。
Claude Managed Agentsで使われているAnthropicの答えは、「脳」(ハーネス)と「手」(サンドボックス実行)を切り離すことです。オーケストレーターがクラッシュしたハーネスやサンドボックスを再起動し、状態は独立した追記専用のセッションログに置かれるため、履歴を失わずに一晩のうちに実行を復旧できます。このログをモデルのコンテキストウィンドウの外に置くことで、コンテキストが圧縮されても詳細が永久に失われることはなく、Claudeはツール呼び出しを通じて過去のコンテキストを照会できます。認証情報はツールモジュール内のボールトに置かれ、モデルが生のシークレットを目にすることはありません。関連するAnthropic Developer Blogの記事「Building Effective Agent Automations」は、ターン数上限、支出上限、時間制限といったガードレールを備えたスケジュール実行エージェントのパターンを示しており、/claude-api managed-agents-onboard でClaude Code内にセットアップできます。
今やるべきこと
一貫した筋は、フロンティアモデルは前世代向けに作られた足場と測定によって「足かせをはめられている」ことが多い、というものです。実践的な手順は次のとおりです。
- 新しいモデルへ移行する際に /checkup prompt-audit と /claude-api prompt-audit を実行し、検証の儀式、スクラッチパッドの強制、徹底性ブースター、矛盾するルールを取り除く
- 静的な内容が先に来るようにプロンプトを並べ替え、Claude Consoleでキャッシュ読み取り比率を確認し、/claude-api cost-optimize を実行する
- 何かを最適化する前に、評価がモデルのティアを区別し、エフォートに応じてスケールし、余地があり、ばらつきが小さいことを確かめる。二値のルーブリックかペアワイズ比較を使い、ジャッジを複数のモデルティアで検証し、生のトレースを自分でレビューする
- まずプロンプトを、厳密な訓練・テスト分割、トークン予算、差分の人間レビューのもとでヒルクライムする。小型モデルの高エフォートより先に、フロンティアモデルの低エフォートを試す
- 長時間動くエージェントでは、セッションログとシークレットをハーネスとサンドボックスの外に置く
より大きな変化として語られているのは、Anthropicのエンジニアが今では時間の大半を、Claudeが一晩で最適化する評価とタスクの設計に費やしており、本番の失敗トレースがオフラインの評価セットに流れ込み、さらに回帰テストへと流れていくことです。得られる成果の大きさは各チームの出発点次第ですが、修正そのものを試すコストはわずかです。


