多数基于前沿模型开发的团队,花的钱比必要的多,得到的质量却比模型能提供的少,而原因通常不在模型本身。据Anthropic一位技术人员的说法,差距来自一些细小但可修复的配置选择:提示词里塞满了为旧模型编写的指令,提示词结构悄悄破坏了缓存,评测集分不清一次改动是真有效还是碰巧走运。清理提示词和缓存被称为“免费的胜利”,因为成本下降的同时并不牺牲性能。Anthropic自己的基准测试显示,仅缓存修复一项就能带来最高72.9%的成本降幅,且得分没有损失。
大多数应用从未触及的前沿
使用大语言模型的经典思维模型是一条权衡曲线:质量更好就要花更多钱,更便宜总意味着更差。在评测图表上,各模型层级分布在这条曲线的不同位置,Opus级模型位于高成本、高质量的一端,Sonnet和Haiku则靠下。
这里的论点是,大多数真实应用根本不在这条曲线上。它们位于曲线内侧,由于提示词和执行框架(harness)的问题,付着前沿模型的价格却只得到中档结果。把应用重新推回前沿,意味着在质量不变的情况下降低每个任务的成本,这也是为什么在考虑降级模型之前,值得先做这些修复。
提示词债务:曾帮助旧模型的习惯如今成了负担
提示词会像代码库一样,跨模型代际累积技术债务。那些为弥补早期模型弱点而写的指令被一路沿用,到了前沿模型上,它们不再是中性的,而是开始消耗成本或损害准确率。
反模式分为三类:
| 类别 | 示例 | 对前沿模型的影响 |
|---|---|---|
| 增加成本 | 验证仪式(“仔细检查你的工作”、“回答前验证两遍”)、彻底性强化语(“尽可能彻底”)、流程和草稿区脚手架、堆砌示例、防偷懒的工具强化语、无用规则 | 推高输入和输出token,却不能改善推理 |
| 破坏准确率 | 散布在冗长系统提示词各处的互相矛盾的规则 | 新模型会试图调和每一条指令,因而陷入混乱,而旧模型只是简单忽略其中一方 |
| 直接失效 | 绑定于旧模型行为的过时配置 | 不再按预期工作 |
其中的道理是,前沿模型已经能自行决定何时思考、自行验证中间结果、自行处理非结构化的边缘情况。强制要求逐步推理或必须使用草稿区,会增加token,甚至可能主动降低输出质量。有一点需要注意:这些变通手段在哪个边界上失去作用,被描述为并不精确,值得通过实验验证。Claude Haiku这类较小的模型可能仍然受益于明确的脚手架。
Anthropic提供了两个Claude Code命令来自动发现这类债务。/checkup prompt-audit命令检查Claude Code的项目记忆、技能和配置提示词,/claude-api prompt-audit则扫描直接调用Anthropic API的应用代码库。两者都应用针对特定模型的启发式规则来标记无用内容并加以清理。
一项包含50张客服工单的合成基准测试模拟了从Opus 4.8迁移到Opus 5.5的过程,展示了收益。保留旧提示词直接换到新模型,提升有限。在迁移基础上再运行提示词审计,则带来了准确率的大幅跃升和进一步的成本下降:从“Opus 4.8加旧提示词”到“Opus 5.5加审计后提示词”的完整路径上,准确率从约89.5%升至约91.8%,每张工单的成本大致减半,因为冗长的验证循环和强化语不再推高token用量。
提示词缓存:前缀完全一致,否则一切归零
第二个杠杆是提示词缓存,它在多轮智能体工作流中最为重要。每一轮都会追加少量新内容,比如一次工具调用,同时重新发送一大段共享上下文。缓存读取的计费约为基础输入token价格的十分之一,命中缓存还能大幅缩短响应延迟。具体定价因模型而异,值得查阅最新的价格表。
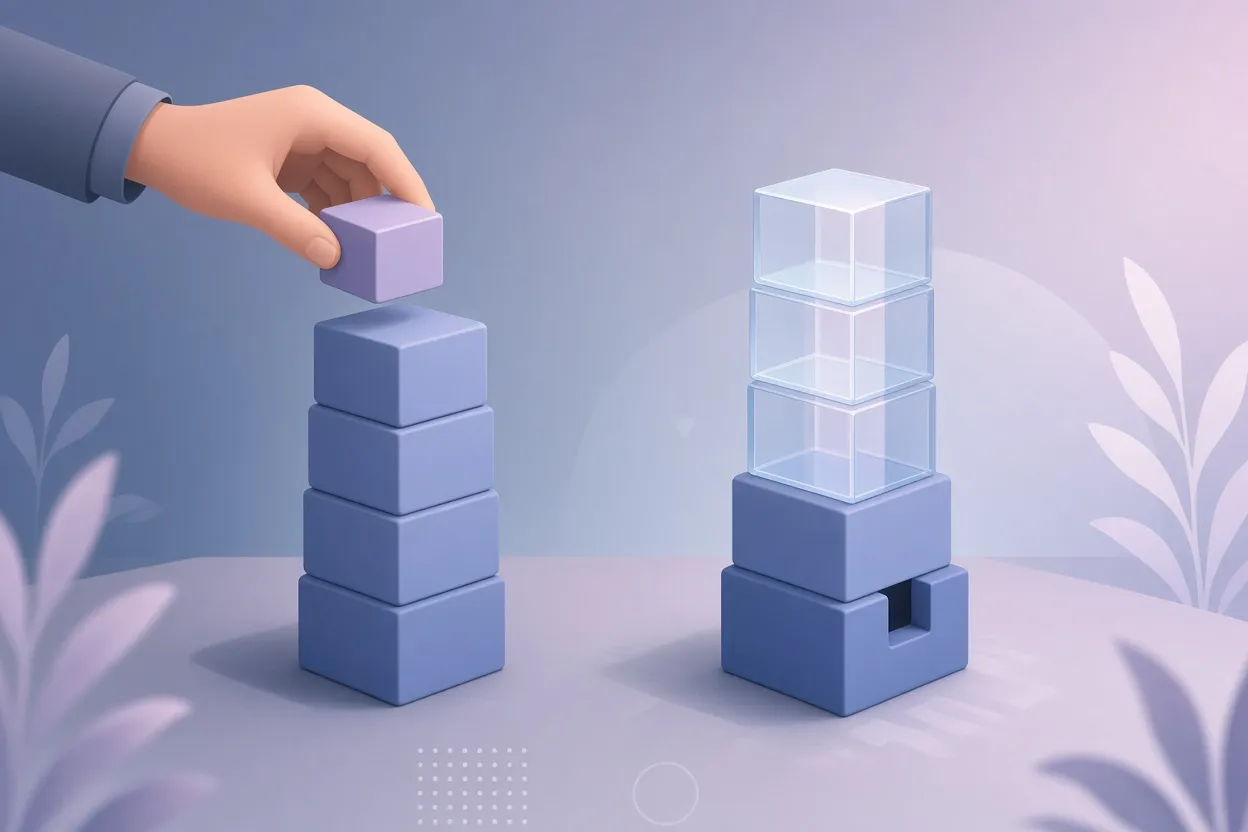
▲ 前缀缓存及早期改动如何破坏它
问题在于,缓存采用的是从提示词最开头起的严格前缀匹配。提示词前部哪怕只改动一个字节,即便是在第四个位置,也会让其后所有缓存失效。任何放在大段静态内容之前的动态内容,都意味着这段静态内容永远不会被复用。
推荐的前缀顺序,从最静态到最动态:
- 系统指令(全局缓存)
- 工具模式(全局缓存)
- CLAUDE.md或项目记忆(按项目缓存)
- 会话状态(按会话缓存)
- 消息(逐轮追加)
Claude Console提供了让问题可见的缓存诊断:缓存读取比例、缓存token总量、缓存未命中token数,以及未命中原因的拆分,比如消息变化、系统提示词变化、工具变化或模型变化。一个示例仪表盘显示,缓存读取比例为71.3%,缓存读取token为124亿,缓存未命中token为2.84万。
Claude Code命令/claude-api cost-optimize会分析API使用模式、检测缓存中断、重构提示词,还会检查推理强度等设置是否存在不必要的开销。Anthropic的Applied AI团队在内部基准上运行了它:
| 基准 | 成本变化 | 得分变化 |
|---|---|---|
| tau2-bench(零售) | -72.9% | +2.0分 |
| OfficeQA Pro | -71.7% | +0.1分 |
| LegalBench | -66.9% | -0.8分 |
| SWE-bench Verified | -14.3% | +1.1分 |
真正能爬坡的评测
提示词审计和缓存是一次性的清理。持续改进依赖于能给模型提供可攀爬信号的评测,这意味着要遵循实验设计的基本原则。一个健康的评测应当具备四个特性:
- 得分随模型层级单调上升,从Haiku到Sonnet再到Opus。
- 给模型更多思考强度或每次尝试更多的行动token时,得分上升。
- 满分之下留有提升空间,前沿模型才能展示出它多带来的东西。
- 多次运行之间方差很低,得分差异反映的是能力而非噪声。
任务定义含糊和无解的边缘案例被描述为极其常见的缺陷,它们压缩了提升空间并引入噪声。据称许多流行的公开基准都含有起草粗糙的题目。对着一个已饱和或校准失当的评测爬坡,等于烧掉token去追逐一个任何模型都达不到的上限;如果测试集中约20%的案例自相矛盾或无解,自动优化器会把预算耗尽在这些案例上。
Claude Code命令/claude-api build-eval充当引导式向导。它有意不预设数据存放在哪里,因此可以读取任何追踪平台、遥测数据库或原始日志文件。它会询问开发者想解决什么问题,检查样本轨迹,逐步构建评测对,净化评分器,测试评分标准是否含糊,并检查测试集的多样性。人工审核环节仍然重要:Claude擅长扫描轨迹并找出失败簇,但工程师应在把案例提升为正式基准之前,亲自检查标注后的原始数据。人对“什么才真正重要”的判断力被视为优秀评测设计的基础。
当任务主观、无法用程序化检查时,有几条指导原则适用:
- 避免使用0到5或1到10这类连续评分量表,它们会引入噪声和评分不一致。优先采用二元的通过/不通过标准,或由多个独立二元检查组成的清单。这条建议被承认有些过于武断;如果方差控制得足够严格,校准良好的多级量表也可行。
- 对生成网页这类产物,优先采用成对比较而非绝对打分。对于生成式用户界面,Claude会在多次试验中比较变体A和变体B,结果汇总为Elo评分。
- 验证评判者。用同一套评分细则分别在Sonnet、Opus和Haiku上运行,普遍分歧说明细则有问题。对相同输入做重复运行,确认方差较低。一旦细则做到二元且清晰,就可以用更小、更便宜的模型担任评判者。
- 从真实生产流量和第一性原理中采样,而不是从某一个模型的失败中采样。模型能力是参差不齐的:一个模型做不了的任务对另一个模型可能轻而易举,因此只基于单一模型家族失败模式构建的评测可能无法迁移。
爬坡而不自欺
评测可靠之后,前沿Claude模型就能自主迭代提示词和技能代码,读取失败案例并提出修改,无需人工介入。风险在于过拟合。一个恰好包含图像任务的基准,可能促使执行框架加入生产环境根本不需要的OCR工具;基准文件放在/app目录下,可能导致硬编码的“cd /app并运行pytest”;独特的措辞可能被固化进提示词;优化器还可能逐个修补失败案例,或从公开仓库拉取参考答案。内部得分看起来很漂亮,到了生产环境却崩溃。
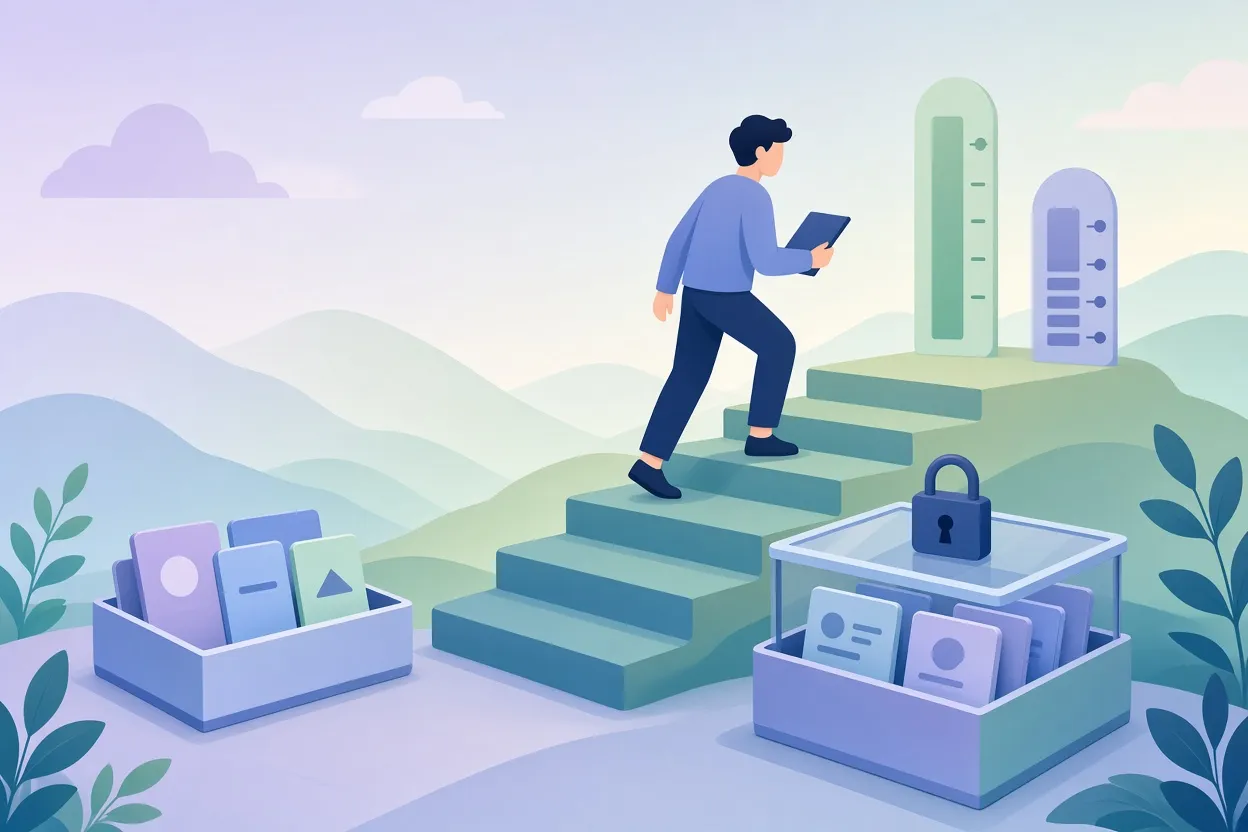
▲ 在训练集上爬坡并保留测试集
/claude-api hillclimb命令在循环中内置了防御。它把评测拆分为训练集和测试集。分析器只读取训练集的失败案例,形成假设,每轮提出一个diff。每轮对两个子集都打分。如果训练集和测试集都提升,保留这次修改;如果两者都持平或任一回退,则撤销。训练集得分上升而测试集持平,是过拟合的早期信号。该命令还会预先询问支出预算,并在进展连续数轮停滞时,对剩余失败案例聚类,检查问题是否出在提示词含糊或评分器缺陷,而非模型能力。这个过程是一种启发式方法,不保证收敛,鼓励开发者审核这些diff。
一项针对Anthropic自家Claude API技能的案例研究,用源自文档的问题进行评测,展示了一次运行的轮廓:
| 轮次 | 通过率 | 所做改动 |
|---|---|---|
| 基线 | 66.1% | 上下文不完整,存在细微错误 |
| 6 | 74.3% | 补充缺失的文档章节和类型定义 |
| 9 | 77.5% | 进一步补充 |
| 11 | 77.2% | 一次没有起效的提示词调整 |
| 12 | 80.1% | 关于技能如何编写可执行代码的说明 |
| 17 | 84.0% | 修复评分器逻辑并新增技能提示词 |
| 22 | 87.9% | 最终 |
爬坡也可以在保持准确率不变的前提下以成本为目标。在一个客服基准上,基线为高思考强度的Opus 4.6,得分74.4%,每张工单成本很高。换成低强度的Opus 5后,准确率上升,成本小幅下降。低强度的Sonnet 5大幅削减成本,准确率回到持平。再在低强度的Sonnet 5上调优提示词,准确率就超过了基线,同时锁定了90%的推理成本降幅。
反直觉的教训是,低强度的前沿模型往往比高强度的中档模型更便宜、更快,因为中档模型会消耗大量思考token,而更强的基础模型并不需要这些。强度设置并不设定token下限;Claude会根据问题难度调整思考量,所以高强度在简单查询上仍然便宜,在困难的编程任务上则大幅增长。实践中的顺序是先测试低强度的更强模型。在准确率、成本和延迟之间权衡时,建议一次只调一个目标,让搜索保持可控。
建议把提示词文本和技能描述作为第一个爬坡面。它们与模型行为紧密耦合,迭代很快,而执行框架代码会产生大量相互混淆的diff。另一面是,提示词也是最容易过拟合的面,这正是训练/测试拆分被视为必需的原因。过拟合被描述为远比模型意识到自己正在被评测更常见的实际问题。
面向多日运行智能体的执行框架
最后一个主题着眼于未来。任务时长已从2024年Claude 3 Opus上约四分钟的对话任务,增长到2025年Claude 3.5和3.7 Sonnet上相当于人类30分钟到两小时的工作,再到2026年Claude Opus 4系列和Opus 5模型上数小时乃至数天的异步运行。超过24小时后,网络中断和容器崩溃成了家常便饭,同步式设计会丢失进度。
Anthropic的答案已用于Claude Managed Agents,即把“大脑”(执行框架)与“双手”(沙箱执行)解耦。编排器会重启崩溃的执行框架或沙箱,状态保存在独立的、只追加的会话日志中,运行可以在夜间恢复而不丢失历史。把这份日志放在模型上下文窗口之外,还意味着上下文被压缩时细节不会永久丢失;Claude可以通过工具调用查询过去的上下文。凭证保存在工具模块内的保险库中,模型永远接触不到原始密钥。Anthropic开发者博客的一篇相关文章《Building Effective Agent Automations》给出了定时智能体模式,并配有轮次上限、支出限额和时间限制等护栏,/claude-api managed-agents-onboard可以在Claude Code内完成配置。
现在该做什么
贯穿始终的主线是,前沿模型常常被为其前代打造的脚手架和测量方式“束缚”。实践上的操作顺序:
- 迁移到更新的模型时运行/checkup prompt-audit和/claude-api prompt-audit,去掉验证仪式、草稿区强制要求、彻底性强化语和互相矛盾的规则。
- 重排提示词,让静态内容在前,在Claude Console查看缓存读取比例,并运行/claude-api cost-optimize。
- 在优化任何东西之前,先确认评测能区分模型层级、随强度提升、留有空间且方差低。使用二元细则或成对比较,跨模型层级验证评判者,并亲自审查原始轨迹。
- 先对提示词爬坡,严格拆分训练/测试集、设定token预算并由人工审核diff。先测试低强度的前沿模型,再考虑高强度的小模型。
- 对于长时间运行的智能体,把会话日志和密钥放在执行框架和沙箱之外。
所描述的更大转变是,Anthropic的工程师如今把大部分时间花在设计评测和任务上,交由Claude在夜间优化,生产环境的失败轨迹流入离线评测集,再进入回归测试。收益的大小取决于各团队的起点,但这些修复本身试起来成本很低。


