Anthropic의 한 엔지니어가 정리한 실무 지침의 핵심은 간단합니다. 최신 Claude를 쓰면서 성능이 기대에 못 미치거나 비용이 많이 나온다면, 모델의 한계보다 예전 모델에 맞춰 써 둔 prompt와 설정이 원인일 가능성이 크다는 것입니다. '단계별로 생각하라', '답하기 전에 두 번 검증하라' 같은 지시는 한때 효과가 있었지만 지금은 token을 낭비하고 답의 품질을 떨어뜨리는 '부채'가 됐습니다. 이 부채를 걷어내고, prompt cache가 깨지지 않게 구조를 다시 짜고, 모델이 스스로 개선할 수 있는 eval(모델 성능을 재는 평가 기준)을 설계하면 품질과 비용을 동시에 잡을 수 있다는 것이 전체 흐름입니다. Anthropic이 여러 benchmark에 자동 비용 최적화를 적용한 결과, 비용이 최대 72.9% 줄었고 점수는 거의 그대로였습니다.
대부분의 앱은 '효율 경계' 안쪽에 있습니다
품질과 비용은 보통 맞바꾸는 관계로 생각합니다. 품질을 올리려면 비싼 모델을 쓰고, 비용을 줄이려면 품질을 포기한다는 식입니다. 이 관계를 그래프로 그리면 Haiku, Sonnet, Opus 같은 모델 등급이 각각 다른 지점에 놓이는 효율 경계(Pareto frontier)가 생깁니다.
그런데 실제 고객 앱 대부분은 이 경계 위가 아니라 안쪽 깊숙이 있습니다. 모델이 부족해서가 아니라 prompt와 설정의 작은 문제 때문입니다. 이를 고치면 같은 품질을 훨씬 낮은 비용으로 얻는 '공짜 이득'이 생깁니다. 아래에서 다루는 prompt 감사, cache, eval, hillclimb(평가 점수를 기준으로 조금씩 고쳐 올라가는 자동 최적화)는 모두 앱을 이 경계 위로 끌어올리는 방법입니다.
prompt 부채: 예전 모델용 습관이 최신 모델을 방해합니다
코드에 기술 부채가 쌓이듯 prompt에도 부채가 쌓입니다. 모델 세대가 바뀌어도 prompt는 그대로 남아, 예전 모델의 약점을 보완하려던 지시가 최신 모델에는 짐이 됩니다.
| 부채 유형 | 예 | 문제 |
|---|---|---|
| 검증 의식 | '답하기 전에 작업을 검증하라', '두 번 확인하라' | 불필요한 검증 반복으로 출력 token 증가 |
| 절차·scratchpad 강제 | 단계별로 생각을 적게 하는 지시 | 모델이 스스로 정하는 사고 과정을 방해 |
| 철저함 강조 | '최대한 철저하게' | 추론은 나아지지 않고 길이만 늘어남 |
| 게으름 방지 문구 | 도구를 꼭 쓰라고 다그치는 문구 | token 낭비 |
| 예시 과다 | 풀이 예시를 잔뜩 넣음 | 입력 token 증가 |
| 모순된 규칙 | 긴 system prompt 곳곳에서 충돌하는 지시 | 최신 모델은 모두 지키려다 혼란 |
| 낡은 설정 | 구 모델 기준 설정값 | 아예 동작하지 않음 |
최신 모델은 언제 생각할지, 중간 결과를 어떻게 검증할지 스스로 판단합니다. 그래서 위 지시들은 입력과 출력 token을 모두 늘려 비용을 올리고 품질까지 떨어뜨릴 수 있습니다. 특히 모순된 지시는 예전 모델이라면 그냥 무시했겠지만, 지시를 엄격히 따르려는 최신 모델은 양쪽을 조화시키려다 엉뚱한 답을 내게 됩니다.
Claude Code에서 쓸 수 있는 감사 명령은 두 가지입니다.
- /checkup prompt-audit: Claude Code 프로젝트 설정, memory 파일, skill에 쌓인 anti-pattern을 점검합니다.
- /claude-api prompt-audit: Anthropic API를 직접 호출하는 코드베이스를 훑어 낡은 검증 지시와 강조 문구를 제거합니다.
효과를 보여 주는 예로 고객 지원 티켓 50건으로 만든 합성 benchmark가 있습니다. Opus 4.8에서 Opus 5.5로 옮기는 상황을 가정했는데, 낡은 prompt를 그대로 들고 옮기면 비용과 정확도가 조금 좋아지는 데 그쳤습니다. 반면 prompt 감사를 거치자 정확도가 약 89.5%에서 약 91.8%로 오르고 티켓당 비용은 절반 가까이 줄었습니다. 다만 Haiku처럼 작은 모델은 여전히 명시적인 안내가 필요할 수 있어, 어느 등급부터 낡은 지시를 지워도 되는지는 직접 확인해야 한다는 단서가 붙습니다.
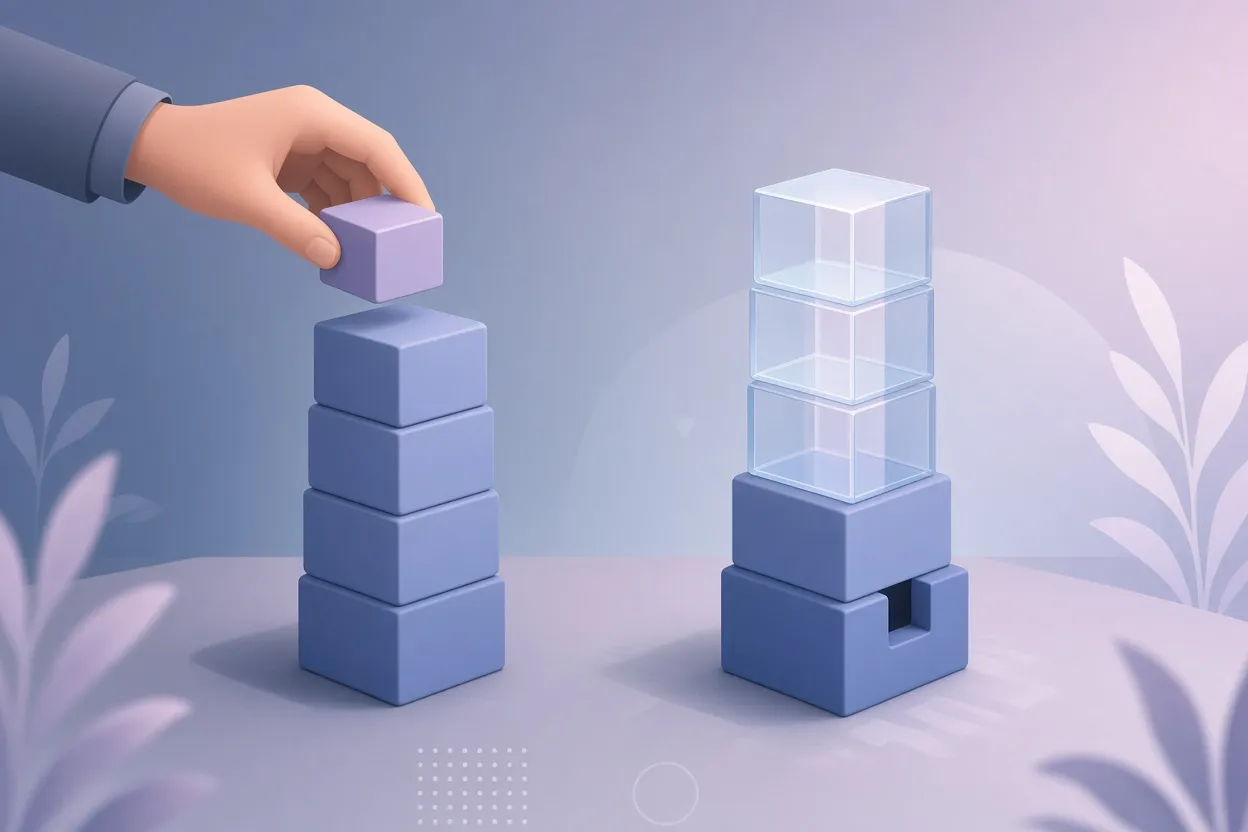
▲ prompt cache의 접두 일치
prompt cache: 앞부분 한 byte만 바뀌어도 전부 무효입니다
두 번째 지렛대는 prompt cache입니다. 여러 turn을 주고받는 agent 작업에서는 매 turn마다 tool 호출 같은 작은 정보만 새로 붙고, 큰 공통 context는 반복해서 보내집니다. cache에서 읽는 token은 일반 입력 token의 약 1/10 가격으로 청구되고 응답 속도도 크게 빨라집니다. 정확한 가격은 모델마다 다를 수 있으니 최신 가격표를 확인해야 합니다.
문제는 cache가 prompt 맨 앞부터 정확히 일치하는 접두(prefix)에만 적용된다는 점입니다. 네 번째 byte 하나만 달라져도 그 뒤의 모든 token이 cache에서 빠집니다. 그래서 바뀌는 내용이 큰 고정 블록보다 앞에 오면 안 됩니다. 권장 순서는 다음과 같습니다.
- system 지시: 전역으로 cache
- tool schema: 전역으로 cache
- CLAUDE.md 같은 프로젝트 memory: 프로젝트 단위로 cache
- session 상태: session 단위로 cache
- 동적 메시지: 맨 끝에 turn마다 추가
Claude Console의 cache 진단 화면은 cache 읽기 비율, 누적 cache 읽기 token, cache miss token, 그리고 miss 원인(메시지 변경, system 변경, tool 변경, 모델 변경)을 보여 줍니다. 예를 들어 읽기 비율 71.3%, 누적 읽기 token 124억 개, miss token 2만 8,400개 같은 수치를 한눈에 확인할 수 있습니다.
이 작업도 자동화할 수 있습니다. Claude Code에서 /claude-api cost-optimize를 실행하면 API 사용 패턴을 분석해 cache가 깨지는 지점을 찾고 prompt 구조를 다시 배치하며, 추론 effort 같은 설정에서 새는 비용도 점검합니다. Anthropic의 Applied AI 팀이 이 명령을 내부 benchmark에 적용한 결과는 다음과 같습니다.
| benchmark | 비용 변화 | 점수 변화 |
|---|---|---|
| tau2-bench(retail) | -72.9% | +2.0%p |
| LegalBench | -66.9% | -0.8%p |
| OfficeQA Pro | -71.7% | +0.1%p |
| SWE-bench Verified | -14.3% | +1.1%p |
eval 설계: 모델이 '오를 수 있는' 평가여야 합니다
prompt를 정리하고 cache를 잡았다면, 다음은 개선을 측정할 eval입니다. 좋은 eval은 모델이 스스로 결과를 읽고 고쳐 나갈 수 있는 구조여야 합니다. 네 가지 조건이 제시됩니다.
- 모델 등급이 Haiku, Sonnet, Opus로 올라갈수록 점수도 함께 올라야 합니다.
- 생각에 쓰는 token이나 effort를 늘리면 점수가 올라야 합니다.
- 만점까지 여유(headroom)가 충분해야 합니다.
- 같은 조건으로 여러 번 돌려도 점수 편차가 작아야 합니다.
흔한 결함은 모호한 과제 정의와 풀 수 없는 edge case입니다. 이런 문항이 섞이면 headroom이 가짜로 줄고 결과가 요동칩니다. 어떤 모델도 닿을 수 없는 천장을 향해 자동 최적화를 돌리면 token만 태우게 됩니다. 공개 benchmark에도 모호한 문항이 꽤 있다는 지적도 있습니다.
/claude-api build-eval은 이 과정을 돕는 명령입니다. 데이터 위치나 형식을 가리지 않고 tracing 도구, telemetry DB, 원시 로그에 연결해 어떤 문제를 풀고 싶은지 묻고, trace 샘플을 살펴보며 평가 쌍을 단계별로 만들어 줍니다. 채점 기준의 모호함을 점검하고 test set의 다양성도 확인합니다. 다만 Claude가 trace에서 이상 사례를 찾아내는 데 뛰어나더라도, 그 사례를 정식 benchmark에 넣기 전에는 사람이 원시 데이터를 직접 검토하는 단계가 꼭 필요합니다. 무엇이 중요한지 정하는 사람의 안목이 eval의 출발점이기 때문입니다.
채점자(LLM judge)를 설계하는 법
프로그램으로 정답을 확인할 수 있으면 그 방법이 항상 우선입니다. 주관적인 과제라면 LLM을 채점자로 쓰되 다음 원칙을 따릅니다.
- 1~10점, 0~5점 같은 연속 척도는 피합니다. 기준이 흐려 편차가 큽니다.
- 통과/실패의 이진 기준으로 묻거나, 여러 개의 이진 체크리스트로 쪼갭니다.
- 웹 페이지처럼 절대 점수를 매기기 어려운 결과물은 A와 B를 짝지어 비교(pairwise)합니다. 생성형 UI에서는 이 비교를 여러 번 돌려 Elo 점수로 순위를 매긴 사례가 있습니다.
- Sonnet, Opus, Haiku로 같은 rubric(채점 기준표)을 돌려 봅니다. 등급 간 판정이 크게 엇갈리면 rubric이 모호하다는 신호입니다.
- 같은 입력을 반복 채점해 편차가 작은지 확인합니다.
- 기준이 이진이고 명확하면 작고 싼 모델을 채점자로 써도 됩니다.
eval 데이터의 분포도 중요합니다. 특정 모델 하나가 틀린 사례만 모아 benchmark를 만들면 치우칩니다. 모델의 능력은 들쭉날쭉해서 Sonnet 4.5가 못 푸는 문제를 Opus 4.5는 쉽게 풀고, 반대로 Opus가 엉뚱한 곳에서 틀리기도 합니다. 실제 운영 트래픽과 기본 원칙에서 사례를 뽑아야 합니다.
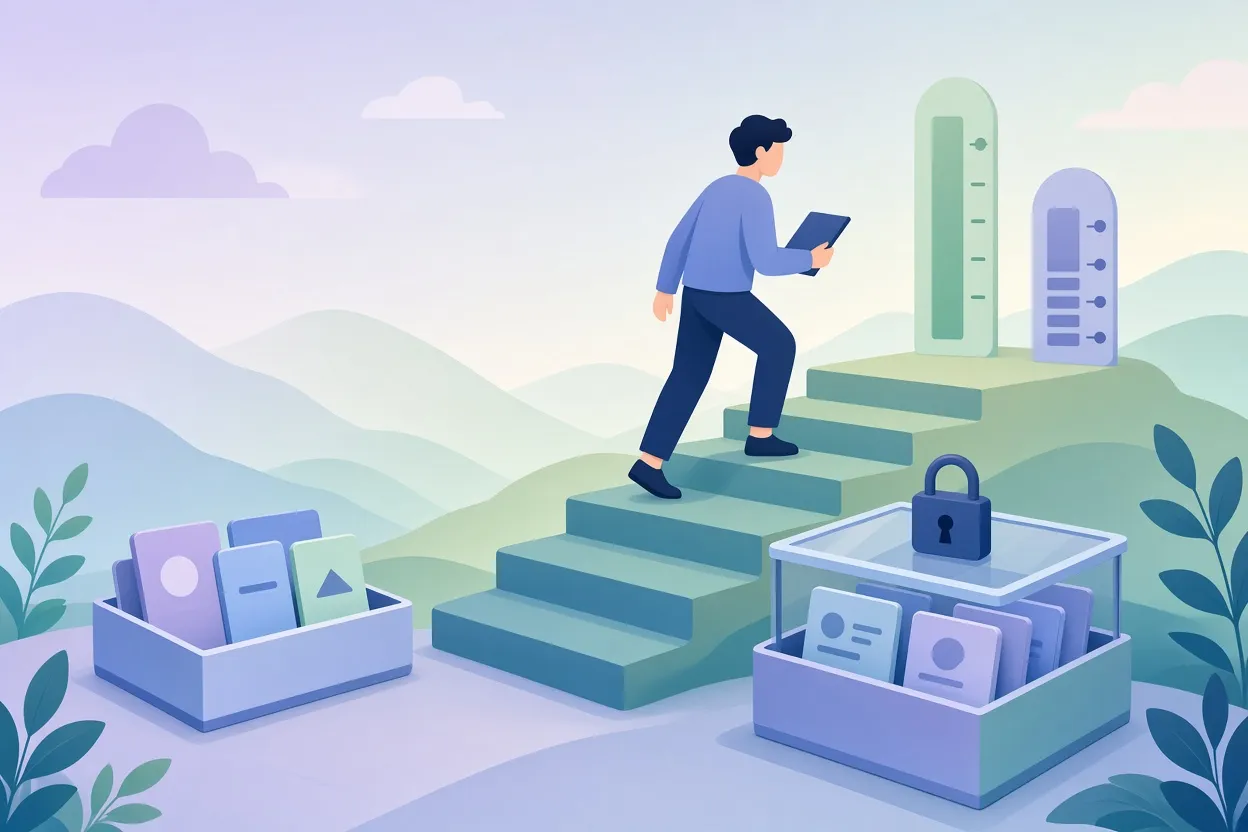
▲ test를 숨긴 hillclimb
hillclimb: 자동 개선과 overfitting 방어
eval이 갖춰지면 /claude-api hillclimb로 Claude가 eval 결과를 읽고 prompt나 skill 코드를 스스로 고치는 반복을 돌릴 수 있습니다. 한 round의 흐름은 다음과 같습니다.
- 수정 대상(예: system prompt)을 정하고 앱의 모델과 harness(모델을 감싸 실행을 관리하는 바깥 구조)는 고정합니다.
- eval 데이터를 train split과 test split으로 나눕니다.
- 분석기는 train split의 실패 trace만 읽고 가설을 세워 round당 하나의 변경(diff)을 제안합니다.
- 두 split 모두 점수를 재서, 둘 다 오르면 유지하고, 둘 다 제자리이거나 하나라도 떨어지면 되돌립니다.
test split을 분석기가 절대 못 보게 하는 것이 핵심입니다. 모델은 benchmark 특유의 표현에 맞춘 prompt, 실패 하나마다 덧붙이는 땜질, 공개 저장소에서 정답을 가져오는 식의 overfitting(평가 데이터에만 맞춰져 실제 환경에서는 통하지 않는 상태)에 매우 능합니다. benchmark에 이미지 과제가 섞여 있다는 이유로 운영에서는 쓸 일 없는 OCR tool을 추가하거나, 예제가 /app 폴더에 있다고 그 경로를 하드코딩하는 왜곡도 일어납니다. train 점수는 오르는데 test 점수가 제자리라면 overfitting의 조기 신호이므로 그 변경은 버립니다. 모델이 평가받는 상황을 눈치채는 '평가 인지'도 연구된 현상이지만, 실무에서는 overfitting이 훨씬 흔하고 큰 문제입니다.
시작 대상은 harness 코드보다 system prompt나 skill 설명 같은 텍스트가 낫습니다. 텍스트는 모델 행동과 직접 연결돼 인과가 분명하고 빠르게 돌릴 수 있는 반면, harness 코드 수정은 diff가 커서 원인을 가리기 어렵습니다.
두 가지 사례
먼저 Claude API skill 자체를 hillclimb한 사례입니다. Anthropic SDK와 API에 관한 질문에서 처음 통과율은 66.1%였습니다. 빠진 문서 섹션과 타입 정의를 추가한 round 6에 74.3%, round 9에 77.5%, round 11에는 77.2%로 잠시 내려갔다가, 실행 가능한 코드를 쓰는 법을 지시한 round 12에 80.1%, 채점 로직을 고치고 skill prompt를 보강한 뒤 84.0%를 거쳐 최종 87.9%에 도달했습니다.
비용을 목표로 둔 사례도 있습니다. 정확도를 유지한다는 제약 아래 모델 등급, effort, prompt 길이를 탐색하게 했습니다. 고객 지원 benchmark에서 Opus 4.6 high effort가 74.4% 정확도로 출발했고, Opus 5 low effort로 바꾸자 정확도가 오르고 비용이 조금 줄었습니다. 이어 Sonnet 5 low effort는 비용을 크게 낮추는 대신 정확도가 기준선 근처로 내려갔는데, 그 상태에서 prompt를 다듬자 정확도가 기준선 이상으로 회복되면서 전체 추론 비용은 90% 줄었습니다.
상위 모델을 낮은 effort로
여기서 직관에 반하는 결론이 나옵니다. 상위 모델을 낮은 effort로 돌리는 편이 중간 모델을 높은 effort로 돌리는 것보다 자주 더 싸고 빠릅니다. Sonnet이 high effort에서 추론에 막대한 token을 쓰는 동안, Opus는 기본 능력이 높아 적은 token으로 같은 정확도에 닿기 때문입니다. 모델을 고를 때는 Opus 4.5 low effort부터 시험하고 그다음에 effort를 올리라는 권고입니다. high effort가 항상 token을 많이 쓰는 것도 아닙니다. 쉬운 문제에는 Claude가 추론 token을 알아서 줄이고, 어려운 코딩 문제에서만 크게 늘어납니다.
예산과 정체 대응
hillclimb는 수렴이 보장되지 않는 heuristic(경험적 탐색)입니다. 그래서 명령은 실행 전 예산 한도를 묻습니다. eval의 20%가량이 모순되거나 풀 수 없는 문항이라면 최적화는 거기서 멈추고 자원만 소모합니다. 여러 round 동안 점수가 제자리라면 모델 한계보다 eval 결함일 가능성이 높으며, 도구는 남은 실패를 묶어 모호한 rubric을 찾아내는 대비책을 갖추고 있습니다. 비용·정확도·지연을 동시에 최적화할 수도 있지만 탐색이 복잡해지므로 한 번에 하나씩 다루는 편이 현실적입니다. 필요한 샘플 수나 split 비율은 hillclimb 명령 안의 heuristic에 물어보라는 안내도 있습니다.
긴 작업을 위한 harness와 바깥 고리
2024년의 Claude 3 Opus가 사람 기준 4분짜리 작업을 다뤘다면, 2025년 중반 Claude 3.5·3.7 Sonnet은 30분에서 2시간, 2026년의 Claude Opus 4·4.5·4.6과 Opus 5는 수 시간에서 수일짜리 비동기 작업을 맡습니다. 24시간을 넘기면 네트워크 끊김이나 container 충돌 한 번으로 진행 상황이 날아가는 기존 설계는 버티지 못합니다. Anthropic은 Claude Managed Agents에서 '두뇌'인 harness와 '손'인 sandbox를 분리하고, 세션 기록을 추가만 가능한 독립 로그에 저장해 어느 쪽이 밤새 죽어도 orchestrator가 새 인스턴스를 띄워 이어 가게 합니다. API 키 같은 비밀은 tool 모듈의 vault에 두어 Claude가 원문을 보지 않고도 인증된 tool을 쓰게 합니다. 대화 기록을 context window 안에만 두고 압축하면 세부 정보가 영구히 사라지지만, 외부 로그로 분리해 두면 필요할 때 tool 호출로 다시 꺼낼 수 있습니다.
이 요소들은 하나의 바깥 고리로 이어집니다. 운영 중인 agent의 trace를 online 평가자가 실시간으로 채점하고, 실패 trace를 offline eval에 넣어 hillclimb로 고친 뒤 회귀 테스트로 굳히는 흐름입니다. online 평가자 보정이 아직 쉽지 않다는 단서는 있지만, 이 순환은 업계 표준이 되어 가고 있습니다. Anthropic 안에서도 많은 엔지니어가 근무 시간 대부분을 eval 설계와 과제 정의에 쓰고 최적화 자체는 Claude가 밤새 돌리는 쪽으로 일하는 방식이 바뀌고 있다는 점은, 앞으로 AI 엔지니어의 역할이 어디로 갈지 보여 주는 신호로 읽힙니다.
정리: 지금 해 볼 일
- 최신 모델로 옮겼다면 prompt부터 감사합니다. '단계별로 생각하라', '두 번 검증하라', '최대한 철저히' 같은 문구와 서로 모순되는 규칙을 찾아 지웁니다. Claude Code를 쓴다면 /checkup prompt-audit, API 코드베이스라면 /claude-api prompt-audit를 돌립니다.
- prompt를 system 지시, tool, 프로젝트 memory, session 상태, 동적 메시지 순으로 재배치하고 Claude Console에서 cache 읽기 비율과 miss 원인을 확인합니다. /claude-api cost-optimize로 자동화할 수 있습니다.
- 자동 최적화 전에 eval이 네 조건(등급별 차이, effort에 따른 상승, headroom, 낮은 편차)을 만족하는지 봅니다. 채점은 이진 기준이나 pairwise 비교로 하고, 후보 사례는 사람이 원시 trace를 보고 확정합니다.
- hillclimb는 텍스트부터, train/test split과 예산 한도를 걸고 시작합니다. 모델 선택은 상위 모델의 low effort부터 시험합니다.
- 하루를 넘기는 agent라면 세션 로그와 비밀 정보를 harness 바깥으로 분리하는 설계를 검토합니다.


