抛开术语不谈,一个前沿语言模型其实就是一个装满数字的大文件,加上一段把这些数字串接起来的简短Python程序。把原始研究产物变成Claude或ChatGPT这样的产品,靠的是一连串训练阶段,每个阶段都以特定方式改变模型。预训练造出一台会续写文本的引擎;监督微调赋予这台引擎助手人格,并教它何时停下;强化学习,尤其是一种名为组相对策略优化(GRPO)的方法,则让模型通过给自己的尝试打分来学会推理。Anthropic的一位研究员从第一性原理出发梳理了这条流水线,这套阐述为理解规模相近的两个模型为何行为迥异提供了一个有用的框架。
模型就是数字加程序
当我们说一个模型有两万亿参数时,意思是权重文件里存着两万亿个独立的浮点数值。从Hugging Face下载一个开放模型,你拿到的是一个配置文件、分词器资源、序列化的权重分片(safetensors文件),以及一个Python类,它的forward函数把输入沿着这些权重传递下去,得出预测。此外没有任何隐藏的东西。
要理解这些数字在做什么,最简单的办法是看一个玩具回归问题:根据面积、卫生间数量和地段预测纽约市的公寓价格。数据集里可能有一套位于SoHo、1,200平方英尺、两卫的公寓,售价$120万;一套上西区2,000平方英尺、三卫的单元,售价$250万;一套西村800平方英尺、一卫的单元,售价$90万;还有一套东村4,000平方英尺、三卫的单元,售价$310万。软件工程师可以为七套房子手写规则,但面对数百万条房源、数百个变量就无从下手。神经网络的任务就是自动发现这个映射函数。
训练就是拧旋钮,直到误差缩小
在这个玩具模型里,每个输入都有一个权重,可以通俗地把它想成一个旋钮,用来调节该特征的重要程度。初始值是随机的,比如面积0.25、卫生间0.05、地段0.15,此时预测偏得很远。预测与真实值之间的差距就是损失。在这个练习的交互版本中,模型起初每套公寓平均偏差约$20万。
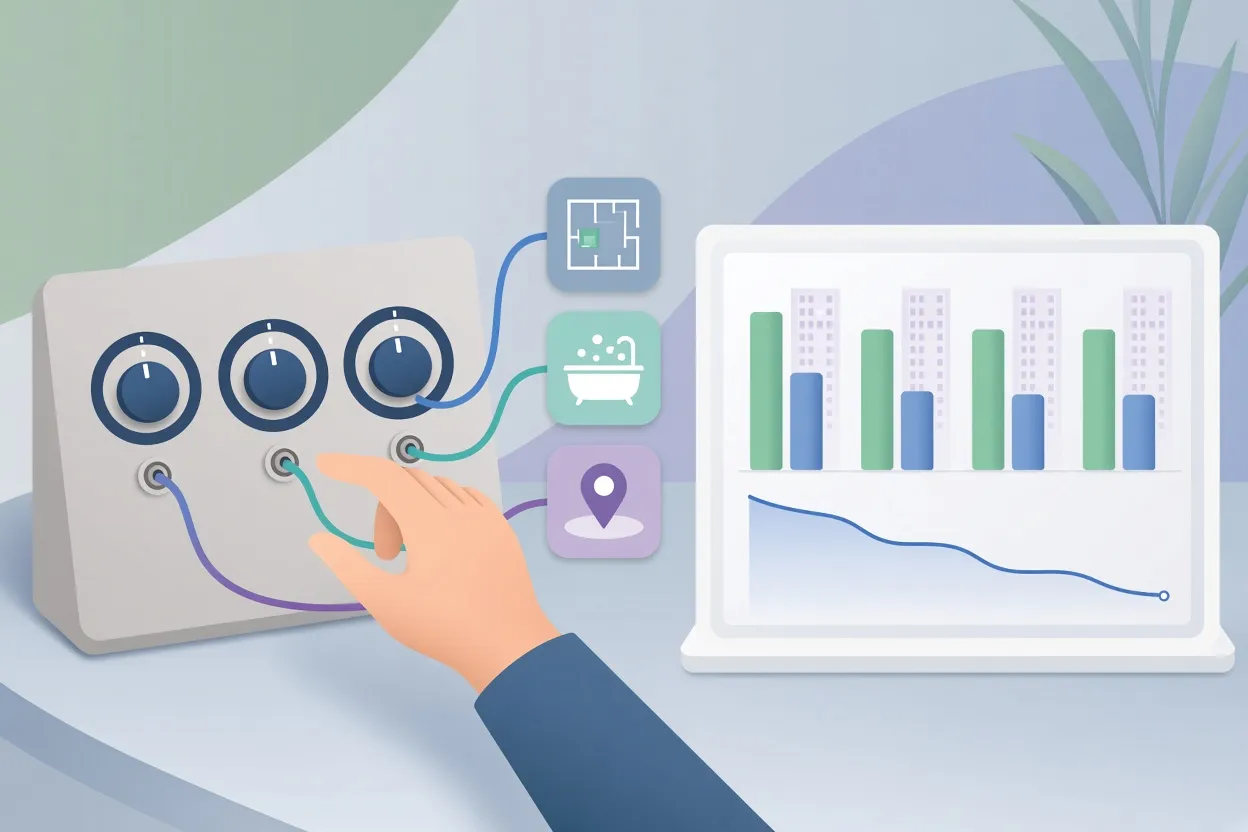
▲ 权重如同旋钮,调节以缩小预测误差
三个旋钮,人可以手动拧,把误差降下来。但参数有数十亿个时,手动就不可能了,这正是PyTorch、JAX、TensorFlow等自动微分框架的用武之地。它们把每一步运算记录在计算图中,然后计算损失对每个参数的导数。如果某个权重增加一个单位会让损失增加三,优化器就知道要往反方向推一推。每次推动的幅度由学习率决定。在PyTorch里,这就是那个熟悉的循环:计算预测,计算损失,调用optimizer.zero_grad()清除过时的梯度,调用loss.backward()为每个参数填入梯度,再调用optimizer.step()更新参数。一段使用Adam优化器、学习率0.03、运行1,000步的短脚本,均方误差从0.66到0.70左右起步,最终收敛到准确的各街区房价。
这个练习中有两个细节同样适用于大模型:
- 单个线性层的平均误差会停滞在$7万左右,因为它无法捕捉特征之间的交互,比如在SoHo多出的面积比在外围行政区值钱得多,而且不成比例。加入隐藏层和非线性激活函数即可解决。通用近似定理指出,一个带非线性且参数足够多的网络,基本上可以逼近任何连续函数。
- 从业者无需手工计算链式法则的导数。框架会代劳,而且Claude或ChatGPT这样的工具能写出并解释这类训练脚本的每一行。
语言模型与玩具网络的区别
语言模型用的是同一类数据,只是重新整理成了文本。那行公寓数据变成字符串“SoHo, 1200 sqft, 2 bath -> $1.2M”,模型学习预测每一个下一个词元:SoHo后面的逗号,然后是1200,最终是价格。最后一层输出的不是单个数字,而是覆盖词表中每一个词元的概率分布。如果正确词元“1.2M”被赋予10%的概率,损失衡量的就是它与已知的100%之间的差距,一步梯度更新可能把它提升到13%,同时压缩所有错误词元的概率。
理论上,在数据和算力无限的情况下,文本模型和数值模型会收敛到同一个函数。但实践中,语言空间的自由度要大得多,所以对于纯表格预测,常规网络远比它更准确、更高效。用大语言模型做数值回归任务,通常是用错了工具。
预训练产出的是自动补全器,不是助手
预训练让网络接触海量互联网文本,只优化下一个词元的似然。结果就是基础模型,它的行为很有启发性。阿里云的Qwen2-0.5B是一个5亿参数的开放权重模型,可以在免费的Google Colab笔记本中,用英伟达T4 GPU通过Hugging Face Transformers的pipeline加载。给它一个空提示词和100个词元的预算,基础模型会先吐出Python单元测试代码,接着是中文对话文本,因为这就是互联网上大概率出现的文本样貌。输入“Einstein said:”,它会生成零碎、半通不通的引语和编造的考题。
基础模型没有求真或助人的意图,也没有说话者角色的概念。早期用户发现,在提示词里写上“user:”和“assistant:”标签,可以诱导它进行对话。用这种格式问“what is 1+1”,基础模型会答对,然后不停地编造后续的用户问题和助手回答,直到撞上200个词元的硬性上限。即便使用模型原生的ChatML分隔符,也就是标记系统、用户或助手轮次起止的特殊词元,基础模型依然不知道答案什么时候算说完。
后训练塑造人格,教会停止
监督微调(SFT)是后训练的第一阶段。模型在一个格式化对话数据集上训练,数量从数万到数十万条不等,由人工标注员和合成流水线编写,其中每一个助手轮次都以明确的停止词元结尾。模型由此学到三件事:稳定的助手身份、对话的结构,以及何时输出停止词元。
差别立刻可见。问“Why is the sky blue?”,经过指令微调的Qwen2-0.5B-Instruct会给出连贯的科学解释,并干净地结束。查看tokenizer.apply_chat_template生成的原始提示词,可以看到一条默认系统消息,表明该模型是阿里云创建的Qwen,后面是正确分隔的用户和助手标签。使用带add_generation_prompt=True的apply_chat_template,而不是手工拼接分隔符字符串,可以避免格式错误。
指令模型仍有一个明显的局限。问“What is 398 * 923 + 2901?”,指令模型立刻猜出37546,与正确答案370,255差了一个数量级。它直接预测答案词元,没有把任何词元花在计算上。如果把助手轮次预先填上“Let's think step by step”,行为就变了:模型写出398乘923等于367,354,再加2,901,得出370,255。提升很大,但并无保证;同一测试的另一次运行得到了370,845。这个提示词技巧是在ChatGPT发布后被公开发现的,它正是后来OpenAI o1等推理模型的种子。
推理来自对模型自身轨迹的强化学习
教模型推理的核心难题在于,互联网文本里都是人类思考的成品,是润色过的博客文章和写完的代码库,而不是产生它们的草稿、死胡同和调试过程。模仿人类写作的模型学到的是人们如何表达,而不是如何解决问题。强化学习补上了缺失的那一块:试错。OpenAI o1是这一点的首次公开展示,在抽象与推理语料库(ARC)、复杂编程和幻觉率上都有提升,而DeepSeek-R1的技术报告则让更广泛的社区详细了解了这种方法。
最朴素的做法是拒绝采样:让模型为一道题生成100个分步解答,把正确的留作训练数据,其余丢弃。这有两个弱点。它扔掉了失败样本中的信号,而且会不加区分地强化成功尝试中的每一个词元,包括无关的废话,给更新引入噪声。
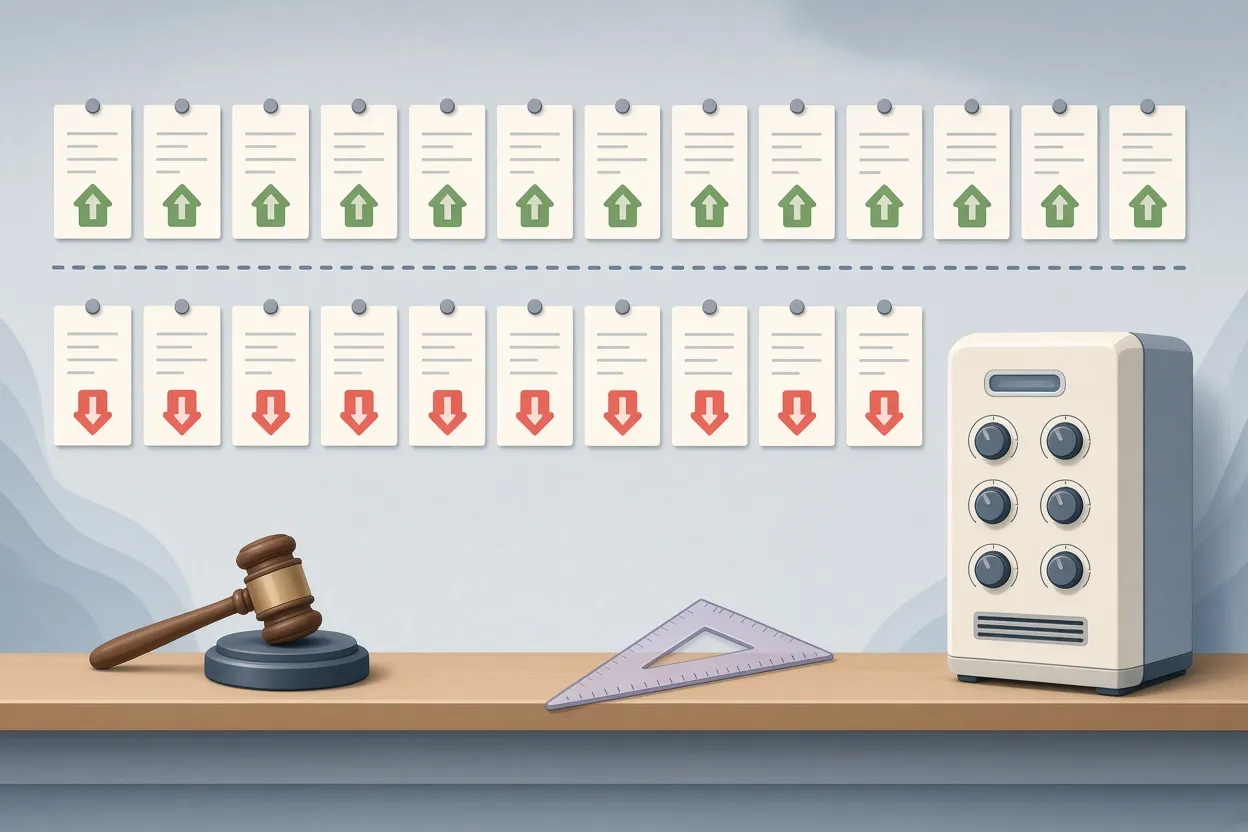
▲ GRPO按组内平均分给尝试打分
DeepSeek-R1论文提出的GRPO同时解决了这两个问题。模型针对一道题采样一批尝试,比如30个或100个。每个尝试按格式约束和正确性打分,分值范围例如从负一到正一。每个分数减去组内平均分,得到优势值。高于平均的尝试中的词元被调高概率,低于平均的尝试中的词元被调低概率。负面样本如今也能贡献信号,而各次尝试共有的噪声则相互抵消。这需要一个能自动验证解答是否正确的环境。
GRPO的一个关键特性是它是同策略的:模型只在自己生成的轨迹上训练。这位研究员的论点是,这样做精炼的是模型已在使用的回路,因此对现有权重的扰动,远小于在外部编写、风格陌生的推理数据上训练,后者有损害通用能力、引发灾难性遗忘的风险。任何形式的微调仍会造成一定退化,但同策略强化学习似乎能把退化降到最低,让模型在高难基准上逐步爬升,同时保留核心知识。
为什么各阶段保持分离
一个自然的问题是,为什么不从一开始就用强化学习,或者为什么不把各阶段合并。合并的研究仍在进行,但分离的现实原因在于,模型会沾染上训练数据的风格。预训练在人类文本的广泛分布上构建了一个下一词元预测器。后训练则安装了助手人格,包括沟通风格和行为边界。如果让一个后训练过的助手再去接触大量原始预训练数据,比如未经筛选的代码仓库,它的人格就会漂移,可能开始像原始代码那样作答,而不是像一个乐于助人的智能体。保持阶段分离可以防止这种崩塌;出于同样的原因,用未经整理的文本语料微调助手模型是应当避免的。
推理模型能发现新东西吗?
一种常见的批评认为,下一词元预测器受限于人类数据的分布,因此无法发现新的科学。这位Anthropic研究员的反驳是把推理定义为一个过程:一步一步地让不太可能、但真实且有趣的结论变得更有可能。广义相对论在阿尔伯特·爱因斯坦经年累月建立起一系列抽象和推演之前,并不是一个大概率的陈述。按同样的逻辑,一个能进行长程推理的模型会构建中间抽象,这位研究员预期这最终会带来超出训练分布的新科学知识。他承认模型尚未独立做出改变世界的突破,同时指出它们已经在解决此前人类未解的数学问题。这是一个预测,能否成立仍未可知。
这对读者意味着什么
上面的框架提供了一种解读模型差异的实用方法:
| 阶段 | 增加了什么 | 薄弱或缺失时的症状 |
|---|---|---|
| 预训练 | 关于文本和世界的广泛知识 | 事实知识浅薄或错误 |
| 监督微调 | 助手人格、对话格式、停止 | 絮絮叨叨、角色混乱、无法干净收尾 |
| 强化学习(GRPO) | 可验证任务上的多步推理 | 对数学和多步问题立刻给出错误猜测 |
由此可以得出几点行动建议。如果想亲自理解这些阶段,可以在免费的Google Colab笔记本中加载Qwen2-0.5B这类小型开放模型的基础版和指令版,用同样的提示词比较两者的输出,成本为零。如果你用指令模型处理多步任务,给它们思考的空间,因为一个词元给出的答案往往只是猜测。如果你要微调模型,优先选择精心整理的对话数据而非原始语料,并在目标是推理时考虑配备自动验证器的同策略方法。如果你正在学习这个领域,这里描述的路径更看重扎实的直觉和动手实验,而不是先精通微积分;导数交给框架处理,这个领域对自学者依然敞开。


