最先端の言語モデルは、専門用語をはぎ取れば、巨大な数値のファイルと、その数値をつなぎ合わせる短いPythonプログラムにすぎません。研究段階の生のモデルと、ClaudeやChatGPTのような製品を隔てているのは、モデルをそれぞれ特定の形で変えていく一連の学習段階です。事前学習は、テキストの続きを書き足すエンジンを生み出します。教師ありファインチューニングはそのエンジンにアシスタントとしての人格を与え、どこで止まるべきかを教えます。強化学習、とりわけGroup Relative Policy Optimization(GRPO)と呼ばれる手法は、モデル自身の試行を採点することで推論を教え込みます。Anthropicのある研究者がこのパイプラインを第一原理から説明しており、その内容は、規模が似た2つのモデルがなぜこれほど違う振る舞いをするのかを理解する有用な枠組みになります。
モデルは数値とプログラムの組み合わせ
モデルが2兆パラメータだと言われるとき、それは重みファイルに格納された2兆個の浮動小数点数を意味します。Hugging Faceからオープンモデルをダウンロードすると、設定ファイル、トークナイザー関連のファイル、シリアライズされた重みの分割ファイル(safetensors形式)、そして入力をそれらの重みに通して予測を出すforward関数を持つPythonクラスが手に入ります。それ以外に隠されたものはありません。
この数値が何をしているのかを理解する最も簡単な方法は、おもちゃのような回帰問題です。ニューヨーク市のアパート価格を、面積、バスルームの数、場所から予測するものです。データセットには、たとえば1,200平方フィート・バス2つのSoHoの物件が$120万、2,000平方フィート・バス3つのアッパーウエストサイドの物件が$250万、800平方フィート・バス1つのウエストビレッジの物件が$90万、4,000平方フィート・バス3つのイーストビレッジの物件が$310万、といった行が並びます。ソフトウェアエンジニアなら7件の住宅についてルールを手書きできますが、数百の変数を持つ数百万件の物件では無理です。ニューラルネットワークの仕事は、この対応関係(マッピング関数)を自動的に見つけ出すことです。
学習とは誤差が縮むまでつまみを回すこと
このおもちゃのモデルでは、各入力に重み、くだけて言えば「つまみ」が付き、その特徴をどれだけ重視するかを調整します。初期値はランダムで、たとえば面積に0.25、バスルームに0.05、場所に0.15といった値から始まり、予測は大きく外れます。予測と正解の差が損失(ロス)です。この演習のインタラクティブ版では、モデルは1物件あたり平均$20万ほど外した状態から始まります。
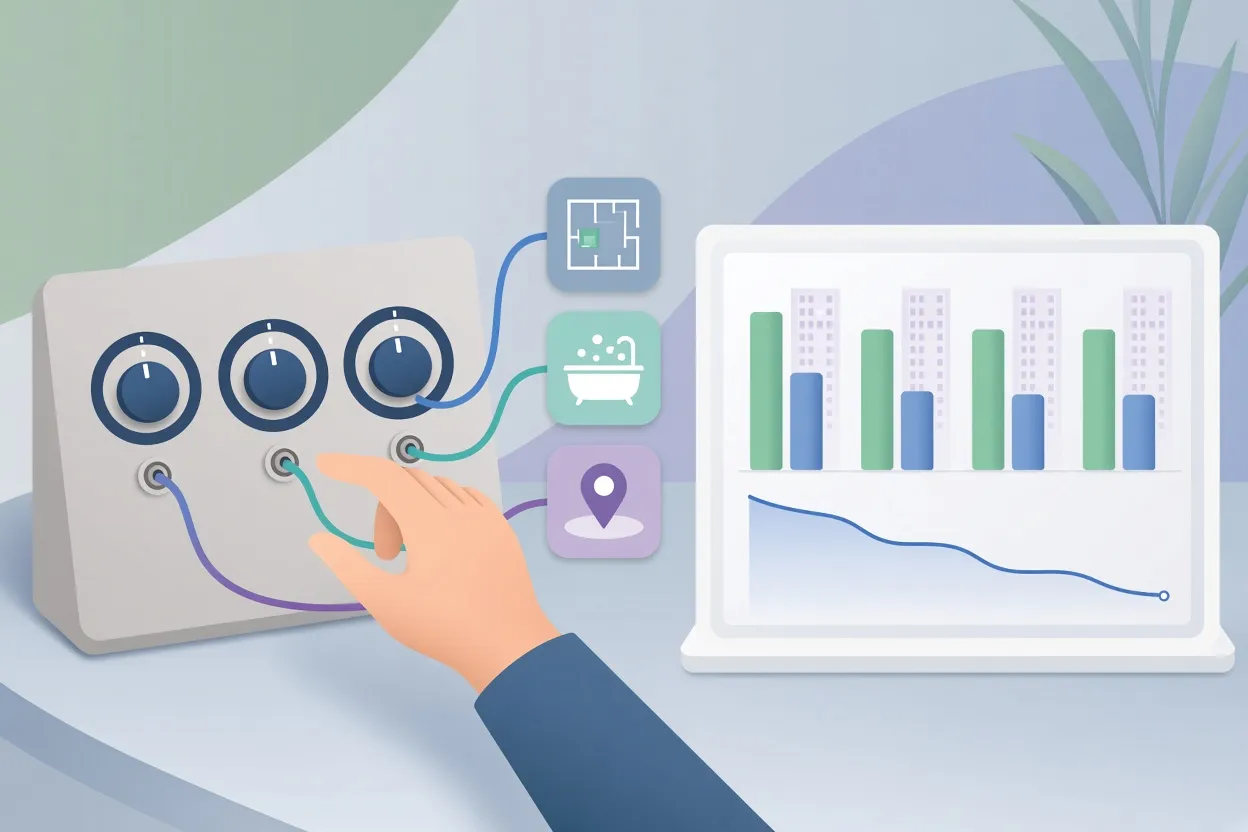
▲ 予測誤差を縮めるつまみとしての重み
3つのつまみなら人が手で回して誤差を減らせます。しかし数十億のパラメータでは不可能で、ここでPyTorch、JAX、TensorFlowといった自動微分フレームワークが登場します。これらは全ての演算を計算グラフに記録し、各パラメータについて損失の微分を計算します。ある重みを1増やすと損失が3増えるなら、オプティマイザーはそれを逆方向に少し動かせばよいと分かります。1回に動かす幅は学習率で決まります。PyTorchではおなじみのループになります。予測を計算し、損失を計算し、optimizer.zero_grad()で古い勾配を消し、loss.backward()で各パラメータの勾配を求め、optimizer.step()で更新する、という流れです。Adamオプティマイザーを学習率0.03で1,000ステップ回す短いスクリプトは、平均二乗誤差0.66から0.70程度から始まり、各地区の正確な価格に収束します。
この演習から、大規模モデルにもそのまま当てはまる2つの点が見えてきます。
- 線形層が1つだけだと、平均誤差は$7万あたりで頭打ちになります。追加の面積がSoHoでは郊外の区よりも不釣り合いに高く評価される、といった特徴同士の相互作用を捉えられないからです。隠れ層と非線形の活性化関数を加えればこの問題は解消します。万能近似定理によれば、非線形性と十分なパラメータを持つネットワークは、本質的にあらゆる連続関数を近似できます。
- 実務者が連鎖律の微分を手計算する必要はありません。フレームワークがやってくれますし、ClaudeやChatGPTのようなツールはこうした学習スクリプトの全行を書いて説明することもできます。
言語モデルはおもちゃのネットワークとどこが違うのか
言語モデルも同じ種類のデータで学習しますが、テキストの形に組み替えられています。アパートの1行は「SoHo, 1200 sqft, 2 bath -> $1.2M」という文字列になり、モデルはSoHoの後のカンマ、次に1200、そして最後に価格へと、次のトークンを順に予測することを学びます。最終層は1つの数値を出力するのではなく、語彙に含まれる全トークンにわたる確率分布を出力します。正解のトークン「1.2M」に10%の確率が割り当てられていれば、損失は既知の100%との差を測り、1回の勾配ステップでそれが13%に上がり、同時に全ての誤ったトークンの確率が圧縮される、といった具合です。
理論上は、無限のデータと計算資源があれば、テキストモデルと数値モデルは同じ関数に収束します。しかし実際には言語空間の自由度は桁違いに大きいため、純粋な表形式データの予測では従来型のネットワークのほうがはるかに正確で効率的です。数値の回帰タスクにLLMを使うのは、一般に道具の選択を誤っています。
事前学習が生むのはアシスタントではなく自動補完器
事前学習では、膨大な量のインターネット上のテキストにネットワークを触れさせ、次のトークンの尤度だけを最適化します。その結果がベースモデルで、その振る舞いは示唆に富んでいます。Alibaba CloudのQwen2-0.5Bは5億パラメータのオープンウェイトモデルで、無料のGoogle ColabノートブックのNVIDIA T4 GPU上で、Hugging Face Transformersのpipelineを通じて読み込めます。空のプロンプトと100トークンの予算を与えると、ベースモデルはPythonのユニットテストコードを出し、続けて中国語の会話文を出力します。それが「ありそうなインターネットのテキスト」の姿だからです。「Einstein said:」と与えると、断片的で半分だけ筋の通った引用や、生成された試験問題を出してきます。
ベースモデルには、正直であろうとか役に立とうという意図はなく、話し手の役割という感覚もありません。初期のユーザーは、プロンプトに「user:」「assistant:」というタグを書き込むことで対話を引き出せることに気付きました。その形式で「what is 1+1」と尋ねると、ベースモデルは正しく答えた後も、ユーザーの追加質問とアシスタントの回答を延々と作り続け、200トークンという上限に達して止まります。モデル固有のChatML区切り、つまりsystem・user・assistantの各ターンの始まりと終わりを示す特殊トークンを使っても、ベースモデルは答えがどこで終わるのかを知りません。
ポストトレーニングが人格と「止まり方」を作る
教師ありファインチューニング(SFT)はポストトレーニングの最初の段階です。モデルは、人間のアノテーターと合成パイプラインが書いた、整形済みの会話データセットで学習します。その数は数万から数十万件で、アシスタントの各ターンは明示的な停止トークンで終わります。ここからモデルは3つのことを学びます。安定したアシスタントとしてのアイデンティティ、会話の構造、そして停止トークンを出すタイミングです。
違いはすぐに目に見えます。「Why is the sky blue?」(空はなぜ青いのか)と尋ねると、指示チューニング済みのQwen2-0.5B-Instructは筋の通った科学的な説明を返し、きれいに終了します。tokenizer.apply_chat_templateが生成する生のプロンプトを見ると、モデルをAlibaba Cloudが作ったQwenだと示すデフォルトのシステムメッセージに続き、正しく区切られたuserとassistantのタグが並んでいます。区切り文字列を手で連結するのではなく、apply_chat_templateをadd_generation_prompt=Trueで使えば、整形ミスを避けられます。
指示モデルにはなお明確な限界があります。「What is 398 * 923 + 2901?」と尋ねると、指示モデルは即座に37546と推測しますが、正解の370,255とは桁が1つ違います。計算にトークンを一切使わず、答えのトークンを予測しているのです。アシスタントのターンの先頭に「Let's think step by step」(一歩ずつ考えよう)を書き込んでおくと振る舞いが変わります。モデルは398かける923は367,354と書き出し、2,901を足して370,255に到達します。改善は大きいものの保証はなく、同じテストの別の実行では370,845という結果になりました。ChatGPTの公開後に広く知られるようになったこのプロンプトの工夫が、OpenAI o1のような推論モデルへ発展する種となりました。
推論はモデル自身の軌跡に対する強化学習から生まれる
推論を教える上での核心的な問題は、インターネット上のテキストには人間の思考の完成品、つまり磨き上げられたブログ記事や完成したコードベースはあっても、それを生み出した下書き、行き止まり、デバッグの過程は含まれていないことです。人間の文章を模倣するモデルは、人がどう伝えるかを写すことは学びますが、どう問題を解くかは学びません。強化学習は欠けていた要素、すなわち試行錯誤を提供します。OpenAI o1はその最初の公開デモンストレーションで、Abstraction and Reasoning Corpus(ARC)、複雑なコーディング、ハルシネーション率で改善を示し、DeepSeek-R1の技術レポートがこの手法の詳細を広いコミュニティに示しました。
素朴なアプローチは棄却サンプリングです。ある問題に対してモデルに段階的な解答を100件生成させ、正解だったものを学習データとして残し、残りを捨てます。これには2つの弱点があります。失敗に含まれる信号を捨ててしまうこと、そして成功した試行に含まれる全トークンを、無関係な埋め草まで含めて無差別に強化してしまい、更新にノイズが混じることです。
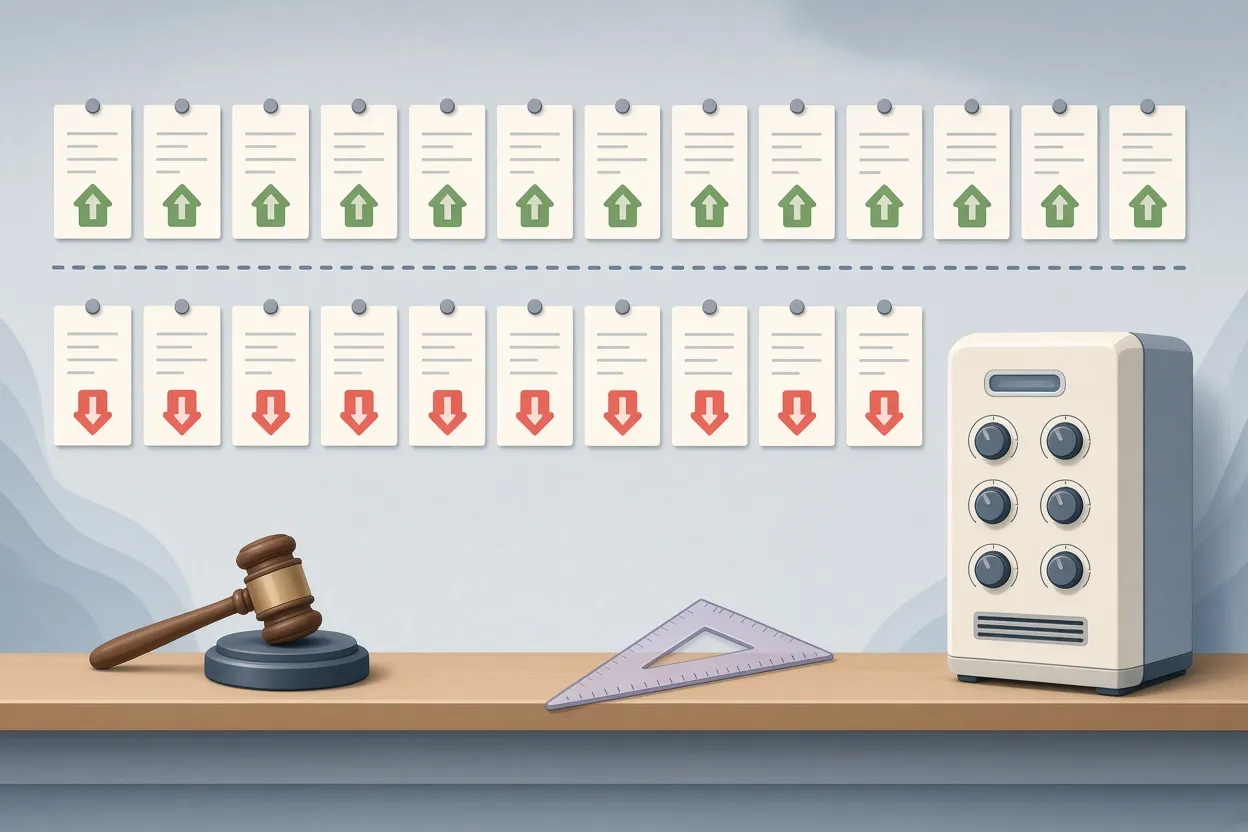
▲ グループ平均と比べて採点するGRPO
DeepSeek-R1の論文で導入されたGRPOは、この両方を解決します。モデルは1つの問題に対して、たとえば30件や100件といった試行のバッチをサンプリングします。各試行は書式の制約と正しさについて、マイナス1からプラス1といった尺度で採点されます。各スコアからグループ平均を引いたものがアドバンテージです。平均を上回る試行のトークンは出やすくなり、下回る試行のトークンは出にくくなります。これで負例も学習に寄与し、試行間で共通するノイズは打ち消されます。ただし、解答が正しいかを検証できる自動化された環境が必要です。
GRPOの重要な性質は、オンポリシーであること、つまりモデルが自分で生成した軌跡だけで学習することです。この研究者の論は、これによってモデルが既に使っている回路が磨かれるため、見慣れないスタイルで外部から書かれた推論データで学習する場合に比べ、更新が既存の重みを乱す度合いがはるかに小さい、というものです。外部データでの学習は、幅広い能力を損ない、破滅的忘却を引き起こすリスクがあります。どんな種類のファインチューニングでもある程度の劣化は起きますが、オンポリシーの強化学習はそれを最小限に抑えるように見え、モデルは中核的な知識を保ちながら難しいベンチマークを登っていけます。
なぜ段階は分けたままなのか
当然の疑問として、なぜ最初から強化学習を使わないのか、あるいはなぜ段階を統合しないのか、というものがあります。統合に向けた研究は進行中ですが、分けている実務上の理由は、モデルが学習データのスタイルをそのまま身に付けてしまうことにあります。事前学習は人間のテキストの広い分布に対する次トークン予測器を作ります。ポストトレーニングは、コミュニケーションのスタイルと行動の境界を持つアシスタントの人格を組み込みます。ポストトレーニング済みのアシスタントを、フィルタリングされていないコードリポジトリのような生の事前学習データに大量にさらすと、人格がずれていき、役に立つエージェントではなく生のコードのように応答し始めることがあります。段階を分けておくことでこの崩壊を防げますし、同じ理由から、アシスタントモデルを精選されていないテキストコーパスでファインチューニングするのは避けるべきことです。
推論モデルは新しいものを発見できるのか
よくある批判は、次トークン予測器は人間のデータの分布に縛られているため、新しい科学を発見することはできない、というものです。Anthropicの研究者の反論は、推論とは「ありそうにないが真で興味深い結論を、一歩ずつ、より確からしいものにしていく過程」だと定義するところから始まります。一般相対性理論は、アルベルト・アインシュタインが時間をかけて一連の抽象化と演繹を積み上げるまでは、確からしい主張ではありませんでした。同じ論理で、長い時間軸にわたって推論するモデルは中間的な抽象を構築していくので、この研究者はこれがいずれ学習分布を超えた新しい科学的知識につながると見込んでいます。モデルが単独で世界を変えるブレークスルーをまだ生み出していないことは認めつつ、人間が未解決だった数学の問題を既に解き始めている点を指摘しています。これは予測であり、当たるかどうかはまだ分かりません。
読者にとっての意味
上記の枠組みは、モデルの違いを解釈する実用的な手がかりになります。
| 段階 | 加わるもの | 弱い・欠けているときの症状 |
|---|---|---|
| 事前学習 | テキストと世界についての幅広い知識 | 浅い、または誤った事実知識 |
| 教師ありファインチューニング | アシスタントの人格、会話の形式、停止 | 冗長な出力、役割の混乱、きれいに終われない |
| 強化学習(GRPO) | 検証可能なタスクでの多段階推論 | 数学や多段階問題での即答の誤り |
ここからいくつかの行動が導けます。各段階を自分で確かめたいなら、Qwen2-0.5Bのような小さなオープンモデルのベース版と指示版を無料のGoogle Colabノートブックで読み込み、同じプロンプトに対する出力を比べてみてください。費用はかかりません。多段階のタスクに指示モデルを使うなら、考える余地を与えてください。1トークンで出てきた答えはしばしば当て推量です。モデルをファインチューニングするなら、生のコーパスより精選された会話データを選び、目的が推論なら自動検証器を備えたオンポリシー手法を検討してください。そしてこの分野を学んでいるなら、ここで述べた道筋は、まず微積分を極めることより、確かな直感と手を動かす実験を重視しています。微分はフレームワークが処理してくれますし、この分野は独学の実践者にも開かれたままです。


