frontier LLM(최전선 성능의 대형 언어 모델)이 어떻게 만들어지는지는 흔히 복잡한 수식과 전문 용어 뒤에 가려져 있습니다. 하지만 Anthropic의 한 연구자가 정리한 틀을 따라가면 핵심은 단순합니다. 모델은 숫자가 가득 든 파일과 그 숫자를 어떻게 연결할지 정한 짧은 Python 코드의 묶음이고, 그 숫자를 세 단계에 걸쳐 조정한 결과가 지금 우리가 쓰는 ChatGPT나 Claude입니다. pre-training(사전 학습)은 세상의 글을 흡수하는 단계, post-training(사후 학습)은 비서라는 인격을 심는 단계, reinforcement learning(RL, 강화 학습)은 모델이 스스로 생각하는 법을 익히는 단계입니다. 어떤 모델이 어디서 강하고 어디서 약한지는 대체로 이 세 단계 가운데 어디에 얼마나 공을 들였는지로 설명된다는 것이 이 글의 출발점입니다.
신경망은 숫자 파일과 짧은 코드
출발점은 뉴욕 아파트 가격 예측이라는 작은 예제입니다. SoHo의 1,200제곱피트, 욕실 2개짜리 아파트는 $120만, Upper West Side의 2,000제곱피트, 욕실 3개는 $250만, West Village의 800제곱피트, 욕실 1개는 $90만처럼 면적, 욕실 수, 위치와 실제 거래가가 짝지어진 데이터가 있습니다. 전통적인 프로그래밍이라면 "면적이 얼마 이상이고 동네가 어디면 얼마"라는 규칙을 사람이 직접 써야 하는데, 집이 수백만 채가 되고 변수가 수백 개가 되면 불가능합니다. 신경망은 이 규칙을 컴퓨터가 데이터에서 스스로 찾아내게 하는 장치입니다.
가장 단순한 형태는 입력값 각각에 '손잡이(knob)', 곧 weight(가중치)를 곱해 더하는 것입니다. 면적에 0.25, 욕실 수에 0.05, 위치에 0.15 같은 임의의 값으로 시작하면 예측은 실제 가격과 크게 어긋나고, 이 어긋남의 평균이 loss(손실)입니다. 손잡이 3개짜리 예제에서는 사람이 직접 돌려 오차를 줄일 수 있습니다. 그러나 처음 $20만 정도였던 평균 오차는 단층 선형 모델로는 약 $7만 근처에서 더 내려가지 않습니다. 위치와 면적이 서로 얽혀 가격에 영향을 주는 비선형 관계를 직선 하나로는 담을 수 없기 때문입니다. 그래서 층(layer)을 여러 겹 쌓고 비선형 activation function(활성화 함수)을 끼워 넣습니다. Universal Approximation Theorem(보편 근사 정리)에 따르면 비선형 함수와 충분한 parameter(매개변수)를 가진 신경망은 거의 모든 연속 함수를 근사할 수 있습니다.
손잡이가 수십억, 수조 개가 되면 사람이 돌릴 수 없습니다. 이 일을 PyTorch, JAX, TensorFlow 같은 autograd(자동 미분) 엔진이 맡습니다. 엔진은 forward pass(입력에서 출력까지의 계산) 과정의 모든 연산을 그래프로 기록해 두고, loss를 각 parameter로 미분해 "이 손잡이를 조금 올리면 loss가 얼마나 변하는가"를 정확히 계산합니다. 어떤 weight를 1만큼 올렸을 때 loss가 3만큼 커진다면 반대 방향으로 learning rate(학습률)만큼 살짝 내리는 식입니다. 이것이 backpropagation(역전파)과 gradient descent(경사 하강)이고, PyTorch 코드로는 loss.backward()가 기울기를 계산하고 optimizer.step()이 parameter를 움직이는 두 줄에 해당합니다. 집값 예제를 1,000 step 학습시키는 짧은 스크립트는 step 0에서 0.66~0.70 수준이던 MSE loss가 꾸준히 떨어지는 모습을 보여 줍니다.
여기서 기억할 사실 하나는 "2조 parameter 모델"이라는 말이 문자 그대로 2조 개의 부동소수점 숫자가 파일에 저장돼 있다는 뜻이라는 점입니다. Hugging Face에서 모델을 내려받으면 설정 파일, tokenizer 파일, safetensors 형식의 weight 조각들, 그리고 forward 함수를 정의한 Python 클래스가 들어 있습니다. frontier 모델도 원리는 집값 예제와 같고 규모만 다릅니다.
LLM은 같은 원리를 글자에 적용한 것
LLM은 이 숫자 예측기를 글에 적용한 것입니다. 집값 표를 "SoHo, 1200 sqft, 2 bath -> $1.2M"이라는 문장으로 바꾸면, 모델은 'SoHo' 다음에 쉼표, 그다음에 '1200' 하는 식으로 앞의 token(모델이 글을 처리하는 최소 단위)들을 보고 다음 token을 예측하도록 학습됩니다. 숫자 예측기의 마지막 층이 가격 하나를 내놓는 반면, LLM의 마지막 층은 어휘 전체에 걸친 확률 분포를 내놓습니다. 정답 token '1.2M'에 10%만 배정했다면 학습 한 걸음 뒤에는 13%로 올라가고, 그만큼 다른 token의 확률은 줄어듭니다.
한 가지 짚어 둘 점이 있습니다. 데이터와 계산이 무한하다면 일반 신경망과 LLM은 이론상 같은 함수에 도달합니다. 그러나 현실의 유한한 자원 아래에서는 표 형태의 숫자 예측에 일반 신경망이 훨씬 정확하고 효율적입니다. 언어 공간은 자유도가 훨씬 커서 훨씬 많은 parameter와 계산을 요구하기 때문입니다. 숫자만 다루는 문제에 LLM을 쓰는 것은 비효율적인 선택입니다.
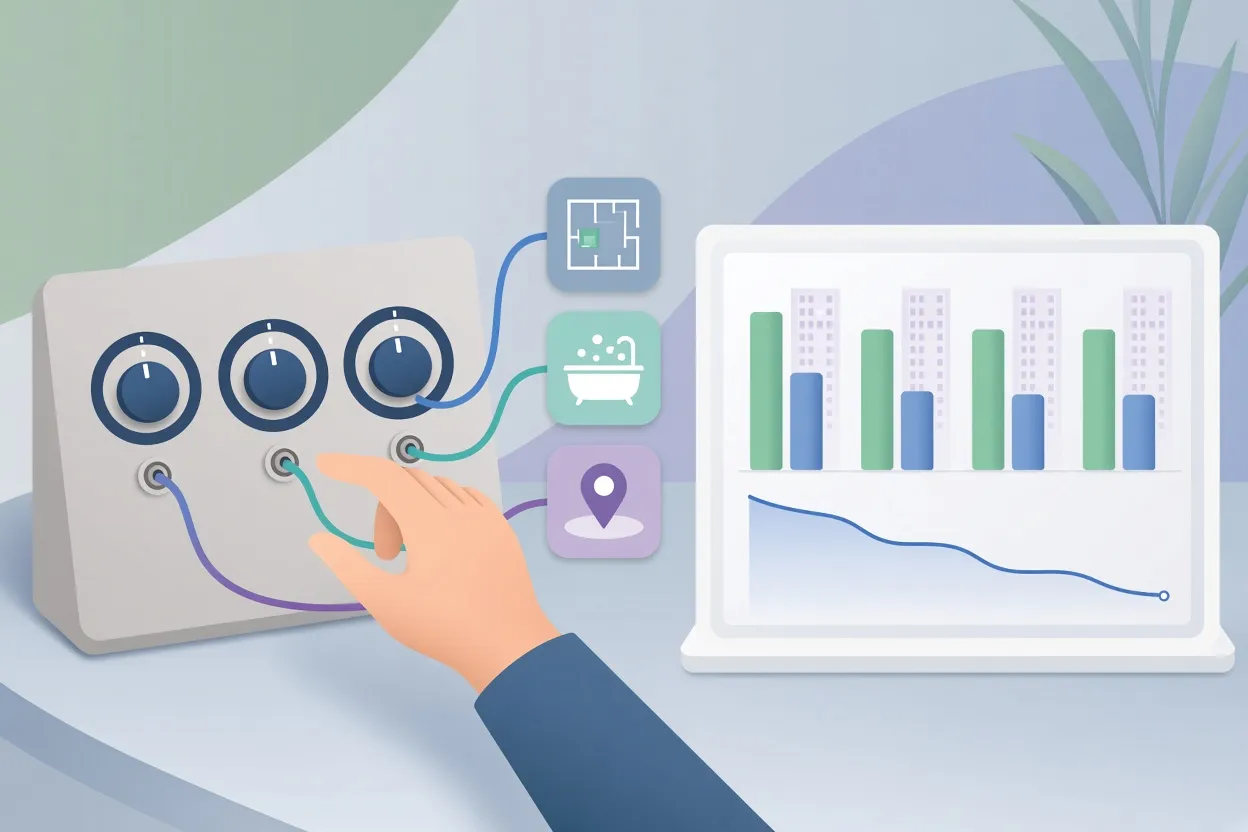
▲ weight 조정과 loss 감소
1단계 pre-training: 인터넷 자동완성기
pre-training을 마친 상태의 모델을 base 모델이라고 부릅니다. Alibaba Cloud의 Qwen2-0.5B(parameter 5억 개)의 base 버전을 Hugging Face Transformers의 pipeline으로 불러 아무 prompt(입력 지시문)도 주지 않고 100 token을 생성시키면 Python 단위 테스트 코드가 나오고 이어서 중국어 대화문이 따라붙습니다. 학습 데이터에 흔한 패턴을 그대로 이어 쓰는 것입니다. 'Einstein said:'처럼 사람 이름 뒤에 "말했다"를 붙여 주면 어디에도 없는 인용문을 그럴듯하게 지어냅니다. base 모델에는 진실을 말하려는 의도도, 도우려는 의도도 없고 오직 다음에 올 법한 token을 예측할 뿐입니다.
base 모델에는 멈추는 법도 없습니다. 'user: what is 1+1 assistant:'라고 입력하면 '1+1=2'까지는 맞게 이어 쓰지만, 곧바로 가상의 사용자 질문과 답을 끝없이 지어내며 설정한 최대 token 수(200개)에 닿을 때까지 계속 씁니다. Qwen2가 쓰는 ChatML 형식의 구분 token(<|im_start|>system, <|im_end|> 등)을 직접 넣어 주면 비서 역할을 완성하는 쪽으로 유도되지만, 역시 어디서 답이 끝나는지 모르고 횡설수설을 이어 갑니다. ChatGPT 이전에는 이런 base 모델이 표준이었고, 정형화된 이메일 초안 같은 자동완성에는 쓸 만했지만 대화는 어려웠습니다.
2단계 post-training: 비서라는 인격과 멈춤을 가르치기
base 모델을 쓸 만한 비서로 바꾸는 것이 post-training, 그 가운데 supervised fine-tuning(SFT, 지도 미세조정)입니다. 사람 작업자와 합성 pipeline이 만든 수만에서 수십만 개(예로 약 10만 개)의 대화 예시를 학습시키는데, 각 비서 답변은 명시적인 stop token(종료 token)으로 끝납니다. 이 과정을 거치면 모델은 일관된 비서 persona를 갖고, 설명이 끝나면 생성을 멈추고, 대화의 경계를 지킵니다. Qwen2-0.5B-Instruct에 "하늘은 왜 파란가"를 묻자 과학적 설명을 내놓고 깨끗하게 멈춥니다. Hugging Face의 AutoTokenizer와 apply_chat_template을 쓰면 메시지를 모델이 요구하는 정확한 구분 token으로 자동으로 감싸 주며, tokenize=False로 출력해 보면 "당신은 Alibaba Cloud가 만든 Qwen"이라는 기본 system 지시문이 앞에 붙어 있는 것을 확인할 수 있습니다.
이 실험은 전부 무료로 재현할 수 있습니다. 유료 구독 없이 NVIDIA T4 GPU가 붙은 기본 Google Colab 환경에서 공개 weight를 내려받아 돌리면 됩니다.
3단계 reasoning: 답하기 전에 생각할 token을 쓰게 하기
그런데 instruct 모델에는 결정적 약점이 있습니다. 여러 단계 계산이 필요한 문제를 받으면 계산 없이 곧바로 정답 token을 찍어 버립니다. "398 × 923 + 2901은?"이라는 질문에 instruct 모델은 자신 있게 37546이라고 답했는데, 실제 답 370,255와는 자릿수부터 다릅니다. 반면 비서 응답을 "Let's think step by step"으로 미리 채워 두면 모델은 398 × 923 = 367,354를 먼저 구하고 2,901을 더해 370,255에 도달합니다. 다만 같은 방식으로 여러 번 돌리면 370,845처럼 비슷하지만 틀린 값이 나오는 경우도 있어, 단계적 사고가 정확도를 크게 높이긴 하지만 오류를 완전히 없애지는 못합니다.
"Let's think step by step"이라는 prompt 기법은 ChatGPT 출시 이후에야 공개적으로 알려졌고, 돌아보면 당연해 보이는 이 발견이 OpenAI o1 같은 reasoning(추론) 중심 모델로 이어졌습니다.
RL: 모델이 스스로 사고 패턴을 찾아내다
왜 모델은 처음부터 단계적으로 생각하지 못했을까요. 인터넷에는 사람이 생각한 결과물, 즉 완성된 블로그 글과 완성된 코드만 있고, 그 결과물에 이르기까지의 시행착오와 중간 사고 과정은 거의 없기 때문입니다. 완성된 코드 조각만 보고 코딩을 배우는 것과, 엔지니어가 실패한 초안을 고치고 디버깅하는 과정을 모두 지켜보며 배우는 것의 차이와 같습니다. 사람의 사고 흔적을 흉내 내게 해도 모델은 문제를 푸는 대신 사람의 말투를 따라 하는 쪽으로 배우기 쉽습니다. 돌파구는 RL이었습니다. 모델이 직접 시도하고 틀리고 고치는 과정에서 사고 패턴을 스스로 발견하게 한 것입니다. OpenAI o1이 이 패러다임을 처음 공개적으로 보여 주며 ARC(Abstraction and Reasoning Corpus) 같은 benchmark(성능 평가 기준)와 복잡한 코딩에서 큰 진전을 이루고 hallucination(사실이 아닌 내용을 그럴듯하게 생성하는 현상)도 줄였습니다. 그 내부 기법은 DeepSeek가 DeepSeek-R1 기술 보고서를 공개하면서 널리 알려졌습니다.
가장 단순한 방법은 rejection sampling(기각 샘플링)입니다. 한 문제에 대해 모델이 100개의 단계별 풀이를 생성하게 하고, 맞은 것만 학습 데이터에 넣고 틀린 것은 버립니다. 하지만 이 방식에는 두 가지 약점이 있습니다. 틀린 시도에 담긴 학습 신호를 통째로 버리고, 맞은 풀이 안에 섞여 있는 무의미한 군더더기 token까지 똑같이 강화합니다.
DeepSeek-R1이 쓴 GRPO(Group Relative Policy Optimization, 그룹 상대 정책 최적화)는 이를 보완합니다.
| 단계 | 내용 |
|---|---|
| 1. 샘플링 | 한 문제에 대해 수십 개(예로 30개나 100개)의 풀이를 생성 |
| 2. 채점 | 각 풀이를 형식 준수와 정답 여부로 채점(-1~+1) |
| 3. 상대 비교 | 각 점수에서 그룹 평균을 빼 advantage(상대 이점)를 계산 |
| 4. 조정 | 평균보다 나은 풀이의 token 확률은 올리고, 못한 풀이의 token 확률은 내림 |
이렇게 하면 틀린 시도도 학습 신호가 되고, 모든 풀이에 공통으로 섞인 잡음은 평균과 함께 상쇄됩니다.
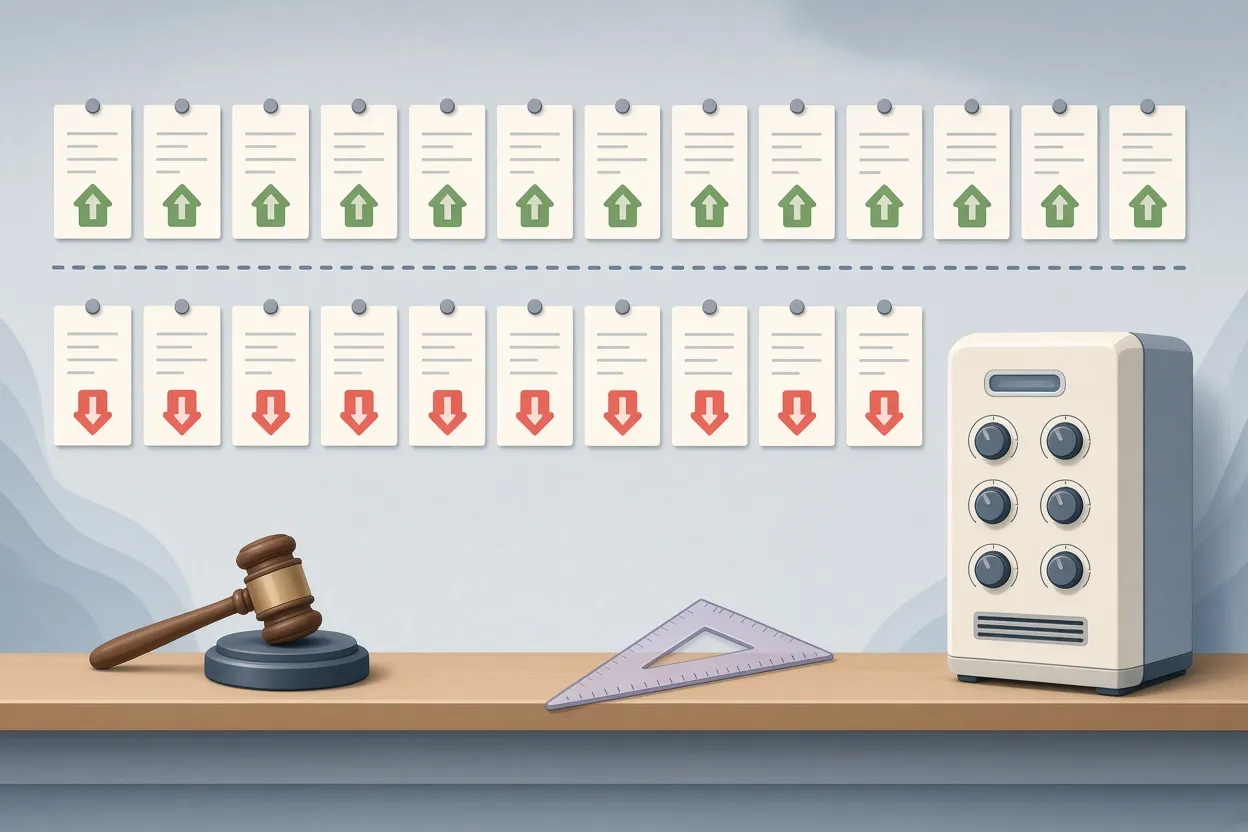
▲ GRPO의 상대 평가 방식
GRPO는 post-training 단계에서 이뤄지며, on-policy(모델 자신의 현재 정책이 생성한 데이터로만 학습) 방식이라는 점이 중요합니다. 모델이 스스로 만든 사고 흔적으로 학습하면 이미 갖고 있는 회로를 다듬는 셈이어서 weight가 크게 흔들리지 않습니다. 반대로 외부 사람의 추론 스타일을 억지로 배우게 하면 조정되지 않은 gradient 업데이트가 기존의 폭넓은 능력을 깎아 내고 catastrophic forgetting(치명적 망각)을 일으킬 위험이 있습니다. 정답을 자동으로 검증할 수 있는 환경만 갖추면, 이 방식으로 모델은 핵심 지식을 거의 잃지 않으면서 어려운 benchmark 점수를 꾸준히 끌어올릴 수 있습니다. fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법)에는 여전히 약간의 성능 저하가 따르지만, on-policy RL이 SFT보다 그 저하를 크게 줄인다는 것이 연구자의 평가입니다.
왜 세 단계를 하나로 합치지 않는가
처음부터 RL을 쓰거나 pre-training과 post-training을 하나로 합치면 안 되는지 궁금해질 수 있습니다. 두 단계를 합치려는 연구가 진행 중이긴 하지만, 현재 분리되어 있는 이유는 분명합니다. pre-training은 인터넷 데이터의 폭넓은 분포 위에서 다음 token 예측기를 만드는 과정이고, post-training은 그 위에 비서라는 persona, 말하자면 '자아'를 심어 소통 방식과 행동의 경계를 정하는 과정입니다. 모델은 학습하는 데이터의 스타일을 그대로 닮기 때문에, 이미 비서가 된 모델에 가공하지 않은 코드 저장소 같은 원시 데이터를 대량으로 다시 학습시키면 persona drift(인격 이탈)가 일어나 비서가 아니라 코드처럼 응답하기 시작합니다. 단계를 나누는 것은 이런 행동 붕괴를 막는 장치입니다.
성능 차이를 읽는 틀과 독자가 할 일
이 세 단계를 알면 모델 간 차이를 다음처럼 읽을 수 있습니다. 아래 표는 위 설명을 바탕으로 한 필자의 정리입니다.
| 단계 | 결정되는 것 | 사용자가 체감하는 지점 |
|---|---|---|
| pre-training | 세상 지식의 폭, 언어와 코드의 통계적 패턴 | 아는 것이 많은가, 다양한 언어와 분야를 다루는가 |
| post-training(SFT) | 비서 persona, 형식, 멈출 때, 대화 경계 | 답이 깔끔하게 끝나는가, 말투가 일관적인가 |
| RL(GRPO 등) | 단계적 사고, 검증 가능한 문제의 정답률 | 수학, 코딩, 복잡한 추론에서 틀리지 않는가 |
base 모델이 지어내는 인용문과 instruct 모델이 찍어 버린 37546은 각각 "pre-training만으로는 진실과 도움을 보장할 수 없다", "SFT만으로는 생각할 시간을 확보할 수 없다"는 한계를 보여 줍니다. 어떤 모델이 복잡한 계산이나 코딩에서 두드러지게 강하다면 RL 단계에 투자가 집중됐다고 해석할 수 있고, 지식은 많은데 답을 깔끔하게 끊지 못한다면 post-training 쪽 문제일 가능성이 있다고 보입니다.
마지막으로 reasoning이 어디까지 갈 수 있는지에 대한 연구자의 관점이 있습니다. 다음 token 예측기는 사람이 쓴 데이터의 분포에 묶여 있어 새 지식을 발견할 수 없다는 비판에 대해, 연구자는 reasoning을 "있을 법하지 않지만 참이고 흥미로운 결론을 점점 더 있을 법하게 만드는 반복 과정"으로 정의합니다. Albert Einstein의 일반 상대성 이론도 처음부터 있을 법한 결론이 아니었고, 추상화와 연역을 여러 단계 거듭한 끝에 도달한 것이라는 비유입니다. 모델이 아직 세상을 바꾼 독립적 과학 발견을 내놓지는 못했지만, 사람이 풀지 못한 수학 문제를 이미 풀고 있으며 긴 사고 과정을 거듭할수록 새로운 과학 지식에 이르게 될 것이라는 전망입니다. 이는 확정된 사실이 아닌 연구자의 믿음임을 밝혀 둡니다.
독자가 바로 해 볼 수 있는 일은 다음과 같습니다.
- Google Colab 무료 환경에서 Qwen2-0.5B의 base와 Instruct 버전을 같은 prompt로 비교해 pre-training과 post-training의 차이를 직접 확인하기
- chat 형식을 문자열로 직접 이어 붙이지 말고 tokenizer.apply_chat_template(add_generation_prompt=True)를 쓰고, tokenize=False로 실제 token 순서를 출력해 점검하기
- 계산이나 논리가 필요한 질문에는 비서 응답을 "Let's think step by step"으로 미리 채워 단계적 사고를 유도하기
- 비서 persona가 완성된 모델을 가공하지 않은 원시 데이터로 fine-tuning하지 않기
- 표 형태 숫자 예측에는 LLM 대신 일반 신경망을 쓰기
- PyTorch 학습 루프를 처음 짤 때는 Claude나 ChatGPT에 코드를 한 줄씩 설명받으며 시작하고, 매 step마다 optimizer.zero_grad()를 loss.backward() 앞에 호출하기
연구자는 이 분야가 여전히 독학으로 충분히 익힐 수 있는 영역이라고 말합니다. 수식에 압도되기보다 직관적인 그림을 먼저 세우고, 흥미가 가는 세부 주제를 깊이 파고들라는 조언입니다. 학위보다 중요한 것은 기본 원리를 이해하고 직접 실험해 보는 꾸준함으로 보입니다.


