#GRPO
带有“GRPO”标签的文章1篇
标签文章
按从新到旧显示带有“GRPO”标签的文章。
AI性能
从预训练到GRPO:前沿大模型是如何炼成的
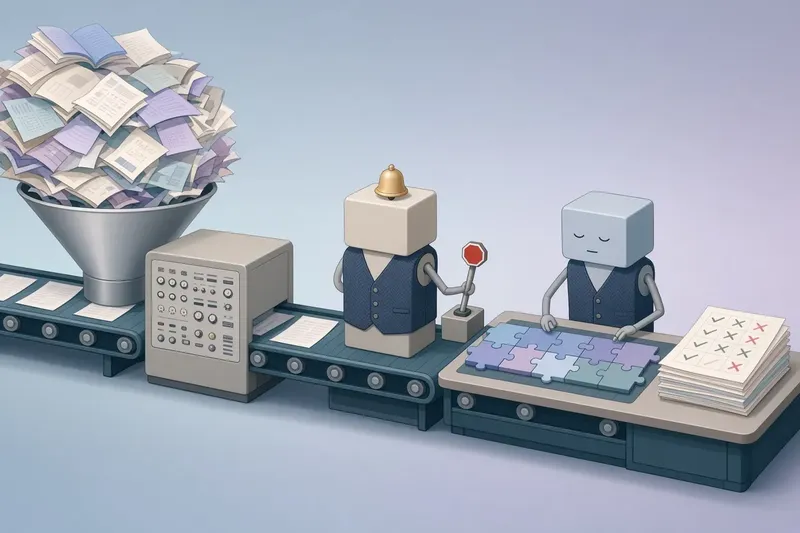
前沿大模型等于权重文件加一段Python程序,经三阶段训练成为助手。预训练只学续写文本,基础模型不知何时停止,也无助手角色。监督微调用数万到数十万条对话教会人格、格式与停止词元。GRPO按组内平均分给模型自己的尝试打分,失败样本也提供信号。用指令模型做多步任务时要留出思考空间,微调应避开原始语料。
带有“GRPO”标签的文章1篇
按从新到旧显示带有“GRPO”标签的文章。
前沿大模型等于权重文件加一段Python程序,经三阶段训练成为助手。预训练只学续写文本,基础模型不知何时停止,也无助手角色。监督微调用数万到数十万条对话教会人格、格式与停止词元。GRPO按组内平均分给模型自己的尝试打分,失败样本也提供信号。用指令模型做多步任务时要留出思考空间,微调应避开原始语料。