前沿语言模型如今写出的游戏和网页应用代码,读起来干净利落,截图也赏心悦目,这让传统的代码评分方式几乎失去了意义。Code Arena与Agent Arena背后的机构Arena发布了一项研究,提出了一种名为Interaction-as-a-Judge(交互即评判)的不同思路:让计算机操作智能体——一种像人一样点击、输入、浏览软件的AI系统——真正去玩生成的游戏、使用生成的网站,再由评判模型评估录制下来的会话,而不是直接评估原始代码。在Arena的实验中,这种方法让所有受测评判模型与人类偏好的一致性都有所提升,比只读代码的智能体发现了多得多的功能缺陷,使推理阶段的修复循环最多改善20%,还让在完全不查看源代码的情况下用强化学习训练代码生成器成为可能。
为什么读代码已经不管用了
用Code Arena上的一条真实提示词最容易说明问题。在这个平台上,用户让两个相互竞争的模型构建同一个东西,然后投票选出胜者。有位用户要求做一个Minecraft克隆版。这个请求隐含了几项功能需求:四处移动、旋转镜头、破坏方块、放置物品。
并排对比,两个模型的JavaScript和WebGL代码看起来几乎可以互换。两者都用同样的偏航和俯仰数学实现镜头旋转,挖掘进度检查也大同小异。两者都没有明显的语法或逻辑错误。静态截图同样帮不上忙:两者都渲染出了逼真的体素地形,有树木、水面和天空。
只有亲自去玩这两个游戏,差别才显露出来。第一个版本里,移动正常,可以攻击僵尸,可以放置花朵,点击方块就能破坏。第二个版本里,移动起初正常,但旋转镜头后会变成令人迷失方向的第三人称视角,而且没有角色模型,点击方块也毫无反应。Code Arena上的人类投票与短暂试玩的结果一致,而代码和截图中没有任何东西能预示这一点。
这正是该研究的核心论点:当生成的代码在表面上一律胜任时,缺陷藏在运行时状态和交互循环里,读代码的人无法在脑中模拟出来。人类靠试玩找到它们,但雇人去玩每一个生成的应用,就抹掉了自动化LLM评判最初吸引人的成本优势。
流程如何运作
Interaction-as-a-Judge保留了自动化评判,但在产物和裁决之间插入了一个智能体。
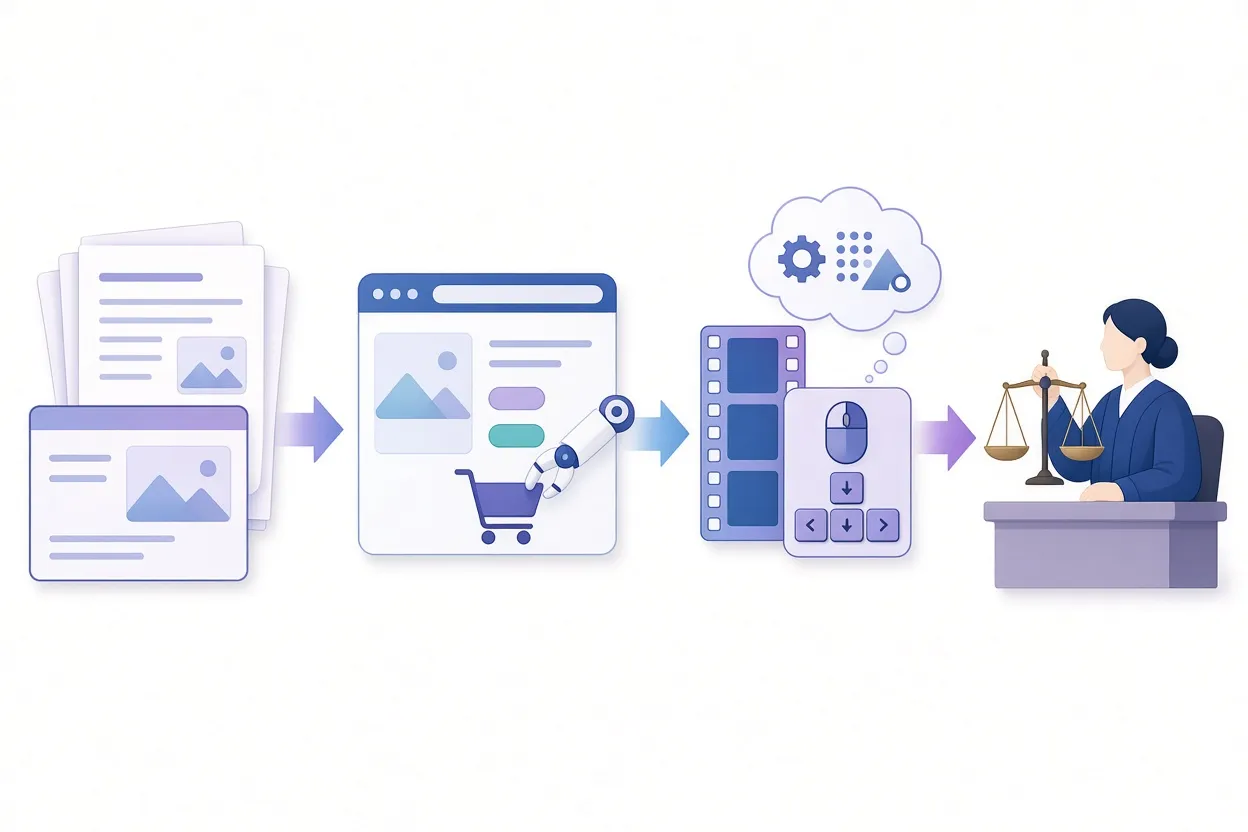
▲ 交互即评判的评估流程
- 生成的代码在隔离沙箱中被构建成可运行的应用。
- 计算机操作智能体与之交互,它只能看到截图,并发出鼠标在像素坐标上的点击、拖拽、按键和等待等原始输入。团队选择像素级操作而非DOM或无障碍树检查,一是为了简单,二是因为这种方式适用于任何应用。
- 会话被记录为交互轨迹:视频帧、动作序列,以及智能体逐步推理的文本。
- 评判模型读取轨迹(可选择同时读取代码),输出成对偏好或针对某项具体需求的通过/不通过裁决。
每次运行上限为30个交互步骤。对于实时游戏,一个定制的运行框架会在动作之间暂停游戏,每执行一个动作后推进500毫秒,这样速度较慢的模型不会因为推理延迟而吃亏。
研究测试了两类评判模型。第一类是现成的LLM,通过提示词让它比较两条轨迹;为了抵消LLM评判模型偏爱先出现选项的已知倾向,每次比较都按AB和BA两种顺序各跑一遍,再取分数平均。第二类是基于Qwen-3.5-9B训练的奖励模型,用视觉编码器处理帧,用文本嵌入处理代码、动作和推理,再由一个线性头输出标量分数。配对数据用Bradley-Terry损失训练,这是从"A胜B"比较中学习的标准公式。视觉编码器保持冻结,因为解冻后只增加了不稳定性,没有可测量的收益。
驱动智能体的三种方式
交互质量要花钱,所以研究比较了三种范式。
| 方法 | 运作方式 | 成本 | 弱点 |
|---|---|---|---|
| 迭代式 | 每一步都观察屏幕、推理、行动,循环往复 | 最高;每步一次模型调用 | 长轨迹开销大 |
| 一次性 | 读取代码和首张截图,预先规划所有动作,线性执行 | 低;一次模型调用 | 早期失误后无法补救 |
| 启发式 | 对交互元素随机或按规则点击,不用模型 | 零推理成本 | 在连续动作空间的游戏中失效 |
在一个名为Zazu的模拟外卖应用上的测试运行,让这些取舍变得具体。迭代式的GPT-5.6 Luna智能体登录、浏览分类、挑选菜品、填写结账信息并完成了下单。一次性智能体在计划早期漏点了一个按钮,最终停在空购物车页面,把剩余预算都耗在预先安排的等待上。启发式智能体随机点击,误把界面切换成了西班牙语,在账户表单中乱逛,始终没有进入主下单流程。即便如此,这次随机运行揭示的应用动态状态,仍远多于一张截图所能展示的,这正是启发式交互在普通网站上依然胜过静态基线的原因。
两个新基准
这项工作引入了两个数据集。
ArenaPreferences关注主观质量:哪个应用看起来更精致,或者用起来更吸引人。它包含自7月起从Code Arena真实用户那里收集的6,858场成对对战,每场都附有提示词、两个生成的应用、人类投票和自动化交互轨迹。七个类别分别是游戏(1,288)、品牌与营销(1,246)、内容创作工具(1,020)、数据与分析(949)、模拟(904)、基于参考的设计(753)和消费产品(698)。
ArenaCorrectness关注客观需求。它收录了412项需求,覆盖222个游戏版本,这些版本挖掘自Agent Arena上67个真实开发者会话。Agent Arena是一个浏览器内沙箱,开发者在其中反复向智能体下达提示词,构建和修改项目。由于开发者不会标注正确性,团队转而挖掘他们的抱怨。在一个Geometry Dash风格的平台跳跃游戏里,一位用户反馈第二个平台总是会让玩家死亡;LLM把它转化为需求"第二个平台不得杀死玩家",人类标注员加以核实,然后把这个有缺陷的版本与后来移除了尖刺的修复版本配成一对。因为人们大多在出问题时才会留言,所以323项需求描述的是故障状态,89项描述的是正常状态。该数据集支持两项任务:需求验证(给定一项需求,这个版本是否通过?)和需求发现(在没有提示该找什么的情况下,找出有缺陷的需求)。
结果:偏好评判
在6,858场对战、每次运行30个动作的设置下,更丰富的交互持续提升了与人类投票的一致性。
| 评判模型 | 仅代码 | 代码+截图 | 启发式 | 一次性 | 迭代式 |
|---|---|---|---|---|---|
| Gemini 3 Flash | 65.6% | 67.6% | 68.4% | 68.3% | 69.1% |
| GPT-5.6 Luna | 68.3% | 66.6% | 67.2% | 67.0% | 67.9% |
Gemini 3 Flash符合预期模式。GPT-5.6 Luna则出现了研究称为最奇怪发现之一的反常现象:在代码之外加上截图反而降低了准确率,交互轨迹也只是部分挽回。研究给出的解释是,OpenAI和Anthropic的前沿模型在训练时高度侧重代码,因此把对代码的心智模型映射到渲染后的视觉状态仍是弱项。需要注意的是,这种代码优先的优势只出现在偏好评判上,正确性评判中并未出现。
训练出的Qwen-3.5-9B奖励模型击败了两个LLM评判模型。在完整代码库(每个应用往往超过10万字符)上,它从仅用代码的69.7%提升到用迭代轨迹的70.8%;在奖励模型基准中,1个百分点的绝对提升被视为很大的差距。当代码上下文被削减到只剩App.tsx(主React组件文件)时,仅代码的准确率跌到68.2%,而基于交互的分数稳守在70.2%。
最具影响的结果出现在无代码设置中。只给迭代式交互轨迹、完全不给源代码的奖励模型达到了69.0%,高于所有基于代码和截图工作的前沿LLM评判模型,并接近69.7%的完整代码基线。这为源代码不可获得的软件打开了评估和训练的大门,研究以Call of Duty这类商业游戏为例,说明它能解锁的目标类型。
还有两项发现对从业者很重要。第一,用廉价启发式轨迹训练的奖励模型,在推理时改用迭代式轨迹后仍有提升,整体从67.9%升至68.9%,游戏类从70.8%升至73.2%,只有基于参考的设计一个类别出现倒退(从70.1%降到68.4%)。第二,收益集中在交互性高的地方:在Gemini 3 Flash上,迭代式交互在模拟类上比代码加截图高出2.8个百分点,在游戏类上高出2.7个百分点,但在数据类应用上为-0.3个百分点。
结果:发现功能缺陷
在ArenaCorrectness上,对照对象是一个不运行任何东西、只静态浏览代码库的代码智能体。两种方法在验证正常需求上表现相当(Luna为87.6%,Terra为86.5%,Sol则是91.0%对92.1%)。差距出现在有缺陷的需求上。
| 模型 | 代码智能体评判 | 交互评判 |
|---|---|---|
| GPT-5.6 Luna | 51.6% | 65.2% |
| GPT-5.6 Terra | 59.6% | 68.0% |
| GPT-5.6 Sol | 63.0% | 71.1% |
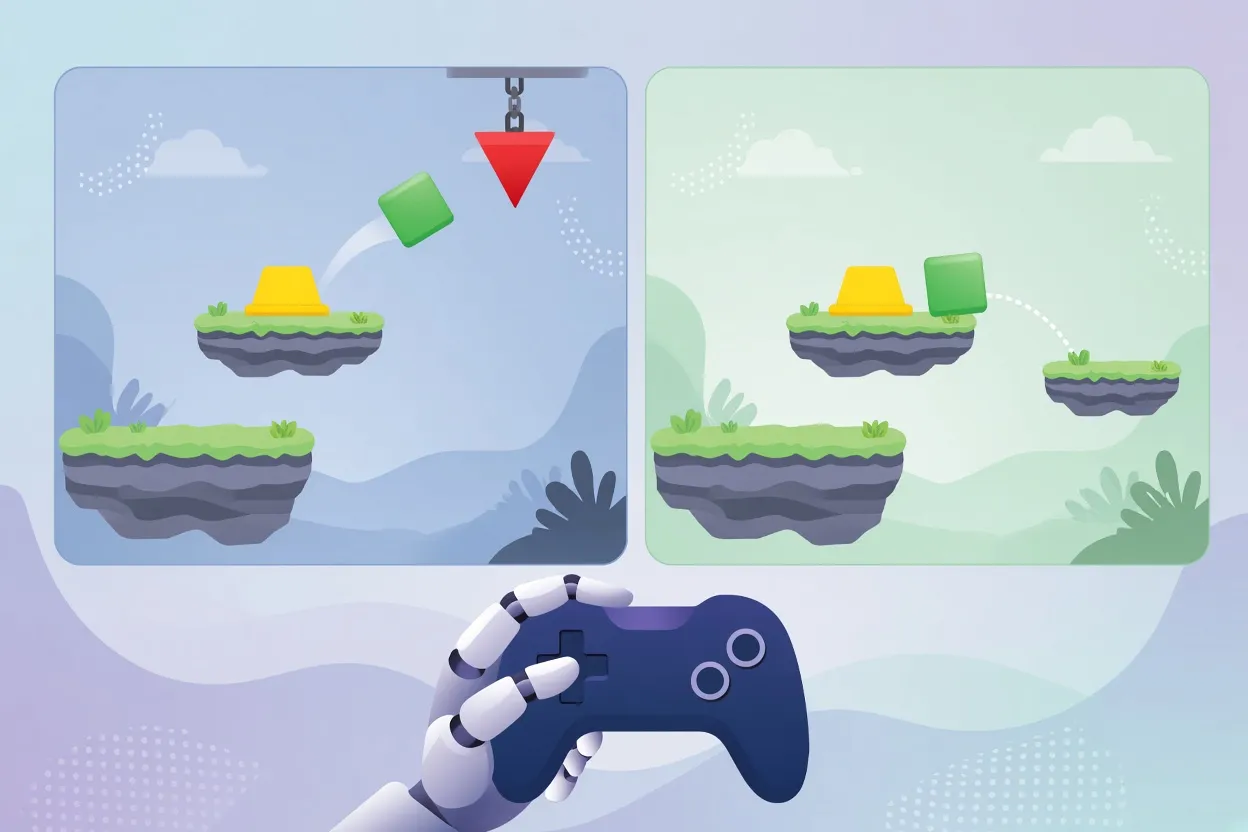
▲ 平台游戏需求的缺陷版与修复版
尖刺的例子解释了原因。放在弹跳板之后的障碍物是否真的无法躲避,取决于运行时的物理表现;读关卡数据很少能给出定论,而一次试玩就能。准确率还随三个层级的模型能力同步提升,研究将此视为后续几代模型验证效果会更好的信号。
需求发现依然困难。在没有清单的情况下诊断一个有缺陷的游戏并生成候选需求,召回率最高只到28%(Sol结合交互;用代码智能体为25%),Luna为17%对14%,Terra为15%对17%。研究把它列为一个开放问题。
用评判模型构建更好的软件
除了评分之外,团队还测试了交互反馈能否改善生成。
在推理阶段的修复循环中,GPT-5.6 Luna既是修复智能体也是自己的验证者,更强的GPT-5.6 Sol担任外部裁判。五轮迭代下来,交互验证的循环第一轮修复了63.5%的需求,第五轮达到75.5%;当Sol以交互方式评判时,代码智能体循环的数字是从49.8%升到55.4%。当Sol改为以代码评判时,两者分别是69.7%到77.4%与57.9%到63.8%,所以无论裁判用哪种方式衡量,领先优势都保持住了。
这个循环还抑制了夸大其词。Luna在交互自我验证下认为自己修好了81.7%的问题,在代码自我验证下为75.9%。对照Sol的交互检查,代码智能体循环夸报了20.4个百分点,交互循环夸报了6.2个百分点;对照Sol的代码检查,差距分别为12.1和4.3个百分点。测试真实行为似乎让模型更难说服自己缺陷已经消失。
在训练阶段的应用上,团队用DAPO(Direct Alignment and Preference Optimization)更新,对一个Qwen 2.5 9B生成器进行强化学习。每次rollout都被构建成网站,由启发式智能体操作(完整的视觉智能体在训练规模下太慢也太贵,实验也仅限于非游戏网站),再由交互奖励模型打分,反馈为策略更新。由于这个小型生成器经常产生无法构建的代码,超出了奖励模型的训练分布,团队加入了一个简单的构建失败负向惩罚,而不是重新训练奖励模型。
在35个训练步中,代码奖励模型和交互奖励模型都稳步学习,收益在两个方向上都能迁移。但结构性结果差异鲜明:
- 代码奖励模型表现出强烈的长度偏好;到第35步,生成的应用膨胀到超过6万字符。
- 交互奖励模型将平均代码长度从约4.5万字符压到2.5万字符以下,总体少生成了35.7%的代码。
- 构建失败率相对代码奖励模型下降了7.2个百分点。
- 在Arena内部的自动评分标准评估中,交互训练的策略相对基础模型胜率提升6.72分,代码训练的策略为6.14分,按Arena的校准,这相当于排行榜大约跃升60到70分。
从中可以得到什么
研究提出的论点直截了当:当生成的代码看起来一律很好时,区分能用的软件和坏掉的软件,唯一可靠的办法就是运行并使用它,而计算机操作智能体现在已经有能力大规模做到这一点。来自这一组实验的证据,支持评估或训练编程智能体的团队采取以下几项实际行动:
- 不再依赖代码审查和截图比对来给交互式应用评分;在沙箱中运行它们并录制会话。
- 预算允许时使用迭代式智能体,但训练数据可以收集廉价的启发式轨迹,因为在弱探索上训练的奖励模型在推理时能迁移到更强的智能体。
- 把随机探索限制在按钮、输入框等交互元素上,并为实时游戏加上暂停-推进的运行框架。
- 从开发会话中挖掘用户的缺陷反馈,整理成缺陷版与修复版配对的测试用例,无需人工标注即可构建正确性基准。
- 在自我修复循环中优先采用基于交互的验证,以限制对成功的虚假声称。
- 随着计算机操作智能体不断进步,可以预期这种方法会自行改善,而最大的回报将出现在游戏和模拟中,而不是静态数据页面。
局限同样清楚。交互会增加延迟,在数万场对战中代价高昂;完整的视觉智能体对大规模强化学习rollout来说仍然太慢;在没有清单的情况下发现未知缺陷,召回率上限仍停在28%。即便如此,把奖励信号与源代码解耦是最可能产生长期影响的部分,因为它让模型能够从那些谁也拿不出源代码的软件中学习。


