최신 frontier 모델(가장 성능이 높은 최신 모델)이 짠 게임 코드는 언뜻 봐서는 흠잡을 데가 없습니다. 문법 오류도, 눈에 띄는 논리 실수도 거의 없고, 스크린샷을 찍어 보면 그럴듯한 화면이 나옵니다. 그런데 실제로 키를 눌러 움직여 보면 카메라 시점이 어긋나거나 블록이 깨지지 않는 일이 생깁니다. Arena 연구진은 이 간극을 메우기 위해 computer-use agent(화면을 보고 마우스와 키보드를 직접 조작하는 AI agent)에게 생성된 게임과 웹사이트를 직접 플레이하게 하고, 그 기록을 바탕으로 품질을 판정하는 'Interaction-as-a-Judge' 방식을 제안했습니다. 6,858건의 실제 사용자 선호 데이터에서 코드와 스크린샷만 본 판정보다 사람의 판단에 더 가까웠고, 고장 난 기능을 찾아내는 정확도도 크게 올랐습니다. 더 나아가 이 방식은 코드를 고치는 반복 루프의 효율을 최대 20% 높였고, 강화 학습의 보상 신호로 쓰여 더 짧고 빌드 실패가 적은 코드를 만들어 냈습니다.
코드도 스크린샷도 똑같아 보이는 두 게임
Code Arena에서 한 사용자가 두 모델에게 Minecraft 클론을 만들어 달라고 요청한 사례가 문제를 잘 보여 줍니다. 이동, 카메라 회전, 블록 부수기, 블록이나 아이템 놓기가 암묵적 요구사항입니다. 두 모델이 생성한 JavaScript/WebGL 코드를 나란히 놓고 보면 카메라의 yaw/pitch 회전 계산이나 채굴 진행도 계산 로직이 거의 비슷합니다. 스크린샷도 마찬가지입니다. 양쪽 모두 나무와 물, 하늘이 있는 복셀 지형을 그려 내 구분이 되지 않습니다.
차이는 플레이해 봐야 드러납니다. A안은 이동이 부드럽고, 좀비를 공격할 수 있고, 꽃을 놓을 수 있고, 클릭하면 블록이 깨집니다. B안은 처음에는 이동이 되는 듯하지만 카메라를 돌리면 캐릭터 모델이 사라진 채 어지러운 3인칭 시점으로 바뀌고, 블록을 클릭해도 부서지지 않습니다. 실제 Code Arena의 사용자 투표도 A안을 선택했습니다. frontier 모델이 코드를 워낙 능숙하게 쓰기 때문에 이제 결함은 세부 동작에 숨어 있고, 정적인 결과물만으로는 찾기 어렵다는 것이 연구진의 진단입니다.
사람 대신 agent가 플레이하고, 그 기록을 판정한다
사람이 생성된 앱을 하나하나 플레이해 평가하면 정확하지만 비용이 너무 커서 LLM-as-a-judge(LLM이 다른 모델의 결과물을 채점하는 방식)의 장점인 저비용이 사라집니다. Interaction-as-a-Judge는 그 자리를 computer-use agent로 대체합니다. 흐름은 다음과 같습니다.
- 생성된 코드를 실행해 실제로 동작하는 앱으로 띄웁니다.
- computer-use agent가 화면을 보며 클릭하고 입력하고 키를 눌러 앱을 탐색합니다.
- 그 과정에서 세션의 녹화 영상, 마우스·키보드 동작 순서, agent가 단계마다 적은 추론 텍스트를 묶은 interaction trace(상호작용 기록)가 만들어집니다.
- 이 기록을 LLM judge나 학습된 reward model(결과물에 점수를 매기도록 학습한 모델)이 받아 선호나 정답 여부를 판정합니다.
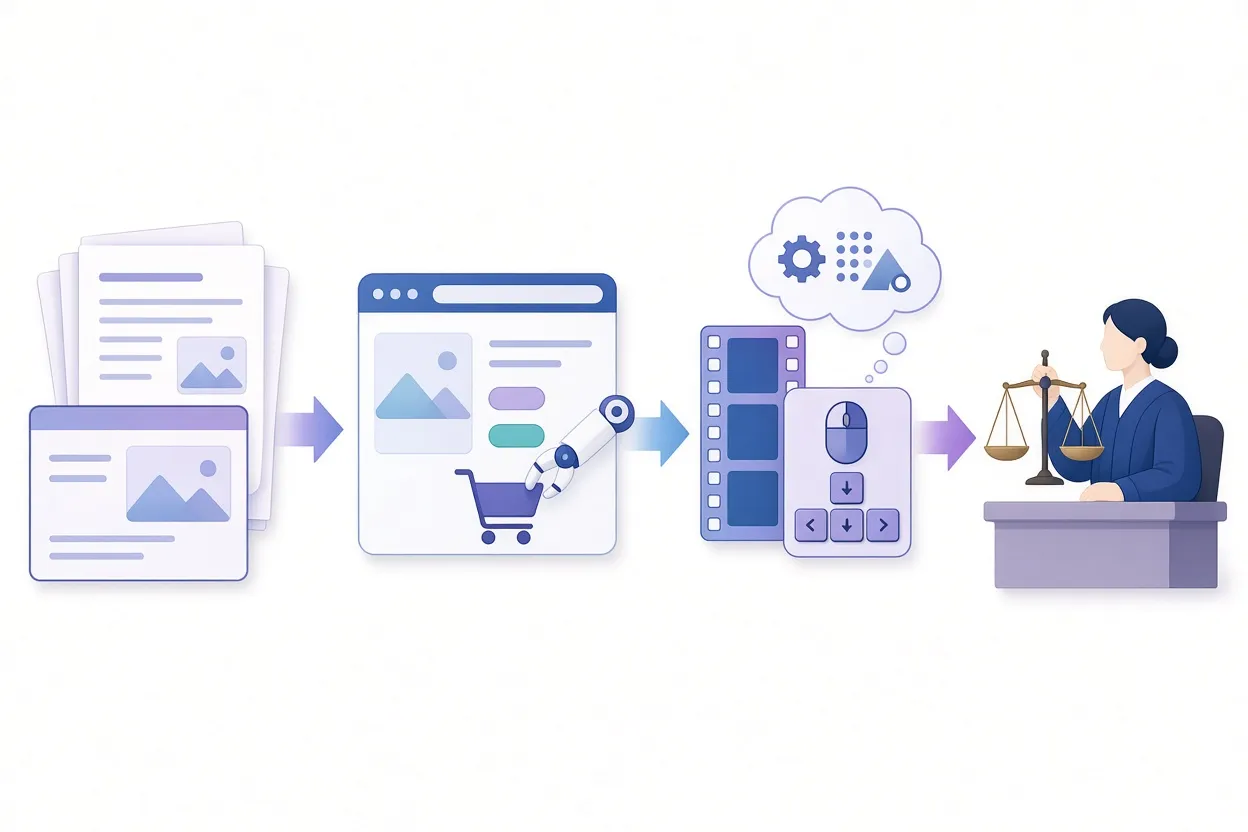
▲ 상호작용 기록 기반 평가 흐름
LLM judge를 쓸 때는 두 결과물의 순서를 AB와 BA로 바꿔 두 번 묻고 평균을 내서 위치 편향을 줄였습니다. reward model은 Qwen-3.5-9B 위에 vision encoder(이미지를 처리하는 부분)와 텍스트 embedding(텍스트를 수치 벡터로 바꾸는 모듈)을 붙이고, 마지막 층에 선형 레이어를 더해 점수 하나를 내도록 만든 뒤 Bradley-Terry 방식의 쌍대 비교 손실로 학습했습니다. vision encoder는 학습 중 고정했는데, 풀어서 학습해도 이득이 거의 없고 안정성만 떨어졌기 때문입니다.
두 종류의 데이터셋: 선호와 정답
연구진은 평가를 '선호'와 '정답' 두 축으로 나눴습니다. 선호는 어느 쪽이 더 완성도 있고 재미있어 보이느냐 같은 주관적 판단이고, 정답은 카메라 조작이나 충돌 판정이 명세대로 동작하느냐 같은 객관적 판단입니다.
ArenaPreferences는 Code Arena에서 7월부터 수집한 실제 사용자 쌍대 비교 6,858건으로 구성된 공개 데이터셋입니다. 각 항목에는 원래 prompt(사용자의 요청 문장), 두 모델이 만든 웹 앱, 사람의 투표, 그리고 자동 생성한 agent 상호작용 기록이 들어 있습니다.
| 분류 | 비교 건수 |
|---|---|
| 게임 | 1,288 |
| 브랜드·마케팅 | 1,246 |
| 콘텐츠 제작 도구 | 1,020 |
| 데이터·분석 | 949 |
| 시뮬레이션 | 904 |
| 참조 기반 디자인 | 753 |
| 소비자 제품 | 698 |
ArenaCorrectness는 Agent Arena(개발자가 브라우저 안에서 agent에게 반복적으로 지시해 소프트웨어를 만드는 sandbox, 즉 격리된 실행 환경)의 실제 개발 세션 67개에서 캐낸 412개 요구사항과 222개 게임 버전으로 이루어져 있습니다. 개발자가 정답 라벨을 달아 주지는 않으므로, 연구진은 개발 중 나온 버그 불만을 요구사항으로 바꿨습니다. 예를 들어 Geometry Dash 스타일 플랫포머에서 "두 번째 발판에 올라가면 빨간 가시 때문에 항상 죽는다"는 불만이 있으면, LLM이 이를 "두 번째 발판은 플레이어를 죽이면 안 된다"는 요구사항으로 정리하고 사람이 검증합니다. 그리고 그 버그가 있는 버전과 agent가 가시를 제거한 이후 버전을 짝지어 실패 사례와 성공 사례를 함께 확보합니다. 사람들은 주로 고장 났을 때 불만을 말하기 때문에 412개 중 323개가 고장 상태, 89개가 정상 상태로 불균형합니다.
이 데이터셋으로 두 과제를 정의했습니다. 요구사항 검증은 요구사항을 주고 특정 버전이 통과인지 실패인지 판별하는 과제이고, 요구사항 발견은 요구사항을 알려 주지 않은 채 어떤 기능이 고장 났는지 스스로 찾아내는 과제입니다.
agent가 앱을 만지는 세 가지 방식
상호작용 기록을 만드는 방법은 세 가지를 비교했습니다.
| 방식 | 동작 | 장점 | 단점 |
|---|---|---|---|
| 반복형(iterative) | 매 단계 화면을 관찰하고 추론한 뒤 동작 하나를 출력, 반복 | 반응성이 높고 상황에 적응 | 단계마다 모델을 호출해 비용이 가장 큼 |
| 일괄형(one-shot) | 소스 코드와 첫 화면을 보고 동작 순서를 처음에 한 번에 계획 | token(모델이 처리하는 텍스트 단위) 비용이 크게 줄어듦 | 초반 실수를 바로잡지 못함 |
| 휴리스틱(heuristic) | 규칙이나 무작위로 동작 선택, 모델 호출 없음 | 빠르고 추론 비용 0 | 게임처럼 동작 공간이 넓으면 성능 급락 |
Zazu라는 음식 주문 데모 앱에서 세 방식의 차이가 선명하게 드러납니다. GPT-5.6 Luna를 반복형으로 쓰면 로그인, 식당 둘러보기, 메뉴 선택, 결제 정보 입력을 거쳐 주문을 완료합니다. 일괄형은 초반에 주문 버튼 클릭이 제대로 되지 않자 그 사실을 알지 못한 채 빈 장바구니 페이지까지 흘러가고, 미리 계획한 대기 명령만 소화하다 끝납니다. 휴리스틱은 무작위 클릭으로 로그인 화면을 지나다 인터페이스 언어를 스페인어로 바꾸는 등 예상 밖의 화면까지 들어가지만 본 기능인 음식 주문에는 도달하지 못합니다. 그래도 정적인 스크린샷 하나보다는 훨씬 많은 화면 상태를 드러낸다는 점이 눈에 띕니다. 일반 웹사이트에서는 버튼, 입력란, 체크박스 같은 상호작용 요소로 동작 공간을 좁힐 수 있어 무작위 방식도 꽤 쓸 만하지만, 카메라 각도와 이동이 연속적인 Minecraft류 게임에서는 크게 무너집니다.
실험은 공정한 비교를 위해 몇 가지 조건을 고정했습니다. agent의 동작은 좌표 클릭, 드래그, 키 입력, 대기 같은 기본 입력으로만 구성하고 DOM이나 접근성 트리는 쓰지 않았습니다. 한 번의 실행은 30단계로 제한했습니다. 실시간 게임에는 agent가 동작을 보낼 때마다 게임을 500ms씩만 진행시키고 그 사이에는 멈추는 harness(실행을 감싸는 보조 장치)를 붙여, 추론이 느린 모델이 반응 속도 때문에 불리해지지 않게 했습니다. 모든 실행은 격리된 sandbox 안에서 이뤄졌습니다.
결과: 상호작용이 더해질수록 사람 판단에 가까워진다
ArenaPreferences 6,858건에서 judge의 판정이 사람 투표와 얼마나 일치하는지 측정한 결과입니다.
| 판정자 | 코드만 | 코드+스크린샷 | 휴리스틱 | 일괄형 | 반복형 |
|---|---|---|---|---|---|
| Gemini 3 Flash | 65.6% | 67.6% | 68.4% | 68.3% | 69.1% |
| GPT-5.6 Luna | 68.3% | 66.6% | 67.2% | 67.0% | 67.9% |
| Qwen-3.5-9B RM(전체 코드) | 69.7% | - | - | - | 70.8% |
| Qwen-3.5-9B RM(App.tsx만) | 68.2% | - | - | - | 70.2% |
| Qwen-3.5-9B RM(코드 없음) | - | - | - | - | 69.0% |
Gemini 3 Flash는 코드만 볼 때 65.6%에서 반복형 상호작용 기록을 함께 볼 때 69.1%로 올랐고, 연구진은 이를 통계적으로 의미 있는 차이로 봅니다. 모든 판정자에서 반복형이 휴리스틱과 일괄형보다 높았는데, 이는 agent의 상호작용 품질이 좋아질수록 평가 품질도 함께 올라간다는 뜻입니다. 연구진은 외부에서 computer-use agent가 발전하면 이 평가 방식도 그대로 좋아진다는 점을 강조합니다.
GPT-5.6 Luna는 특이한 결과를 보였습니다. 코드만 봤을 때 68.3%로 가장 높았고, 스크린샷을 더하면 오히려 66.6%로 떨어졌습니다. 상호작용 단계를 늘리면 67.9%까지 회복되지만 코드만 본 결과를 넘지는 못합니다. 연구진은 OpenAI와 Anthropic의 frontier 모델이 코드 데이터에 집중해 학습된 탓에 코드로 세운 머릿속 모델과 실제 화면 렌더링을 연결하는 데 약점이 있는 것으로 해석합니다. 단, 이 코드 우위는 선호 판정에서만 나타나고 정답 검증에서는 성립하지 않습니다.
직접 학습한 reward model은 frontier LLM judge를 모두 앞섰습니다. 전체 코드와 반복형 기록을 함께 보면 70.8%에 이르는데, reward model benchmark에서 1%p 차이는 큰 폭이라는 설명입니다. 앱 하나의 코드가 10만 자를 넘는 경우가 많은데, React 앱의 핵심 파일인 App.tsx만 남기면 코드만 본 판정은 69.7%에서 68.2%로 떨어지지만 상호작용 기록이 있으면 70.2%로 0.5%p 정도만 빠집니다.
가장 주목할 결과는 코드를 전혀 주지 않고 반복형 상호작용 기록만으로 판정한 reward model이 69.0%를 기록했다는 점입니다. 전체 코드와 스크린샷을 본 Gemini 3 Flash나 GPT-5.6 Luna보다 높고, 전체 코드를 본 reward model(69.7%)에 근접합니다. 연구진은 이것이 Call of Duty 같은 상용 게임처럼 소스 코드에 접근할 수 없는 영역에서도 플레이 기록만으로 평가와 학습이 가능해진다는 뜻이라고 봅니다.
분류별로 보면 Gemini 3 Flash 기준으로 반복형 상호작용이 코드+스크린샷 대비 시뮬레이션에서 +2.8%p, 게임에서 +2.7%p, 소비자 앱에서 +2.4%p 올랐고, 데이터·분석 앱에서는 -0.3%p로 효과가 없었습니다. 동적인 앱일수록 직접 만져 보는 평가의 이득이 큽니다. 또 값싼 무작위 기록으로 reward model을 학습한 뒤 추론 시에만 반복형 기록을 쓰는 실험에서도 전체 일치율이 67.9%에서 68.9%로 올랐고 게임은 70.8%에서 73.2%로 올랐습니다. 참조 기반 디자인만 70.1%에서 68.4%로 떨어졌습니다. 학습 데이터는 싸게 모으고 추론에만 비싼 agent를 쓰는 전략이 통한다는 뜻입니다.
고장 난 기능 찾기: 검증은 잘하지만 발견은 아직
ArenaCorrectness에서는 코드를 읽어 판단하는 code-agent-as-a-judge와 Interaction-as-a-Judge를 GPT-5.6 Luna, Terra, Sol 세 등급에서 비교했습니다.
| 모델 | 정상 요구사항(코드 / 상호작용) | 고장 요구사항(코드 / 상호작용) |
|---|---|---|
| Luna | 87.6% / 87.6% | 51.6% / 65.2% |
| Terra | 86.5% / 86.5% | 59.6% / 68.0% |
| Sol | 91.0% / 92.1% | 63.0% / 71.1% |
정상인 기능을 정상이라고 확인하는 데는 두 방식의 차이가 거의 없습니다. 차이는 고장 난 기능을 찾을 때 나타납니다. Luna에서는 13.6%p, Sol에서도 8%p 넘게 상호작용 방식이 앞섭니다. 가시 때문에 캐릭터가 앞으로 나아갈 수 없는 게임을 코드만 읽고 알아내기는 어렵지만, 직접 플레이하면 곧바로 드러나는 식입니다. 코드 agent는 브라우저를 실행하지 않고 코드베이스만 정적으로 탐색하기 때문에 런타임 버그에 약하다는 것이 연구진의 설명입니다. 모델 등급이 올라갈수록 정확도가 함께 오르는 것도 확인됐습니다.
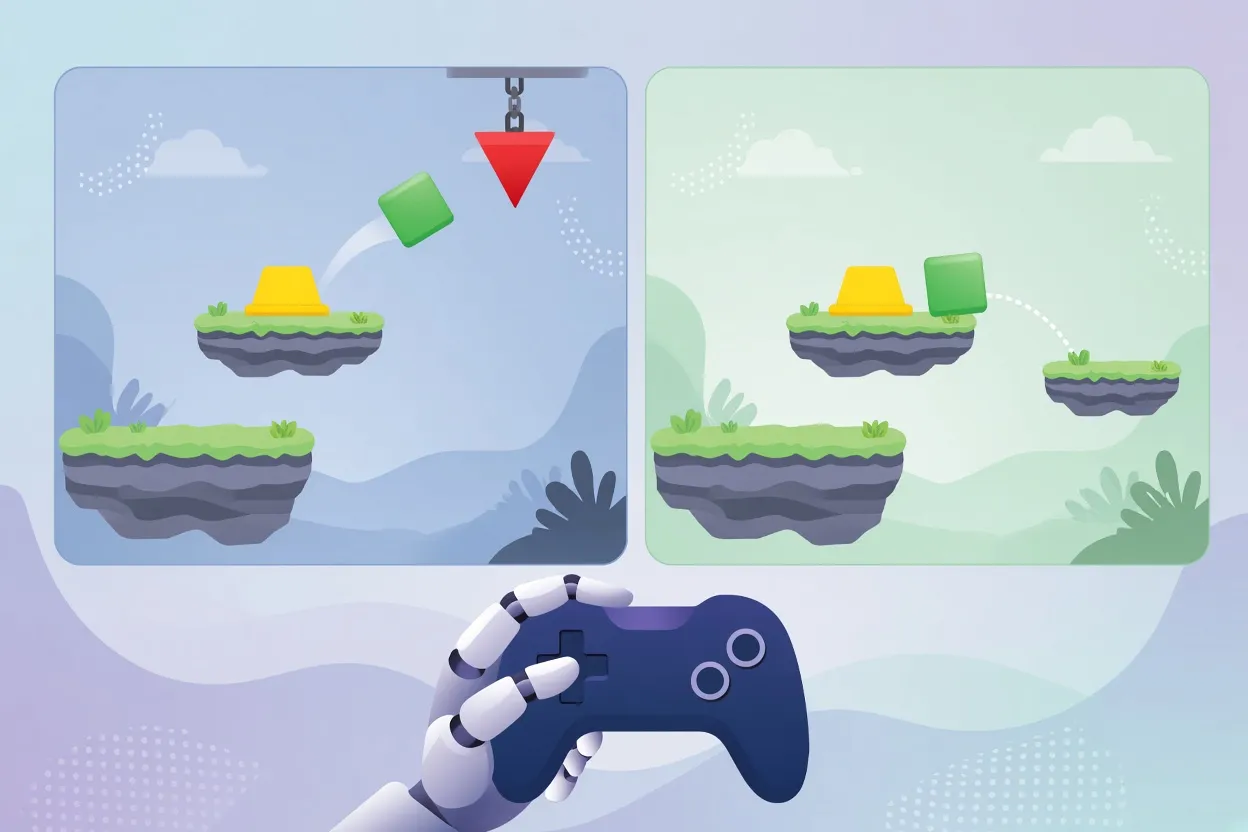
▲ 고장 버전과 수정 버전의 비교
반면 요구사항을 알려 주지 않고 고장 난 곳을 스스로 찾아내는 요구사항 발견 과제는 모든 모델에서 어려웠습니다. 고장 난 게임만 주고 수백에서 수천 개의 후보 요구사항을 생성하게 한 뒤 정답과 비교한 재현율은 Luna가 코드 14%·상호작용 17%, Terra가 코드 17%·상호작용 15%, Sol이 코드 25%·상호작용 28%에 그쳤습니다. 최고치가 28%이므로 이 영역은 아직 연구가 더 필요한 미해결 과제로 남아 있습니다.
평가를 넘어 생성에 쓰기: 수정 루프와 강화 학습
연구진은 이 평가 방식이 코드 생성 자체를 개선하는지도 확인했습니다. 첫째는 inference-time scaling(추론 시점에 계산을 더 써서 결과를 다듬는 방식)입니다. GPT-5.6 Luna가 고장 난 게임과 목표 요구사항을 보고 코드를 고치는 수리 agent 역할을, 같은 모델이 수정 결과를 확인하는 검증 agent 역할을 맡아 최대 5회 반복합니다. 외부 심판으로는 더 강한 GPT-5.6 Sol을 썼습니다.
Sol이 상호작용으로 검증했을 때 Interaction-as-a-Judge 루프는 1회차 63.5%에서 5회차 75.5%의 요구사항을 고쳤고, 코드 agent 검증 루프는 49.8%에서 55.4%에 머물렀습니다. 평가 편향을 의심해 Sol이 코드로 검증한 경우에도 77.4% 대 63.8%로 결과는 같은 방향이었습니다. 첫 회차부터 앞서고 반복할수록 격차가 커집니다.
더 흥미로운 지표는 '자기 검증 격차'입니다. Luna는 스스로 고쳤다고 믿는 비율이 상호작용 검증 시 81.7%, 코드 검증 시 75.9%였는데, Sol의 실제 판정과 비교하면 코드 agent 방식은 Sol 코드 검증 기준 12.1%p, Sol 상호작용 검증 기준 20.4%p를 과장했습니다. 반면 상호작용 방식의 과장은 각각 4.3%p, 6.2%p에 그쳤습니다. 실제 동작을 확인하기 때문에 고치지도 않은 버그를 고쳤다고 착각하는 일이 크게 줄어드는 것으로 보입니다.
둘째는 강화 학습입니다. 생성 모델이 코드를 만들면 이를 앱으로 렌더링하고, computer-use agent가 상호작용해 기록을 남기고, interaction reward model이 점수를 매겨 DAPO로 정책을 갱신하는 루프입니다. 코드 검증이 전혀 끼어들지 않습니다. 완전한 시각 기반 agent는 느리고 비싸서 이 실험에서는 휴리스틱·무작위 상호작용을 쓰고, 그 방식이 잘 통하는 비게임 웹사이트에 한정했습니다. 생성 모델은 Qwen 2.5 9B인데 빌드가 안 되는 코드를 자주 내놓아, reward model을 다시 학습하는 대신 빌드 실패에 단순한 음의 보상을 더했습니다.
35스텝 학습 결과는 다음과 같습니다.
- 빌드 보상만 준 기준 모델은 보상이 -1.6 근처까지 계속 떨어졌습니다.
- 코드 reward model로 학습하면 코드 보상이 -1.0에서 약 0.0으로, interaction reward model로 학습하면 상호작용 보상이 -1.0에서 약 -0.1로 올랐고, 서로 다른 보상 기준에서도 함께 개선됐습니다.
- 코드 reward model은 긴 코드를 좋은 코드로 여기는 길이 편향이 심해 35스텝 시점에 앱당 코드가 6만 자를 넘겼습니다. interaction reward model은 평균 코드 길이가 4만 5,000자에서 2만 5,000자 아래로 줄었고, 전체적으로 35.7% 적은 코드를 생성했습니다.
- 빌드 실패율은 interaction reward model이 코드 reward model보다 7.2%p 낮았습니다.
- Arena 내부 자동 rubric(채점 기준표) 평가에서 기준 모델 대비 승률 상승은 코드 reward model +6.14%p, interaction reward model +6.72%p였습니다. 연구진의 보정에 따르면 +6.72%p는 리더보드 60~70점 상승에 해당합니다.
정리: 평가의 기준을 '읽기'에서 '써 보기'로
이 연구가 말하는 핵심은 두 가지입니다. 첫째, agent가 직접 만져 본 기록을 판정에 쓰면 선호 평가와 정답 검증 모두에서 코드·스크린샷 기반 평가보다 사람 판단에 가까워지고, 그 이득은 게임과 시뮬레이션처럼 동적인 앱에서 가장 큽니다. 둘째, 같은 신호를 수정 루프와 강화 학습에 쓰면 과장된 자기 검증이 줄고, 코드 길이 편향과 빌드 실패가 줄어듭니다. 코드 없이도 평가와 학습이 가능하다는 점은 소스가 비공개인 소프트웨어까지 학습 재료로 끌어올 수 있다는 뜻이고, computer-use agent가 발전할수록 이 방식의 정확도도 함께 오를 것으로 연구진은 내다봅니다. 다만 요구사항 발견 재현율이 최고 28%에 머물고, 시각 기반 agent의 속도와 비용이 대규모 학습에는 아직 부담이라는 한계도 분명합니다.
AI 코딩 도구를 쓰거나 평가하는 독자라면 다음을 참고할 수 있습니다.
- 생성된 앱이나 게임을 평가할 때 코드 리뷰나 스크린샷 비교에서 멈추지 말고, sandbox에서 실제로 실행해 버튼, 키 입력, 물리 동작을 직접 눌러 보거나 agent에게 눌러 보게 합니다.
- LLM judge를 쓸 때는 두 후보의 순서를 바꿔 두 번 묻고 평균을 내서 위치 편향을 줄입니다.
- 웹 앱 테스트 자동화에서는 무작위 동작이라도 버튼과 입력란 같은 상호작용 요소로 동작 공간을 좁히면 추론 비용 없이 쓸 만한 탐색 기록을 얻을 수 있습니다.
- 실시간 게임을 agent로 테스트할 때는 동작마다 게임을 잠시 멈추고 일정 시간만 진행시키는 방식으로 추론 지연을 보정합니다.
- 모델이 "고쳤다"고 보고하면 코드 설명이 아니라 실제 동작으로 확인합니다. 자기 검증은 과장되기 쉽습니다.
- 사용자 불만 로그가 있다면 이를 요구사항으로 뒤집고 고장 버전과 수정 버전을 짝지어 자체 정답 테스트 세트를 만들 수 있습니다.


