最先端の大規模言語モデルが書くゲームやWebアプリのコードは、見た目にはきれいで、スクリーンショットも見栄えよく描画されます。そのため、コードを読んで採点する従来の方法はほとんど役に立たなくなりました。Code ArenaとAgent Arenaを運営するArenaは、「Interaction-as-a-Judge」と呼ぶ別のアプローチの研究を公開しました。人間と同じようにクリックや入力、画面遷移を行うAIシステムであるコンピュータ操作エージェントが、生成されたゲームを実際にプレイしたり生成されたWebサイトを実際に使ったりし、審判モデルは生のコードではなくその記録されたセッションを評価します。Arenaの実験では、この方法によってテストしたすべての審判モデルで人間の好みとの一致率が上がり、コードを読むだけのエージェントよりはるかに多くの動かない機能を見つけ、推論時の修復ループを最大20%改善し、ソースコードを一度も確認せずにコード生成モデルを強化学習で訓練できるようになりました。
コードを読むだけでは通用しなくなった理由
この問題は、Code Arenaの実際のプロンプトを見るとよく分かります。Code Arenaでは、ユーザーが競合する2つのモデルに同じものを作らせ、勝者に投票します。あるユーザーはMinecraftのクローンを求めました。この依頼には、移動、カメラの回転、ブロックの破壊、アイテムの設置といった一握りの機能要件が含まれています。
2つのモデルが書いたJavaScriptとWebGLのコードを並べると、ほとんど見分けがつきませんでした。どちらもカメラ回転に同じヨーとピッチの計算を実装し、採掘の進行チェックも似ていました。構文や論理の明らかな誤りはどちらにもありません。静的なスクリーンショットも役に立たず、両方とも木や水、空のある説得力のあるボクセル風景を描画していました。
違いが明らかになったのは、2つのゲームを実際にプレイしたときだけでした。1つ目の版では移動が機能し、ゾンビを攻撃でき、花を置くことができ、クリックでブロックが壊れました。2つ目の版では最初は移動できましたが、カメラを回転させるとキャラクターモデルのない三人称視点になって方向感覚を失い、ブロックをクリックしても何も起きませんでした。Code Arenaでの人間の投票は短いプレイセッションで分かった結果と一致しており、コードやスクリーンショットからは予測できないものでした。
これがこの研究の核となる主張です。生成コードが表面上は一様に有能に見えるとき、バグは実行時の状態や操作のループの中に潜んでおり、読むだけではシミュレーションできません。人間はプレイすることで見つけますが、生成されたすべてのアプリを人に遊んでもらうために報酬を払うと、そもそも自動化されたLLM審判を魅力的にしていたコスト面の利点が失われます。
パイプラインの仕組み
Interaction-as-a-Judgeは自動審判を残したまま、成果物と判定の間にエージェントを挟みます。
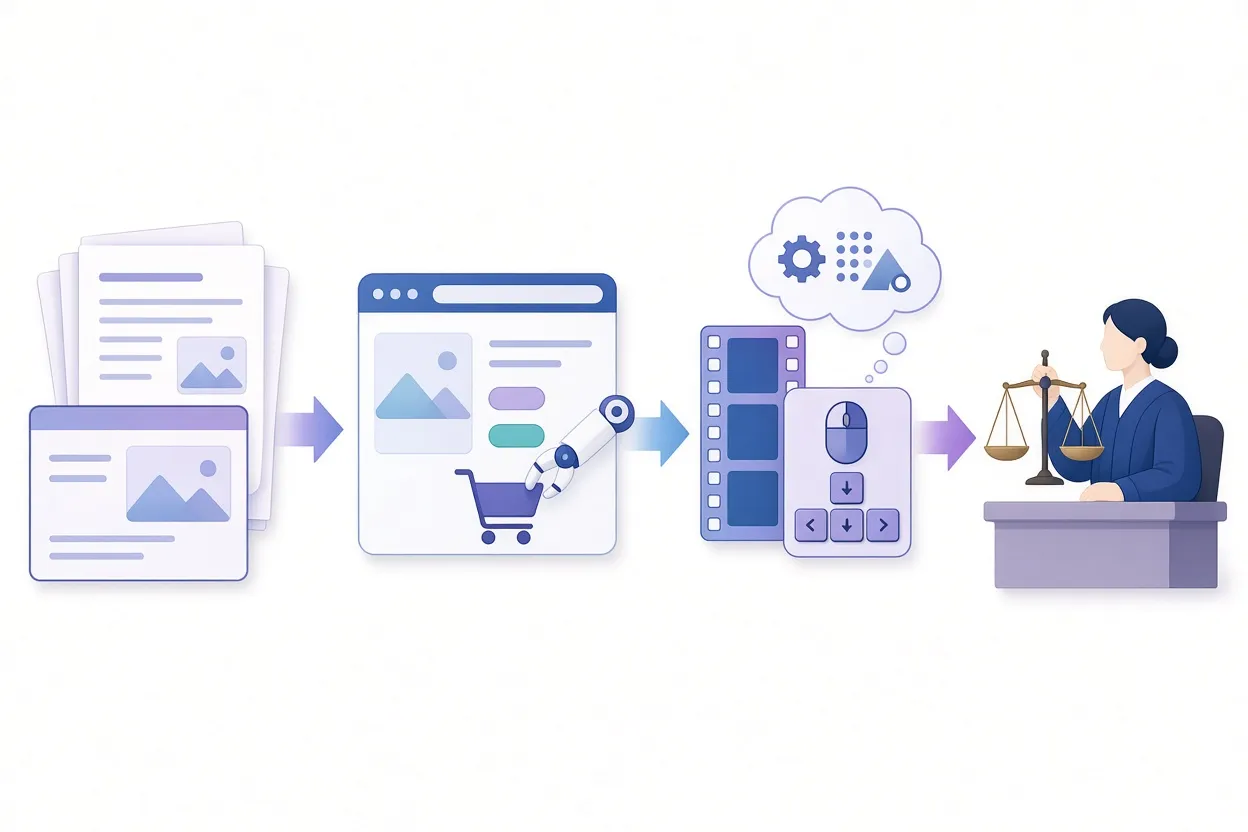
▲ Interaction-as-a-Judgeの流れ
- 生成されたコードを隔離されたサンドボックスでビルドし、動作するアプリにします。
- コンピュータ操作エージェントがそのアプリを操作します。エージェントはスクリーンショットだけを見て、ピクセル座標でのマウスクリック、ドラッグ、キー入力、待機といった原始的な入力を発行します。チームがDOMやアクセシビリティツリーの検査ではなくピクセル単位の操作を選んだのは、単純で、どんなアプリでも動くからです。
- セッションは操作トレースとして記録されます。動画フレーム、操作の順序、エージェントの段階的な推論テキストです。
- 審判がトレースを読み込み(必要に応じてコードも併せて)、ペアワイズの好みか、特定の要件に対する合否の判定を出力します。
毎回の実行は30操作ステップまでに制限されています。リアルタイムのゲームでは、専用のハーネスが操作の合間にゲームを一時停止し、各操作のあとに500ミリ秒ずつ進めるため、遅いモデルが推論の遅延で不利になることはありません。
テストされた審判は2種類です。1つ目は、2つのトレースを比較するようプロンプトで指示した既製のLLMです。LLM審判が先に提示された選択肢を好むというよく知られた傾向に対抗するため、すべての比較をABとBAの両方の順序で実行し、スコアを平均します。2つ目はQwen-3.5-9Bをベースに訓練した報酬モデルで、フレーム用のビジョンエンコーダー、コード・操作・推論用のテキスト埋め込み、スカラーのスコアを出力する線形ヘッドで構成されます。ペアは、「AがBに勝った」という比較から学習するための標準的な定式化であるBradley-Terry損失で訓練されます。ビジョンエンコーダーは凍結したままにしました。凍結を解除すると、測定できる改善がないまま不安定さが増したためです。
エージェントを動かす3つの方法
操作の質にはコストがかかるため、研究では3つのパラダイムを比較しています。
| 方式 | 仕組み | コスト | 弱点 |
|---|---|---|---|
| 反復型 | 画面を観察し、推論し、操作する、をステップごとに繰り返す | 最も高い。ステップごとにモデル呼び出しが必要 | 長いトレースでは高コスト |
| ワンショット型 | コードと最初のスクリーンショットを読み、すべての操作を事前に計画して順番に実行 | 低い。モデル呼び出しは1回 | 早い段階の見逃しから回復できない |
| ヒューリスティック型 | 操作可能な要素をランダムまたはルールに基づいてクリック。モデルは使わない | 推論コストはゼロ | 連続的な行動空間を持つゲームでは機能しない |
Zazuという模擬フードデリバリーアプリでのテスト実行を見ると、トレードオフが具体的に分かります。反復型のGPT-5.6 Lunaエージェントはログインし、カテゴリーを閲覧し、料理を選び、決済情報を入力して注文を完了しました。ワンショット型のエージェントは計画の早い段階でボタンを1つ見逃し、空のカートページにたどり着いたあと、残りの予算を事前に組まれた待機で浪費しました。ヒューリスティック型のエージェントはランダムにクリックし、誤ってインターフェースをスペイン語に切り替え、アカウント関連のフォームをさまよったまま、肝心の注文フローには一度も到達しませんでした。それでも、このランダムな実行は1枚のスクリーンショットよりはるかに多くのアプリの動的な状態を明らかにしました。ヒューリスティックな操作が通常のWebサイトでは静的なベースラインを上回る理由はここにあります。
2つの新しいベンチマーク
この研究では2つのデータセットを導入しています。
ArenaPreferencesは主観的な品質、つまりどちらのアプリがより洗練されて見えるか、より魅力的に感じられるかを扱います。7月以降に実際のCode Arenaユーザーから収集した6,858件のペアワイズの対戦が含まれ、それぞれにプロンプト、生成された2つのアプリ、人間の投票、自動化された操作トレースが付いています。カテゴリーは7つで、ゲーム(1,288)、ブランド・マーケティング(1,246)、コンテンツ制作ツール(1,020)、データ・分析(949)、シミュレーション(904)、参照ベースのデザイン(753)、消費者向け製品(698)です。
ArenaCorrectnessは客観的な要件を扱います。Agent Arena上の67件の実際の開発者セッションから採掘した222のゲームバージョンにわたる412の要件を収録しています。Agent Arenaはブラウザー内のサンドボックスで、開発者がエージェントに繰り返しプロンプトを出してプロジェクトを構築・修正します。開発者は正しさにラベルを付けないので、チームは開発者の不満を採掘しました。あるGeometry Dash風のプラットフォーマーでは、ユーザーが2番目の足場で必ずプレイヤーが死ぬと報告しました。LLMはこれを「2番目の足場はプレイヤーを殺してはならない」という要件に変換し、人間のアノテーターが検証し、壊れた版と、トゲが取り除かれた後の修正版をペアにしました。人は主に何かが失敗したときにコメントするため、323の要件は壊れた状態を、89の要件は正常に動く状態を記述しています。このデータセットは2つのタスクに対応します。要件の検証(要件が与えられたとき、この版は合格か)と、要件の発見(何を探すべきか教えられずに壊れた要件を見つける)です。
結果:好みの判定
1回の実行あたり30操作で6,858件の対戦を評価した結果、操作が豊かになるほど人間の投票との一致率は一貫して向上しました。
| 審判 | コードのみ | コード+スクリーンショット | ヒューリスティック | ワンショット | 反復 |
|---|---|---|---|---|---|
| Gemini 3 Flash | 65.6% | 67.6% | 68.4% | 68.3% | 69.1% |
| GPT-5.6 Luna | 68.3% | 66.6% | 67.2% | 67.0% | 67.9% |
Gemini 3 Flashは予想どおりのパターンです。GPT-5.6 Lunaには、研究が最も奇妙な発見の1つと述べる異常が見られました。コードにスクリーンショットを加えると精度が下がり、操作トレースでも部分的にしか回復しなかったのです。研究が示す解釈は、OpenAIとAnthropicの最先端モデルはコードを重視して訓練されているため、コードのメンタルモデルを描画された視覚状態に対応付けることが依然として弱点になっている、というものです。ただし注意点として、このコード優先の優位性は好みの判定でだけ現れ、正しさの判定では現れませんでした。
訓練したQwen-3.5-9B報酬モデルは両方のLLM審判を上回りました。アプリ1つあたり10万文字を超えることも多い完全なコードベースでは、コードのみの69.7%から反復型トレースありの70.8%に上昇しました。報酬モデルのベンチマークでは、1ポイントの絶対的な改善は大きな差とみなされます。コードの文脈をReactのメインコンポーネントファイルであるApp.tsxだけに削ると、コードのみの精度は68.2%に落ちた一方、操作ベースのスコアは70.2%を維持しました。
最も影響の大きい結果はコードなしの設定です。反復型の操作トレースだけを与え、ソースコードをまったく与えなかった報酬モデルは69.0%に達しました。これはコードとスクリーンショットから判定するあらゆる最先端LLM審判を上回り、完全なコードを使ったベースラインの69.7%に迫る数字です。これにより、ソースコードが入手できないソフトウェアの評価と訓練への道が開けます。この手法が対象にできる例として、Call of Dutyのような商用ゲームが挙げられています。
実務者にとって重要な発見がさらに2つあります。1つ目は、安価なヒューリスティックトレースで訓練した報酬モデルを推論時に反復型トレースに適用しても改善したことです。全体では67.9%から68.9%に、ゲームでは70.8%から73.2%に向上し、後退したのは参照ベースのデザイン(70.1%から68.4%)だけでした。2つ目は、改善が対話性の高い領域に集中していることです。Gemini 3 Flashでは、反復型の操作はコード+スクリーンショットをシミュレーションで2.8ポイント、ゲームで2.7ポイント上回りましたが、データ系アプリでは-0.3ポイントでした。
結果:壊れた機能の発見
ArenaCorrectnessでは、何も実行せずにリポジトリを静的に調べるコードエージェントと比較しました。正常に動く要件の検証では両方のアプローチがほぼ同等でした(Lunaで87.6%、Terraで86.5%、Solでは91.0%対92.1%)。差が出たのは壊れた要件です。
| モデル | Code Agent-as-a-Judge | Interaction-as-a-Judge |
|---|---|---|
| GPT-5.6 Luna | 51.6% | 65.2% |
| GPT-5.6 Terra | 59.6% | 68.0% |
| GPT-5.6 Sol | 63.0% | 71.1% |
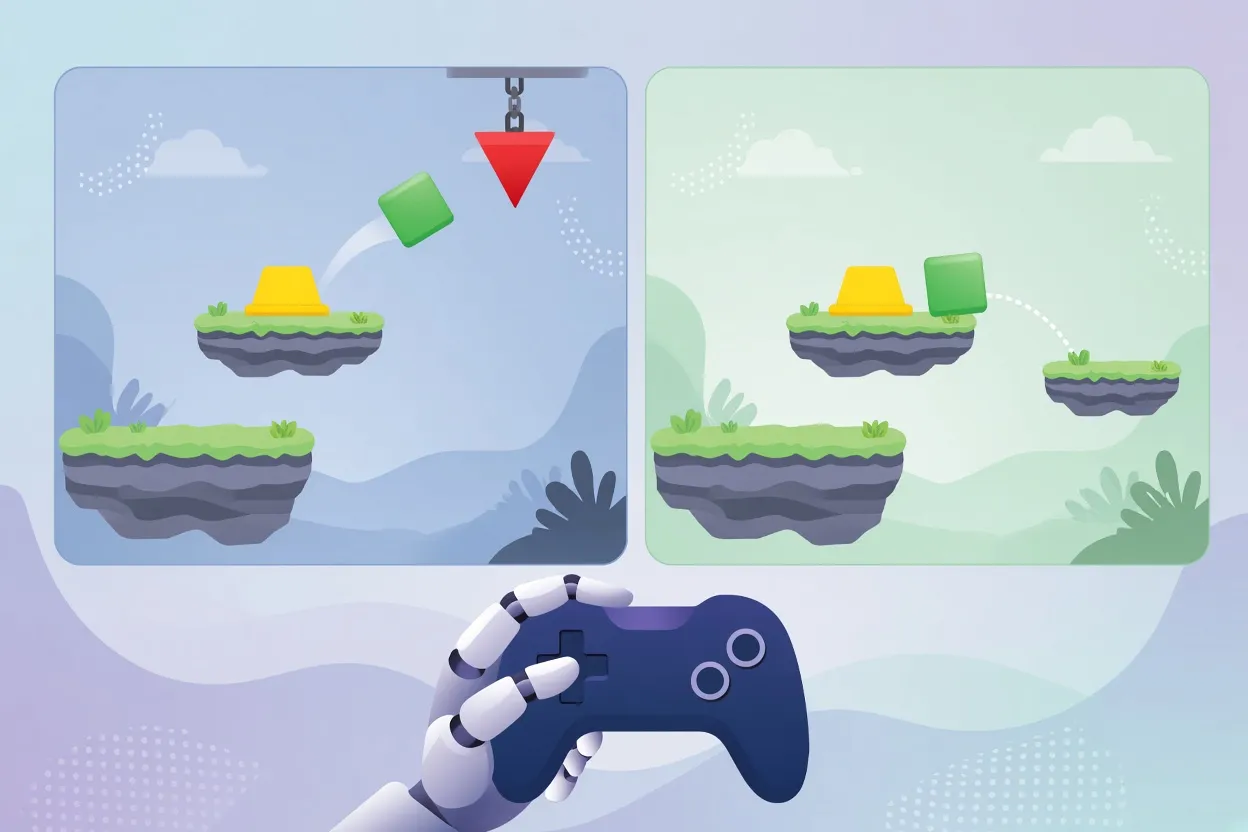
▲ プラットフォーマー要件の壊れた版と修正版
トゲの例がその理由を説明しています。バウンスパッドの直後に置かれた障害物が本当に避けられないかどうかは実行時の物理挙動で決まり、レベルデータを読んでも結論はほとんど出ませんが、1回プレイしてみれば分かります。精度は3つのティアすべてでモデルの能力に応じて向上しており、研究はこれを、今後の世代ではさらに検証がうまくなる兆しだと受け取っています。
要件の発見は依然として難しいままでした。チェックリストなしで壊れたゲームを診断し、候補となる要件を生成するよう求めたところ、再現率は操作ありのSolで最高の28%(コードエージェントでは25%)で、Lunaは17%対14%、Terraは15%対17%でした。研究はこれを未解決の問題として提示しています。
審判を使ってより良いソフトウェアを作る
採点にとどまらず、チームは操作のフィードバックが生成を改善するかどうかも検証しました。
推論時の修復ループでは、GPT-5.6 Lunaが修復エージェントと自己検証の両方を担い、より強力なGPT-5.6 Solが外部の審査役を務めました。5回の反復で、操作による検証を使うループは1回目で要件の63.5%を修正し、5回目までに75.5%に達しました。一方、コードエージェントのループは、Solが操作で判定した場合、49.8%から55.4%でした。Solがコードで判定した場合の数字は69.7%から77.4%に対して57.9%から63.8%で、審査役の測り方に関係なく優位は保たれました。
このループは過剰な申告も抑えました。Lunaは操作による自己検証では問題の81.7%を、コードによる自己検証では75.9%を修正したと信じていました。Solの操作チェックと比べると、コードエージェントのループは20.4ポイント過剰に申告し、操作ループは6.2ポイントでした。Solのコードチェックとの比較では、差は12.1ポイントと4.3ポイントでした。実際の挙動をテストすると、モデルがバグは消えたと自分を納得させるのがはるかに難しくなるようです。
訓練時の利用では、チームはQwen 2.5 9Bの生成モデルに対してDAPO(Direct Alignment and Preference Optimization)の更新で強化学習を実行しました。各ロールアウトはWebサイトとしてビルドされ、ヒューリスティックエージェントが操作し(完全な視覚エージェントは訓練規模では遅すぎて高コストで、実験はゲーム以外のWebサイトに限定されました)、操作報酬モデルがスコアを付け、ポリシー更新としてフィードバックされました。小さな生成モデルは報酬モデルの訓練分布の外にあるビルドできないコードをしばしば生成したため、報酬モデルを再訓練するのではなく、単純なビルド失敗のペナルティを加えました。
35の訓練ステップにわたり、コード報酬モデルと操作報酬モデルの両方が着実に学習し、改善は双方向に転移しました。構造的な結果は大きく異なりました。
- コード報酬モデルは強い長さバイアスを示し、生成されたアプリはステップ35までに60,000文字を超えて膨張しました。
- 操作報酬モデルは平均コード長を約45,000文字から25,000文字未満に押し下げ、全体で35.7%少ないコードを生成しました。
- ビルド失敗率はコード報酬モデルに比べて7.2ポイント低下しました。
- Arena内部の自動ルーブリック評価では、操作で訓練したポリシーはベースモデルに対して勝率が6.72ポイント上がり、コードで訓練したポリシーの6.14ポイントを上回りました。Arenaの較正では、これはリーダーボードでおよそ60から70ポイントの上昇に相当します。
この研究から何を学ぶか
研究の主張は明快です。生成コードが一様に良く見えるとき、動くソフトウェアと壊れたソフトウェアを見分ける唯一の確実な方法は実行して使うことであり、コンピュータ操作エージェントは今やそれを大規模に行える能力を備えています。この一連の実験から得られた証拠は、コーディングエージェントを評価または訓練するチームにとって、いくつかの実践的な動きを支持しています。
- 対話型アプリの採点にコードレビューやスクリーンショットの差分に頼るのをやめ、サンドボックスで実行してセッションを記録する。
- 予算が許すところでは反復型エージェントを使い、訓練には安価なヒューリスティックトレースを集める。弱い探索で訓練した報酬モデルが、推論時にはより強いエージェントに転移したためです。
- ランダムな探索はボタンや入力欄などの操作可能な要素に限定し、リアルタイムゲームには一時停止と進行のハーネスを加える。
- 開発セッションのユーザーのバグ報告を採掘し、壊れた版と修正版のペアのテストケースにして、手作業のラベル付けなしで正しさのベンチマークを構築する。
- 自己修復ループの中では操作ベースの検証を優先し、成功の誤った申告を抑える。
- コンピュータ操作エージェントの進歩に伴ってこのアプローチも自然に改善すると見込み、最大の効果は静的なデータページではなくゲームとシミュレーションで出ると期待する。
限界も同じく明確です。操作は遅延を加え、数万件の対戦では高コストになります。完全な視覚エージェントは大規模なRLロールアウトには依然として遅すぎ、チェックリストなしで未知のバグを発見する再現率は28%が上限です。それでも、報酬信号をソースコードから切り離したことは、長期的に最も重要になりそうな部分です。誰もコードを渡せないソフトウェアからモデルが学べるようになるからです。


