Anthropic于2026年11月9日发布了Claude Fable 5.2和Claude Mythos 5.2,新模型随即登上Artificial Analysis智能指数榜首,领先Claude Opus 5.5六分。榜单名次是一回事,模型能否在真实工作中物有所值是另一回事。本文先梳理官方公布的基准与成本数据,再把Fable 5.2放进Claude Code,完成五项普通的工作:一份城市出行规划的3D指南、一个篮球投篮模拟、一份本地AI服务器的硬件调研报告、一次在线课程网站的销售漏斗审查,以及一款面向折叠屏iPhone的原生应用。结果显示,亮眼的数字在策略型和软件开发工作中确实转化成了实际能力,但图形方面存在明显短板,还有几个值得警惕的成本陷阱。
发布内容的核心主张
Fable 5.2和Mythos 5.2共用同一个底层模型。Mythos 5.2保留了专门的网络安全与生物学能力,仅通过验证计划开放;Fable 5.2则对这些领域加装了安全防护,据Anthropic介绍,其不必要的拒答也比Fable 5.1更少。两款模型据称表达更清晰,输出生成速度比5.1一代最多快30%。
Fable 5.2现已成为Claude.ai和Claude Desktop的默认模型,推荐思考强度为"中等"。Anthropic将Opus 5.5定位为日常主力,建议把Fable 5.2和Mythos 5.2用于开放式技术难题,或作为编排者把较小的任务分派给Sonnet 5.5或Haiku 5.5。这是一次耐人寻味的反转:直到不久前还是产品线顶端的Opus 5.5,如今被定义成了较轻量的选项。
定价
| 模式 | 输入(每百万token) | 输出(每百万token) | 速度 |
|---|---|---|---|
| 标准 | $8 | $40 | 比Fable 5.1最多快30% |
| 快速模式 | $16 | $80 | token生成速度最高达2.5倍 |
在Artificial Analysis的单任务成本图上,Fable 5.2每项指数任务的加权平均成本约为$10,单任务开销高于Opus 5.5。需要注意的是,虽然该模型生成token的速度比Fable 5.1更快,但Artificial Analysis的数据显示其平均单任务耗时反而更长,原因似乎在于它在作答前进行了更深入的推理。
与Opus 5.5和GPT-6 Astra的基准对比
Anthropic的对比表显示,Fable 5.2在所有评测类别上都领先于Opus 5.5和OpenAI的GPT-6 Astra。
| 基准 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0(高强度) | 49.1% | 32.4% | 45.5% | 42.8% |
| FrontierSWE v2(智能体编程) | 69.9% | 56.3% | 62.3% | 65.5% |
| Terminal-Bench Science 0.1 | 74.6% | — | 68.1% | 66.5% |
| AA-Briefcase v1.1(数周跨度的知识工作) | 66.1% | — | 59.5% | 58.0% |
在超高强度下,Fable 5.2在FrontierCode 2.0上达到56.9%,仅略高于Fable 5.1在同一设置下的56.7%。该模型在带工具的Humanity's Last Exam上得分74.2%,在图表阅读测试Chartography上得分73.4%,在高强度下的Remote Labor Index上得分41.3%。AA-Briefcase值得专门说明:它衡量的是跨越数周的长程智能体知识工作,涉及财务、法律和运营材料,例如密集的电子表格、PDF和聊天记录,比起编程谜题更接近真实的办公室工作。
安全方面,不带防护的Mythos 5.2在CyScenarioBench上得分76.3%,而带防护的Fable 5.2为36.3%。在Anthropic内部的CVE重新发现基准中,模型需要找出1,629个已公开的历史漏洞,Mythos 5.2达到89.6%,比Opus 5.5高10.2%,比Mythos 5.1高14.4%。Anthropic还报告,Mythos 5.2夸大漏洞严重程度的情况大约每20次只出现1次,这对需要为补丁排定优先级、而不是追逐误报的防御方来说很重要。
要了解这个领域的变化有多快,可以在Artificial Analysis指数中筛选较早的模型:Claude Opus 5为44分,Kimi K1.3 Pro为46分,GLM 5.3 Max为32分。
思考强度设置:钱花在了哪里
这次发布中最有用的一张图,绘制了Fable 5.2、Opus 5.5、Mythos 5.1、GPT-6 Astra和Gemini 4 Carbon在不同思考强度下的FrontierCode 2.0准确率与单任务成本的关系。从低强度到高强度,分数稳步上升;再往上到超高或最高强度,成本急剧攀升,准确率却几乎不动。
▲ 思考强度越高,收益递减
由此可以得出两个实用结论。第一,高强度下的Fable 5.2与最高强度下的Opus 5.5成绩相当,而单任务成本大约减半。第二,对于智能体编程,高强度看来是合理的上限;超高和最高档位呈现出收益递减。在中等强度下,Fable 5.2完成困难任务所消耗的token也比Fable 5.1更少。
另一面是,强度控制已经变得难以追踪。Anthropic的"模型加强度"组合比ChatGPT的单一滑块更复杂,后者在Pro档位下默认选中GPT-6,GPT-5.6-turbo则藏在一个容易被忽略的下拉菜单里。无论使用哪家供应商,只要智能体以最高强度运行,更低的单token价格也挡不住支出失控。
Anthropic称用该模型做出了什么
发布说明中包含几项重大主张,这里按Anthropic的表述如实转述。按Anthropic自己的统计,如今进入公司核心代码库的代码变更中,超过九成由Claude编写。Fable 5.2将一项内部生产服务从Python迁移到Rust,执行速度提升约26倍。一位工程师从空文件夹起步,让Fable 5.2协调1,000多个子智能体工作八天,做出了一个可在笔记本电脑上启动的原型操作系统,带有自定义的磁盘、键盘和网络驱动、窗口系统、登录界面和安装程序。由1,000个Fable 5.2智能体组成的团队在30小时内用Lean证明语言形式化了费马大定理,而一个未发布的研究模型需要11天;Opus 5.5在18小时内完成了26%后便停滞不前。与电路板制造商Diode合作时,一条提示词就生成了语音助手中枢、USB会议扬声器和手持电子宠物的规格说明、四层板布局、元件清单和可3D打印的外壳,全部一次打样即可工作。
如果照单全收,这些成果令人印象深刻,而这类内容如此之快就读起来像例行发布说明,本身也很惊人。至于自主科学平台意味着"博士学位的终结"这一说法,比起工程结果,更值得保持怀疑。
Claude Code中的五项实战任务
1. 城市出行规划的3D指南
第一个项目把马德里辖下市镇拉斯罗萨斯(Las Rozas)的官方《可持续城市出行规划》(PMUS)变成了一个名为"The Plan in Motion"的交互式3D网页应用。这项工作同时用到了Claude Opus 5.5和Fable 5.2。应用把规划文本与该镇的3D模型绑定,滚动到某一章节时,对应的地图图层就会亮起。2021年数据中的出行方式以彩色光点呈现:1,409个红点代表私家车,366个蓝点代表公共交通,360个黄点代表步行,49个绿点代表其他方式。九项市政行动计划连同预算投射在地图上,其中包括€540万用于主动出行和本地交通改善,€18.2万用于多式联运衔接,€5.2万用于公共交通升级。自行车图层显示现有车道以及第一期和第二期新增路段,一个开关可在发光的夜景视图和较平淡的日间视图之间切换。夜景视图的吸引力要大得多。市政客户反响热烈,这说明把密集的规划PDF转换成可导航3D指南的模式有真实需求。
2. 篮球投篮模拟
受Fable系列模型用代码渲染自然场景的演示启发,第二项任务要求Fable 5.2搭建一条轻量级的3D渲染管线,呈现一次篮球投篮。通过Claude Code中的终端命令,模型生成了一个名为SPLASH的脚本,在300帧中渲染出140帧,输出一段1080p、60fps的短MP4,内容是斯蒂芬·库里在金州勇士队球馆命中三分。管线能跑通,但与商业游戏引擎相比,画面显得粗糙。用这样的标准去要求一个编程智能体并不公平,不过这个结果有效标记了当下生成式编程的止步之处。
3. 调研€1万以内的本地AI服务器
第三项任务是一份自动化调研报告。目标是:一台全天候运行的家用服务器,以量化后的GLM 5.3-Flash模型同时运行四个智能体,每路约40 token每秒,且无需持续支付云API费用。Fable 5.2被要求调研欧洲和葡萄牙的硬件价格、内存需求,以及vLLM、TensorRT-LLM和ExLlamaV2等推理引擎。
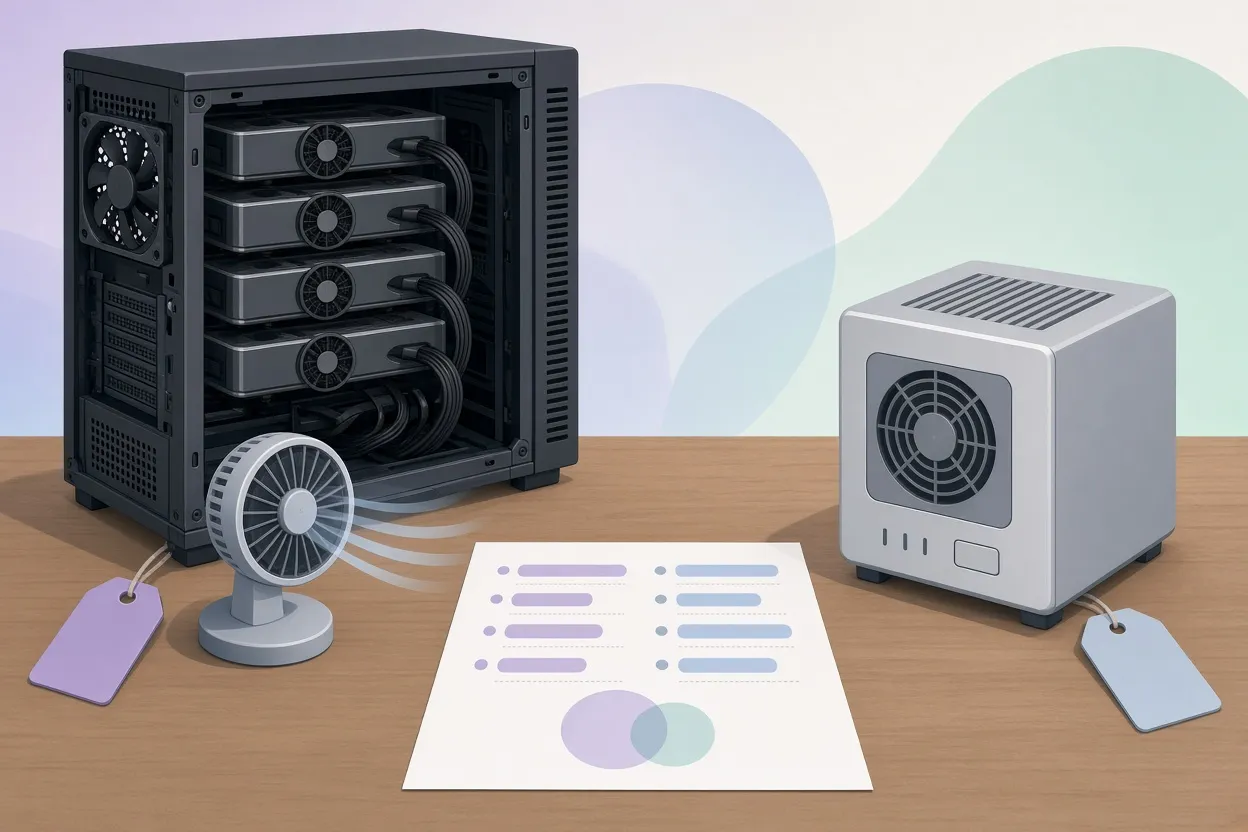
▲ 四卡RTX 3090与Mac Studio对比
报告给出的答案是明确的否定:在€1万预算内无法实现四路各40 token每秒。报告指出,这款模型在单台机器上跑四路并发的实际上限约为110 token每秒。
| 方案 | 预估价格 | 吞吐量 |
|---|---|---|
| 自组工作站,4块英伟达GeForce RTX 3090 | €7,500-8,500 | 总计79到105 token每秒;四路并发下每个智能体约27 |
| 苹果Mac Studio M5 Ultra,256GB统一内存,80核GPU | €11,500-12,500 | 内存上限高,每欧元吞吐量较低 |
| 512GB版Mac Studio | 再加€12,000-14,000 | 超出此预算承受范围 |
四卡RTX 3090方案(最好从二手市场购买显卡)的每欧元吞吐量最佳。即便如此,对于工具链已经以苹果为中心、并预期未来几个月模型优化会持续改进的人来说,Mac Studio仍然颇具吸引力。报告提出两点提醒:欧洲各国之间硬件价格波动很大,增值税也会改变总预算。更广泛的经验是,要验证真实的多路并发吞吐量,而不是相信单路基准数据。
4. 诊断漏水的结账漏斗
第四项测试把一个真实的商业问题交给了Fable 5.2:一个托管在Thinkific上的小型在线课程网站。分析数据显示,四周内有1,420名访客和220次加购,加购访客比为15.5%,但只有32次开始结账,最终仅完成3单。此前30天的收入为€14。提示词要求模型扮演增长营销人员兼开发者,检查公开的结账页面、测试分析埋点、核查Thinkific和Stripe的集成,并在$100以内的支出下制定一份恢复方案。
Fable 5.2浏览了网站,读取漏斗数据,得出结论:购物车挽回邮件在正常发送,但没能说服犹豫的买家。随后它自主完成了几件事:
- 为现有订阅者设计了一场为期七天的促销:全部五门课程的终身套餐售价€99,而单独购买合计€432。
- 在Thinkific中创建了该套餐产品并发布了销售页面。
- 起草了Kit邮件通讯的群发排期、社区公告和LinkedIn帖子。
- 建议在站长高流量视频的描述中加入课程直达链接,因为最畅销的课程大部分访客来自其中一个视频。
- 发现并修复了一处价格不一致:课程页面显示的价格与结账页面不同。
模型还建议推出€600每小时的辅导档位,但被否决了,因为这项服务已经以同样价格存在。这些数字来自一个小型个案,并不能说明其他企业应当期待什么,但仅就价格不一致的修复而言,这正是那种会悄悄扼杀转化率的隐藏缺陷。
5. 面向折叠屏iPhone Duo的原生应用
最后一项测试要求Fable 5.2开发一款原生iOS应用,把iPhone Duo变成Mac的远程控制器,采用双屏布局和响应式键盘。Claude Code中一个自定义的"iphone-app"技能负责Swift和Xcode脚手架,一个名为xtwo的工具加快了在已启用开发者模式的设备上编译和安装构建版本的速度。提示词要求在生成之后、部署之前进行安全审查。
最终做出的应用名为Duo Desk,可通过本地Wi-Fi或USB与MacBook Pro配对。横屏展开时,上屏镜像显示Mac桌面,下屏是带修饰键的完整QWERTY键盘。在手机上打字,内容会立即出现在Mac上的Claude Code里。相比之下,键盘在右、桌面在左的竖屏模式用起来很别扭。一款向桌面授予远程输入权限的应用是真实的安全攻击面,因此这不是一个可以不经严格审查就照搬的模式;这里描述的任何内容都不应被视为经过安全审核的实现。
要点
Fable 5.2对Opus 5.5和GPT-6 Astra的基准领先在编程、科学和长程知识工作上保持一致,实战任务也在策略密集型工作上印证了这一点:漏斗诊断、硬件调研和完整应用开发都一次就产出了可用结果。图形渲染仍然初级,单任务成本也高于Opus 5.5。
如果你想试用:
- 检查Claude.ai和Claude Desktop的设置;Fable 5.2现已是默认模型。
- 日常工作继续用Opus 5.5,把Fable 5.2留给开放式问题,或让它编排Sonnet 5.5和Haiku 5.5。
- 智能体编程用高强度运行,不要用超高或最高,以免为微小收益付出成本激增。
- 给自主智能体设定明确的预算和指标,就像漏斗测试中的$100上限那样。
- 规划本地推理时,购买硬件前先验证多路并发吞吐量。
- 任何涉及远程控制或桌面输入的生成应用,都要求做安全审查。


