Anthropicは2026年11月9日、Claude Fable 5.2とClaude Mythos 5.2を公開しました。新モデルは公開直後からArtificial Analysis Intelligence Indexの首位に立ち、Claude Opus 5.5を6ポイント上回っています。ただし、ランキングの順位と実際の仕事で役に立つかどうかは別の話です。本記事ではまず公表されたベンチマークとコストの数値を確認し、そのうえでClaude Code上でFable 5.2に5つの日常的な仕事を任せました。都市の交通計画を解説する3Dガイド、バスケットボールのシュートシミュレーション、ローカルAIサーバー向けのハードウェア調査レポート、オンライン講座サイトの販売ファネル監査、折りたたみ式iPhone向けのネイティブアプリです。結果を見ると、見出しの数値は戦略立案やソフトウェア開発の実力として現れている一方、グラフィックスには明確な限界があり、コスト面にも注意すべき落とし穴があります。
リリースが示す主張
Fable 5.2とMythos 5.2は同じ基盤モデルを共有しています。Mythos 5.2はサイバーセキュリティと生物学に特化した能力を保持しており、これらは検証プログラムを通じてのみ利用できます。一方のFable 5.2はこれらの分野に安全対策を組み込んで提供され、Anthropicによれば不要な拒否がFable 5.1より少なくなっています。両モデルとも5.1世代より明快に意思疎通でき、出力生成は最大30%高速になったとされています。
Fable 5.2は現在、Claude.aiとClaude Desktopの既定モデルで、推奨される思考エフォートは「medium」です。AnthropicはOpus 5.5を日常業務の主力と位置づけ、Fable 5.2とMythos 5.2は答えの定まらない技術的課題に使うか、小さなタスクをSonnet 5.5やHaiku 5.5に委ねるオーケストレーターとして使うことを推奨しています。つい最近までラインアップの最上位だったOpus 5.5が軽量な選択肢として扱われるのは、興味深い逆転です。
料金
| モード | 入力(100万トークンあたり) | 出力(100万トークンあたり) | 速度 |
|---|---|---|---|
| 標準 | $8 | $40 | Fable 5.1比で最大30%高速 |
| Fast Mode | $16 | $80 | トークン生成速度が最大2.5倍 |
Artificial Analysisのタスクあたりコストのグラフでは、Fable 5.2はインデックスのタスク1件あたり加重平均でおよそ$10に位置し、タスク単価ではOpus 5.5より高くなっています。1つ注意点があります。Fable 5.1よりトークン生成は速いものの、Artificial Analysisの集計ではタスクあたりの平均所要時間はむしろ長くなっており、回答前により深く推論しているためとみられます。
Opus 5.5とGPT-6 Astraとのベンチマーク比較
Anthropicの比較表では、評価したすべてのカテゴリーでFable 5.2がOpus 5.5とOpenAIのGPT-6 Astraを上回っています。
| ベンチマーク | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0(高エフォート) | 49.1% | 32.4% | 45.5% | 42.8% |
| FrontierSWE v2(エージェント型コーディング) | 69.9% | 56.3% | 62.3% | 65.5% |
| Terminal-Bench Science 0.1 | 74.6% | — | 68.1% | 66.5% |
| AA-Briefcase v1.1(数週間規模のナレッジワーク) | 66.1% | — | 59.5% | 58.0% |
エフォートをextra-highにするとFable 5.2はFrontierCode 2.0で56.9%に達しますが、同じ設定のFable 5.1の56.7%をわずかに上回る程度です。このほか、ツール使用ありのHumanity's Last Examで74.2%、グラフ読み取りテストのChartographyで73.4%、高エフォートでのRemote Labor Indexで41.3%を記録しています。AA-Briefcaseは説明しておく価値があります。密度の高いスプレッドシート、PDF、チャットのスレッドといった財務・法務・業務資料を対象に、数週間にわたる長期のエージェント型ナレッジ作業を測るもので、コーディングのパズルよりオフィス業務に近い内容です。
セキュリティ面では、安全対策なしのMythos 5.2がCyScenarioBenchで76.3%を記録したのに対し、安全対策ありのFable 5.2は36.3%でした。Anthropic社内のCVE再発見ベンチマークは、すでに公開済みの過去の脆弱性1,629件をモデルに探させるもので、Mythos 5.2は89.6%に達し、Opus 5.5を10.2%、Mythos 5.1を14.4%上回りました。さらにAnthropicは、Mythos 5.2が検出結果の深刻度を過大評価するのは20回に1回程度だと報告しています。誤報を追いかけるのではなくパッチの優先順位を決めなければならない防御側にとって、これは重要な点です。
この分野の進歩の速さを把握するため、Artificial Analysisのインデックスで旧モデルを絞り込むと、Claude Opus 5が44、Kimi K1.3 Proが46、GLM 5.3 Maxが32となっています。
エフォート設定:コストはどこで膨らむのか
今回のリリースで最も有用なグラフは、Fable 5.2、Opus 5.5、Mythos 5.1、GPT-6 Astra、Gemini 4 Carbonについて、思考エフォートの段階ごとにFrontierCode 2.0の正答率とタスクあたりコストを対応づけたものです。スコアはlowからhighまで着実に上がります。しかしそこからextra-highやmaxに上げると、コストが急増する一方で正答率はほとんど動きません。
▲ 思考エフォートを上げた際の収穫逓減
ここから実用的な結論が2つ導けます。第1に、高エフォートのFable 5.2はmaxエフォートのOpus 5.5と同等の成績を、タスクあたりコストをおよそ半分に抑えて達成します。第2に、エージェント型コーディングでは高エフォートが妥当な上限とみられ、extra-highとmaxの段階は収穫逓減に見えます。また、mediumエフォートのFable 5.2は、難しいタスクをFable 5.1より少ないトークンで完了しています。
裏を返せば、エフォートの管理は把握しにくくなっています。Anthropicのモデルとエフォートの組み合わせは、ChatGPTの単一スライダーより複雑に感じられます。ChatGPTではProプランでGPT-6が既定で選ばれ、GPT-5.6-turboは見落としやすいドロップダウンの中にあります。どのベンダーを使うにせよ、トークン単価が安くても、エージェントがmaxエフォートで走れば支出の暴走からは守ってくれません。
Anthropicがこのモデルで作ったと語るもの
リリースノートには大きな主張がいくつか含まれており、ここではAnthropicの発表どおりに伝えます。Anthropic自身の集計によれば、同社の中核コードベースに取り込まれるコード変更の9割超を現在Claudeが書いています。Fable 5.2は社内の本番サービスをPythonからRustに移行し、実行速度はおよそ26倍になりました。あるエンジニアは空のフォルダーから始めて、Fable 5.2に1,000以上のサブエージェントを8日間にわたって統率させ、独自のディスク、キーボード、ネットワークのドライバー、ウィンドウシステム、ログイン画面、インストーラーを備え、ノートPCで起動するプロトタイプOSを作り上げました。1,000体のFable 5.2エージェントからなるチームは、フェルマーの最終定理を証明言語Leanで30時間で形式化しました。未公開の研究用モデルでは11日かかり、Opus 5.5は18時間で26%を完了したところで行き詰まりました。基板メーカーのDiodeとの取り組みでは、1つのプロンプトから音声アシスタントハブ、USBスピーカーフォン、携帯型バーチャルペットの仕様、4層基板のレイアウト、部品表、3Dプリント可能な筐体が生成され、いずれも最初の製造で動作しました。
額面どおりに受け取れば目覚ましい成果ですが、こうした項目が当たり前のリリースノートのように読めるようになった速さには驚かされます。自律型の科学プラットフォームが「博士課程の終わり」を意味するという主張については、エンジニアリングの成果より慎重に受け止めるべきでしょう。
Claude Codeで試した5つの実作業
1. 都市の交通計画を解説する3Dガイド
最初のプロジェクトでは、マドリード州の自治体ラス・ロサスの公式な持続可能な都市交通計画(PMUS)を、「The Plan in Motion」という対話型3Dウェブアプリに変換しました。作業にはClaude Opus 5.5とFable 5.2を使っています。このアプリは計画の本文と町の3Dモデルを結びつけ、ある節をスクロールすると対応する地図レイヤーが点灯します。2021年のデータによる移動手段は色付きの光点で表示され、自家用車が赤1,409個、公共交通が青366個、徒歩が黄360個、その他が緑49個です。9つの自治体施策が予算とともに地図上に投影され、アクティブモビリティと地域交通の改善に€540万、インターモーダル接続に€182,000、公共交通の改良に€52,000などが含まれます。自転車レイヤーは既存のレーンに加えてフェーズ1とフェーズ2の追加分を示し、切り替えスイッチで光る夜景ビューと平坦な昼間ビューを行き来できます。夜景ビューのほうがはるかに訴求力があります。自治体の顧客からは熱のこもった反応があり、情報量の多い計画書PDFを操作できる3Dガイドに変換するという手法には実需があるとみられます。
2. バスケットボールのシュートシミュレーション
Fableモデルがコードで自然の風景を描画するデモに触発され、2つ目のタスクではFable 5.2にバスケットボールのシュートを描く軽量な3Dレンダリングパイプラインの構築を依頼しました。Claude Codeのターミナルコマンドを通じて、モデルはSPLASHというスクリプトを生成し、300フレーム中140フレームをレンダリングして、ステフィン・カリーがGolden State Warriorsのアリーナで3ポイントシュートを決める1080p・60fpsの短いMP4動画を作りました。パイプラインは動いたものの、出力は商用ゲームエンジンと並べると粗く見えます。コーディングエージェントにその水準を求めるのは酷ですが、生成コーディングが今日どこで止まるかを示す有用な目安になりました。
3. €10,000以下のローカルAIサーバーを調査する
3つ目のタスクは自動化した調査レポートです。目標は、量子化したGLM 5.3-Flashモデルで4つのエージェントを同時に、それぞれ毎秒約40トークンで動かし、クラウドAPIの継続的な費用なしに24時間365日稼働する自宅サーバーです。Fable 5.2には、ヨーロッパとポルトガルのハードウェア価格、必要なメモリ量、vLLM、TensorRT-LLM、ExLlamaV2などの推論エンジンを調べるよう依頼しました。
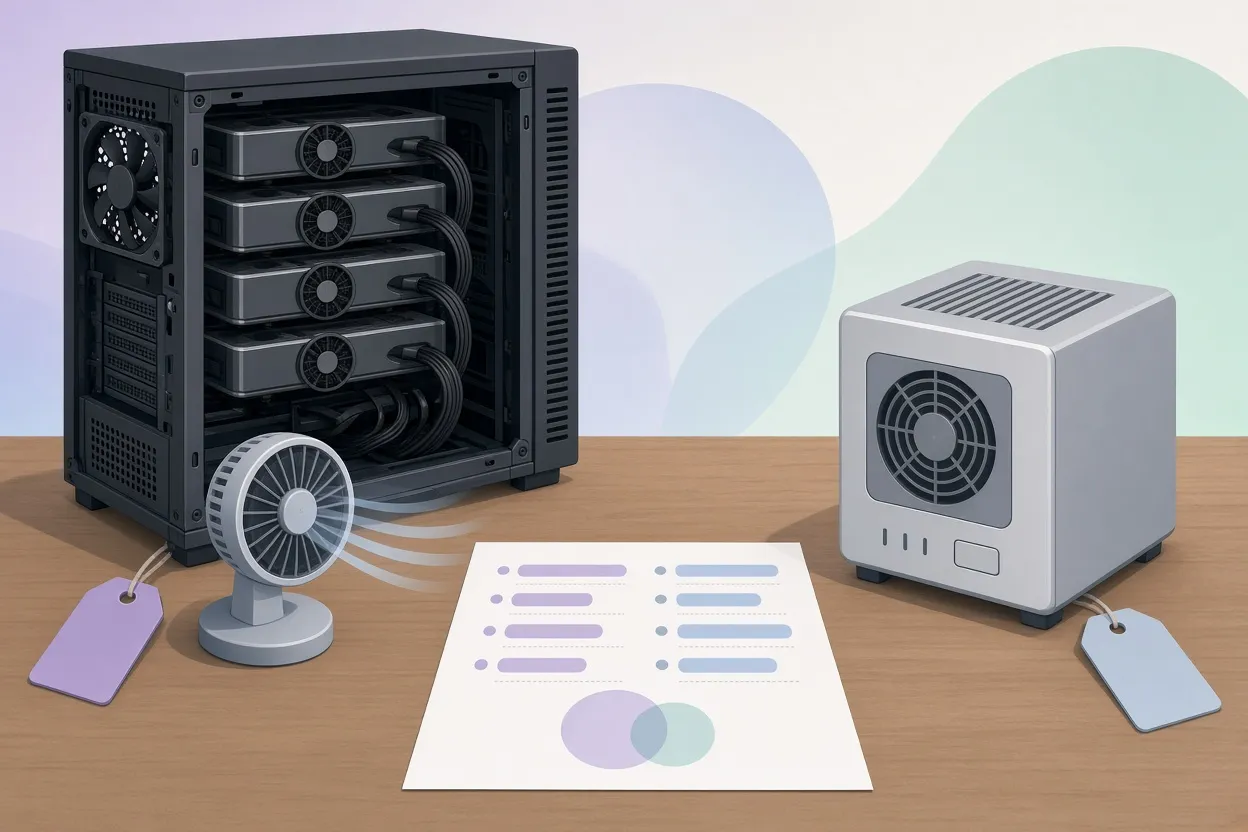
▲ RTX 3090を4枚の自作機とMac Studioの比較
レポートの答えは明確な「不可能」でした。4ストリームをそれぞれ毎秒40トークンで動かすことは€10,000以下では実現できません。このモデルを4ストリームで動かした場合、1台あたりの実用的な上限は毎秒約110トークンだと特定しています。
| 選択肢 | 推定価格 | スループット |
|---|---|---|
| 自作ワークステーション、NVIDIA GeForce RTX 3090を4枚 | €7,500 ~ €8,500 | 合計で毎秒79 ~ 105トークン、4ストリームでエージェントあたり約27トークン |
| Apple Mac Studio M5 Ultra、256GBユニファイドメモリ、80コアGPU | €11,500 ~ €12,500 | メモリ上限は高いが、ユーロあたりのスループットは低い |
| Mac Studio 512GB構成 | €12,000 ~ €14,000の追加 | この予算では非現実的 |
RTX 3090を4枚使う構成は、理想的には中古市場のカードを使うことで、ユーロあたりのスループットが最も高くなります。それでも、すでにApple中心のツールを使っていて、今後数か月でモデルの最適化が進むと見込む人にとっては、Mac Studioは依然として魅力的です。レポートからの注意点は2つあります。ハードウェア価格はヨーロッパの国ごとに大きく変動し、VATによって総予算が変わります。より大きな教訓は、単一ストリームのベンチマークを信じるのではなく、実際の複数ストリームのスループットを検証することです。
4. 漏れのある決済ファネルを診断する
4つ目のテストでは、Thinkificでホストしている小規模なオンライン講座サイトの実際の経営課題をFable 5.2に渡しました。アナリティクスによると、4週間で訪問者1,420人、カート追加220件で、訪問者に対するカート率は15.5%でしたが、決済開始は32件、完了はわずか3件でした。直近30日間の売上は€14です。プロンプトではモデルにグロースマーケター兼開発者として振る舞い、公開されている決済ページを点検し、アナリティクスのフックをテストし、ThinkificとStripeの連携を確認したうえで、支出$100未満で回復計画を作るよう指示しました。
Fable 5.2はサイトを閲覧し、ファネルのデータを読み、カート放棄メールは送信されているものの迷っている購入者を説得できていないと結論づけました。そのうえで、いくつかのことを自律的に実行しました。
- 既存の購読者向けに7日間のセールを設計。全5講座の永久利用バンドルを、合計価格€432の代わりに€99で提供。
- Thinkific上にバンドル商品を作成し、販売ページを公開。
- Kitのニュースレター配信スケジュール、コミュニティへの告知、LinkedIn投稿の草案を作成。
- 最も売れている講座は訪問者の大半を特定の動画から得ているため、サイト運営者のアクセスの多い動画の説明欄に講座への直接リンクを追加するよう提案。
- 講座ページの表示価格が決済画面と異なるという価格の不一致を発見し、修正。
モデルは1時間€600のコーチングプランも提案しましたが、そのサービスはすでに同じ価格で存在するため見送られました。これらの数値は小規模な1事例のもので、ほかの事業が何を期待できるかについては何も語りません。ただ、価格不一致の修正だけを取っても、コンバージョンを静かに殺す隠れた欠陥の典型です。
5. 折りたたみ式iPhone Duo向けのネイティブアプリ
最後のテストでは、iPhone DuoをMacのリモートコントローラーに変える、2画面レイアウトと反応の良いキーボードを備えたネイティブiOSアプリの構築をFable 5.2に依頼しました。Claude Codeのカスタムスキル「iphone-app」がSwiftとXcodeの雛形作成を担当し、xtwoというツールが開発者モードを有効にした端末へのビルドのコンパイルとインストールを高速化しました。プロンプトでは、生成後かつ配備前にセキュリティレビューを行うことを必須としました。
完成したアプリ「Duo Desk」は、ローカルWi-FiまたはUSB経由でMacBook Proとペアリングします。横向きに開くと、上画面にMacのデスクトップがミラーリングされ、下画面に修飾キー付きのフルQWERTYキーボードが表示されます。スマートフォンでの入力は、Mac上のClaude Codeに即座に反映されました。縦向きでキーボードを右、デスクトップを左に置くモードは、それに比べるとぎこちなく感じられました。デスクトップへのリモート入力を許可するアプリは本物のセキュリティ上の攻撃面になるため、適切なレビューなしに真似すべきパターンではありません。ここで述べた内容はいずれも、セキュリティ検証済みの実装として扱うべきではありません。
まとめ
Fable 5.2がOpus 5.5とGPT-6 Astraに対して持つベンチマークの優位は、コーディング、科学、長期のナレッジワークにわたって一貫しており、実作業でも戦略寄りの仕事ではそれが裏付けられました。ファネル診断、ハードウェア調査、アプリの一括構築はいずれも1回の実行で使える結果を出しています。一方、グラフィックスの描画は依然として初歩的で、タスクあたりのコストはOpus 5.5を上回ります。
試してみるなら、次の点を押さえてください。
- Claude.aiとClaude Desktopの設定を確認する。Fable 5.2が既定になっています。
- 定型業務にはOpus 5.5を使い続け、Fable 5.2は答えの定まらない課題に取っておくか、Sonnet 5.5とHaiku 5.5のオーケストレーターとして使う。
- エージェント型コーディングはextra-highやmaxではなく高エフォートで実行し、見返りの少ないコスト急増を避ける。
- ファネルのテストで$100の上限を設けたように、自律エージェントには明示的な予算と指標を与える。
- ローカル推論を計画する場合は、ハードウェアを買う前に複数ストリームのスループットを検証する。
- リモート操作やデスクトップ入力に触れる生成アプリには、必ずセキュリティレビューを求める。


