Anthropic이 2026년 11월 9일 공개한 Claude Fable 5.2는 Artificial Analysis Intelligence Index에 1위로 데뷔했고, 같은 회사의 Claude Opus 5.5보다 6점 앞섰습니다. 그동안 Opus 아래에 자리하던 모델군이 최상위로 올라선 셈입니다. 그런데 발표 자료의 숫자가 실제 업무에서 어느 정도로 체감되는지는 별개의 문제입니다. 이 글은 benchmark 수치와 비용 구조를 먼저 확인한 뒤, Claude Code(터미널에서 코드와 도구를 다루는 Anthropic의 agent 환경)에서 다섯 가지 실제 작업을 돌려 본 결과를 정리합니다. 결론부터 말하면, 사업 분석과 앱 개발처럼 범위가 분명한 작업에서는 발표 자료의 성능이 상당 부분 체감되었고, 3D 그래픽처럼 결과물의 품질 기준이 높은 작업에서는 한계가 드러났습니다.
발표 자료가 말하는 것
기본 모델 교체와 가격
Claude.ai 웹과 Claude Desktop을 열어 보면 Fable 5.2가 Opus와 Sonnet을 밀어내고 기본 모델로 잡혀 있고, 권장 thinking effort(모델이 답하기 전에 추론에 쓰는 노력의 양)는 medium입니다. Fable 5.2와 함께 나온 Mythos 5.2는 같은 가중치를 공유하는 모델로, 사이버 보안과 생물학 관련 능력을 검증 프로그램 아래에서만 제공한다는 점이 다릅니다. Fable 5.2에는 오남용을 막는 보호 장치가 들어가 있으면서도 Fable 5.1보다 과도한 거부는 줄었다고 Anthropic은 설명합니다.
가격과 속도 관련 수치는 다음과 같습니다.
| 항목 | 수치 |
|---|---|
| 표준 가격 | 입력 100만 token당 $8, 출력 100만 token당 $40 |
| Fast Mode 가격 | 입력 100만 token당 $16, 출력 100만 token당 $80 |
| Fast Mode 속도 | 최대 2.5배 빠른 token 생성 |
| 생성 속도 | Fable 5.1과 Mythos 5.1 대비 최대 30% 향상 |
| Artificial Analysis 작업당 비용 | 가중 평균 약 $10 |
작업당 약 $10이라는 비용은 Opus 5.5보다 비싼 값입니다. 또 token 생성 자체는 빨라졌지만 더 깊이 추론하기 때문에 Artificial Analysis가 측정한 평균 작업 완료 시간은 오히려 느리게 나타납니다. token 단가만 보고 저렴하다고 판단하면 안 되고, effort 설정을 함께 관리해야 비용이 통제됩니다.
benchmark 비교
Anthropic은 일상 작업의 기본 모델로는 Opus 5.5를 권하고, Fable 5.2와 Mythos 5.2는 열린 결말의 어려운 기술 문제나 Sonnet 5.5·Haiku 5.5에 작업을 나눠 주는 orchestrator(여러 하위 agent를 지휘하는 역할) 용도로 자리매김합니다. 얼마 전까지 최상위였던 Opus 5.5가 가벼운 일상용으로 밀린 모습은 세대 교체 속도를 보여 주는 장면으로 읽힙니다.
주요 benchmark 수치는 다음과 같습니다.
| benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (high effort) | 49.1% | 32.4% | 45.5% | 42.8% |
| FrontierCode 2.0 (extra-high) | 56.9% | 56.7% | - | - |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% |
| Terminal-Bench Science 0.1 | 74.6% | - | 68.1% | 66.5% |
| AA-Briefcase v1.1 | 66.1% | - | 59.5% | 58.0% |
AA-Briefcase v1.1은 재무·법무·운영 영역에서 여러 주에 걸친 agent 지식 노동을 평가하는 benchmark입니다. 이 밖에 Humanity's Last Exam 도구 사용 조건에서 74.2%, 차트 해석(Chartography)에서 73.4%, Remote Labor Index high effort에서 41.3%를 기록했습니다. 보안 쪽에서는 보호 장치를 끈 Mythos 5.2가 CyScenarioBench에서 76.3%, 보호 장치가 있는 Fable 5.2가 36.3%를 받았고, Mythos 5.2의 CVE 재발견율은 89.6%로 Opus 5.5의 78.3%를 앞섰습니다. 2026년 10월 기준 1,629건의 과거 취약점을 대상으로 한 내부 평가에서는 Mythos 5.2가 Opus 5.5보다 10.2%, Mythos 5.1보다 14.4% 더 많은 취약점을 찾았고, 심각도를 과장한 경우는 20건 중 1건 정도였습니다.
참고로 Artificial Analysis 지수에서 Claude Opus 5는 44점, Kimi K1.3 Pro는 46점, GLM 5.3 Max는 32점입니다. 핀테크 기업 Revolut가 GLM 5.3 같은 모델 위에서 핵심 엔지니어링 스택을 운영하는 상황과 겹쳐 보면, 몇 세대의 도약이 짧은 기간에 일어나고 있다는 점이 드러납니다.
effort 설정과 비용 곡선
가장 실용적인 정보는 effort와 비용의 관계입니다. FrontierCode 2.0에서 Fable 5.2를 high effort로 돌리면 Opus 5.5를 max effort로 돌린 것과 같은 성능이 나오면서 작업당 비용은 절반 수준입니다. medium effort에서도 Fable 5.1보다 적은 token으로 어려운 작업을 끝냅니다.
반면 Fable 5.2, Opus 5.5, Mythos 5.1, GPT-6 Astra, Gemini 4 Carbon의 정확도 대 비용 곡선을 보면, low에서 high로 올릴 때는 점수가 오르지만 extra-high나 max로 가면 비용이 급격히 뛰는 데 비해 점수는 거의 오르지 않습니다. agentic coding 작업에서는 high로 충분하다고 보는 편이 합리적입니다.
한편 thinking effort 설정 방식은 공급사마다 달라 따라가기 어렵습니다. OpenAI의 ChatGPT는 입력창에 effort 슬라이더를 두고, Pro 아래 드롭다운에서 GPT-6가 기본, GPT-5.6-turbo가 대안으로 잡혀 있는 구조입니다. ChatGPT는 인터페이스가 자주 바뀌니 어떤 모델이 세션에 배정되어 있는지 드롭다운을 직접 확인하는 습관이 필요합니다.
Anthropic이 함께 공개한 사례
발표 자료에는 benchmark 외에도 몇 가지 사례가 실려 있습니다.
- Anthropic 핵심 코드베이스에 병합되는 변경의 90% 이상을 이제 Claude가 작성합니다. Fable 5.2는 내부 프로덕션 서비스를 Python에서 Rust로 이전해 약 26배 빠른 실행 속도를 냈습니다.
- 한 Anthropic 엔지니어가 빈 폴더에서 시작해 1,000개가 넘는 하위 agent를 8일 동안 조율하게 했더니, 디스크·키보드·네트워크 드라이버, 영구 저장소, 창 시스템, 로그인 화면, 설치 프로그램, 내장 Claude 기능을 갖춘 프로토타입 운영체제가 노트북에서 부팅되었습니다. Vercel, Shopify, Datadog, Unity, Uber, Oracle 엔지니어링 팀의 사용 후기도 함께 실렸습니다.
- Fable 5.2 agent 1,000개가 Fermat의 마지막 정리를 Lean(수학 증명을 컴퓨터로 검증하는 언어)으로 30시간 만에 형식화했습니다. 미공개 연구용 Claude는 11일이 걸렸고, Opus 5.5는 18시간 동안 26%까지 진행한 뒤 멈췄습니다.
- 회로 기판 제조사 Diode와 함께한 실험에서는 prompt 하나로 가정용 음성 비서 허브, USB 스피커폰, 휴대용 가상 반려동물 세 가지 장치의 사양, 4층 기판 배치, 부품 선정, 3D 프린팅용 외장까지 생성했고, Diode가 하루 만에 제작한 세 장치가 첫 조립에서 모두 동작했습니다.
- 이론물리학에서 홀로그래피 이중성과 블랙홀 열역학 관련 미해결 문제 두 개를 풀었고, Mythos 5.2는 수십 개 단백질 사슬로 이뤄진 아데노 연관 바이러스 캡시드 구조를 34회 시도 중 28회 정확히 예측했습니다.
같은 시기 Google Cloud AI Research는 사람 개입 없이 연구 주기를 자동화해 논문과 검증된 코드를 내놓는 multi-agent 프레임워크 'ScientistTwo' 논문을 공개했습니다. 이런 발표가 잇따르면서 미해결 물리 문제나 장치 자동 설계 같은 소식이 평범한 릴리스 노트처럼 소비되는 분위기가 있고, 자동화된 과학 agent가 박사 과정의 종말을 뜻한다는 식의 과장에는 거리를 둘 필요가 있어 보입니다.
▲ effort 상향의 수익 체감
실제 작업 다섯 가지
1. 도시 이동 계획서를 3D 안내서로
첫 번째는 마드리드 인근 Las Rozas 시의 지속 가능 도시 이동 계획(PMUS) 문서를 3D 웹 안내서로 바꾸는 작업입니다. Claude Opus 5.5와 Fable 5.2를 써서 만든 이 앱은 시의 공식 문서를 3D 지도와 연결해, 문서를 넘기면 해당 지도 레이어가 함께 바뀌는 구조입니다.
2021년 이동 데이터는 색 불빛으로 표현됩니다. 자가용은 빨간색 1,409개, 대중교통은 파란색 366개, 도보는 노란색 360개, 기타 수단은 초록색 49개입니다. 아홉 가지 실행 계획이 지도 위에 투영되고 예산도 함께 보입니다. 능동 이동과 시내 교통 개선에 €540만, 대중교통 개선에 €5만 2,000, 환승 연계 촉진에 €18만 2,000이 배정되어 있습니다. 자전거 기반 시설 확장은 현재 노선, 1단계, 2단계로 나눠 보여 주고, 야간 모드와 주간 모드를 전환할 수 있습니다. 교통 노선이 빛나는 야간 모드가 주간 모드보다 훨씬 설득력 있게 보입니다. 이 시제품을 시 담당자들에게 보여 주었을 때 반응이 좋았는데, 정적인 문서 데이터를 움직이는 3D 안내서로 바꿔 준다는 점이 이유였습니다.
2. 농구 슈팅 3D 시뮬레이션
두 번째는 가벼운 3D 렌더링 엔진을 만들어 농구 3점 슛 장면을 그리는 실험입니다. Fable 계열 모델이 자연 풍경과 노을을 코드로 렌더링하는 온라인 시연이 여럿 있어 시도해 본 것입니다. Claude Code에서 터미널 명령으로 'SPLASH'라는 스크립트가 만들어졌고, 300프레임 중 140프레임을 캡처해 1080p 60fps MP4 클립을 냈습니다. Stephen Curry가 Golden State Warriors 경기장에서 아크 정면 3점 슛을 넣는 장면인데, 결과물은 솔직히 조잡하고 우스꽝스러운 수준입니다. 다만 상용 게임 엔진 수준의 그래픽을 코딩 agent에 기대하는 것 자체가 과한 기준이고, 생성 코딩의 경계가 어디인지 확인하는 실험으로 보는 것이 맞습니다.
3. €1만 이하 로컬 LLM 서버 조사
세 번째는 클라우드 API 요금 없이 24시간 돌아가는 가정용 서버를 꾸리려는 조사입니다. 목표는 양자화한 GLM 5.3-Flash로 agent 4개를 동시에 돌리면서 agent당 초당 약 40 token을 내는 것입니다. 초기 추정으로는 원하는 구성이 €1만을 쉽게 넘겼고, 그래도 Opus 5.5나 GLM 5.3 전체 모델을 양자화 없이 돌릴 메모리는 안 나왔습니다.
Fable 5.2에 유럽과 포르투갈 시장 가격, 메모리 요구량, vLLM·TensorRT-LLM·ExLlamaV2 같은 추론 엔진을 포함한 조사를 맡기자 다음과 같은 결론의 보고서가 나왔습니다.
| 구성 | 가격 | 처리량 |
|---|---|---|
| NVIDIA GeForce RTX 3090 4장 조립 워크스테이션 | €7,500~8,500 | 4개 스트림 동시 실행 시 agent당 약 초당 27 token (제작자별 측정 초당 79~105 token) |
| Apple Mac Studio M5 Ultra (256GB 통합 메모리, 80코어 GPU) | €1만 1,500~1만 2,500 | 512GB로 올리면 €1만 2,000~1만 4,000 추가 |
보고서의 핵심은 €1만 이하로는 4개 스트림에서 초당 40 token을 내는 것이 불가능하고, 기기 한 대의 총 처리량 상한이 초당 약 110 token이라는 것입니다. 유로당 처리량은 RTX 3090 조립이 가장 좋지만, 기존 개발 환경이 Apple 중심이고 앞으로 몇 달간 모델 최적화가 기대된다는 이유로 Mac Studio 쪽으로 기우는 판단도 가능합니다. 하드웨어 가격은 유럽 국가마다 크게 다르고 부가가치세 구조가 총예산에 영향을 주며, RAM 가격이 치솟아 로컬에서 큰 모델을 돌리는 비용이 부담스러워졌다는 점도 함께 고려해야 합니다.
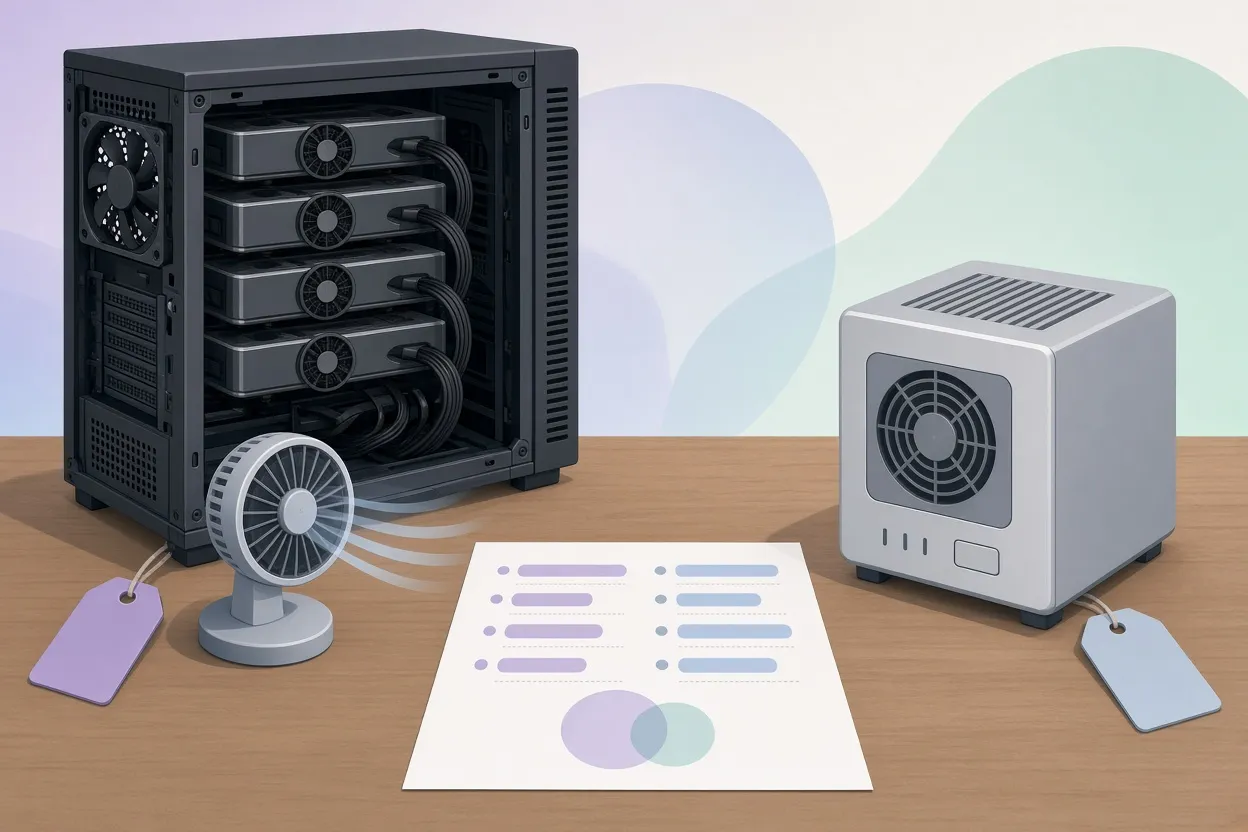
▲ 로컬 LLM 서버 두 가지 선택지
4. 온라인 강의 결제 전환 분석
네 번째는 한 온라인 강의 사이트의 결제 누수 문제입니다. Thinkific 관리자 화면을 보면 방문자 흐름은 꾸준한데 최근 30일 매출이 €14에 그쳤습니다. 지난 4주 기준 순방문자 1,420명, 장바구니 생성 220건으로 방문자 대비 장바구니 비율은 15.5%였지만, 결제 시작 32건 중 결제 버튼까지 간 것도 3건, 완료도 3건뿐이었습니다. 장바구니는 많이 만들어지는데 구매로 이어지지 않는 전형적인 누수입니다.
Claude Code에서 Fable 5.2에 '성장 마케터이자 개발자로서 자율적으로 일하되 외부 지출은 $100 미만'이라는 조건으로 공개 결제 페이지 점검, 분석 hook 테스트, Thinkific과 Stripe 연동 확인, 기술적 복구 계획 수립을 맡겼습니다. 모델이 사이트와 funnel 데이터를 살핀 뒤 내놓은 진단과 조치는 다음과 같습니다.
- 장바구니 복구 이메일은 동작하지만 망설이는 구매자를 설득하지 못한다고 진단
- 기존 구독자를 대상으로 7일 한정 세일을 제안하고, 전체 강의 평생 이용 번들을 €432 대신 €99로 책정
- Thinkific에 5개 강의 번들 상품을 직접 만들고 공개 판매 페이지 게시
- Kit 뉴스레터 발송문, 커뮤니티 공지, LinkedIn 게시물을 캠페인 일정에 맞춰 작성
- 조회수가 많은 기존 홍보 콘텐츠에 강의 링크를 직접 넣어 유기적 유입을 판매 페이지로 연결하라고 권고
- 강의 페이지에 표시된 가격과 결제 화면 가격이 다른 불일치를 발견해 직접 수정
시간당 €600짜리 고가 코칭 워크숍을 열라는 권고도 있었지만, 이미 같은 가격의 1:1 코칭을 운영 중이어서 받아들이지 않았습니다. 모델의 제안을 전부 따르기보다 사업 맥락에 맞춰 취사선택하는 과정이 필요하다는 점을 보여 주는 대목입니다. 가격 불일치 같은 숨은 UI 결함을 스스로 찾아 고친 점은 발표 자료의 agent 지식 노동 benchmark가 실제로 의미하는 바에 가까워 보입니다.
5. iPhone Duo로 Mac을 제어하는 앱
마지막은 처음부터 끝까지 소프트웨어를 만드는 시험입니다. 목표는 접이식 iPhone Duo를 Mac의 화면을 띄우고 조작하는 휴대용 원격 제어기로 만드는 것입니다. Claude Code에서 Swift와 Xcode 앱 생성을 표준화해 둔 자체 iphone-app skill(agent에게 특정 작업 절차를 가르쳐 두는 재사용 가능한 지침 묶음)을 켜고, 두 화면 배치 최적화와 반응성 좋은 키보드 입력을 갖춘 앱을 만들되 기기에 설치하기 전에 보안 검토를 반드시 거치라고 지시했습니다. 빌드와 설치에는 Xcode와 함께 개발자 모드가 켜진 실제 기기에 빠르게 설치해 주는 xtwo라는 도구를 썼습니다.
완성된 'Duo Desk' 앱은 같은 Wi-Fi 페어링이나 USB 케이블로 MacBook Pro에 연결됩니다. 펼친 상태에서 위쪽 화면에 Mac 데스크톱이 미러링되고 아래쪽에는 modifier 키까지 갖춘 넓은 QWERTY 키보드가 나옵니다. 휴대폰 키보드로 글자를 치면 Mac의 Claude Code에 즉시 나타날 정도로 반응이 빠릅니다. 세로 방향에서는 키보드가 오른쪽, 데스크톱이 왼쪽에 놓여 가로 클램셸 배치보다 다소 어색합니다.
여기서 주의할 점이 있습니다. 데스크톱에 원격 입력 권한을 주는 자체 제작 앱은 보안 위험을 수반합니다. 보안 전문가가 아닌 개인이 만든 검증되지 않은 구현을 누구에게나 권할 수는 없으며, 비슷한 시도를 한다면 생성 직후 자동화된 보안 검토를 작업 흐름에 포함하고 신뢰할 수 있는 네트워크 안에서만 쓰는 것이 최소한의 방어책입니다.
정리: 어디까지 체감되는가
다섯 가지 작업을 놓고 보면 Fable 5.2의 강점은 두 가지로 요약됩니다. 하나는 funnel 데이터를 읽고 전략을 세운 뒤 플랫폼 안에서 직접 손을 대는 사업 분석 능력이고, 다른 하나는 새로운 두 화면 하드웨어용 네이티브 앱처럼 범위가 분명한 소프트웨어를 완성하는 능력입니다. 반면 3D 그래픽처럼 결과물의 시각적 완성도가 평가 기준인 작업에서는 아직 기대를 낮춰야 합니다. 하드웨어 조사 보고서는 '불가능하다'는 결론과 수치 근거를 내놓았다는 점에서, 모델이 원하는 답이 아니라 현실적인 답을 준 사례로 볼 수 있습니다.
독자가 바로 할 수 있는 일은 다음과 같습니다.
- Claude.ai와 Claude Desktop 설정을 열어 기본 모델이 Fable 5.2로 바뀌었는지, effort가 어떻게 잡혀 있는지 확인합니다.
- 일상 작업은 Opus 5.5에 맡기고, Fable 5.2는 열린 결말의 복잡한 기술 문제나 Sonnet 5.5·Haiku 5.5에 하위 작업을 나눠 주는 orchestrator로 씁니다.
- agentic coding에서는 high effort까지만 올립니다. extra-high나 max는 비용만 크게 늘고 점수 개선은 미미합니다.
- 결제 전환 같은 사업 분석을 맡길 때는 지출 상한과 측정 지표를 숫자로 분명히 적어 주고, 모델의 권고는 사업 맥락에 맞춰 골라 적용합니다.
- 로컬 LLM 서버를 계획한다면 단일 스트림 benchmark가 아니라 여러 스트림을 동시에 돌릴 때의 처리량 상한을 확인하고, 중고 RTX 3090 같은 선택지를 검토합니다.
- 모바일 개발처럼 반복되는 작업은 자체 agent skill로 절차를 표준화하고, 원격 제어처럼 권한이 큰 앱에는 생성 후 보안 검토를 반드시 넣습니다.
2026년의 AI 활용에서 가치를 가르는 것은 모델 규모의 미세한 차이보다 잘 설계된 agent skill과 맞춤형 도구 연결이라는 관점도 함께 기억할 만합니다. 모델이 바뀔 때마다 benchmark를 좇기보다, 자기 업무에 맞는 작업 절차를 쌓아 두는 쪽이 체감 성능을 끌어올리는 더 확실한 길로 보입니다.


